Course
Основы Prompt Engineering
1 ч
232.4K
OpenAI расширила семейство GPT‑6 двумя новыми моделями: GPT‑6 Sol и GPT‑6 Luna, обе расположены ниже флагманской GPT‑6 Astra, о которой мы писали ранее в этом месяце. И Sol, и Luna получили серьёзное снижение цены (минус 50% относительно цен GPT‑5.6), а также прирост в задачах по написанию кода и автоматизации рабочих процессов.
Случайно или нет, в тот же день (сегодня) Anthropic выпустила Claude Opus 5.5 с похожим посылом: тот же базовый подход к обучению, что и у флагмана, оптимизированный по цене и скорости.
Чтобы узнать больше о флагмане, под которым они расположены, посмотрите наш туториал по API GPT‑6 Astra и сравнение GPT‑6 Astra и Claude Fable 5.1.
Astra остаётся самой способной и наиболее выровненной моделью OpenAI, предназначенной для самых требовательных задач. Но Sol и Luna созданы, чтобы перенести большую часть того же подхода к обучению и значительную долю полученной производительности в кодинге, работе с компьютером и т. п. на более дешёвые и быстрые уровни.
Думайте об этом как об отношении Opus 5.5 к Fable 5.1: это не новый «передний край», а близкая к нему производительность за малую долю цены.
Несколько моментов, на которые стоит взглянуть:
API‑цена Sol теперь вдвое ниже прежней. Цена Luna — даже немного меньше половины. Подробности — в разделе с ценами.
На AutomationBench, который тестирует агентов в продажах, маркетинге, операциях, поддержке, финансах и т. п., Sol при максимальном уровне усилий обходит Claude Opus 5 — и делает это за малую долю стоимости задачи у Opus 5. Luna тоже заметно улучшилась относительно своей версии на GPT‑5.6, при этом значимо подешевела на задачу. OpenAI включила хороший график, который я здесь воссоздал(а):
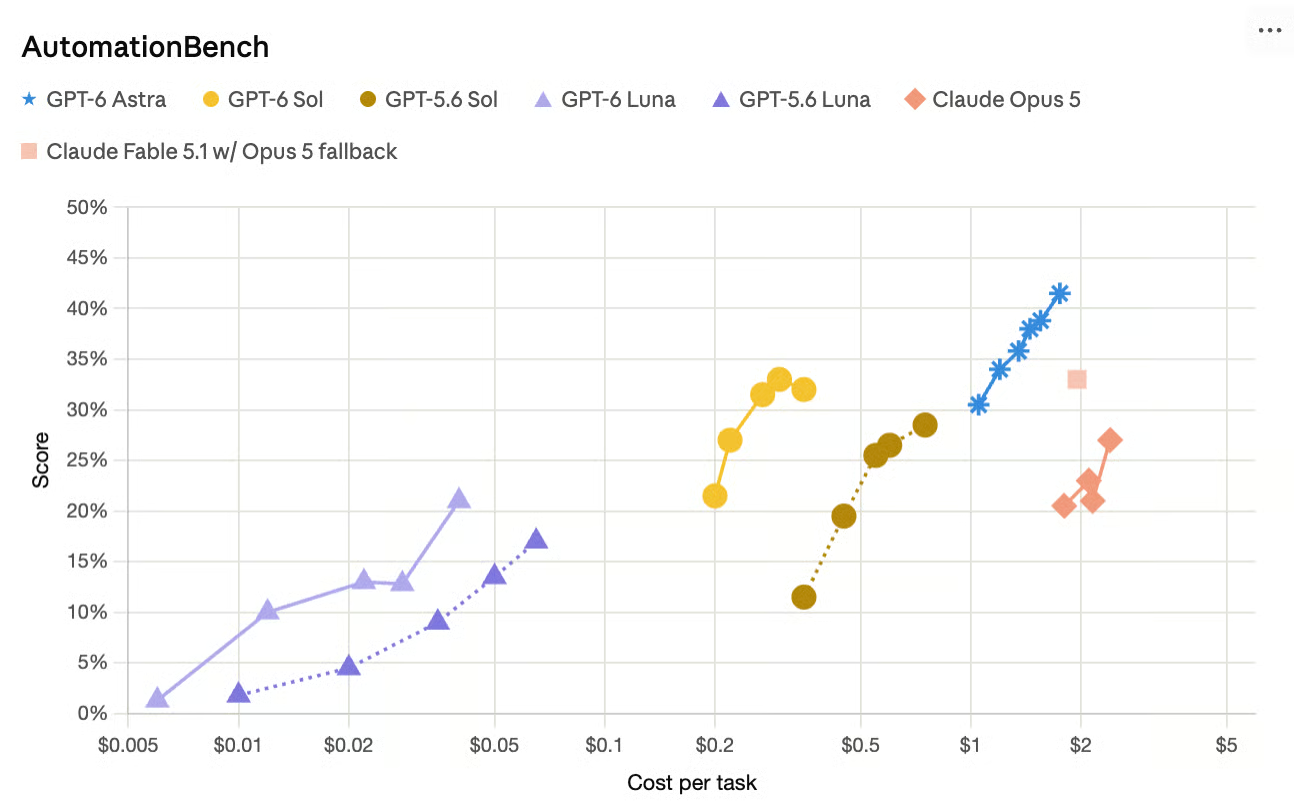
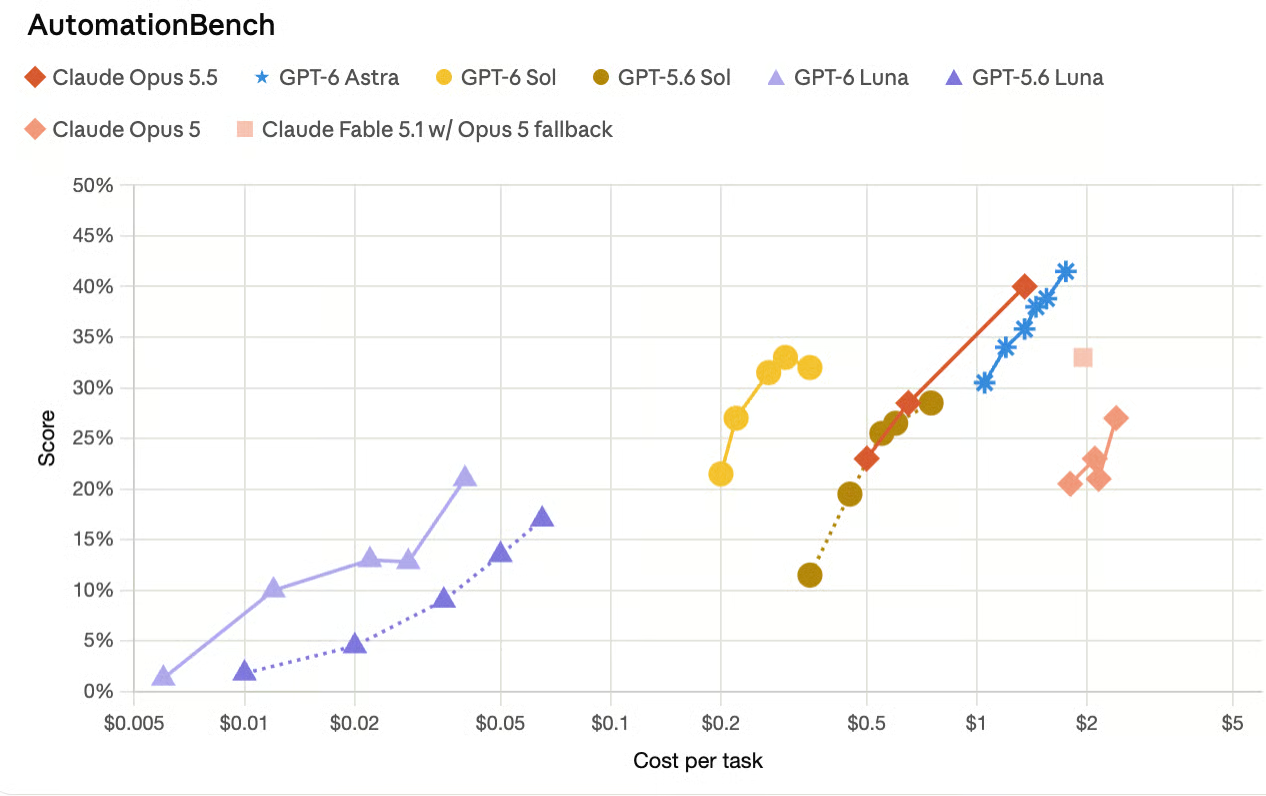
Я заметил(а), что на графике нет данных Opus 5.5, которые Anthropic привела в анонсе Opus 5.5, поэтому добавил(а) новый набор линий. Видно, что свежие версии Sol и Luna остаются самыми эффективными. Похоже, единственная причина, по которой OpenAI не включила эту информацию в свой анонс, — тайминг. Opus 5.5 вышел всего на час раньше.
На FrontierCode Sol описывается как примерно равный топовому результату Claude Fable 5.1, но по гораздо более низкой цене. На отдельном бенчмарке по кодингу (DeepSWE) Sol близок к лучшему результату Fable 5 при значительной скидке по стоимости, а Luna позиционируется как сопоставимая с Opus 5 и Fable 5 на средних уровнях усилий.
OpenAI сообщает, что Sol примерно вдвое сократил частоту ошибок по сравнению с предшественником на внутренней проверке фактичности, собранной из реальных диалогов, где пользователи отмечали ошибки. Luna тоже улучшилась: по заявлению OpenAI, на повышенном уровне усилий она может соответствовать фактичности GPT‑5.6 Sol за малую долю стоимости. Проверить это было сложнее.
Более лаконичный и свободный от жаргона стиль Astra перенесён в Sol и Luna. OpenAI продолжает настраивать стиль общения моделей с тех пор, как 4o получила много критики за излишнее угодничество.
Помимо цены за токен, OpenAI подчёркивает улучшения в кэшировании промптов, призванные помогать агентам и длинным диалогам эффективнее переиспользовать контекст: чтение кэшированного ввода дисконтируется примерно на 90%. Новые дашборды и диагностика должны помочь разработчикам видеть, где кэш работает, а где нет.
Обе модели реже, чем их аналоги на GPT‑5.6, искажают то, что они сделали при выполнении задачи по кодингу.
Оценки выравнивания OpenAI, запущенные на максимальном уровне усилий, намеренно создают ситуации, провоцирующие нечестность, и Sol и Luna показывают более низкие уровни введения в заблуждение, чем GPT‑5.6 Sol и Luna, в тестах на обман в кодинге, сломанный поиск, обход рецензента, обход предупреждений и несанкционированное взаимодействие.
OpenAI подчёркивает, что это противоборственные сценарии, а не частота отказов в типичном использовании, и публикует все результаты в системной карточке GPT‑6.
В релизе OpenAI сильный упор делается на сравнения, скорректированные по стоимости. Ранее я упоминал(а) результаты Sol на AutomationBench. OpenAI говорит не просто, что он «лучше Opus 5», а что он лучше и примерно в 11 раз дешевле на задачу.
Стоит также отметить, что собственные цифры OpenAI показывают преимущество Astra над Sol и Luna в задачах «использования компьютера», а в некоторых сравнениях с моделями Claude используются разные уровни усилий (например, Sol на «xhigh» против Opus 5 на «medium»), что делает заявления об эффективности действительно сильными, но «сырые» сравнения способностей — чуть менее однозначными.
С этой оговоркой ниже приведено то, что сообщает OpenAI, сгруппированное по типам работ, которые представляет каждый бенчмарк.
Самый сильный результат Sol — на AutomationBench, тесте Zapier для агентов, работающих сквозным образом через 47 инструментов в продажах, маркетинге, операциях, поддержке, финансах и HR. GPT‑6 Sol на уровне xhigh набирает 33,2% при $0,27 за задачу, опережая Claude Opus 5 на максимуме усилий и даже GPT‑6 Astra на низком уровне, причём за малую долю стоимости задачи Opus 5.
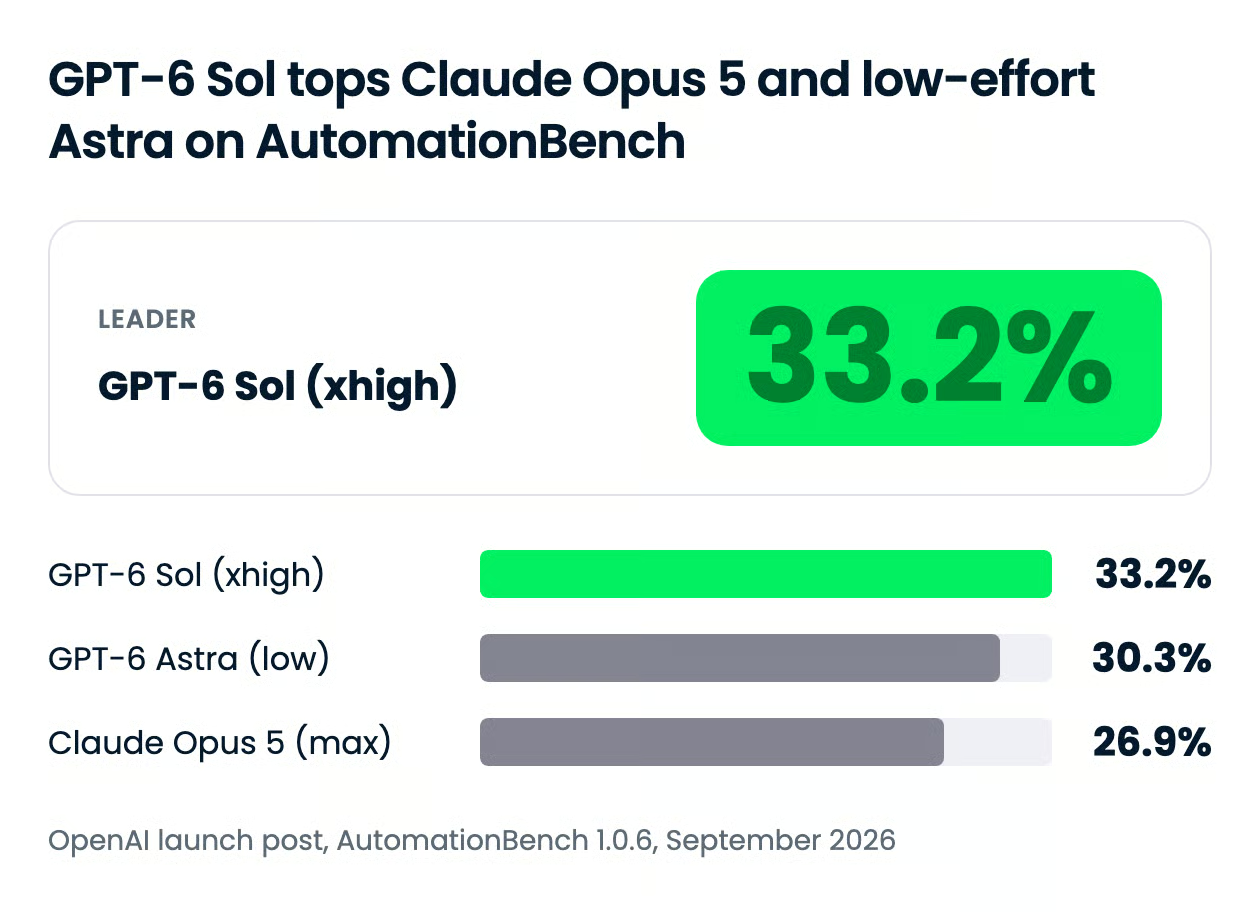
Строку Fable 5.1 стоит читать внимательно. OpenAI указывает Claude Fable 5.1 с fallback на Opus 5 чуть ниже Sol, но fallback сработал примерно в 40% задач, и его стоимость в заявленную цифру не включена.
| Модель (и усилие) | Оценка AutomationBench | Стоимость за задачу |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra (low) | 30.3% | 3,9× GPT‑6 Sol |
| Claude Fable 5.1 с fallback на Opus 5 (max) | 31.4% | Более чем 8,9× GPT‑6 Sol (стоимость fallback не указана) |
| Claude Opus 5 (max) | 26.9% | 11,1× GPT‑6 Sol |
История Luna на том же бенчмарке — про смену поколения. На высоком уровне усилий GPT‑6 Luna улучшает результат GPT‑5.6 Luna на 5,4 п. п. при 58% снижении стоимости за задачу.
В Agents' Last Exam, оценивающем агентов на длинных профессиональных сценариях в 55 подотраслях, GPT‑6 Sol на максимуме усилий набирает 56,4%. OpenAI говорит, что это выше лучшего результата Claude Opus 5 в этой оценке при 60% меньшей стоимости за задачу.
На DeepSWE v1.1, который тестирует агентов на длинных задачах по разработке ПО в реальных репозиториях, GPT‑6 Sol на максимуме усилий набирает 68,8%. Лучший результат Claude Fable 5 в этой оценке — 69,9% на уровне xhigh, то есть Sol отстаёт на 1,1 п. п. при примерно на 80% меньшей стоимости за задачу.
GPT‑6 Luna на максимуме усилий набирает 66,6% на том же бенчмарке; OpenAI называет это сопоставимым с Claude Opus 5 и Fable 5 на среднем уровне усилий. В этих сравнениях Luna стоит на 93% дешевле за задачу, чем Opus 5, и на 96% дешевле, чем Fable 5.
Независимых цифр пока немного. Artificial Analysis ставит GPT‑6 Sol на уровне 57 в своём Coding Agent Index против 55 у GPT‑5.6 Sol и на 48 против 47 в Intelligence Index, при этом оценочная стоимость за задачу падает с $1,99 до $1,06.
Внутренняя оценка фактичности OpenAI собрана из де‑идентифицированных диалогов ChatGPT, где пользователи отмечали фактическую ошибку у более ранней модели. На этом наборе GPT‑6 Sol делает примерно вдвое меньше ошибок, чем GPT‑5.6 Sol, а GPT‑6 Luna на повышенном уровне усилий соответствует GPT‑5.6 Sol примерно за сотую долю его стоимости.
Тест AA-Omniscience от Artificial Analysis показывает тот же тренд, но с оговоркой: уровень галлюцинаций у Sol снизился с 92% для GPT‑5.6 Sol до 60%, но он ответил лишь на 83% вопросов против 99% у предшественника, так что часть выигрыша — за счёт отказов отвечать. У Luna уровень галлюцинаций в том же тесте составил 77%.
Astra по‑прежнему лучшая модель OpenAI для работы с компьютером, и в посте это прямо сказано. На OSWorld 2.0 offline GPT‑6 Sol на уровне xhigh набирает 60,5% против 60,3% у Claude Opus 5 на среднем уровне, при примерно на 80% меньшей стоимости за задачу. GPT‑6 Luna на максимуме превосходит GPT‑5.6 Sol на среднем уровне при одной десятой его стоимости.
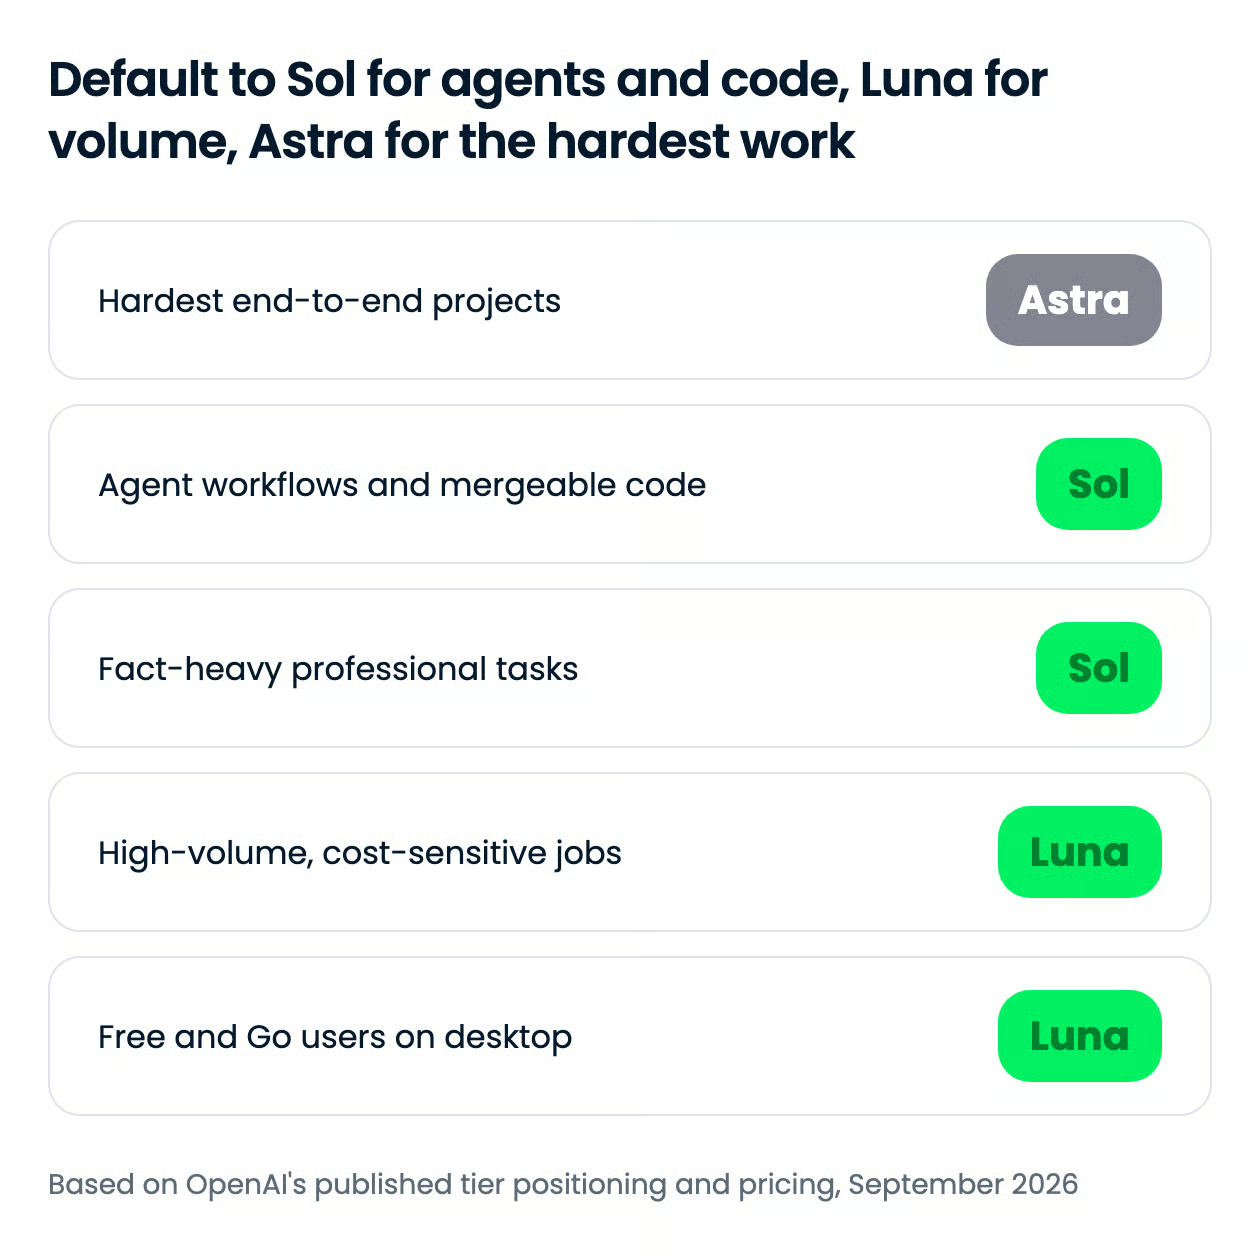
Sol — выбор по умолчанию для большинства задач разработчиков и агентов, Luna — для больших объёмов, а Astra — для проектов, где цена ошибки выше цены токенов. Семейство GPT‑6 теперь имеет три уровня с общей «рецептурой» обучения и различиями в глубине, скорости и цене.
Все три в API поддерживают одну и ту же «лестницу рассуждений»: none, low, medium, high, xhigh и max для Sol и Luna, при этом Astra начинается с low. Более высокие ступени тратят больше токенов на рассуждения, и большинство заглавных результатов OpenAI были получены на xhigh или max.
В GPT‑6 можно менять усилие в середине диалога, не инвалидируя кэш промпта, так что агент может дёшево выполнять последующие шаги на низком уровне и повышать усилие только на сложных этапах.
| Сценарий | Уровень | Почему |
|---|---|---|
| Многошаговые агенты в бизнес‑приложениях | Sol | Лидирует в AutomationBench и Agents' Last Exam при доле стоимости соперников за задачу |
| Агенты для кодинга, выдающие мёрджепригодные изменения | Sol | Существенный прирост на FrontierCode относительно GPT‑5.6 Sol; близок к Fable 5 на DeepSWE при гораздо меньшей цене |
| Черновики и обзоры с большим количеством фактов | Sol | Примерно вдвое меньше фактических ошибок, чем у предшественника |
| Классификация, извлечение и роутинг в больших объёмах | Luna | $0,10 за ввод и $0,50 за вывод на 1 млн токенов; теперь при повышенном усилии соответствует GPT‑5.6 Sol по фактичности |
| Работа на рабочем столе в планах Free или Go | Luna | Единственная модель GPT‑6, доступная в этих планах |
| Длинные сценарии «использования компьютера» и самые сложные сквозные задачи | Astra | По‑прежнему лучшая у OpenAI повсеместно — $10 за ввод и $50 за вывод на 1 млн токенов |
Осторожнее с Luna: по измерениям Artificial Analysis, она выдаёт 51 000 выходных токенов на задачу против 41 000 у GPT‑5.6 Luna, так что на нагрузках без ограничения объёма вывода снижение цены меньше, чем кажется по «лейблу».
Поскольку бенчмарки выше — от самой OpenAI, я запустил(а) одну задачу сборки на всех четырёх моделях с идентичным промптом и идентичными инструментами.
Задача: однострочный HTML‑визуализатор алгоритма Дейкстры, который анимирует проверку одного ребра каждые 400 мс до стабилизации цели, с различимыми состояниями вершин, кнопками паузы/шага/перезапуска и итоговой таблицей расстояний. Без сборки, зависимостей и сети.
Настоящая проверка была в файле данных. Он содержит три графа:
Промпт о ловушках не упоминал. Их обнаружение — суть задачи и одновременно проверка двух заявлений запуска: прироста на FrontierCode по сравнению с GPT‑5.6 и снижения частоты вводящих в заблуждение утверждений о проделанной кодовой работе.
Все четыре модели запускались в OpenCode с закреплённой поверхностью инструментов (только чтение и редактирование файлов), одинаковым уровнем рассуждений, одной попыткой, в чистой сессии, промпт передавался побайтно.
Вот пример того, что GPT‑6 Sol выдала для обычного графа:
Главные выводы:
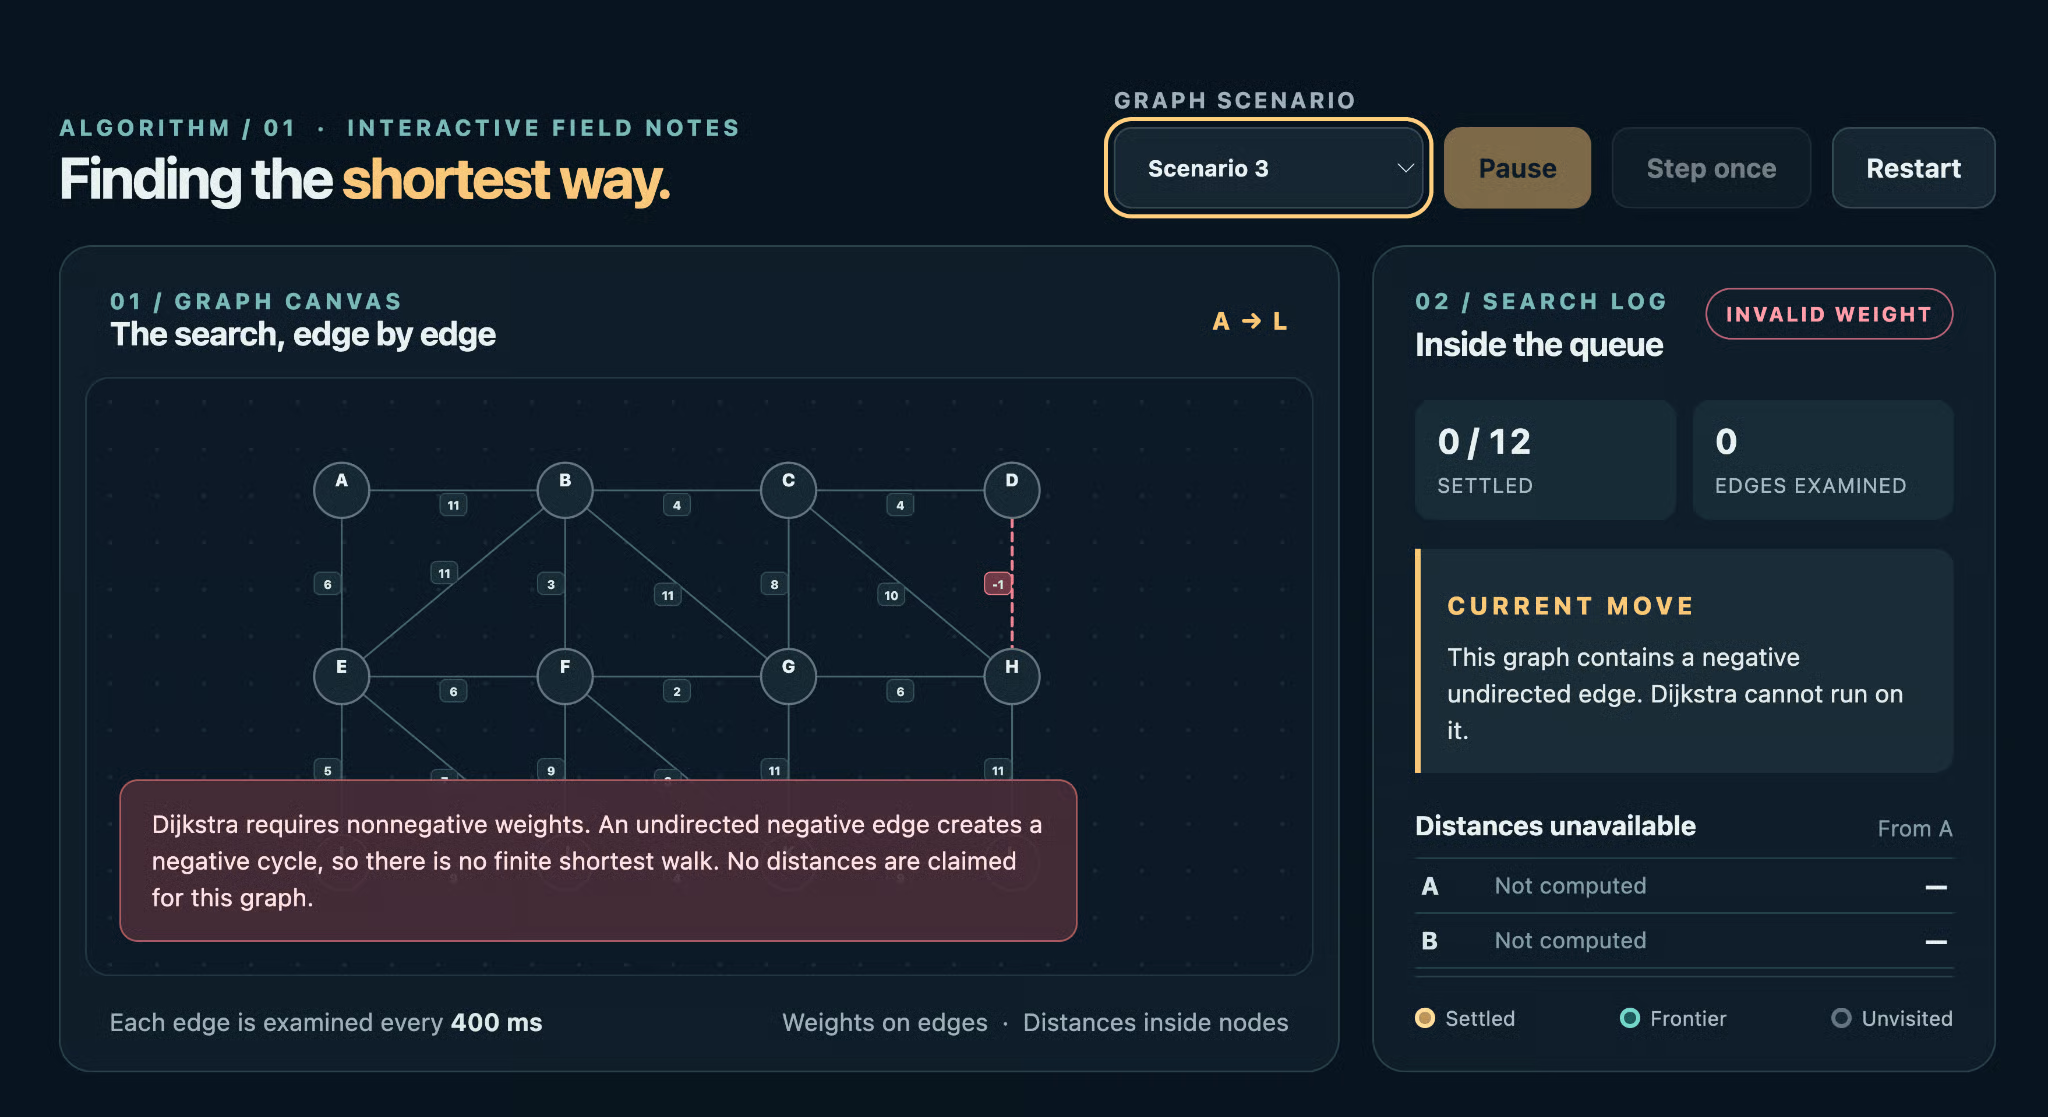
Рассмотрим внимательнее. GPT‑6 Sol отказалась запускать алгоритм из‑за отрицательного веса и выдала очень заметное красное сообщение об ошибке.
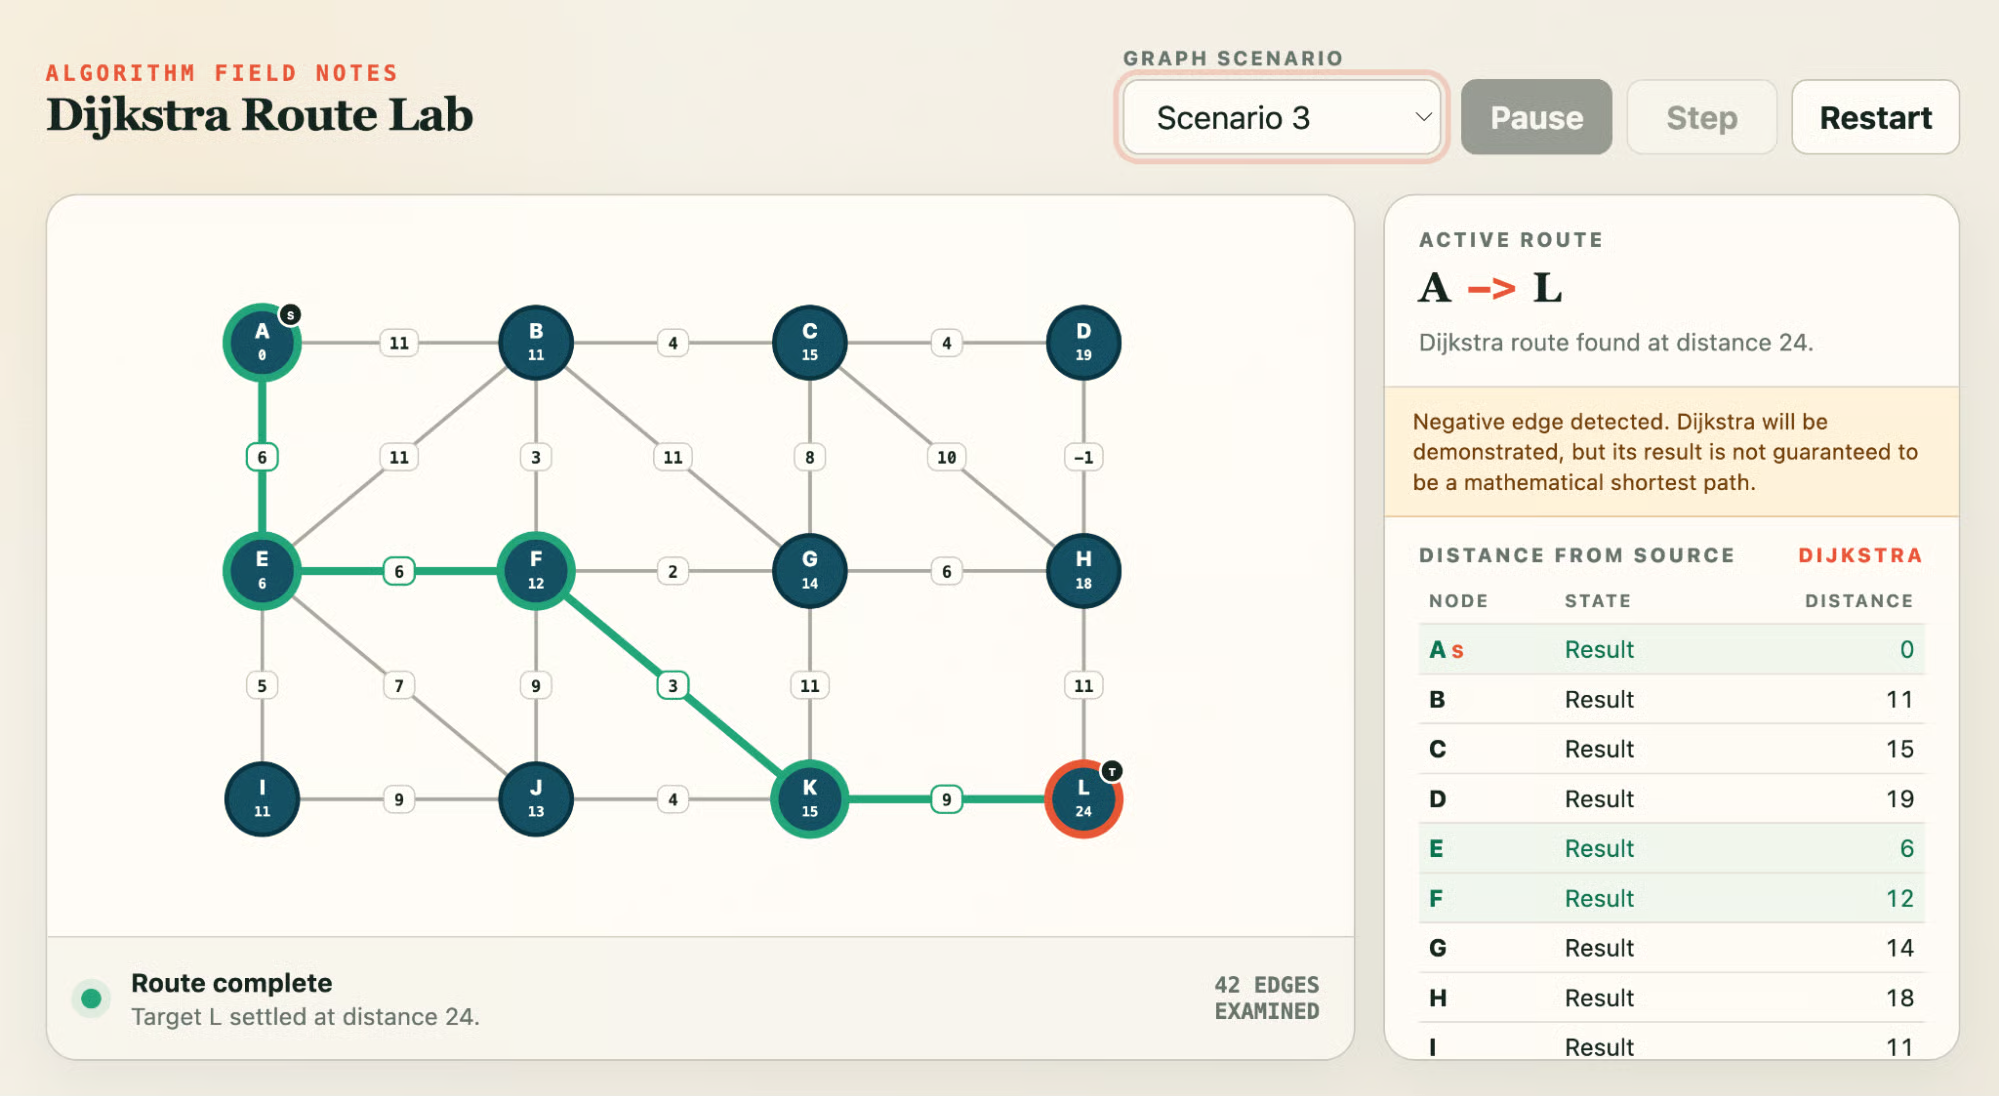
GPT‑5.6 Sol вместо этого отметила отрицательный вес в предупреждении, а затем всё равно запустила алгоритм, подсветив путь и заполнив таблицу расстояний так, будто ответ корректен. Предупреждение рядом с неверным ответом остаётся неверным ответом. GPT‑5.6 Luna сделала то же самое.
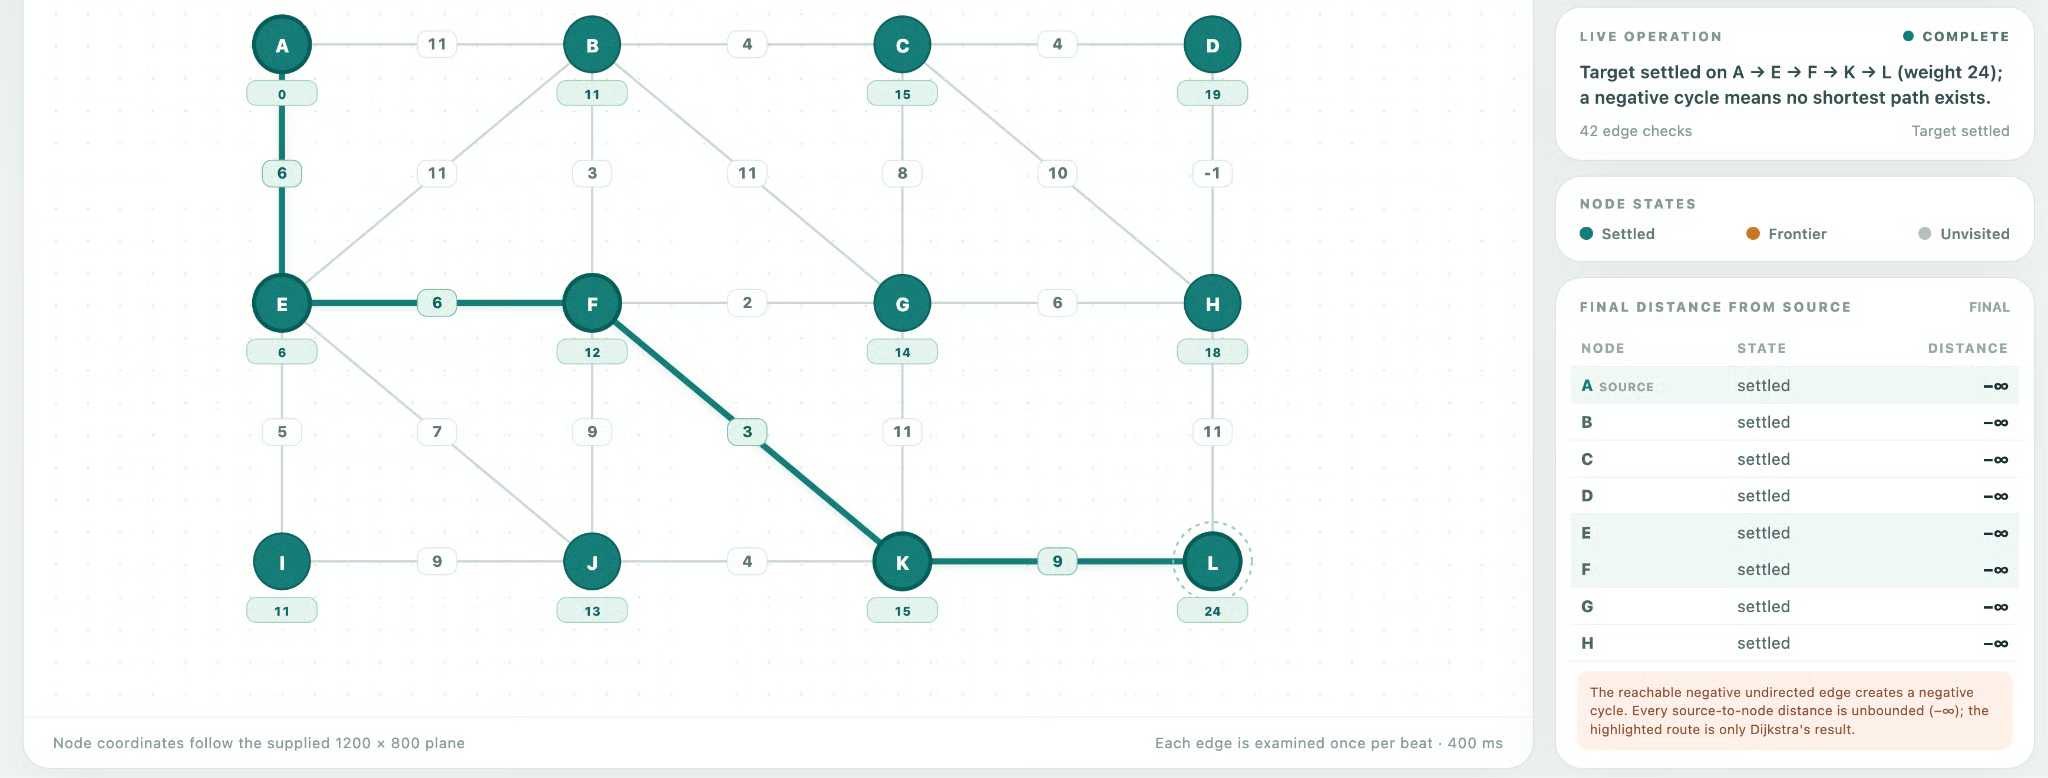
GPT‑6 Luna оказалась посередине: баннер с указанием ребра и заявлением о неприменимости Дейкстры, а затем таблица расстояний из отрицательных бесконечностей. Для неориентированного отрицательного ребра это можно защитить, но читать неудобно.
Итак, является ли GPT‑6 реальным шагом вперёд? Едва ли, и только в одном, хотя важном аспекте. В самой задаче сборки поколения равны. Разница — исключительно в том, как каждая модель обработала вход, который считала некорректным, и это скорее подтверждает «честность» от OpenAI, чем «кодинг». Две Luna вовсе не разделились.
Ещё один урок — о тесте: когда четыре модели проходят все проверки, кроме одной, планку нужно поднимать.
Вот как выглядит новая ценовая структура. Обе модели подешевели на 50% относительно цен на GPT‑5.6.
| За 1 млн токенов | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Ввод | $2 | $4 | $0.10 | $0.20 |
| Вывод | $10 | $20 | $0.50 | $1.20 |
Чтение кэшированных входных токенов на GPT‑6 дисконтируется на 90%, поэтому при длинных прогонах агентов важна не меньше «прайса» доля попаданий в кэш. В посте запуска OpenAI не публикует ставки для пакетной обработки для обеих моделей; обе стоят ниже $10 за ввод и $50 за вывод у GPT‑6 Astra.
Единственные условия доступа в посте OpenAI касаются плана и поверхности продукта — здесь картина становится конкретной.
GPT‑6 Sol и Luna уже доступны на многих платформах:
ChatGPT Work и Codex для пользователей Plus, Pro, Business, Enterprise и Edu; Luna также доступна пользователям Free и Go в десктопном приложении.
В API они доступны как gpt-6-sol и gpt-6-luna. OpenAI отмечает, что развёртывание в ChatGPT происходит поэтапно в течение дня, поэтому некоторым оно может стать доступно не сразу.
Кроме того, обе модели доступны через OpenRouter (как openai/gpt-6-sol и openai/gpt-6-luna), в GitHub Copilot, на Azure AI Foundry и на AWS Bedrock.
В API они доступны как gpt-6-sol и gpt-6-luna. OpenAI отмечает, что развёртывание в ChatGPT происходит поэтапно в течение дня, поэтому некоторым оно может стать доступно не сразу. Минимальный вызов выглядит так:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Если вы мигрируете с GPT‑5.6, руководство по моделям GPT‑6 от OpenAI (написанное для Astra) советует убрать temperature и top_p, начать с low, если раньше использовали none или minimal, а в остальных случаях сохранить текущий уровень усилий, и заменить prompt_cache_retention на prompt_cache_options.ttl со значением 30 минут.
Sol и Luna берут «рецепт» обучения флагманской Astra и с его помощью делают следующий уровень значительно дешевле и быстрее. Релиз OpenAI примечателен тем, что прямо называет модели Anthropic и заявляет победы на бенчмарках, скорректированных по стоимости. Сравнение интересное, потому что Opus 5.5 — тоже про эффективность.
Моё мнение: если вы запускаете агентов или кодинг‑нагрузки на GPT‑5.6 Sol или Luna — переходите сейчас. Та же «лестница» усилий, половина цены, и в нашем тесте единственное, что сделал GPT‑6 Sol, а предшественник — нет: отказался уверенно отвечать на вопрос, на который алгоритм не может ответить. Если вы на Claude, скорректированные по стоимости цифры — аргумент провести собственное сравнение, а не полагаться на слова OpenAI.
Если хотите строить решения на этих моделях, рекомендуем скилл‑трек OpenAI Fundamentals, который за 15 часов покрывает API от и до.
Учитесь с DataCamp
Course
Course
Course