Corso
Comprendere l'ingegneria del prompt
1 h
232.4K
OpenAI ha appena ampliato la famiglia GPT‑6 con due nuovi modelli: GPT‑6 Sol e GPT‑6 Luna, entrambi posizionati sotto il top di gamma GPT‑6 Astra, di cui abbiamo scritto all'inizio del mese. Sia Sol che Luna arrivano con forti tagli di prezzo (–50% rispetto ai prezzi di GPT‑5.6) e con miglioramenti per coding e automazione dei workflow.
Per coincidenza o meno, Anthropic ha rilasciato Claude Opus 5.5 lo stesso giorno (oggi), con un messaggio simile: stesso approccio di training del modello di punta, ottimizzato per costi e velocità.
Per saperne di più sul top di gamma a cui si affiancano, dai un'occhiata al nostro tutorial sull'API di GPT‑6 Astra e al nostro confronto tra GPT‑6 Astra e Claude Fable 5.1.
Astra resta il modello più capace e meglio allineato di OpenAI, riservato ai lavori più impegnativi. Ma Sol e Luna portano gran parte dello stesso approccio di training e buona parte delle prestazioni risultanti in coding, uso del computer, ecc., su livelli più economici e veloci.
Pensali come il rapporto tra Opus 5.5 e Fable 5.1: non una nuova frontiera, ma prestazioni vicine alla frontiera a una frazione del costo.
Alcune cose da notare:
Il prezzo API di Sol è dimezzato rispetto a prima. Il prezzo di Luna è persino un po' meno della metà. Trovi maggiori dettagli nella sezione prezzi.
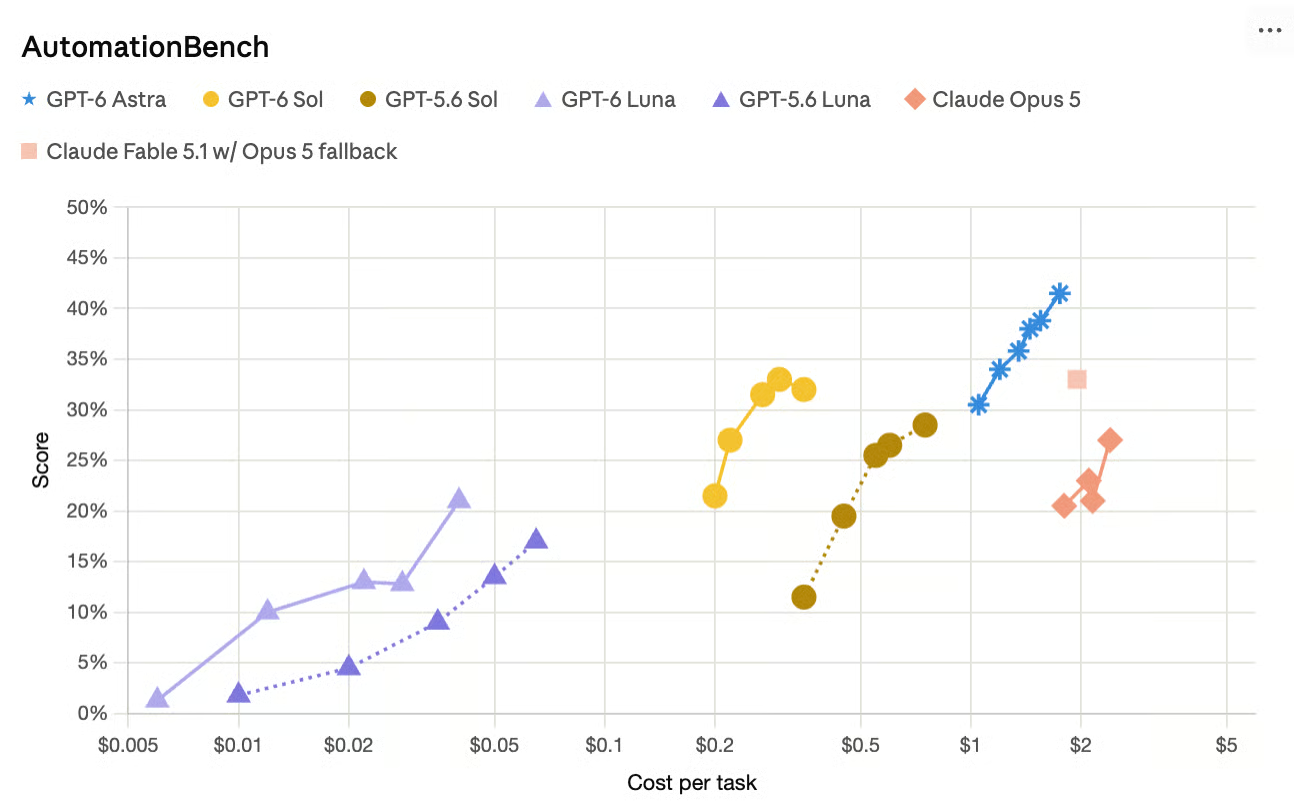
Su AutomationBench, che testa agent su vendite, marketing, operations, supporto, finanza e simili, Sol alla massima impostazione di effort supera Claude Opus 5, e lo fa a una piccola frazione del costo per task di Opus 5. Anche Luna è migliorata in modo significativo rispetto alla sua versione GPT‑5.6 pur diventando sensibilmente più economica per task. OpenAI ha incluso un bel grafico, che ho ricreato qui:
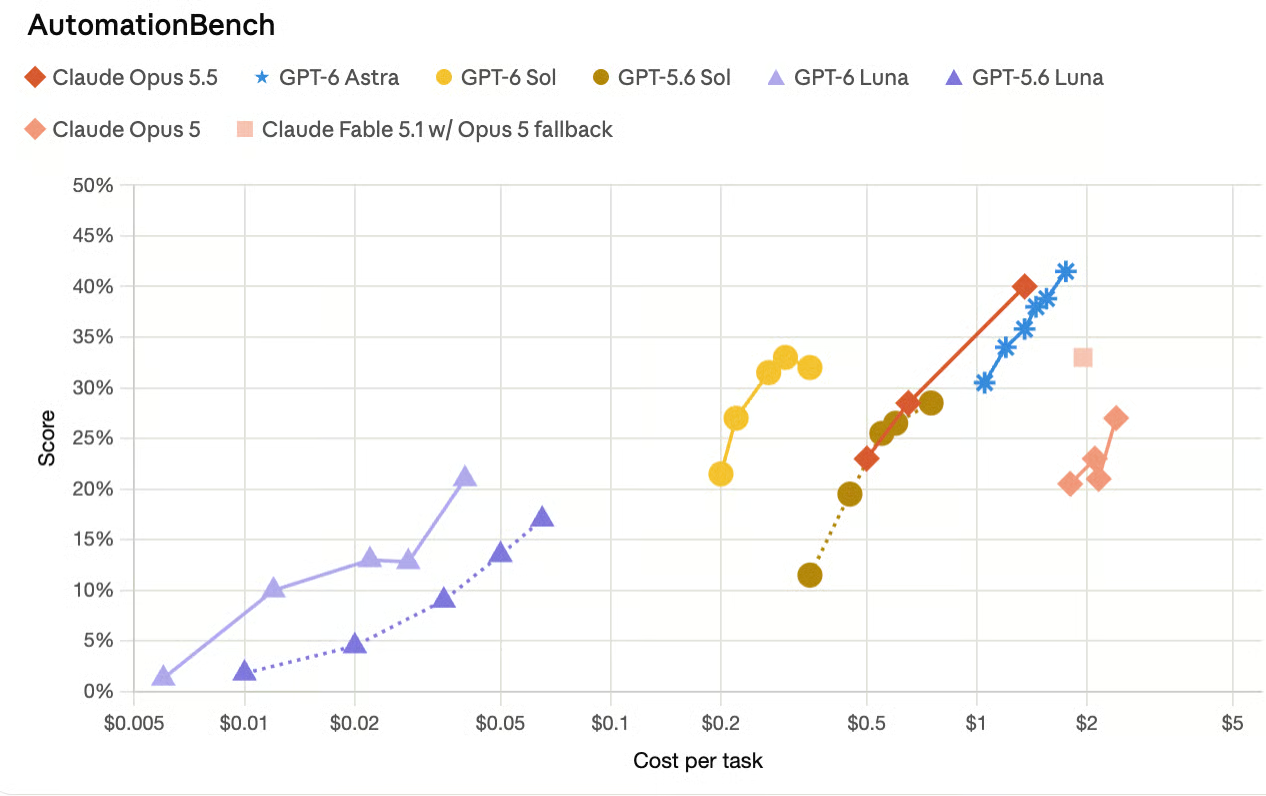
Ho notato che il grafico non includeva i numeri di Opus 5.5 riportati da Anthropic nell'annuncio di Opus 5.5, quindi ho aggiunto un nuovo set di linee. Si vede che le versioni più recenti di Sol e Luna restano le più efficienti. Probabilmente l'unico motivo per cui OpenAI non ha incluso questa informazione nel loro annuncio di lancio è la tempistica. Opus 5.5 è uscito solo un'ora prima.
Su FrontierCode, Sol è descritto come all'incirca in linea con il punteggio massimo di Claude Fable 5.1, ma a un prezzo molto più basso. Su un benchmark di coding separato (DeepSWE), Sol si avvicina al miglior punteggio di Fable 5 con un forte sconto sul costo, e Luna è presentata come paragonabile a Opus 5 e Fable 5 a impostazioni di effort intermedie.
OpenAI afferma che Sol dimezza circa il tasso di errore del suo predecessore su un controllo di factualità interno basato su conversazioni reali in cui gli utenti avevano segnalato errori. Anche Luna è migliorata: secondo OpenAI può eguagliare la factualità di GPT‑5.6 Sol a una piccola frazione del costo quando eseguita a effort più alto. Questo è stato più difficile da verificare.
Lo stile di comunicazione più conciso e con meno gergo di Astra è stato portato su Sol e Luna. OpenAI continua a ottimizzare lo stile conversazionale dei suoi modelli sin da quando 4o è stato molto criticato per essere troppo compiacente.
Oltre al prezzo per token, OpenAI evidenzia miglioramenti al prompt caching pensati per aiutare agent e conversazioni lunghe a riutilizzare il contesto in modo più efficiente, con letture di input in cache scontate di circa il 90%. Nuove dashboard e diagnostiche servono ad aiutare gli sviluppatori a capire dove il caching funziona e dove no.
Entrambi i modelli sono meno inclini rispetto alle controparti GPT‑5.6 a travisare ciò che hanno fatto su un task di coding.
Le valutazioni di allineamento di OpenAI, eseguite al massimo effort, impostano deliberatamente situazioni che invitano alla disonestà, e Sol e Luna mostrano tassi di inganno inferiori rispetto a GPT‑5.6 Sol e Luna nei test su inganno nel coding, ricerca interrotta, aggiramento del revisore, elusione degli avvisi e interazioni non autorizzate.
OpenAI sottolinea che si tratta di setup avversariali, non di tassi di fallimento nell'uso tipico, e pubblica tutti i risultati nella system card di GPT‑6.
Il comunicato di OpenAI punta molto sui confronti corretti per il costo. Prima ho citato le prestazioni di Sol su AutomationBench. OpenAI non dice solo che è "meglio di Opus 5" ma anche che è migliore e circa 11 volte più economico per task.
Vale anche la pena notare che i numeri di OpenAI mostrano Astra ancora davanti a Sol e Luna nei task di uso del computer, e che alcuni confronti con i modelli Claude usano impostazioni di effort diverse ai due lati (per esempio, Sol a "xhigh" contro Opus 5 a "medium"), il che rende solide le affermazioni sull'efficienza ma un po' più difficile inchiodare i confronti di capacità “pura”.
Con questa premessa, ecco cosa ha riportato OpenAI, raggruppato per tipo di lavoro rappresentato da ciascun benchmark.
Il risultato più forte di Sol è su AutomationBench, il test di Zapier su agent che lavorano end-to-end con 47 strumenti in vendite, marketing, operations, supporto, finanza e HR. GPT‑6 Sol a effort xhigh ottiene il 33,2% a $0,27 per task, davanti a Claude Opus 5 al massimo effort e persino davanti a GPT‑6 Astra a effort basso, e a una piccola frazione del costo per task di Opus 5.
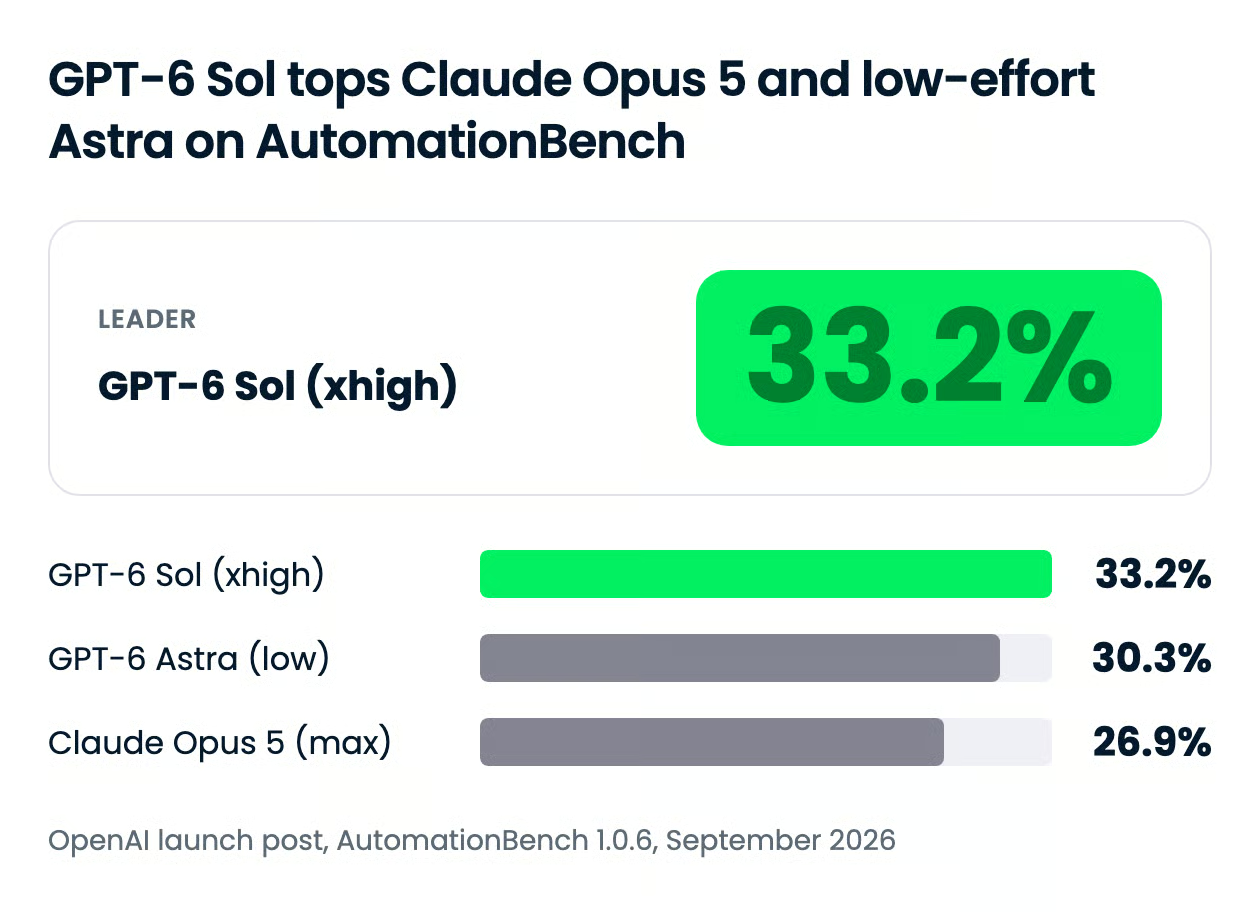
La riga di Fable 5.1 è quella da leggere con attenzione. OpenAI elenca Claude Fable 5.1 con fallback a Opus 5 appena sotto Sol, ma il fallback è scattato in circa il 40% dei task e il suo costo non è incluso nella cifra riportata.
| Modello (ed effort) | Punteggio AutomationBench | Costo per task |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra (basso) | 30.3% | 3,9× GPT‑6 Sol |
| Claude Fable 5.1 con fallback Opus 5 (max) | 31.4% | Oltre 8,9× GPT‑6 Sol (costo del fallback non riportato) |
| Claude Opus 5 (max) | 26.9% | 11,1× GPT‑6 Sol |
La storia di Luna sullo stesso benchmark è generazionale. Ad alto effort, GPT‑6 Luna migliora GPT‑5.6 Luna di 5,4 punti percentuali con un costo per task inferiore del 58%.
Su Agents' Last Exam, che valuta agent su workflow professionali di lungo orizzonte in 55 sotto-settori, GPT‑6 Sol al massimo effort ottiene il 56,4%. OpenAI afferma che è sopra il miglior punteggio di Claude Opus 5 nella valutazione, con un costo per task inferiore del 60%.
Su DeepSWE v1.1, che testa agent su task di ingegneria del software di lungo orizzonte in repository reali, GPT‑6 Sol al massimo effort ottiene il 68,8%. Il miglior punteggio di Claude Fable 5 nella valutazione è 69,9% a effort xhigh, quindi Sol si posiziona 1,1 punti dietro a un costo per task circa inferiore dell'80%.
GPT‑6 Luna al massimo effort ottiene il 66,6% sullo stesso benchmark, che OpenAI definisce paragonabile a Claude Opus 5 e Fable 5 a effort medio. Nelle stesse comparazioni, Luna costa il 93% in meno per task rispetto a Opus 5 e il 96% in meno rispetto a Fable 5.
I numeri indipendenti sono per ora modesti. Artificial Analysis colloca GPT‑6 Sol a 57 nel suo Coding Agent Index contro 55 per GPT‑5.6 Sol, e a 48 contro 47 nel suo Intelligence Index, con costo stimato per task in calo da $1,99 a $1,06.
La valutazione interna di factualità di OpenAI è costruita da conversazioni ChatGPT de-identificate in cui gli utenti hanno segnalato un errore fattuale da un modello precedente. Su quel set, GPT‑6 Sol commette circa la metà degli errori di GPT‑5.6 Sol, e GPT‑6 Luna a effort più alto eguaglia GPT‑5.6 Sol a circa un centesimo del suo costo.
Il test AA-Omniscience di Artificial Analysis va nella stessa direzione, con un caveat: il tasso di allucinazioni di Sol è sceso dal 92% di GPT‑5.6 Sol al 60%, ma ha risposto solo all'83% delle domande contro il 99% del suo predecessore, quindi parte del guadagno deriva dal rifiuto di rispondere. Il tasso di allucinazioni di Luna nello stesso test è stato del 77%.
Astra è ancora il miglior modello di OpenAI per l'uso del computer, e il post lo dice. Su OSWorld 2.0 offline, GPT‑6 Sol a effort xhigh ottiene il 60,5% contro il 60,3% di Claude Opus 5 a effort medio, a un costo per task circa inferiore dell'80%. GPT‑6 Luna al massimo supera GPT‑5.6 Sol a effort medio a un decimo del suo costo.
Sol è il default per la maggior parte del lavoro di sviluppo e degli agent, Luna è per il volume, e Astra è per i progetti in cui una risposta sbagliata costa più dei token. La famiglia GPT‑6 ora ha tre livelli che condividono la ricetta di training e differiscono per profondità, velocità e prezzo.
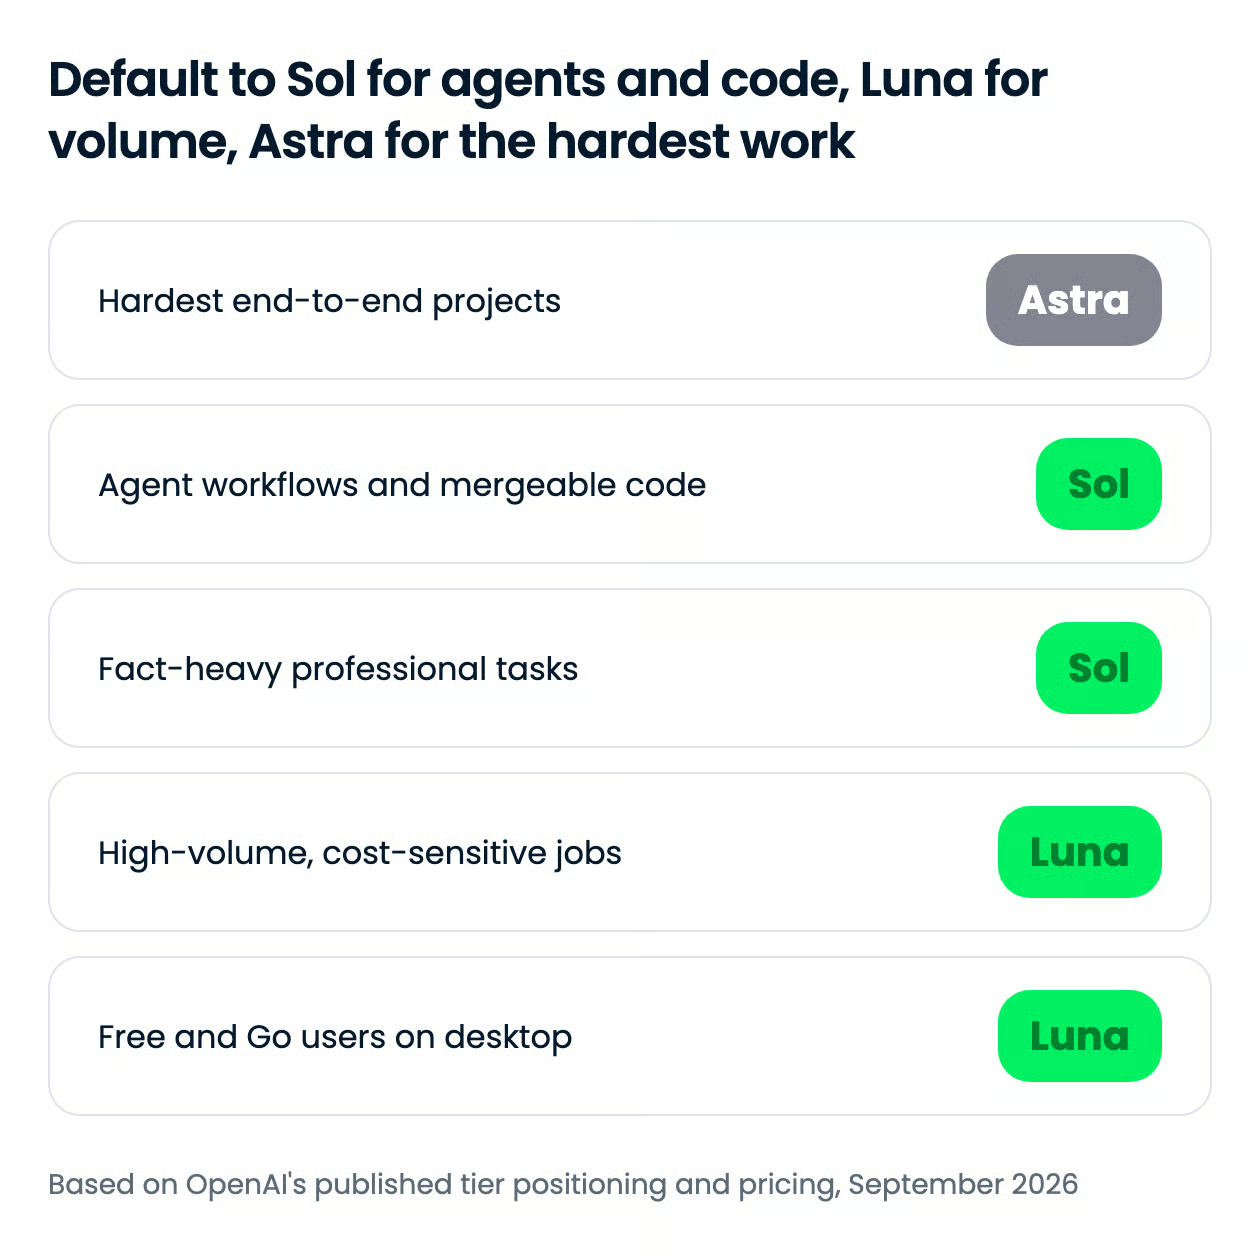
Tutti e tre espongono la stessa scala di reasoning nell'API: none, low, medium, high, xhigh e max per Sol e Luna, con Astra che parte da low. I gradini più alti spendono più token sul ragionamento, e la maggior parte dei risultati in evidenza di OpenAI sono stati ottenuti a xhigh o max.
GPT‑6 consente anche di cambiare l'effort a conversazione in corso senza invalidare la cache del prompt, così un agent può eseguire follow-up economici a basso effort ed elevare solo i passaggi difficili.
| Caso d'uso | Livello | Perché |
|---|---|---|
| Agent multi-step su app aziendali | Sol | Guida AutomationBench e Agents' Last Exam a una frazione del costo per task dei rivali |
| Agent di coding che producono modifiche mergeabili | Sol | Notevole guadagno su FrontierCode rispetto a GPT‑5.6 Sol; vicino a Fable 5 su DeepSWE a costo molto inferiore |
| Stesura e sintesi di ricerca ricche di fatti | Sol | Circa la metà degli errori fattuali del predecessore |
| Classificazione, estrazione e routing ad alto volume | Luna | $0,10 input e $0,50 output per 1M token, e ora eguaglia GPT‑5.6 Sol sulla factualità a effort più alto |
| Uso desktop su un piano Free o Go | Luna | L'unico modello GPT‑6 disponibile su quei piani |
| Uso del computer di lungo orizzonte e il lavoro end-to-end più difficile | Astra | Ancora il migliore di OpenAI a tutto tondo, a $10 input e $50 output per 1M token |
Una cautela su Luna: Artificial Analysis ha misurato 51.000 token di output per task contro 41.000 per GPT‑5.6 Luna, quindi su carichi di lavoro in cui non limiti l'output, il taglio di prezzo è inferiore a quanto suggerito dall'etichetta.
I benchmark sopra sono di OpenAI, quindi ho eseguito un task di build su tutti e quattro i modelli con prompt e tool identici.
Il task: un visualizzatore HTML single-file per l'algoritmo di Dijkstra, che anima un controllo per arco ogni 400 ms finché il target si stabilizza, con stati dei nodi distinti, controlli di pausa/step/restart e una tabella finale delle distanze. Niente build step, niente dipendenze, niente rete.
Il vero test era nel file dei dati. Contiene tre grafi:
Il prompt non menziona mai le trappole. Notarle è il punto, e indaga due affermazioni di lancio insieme: il guadagno su FrontierCode rispetto a GPT‑5.6 e il minor tasso di affermazioni fuorvianti sul lavoro di coding.
Tutti e quattro sono stati eseguiti in OpenCode con la stessa superficie di tool bloccata (solo lettura e modifica file), stesso effort di reasoning, un tentativo, sessione nuova, prompt inviato byte-per-byte.
Ecco un esempio di ciò che GPT-6 Sol ha prodotto per il grafo normale:
I risultati principali:
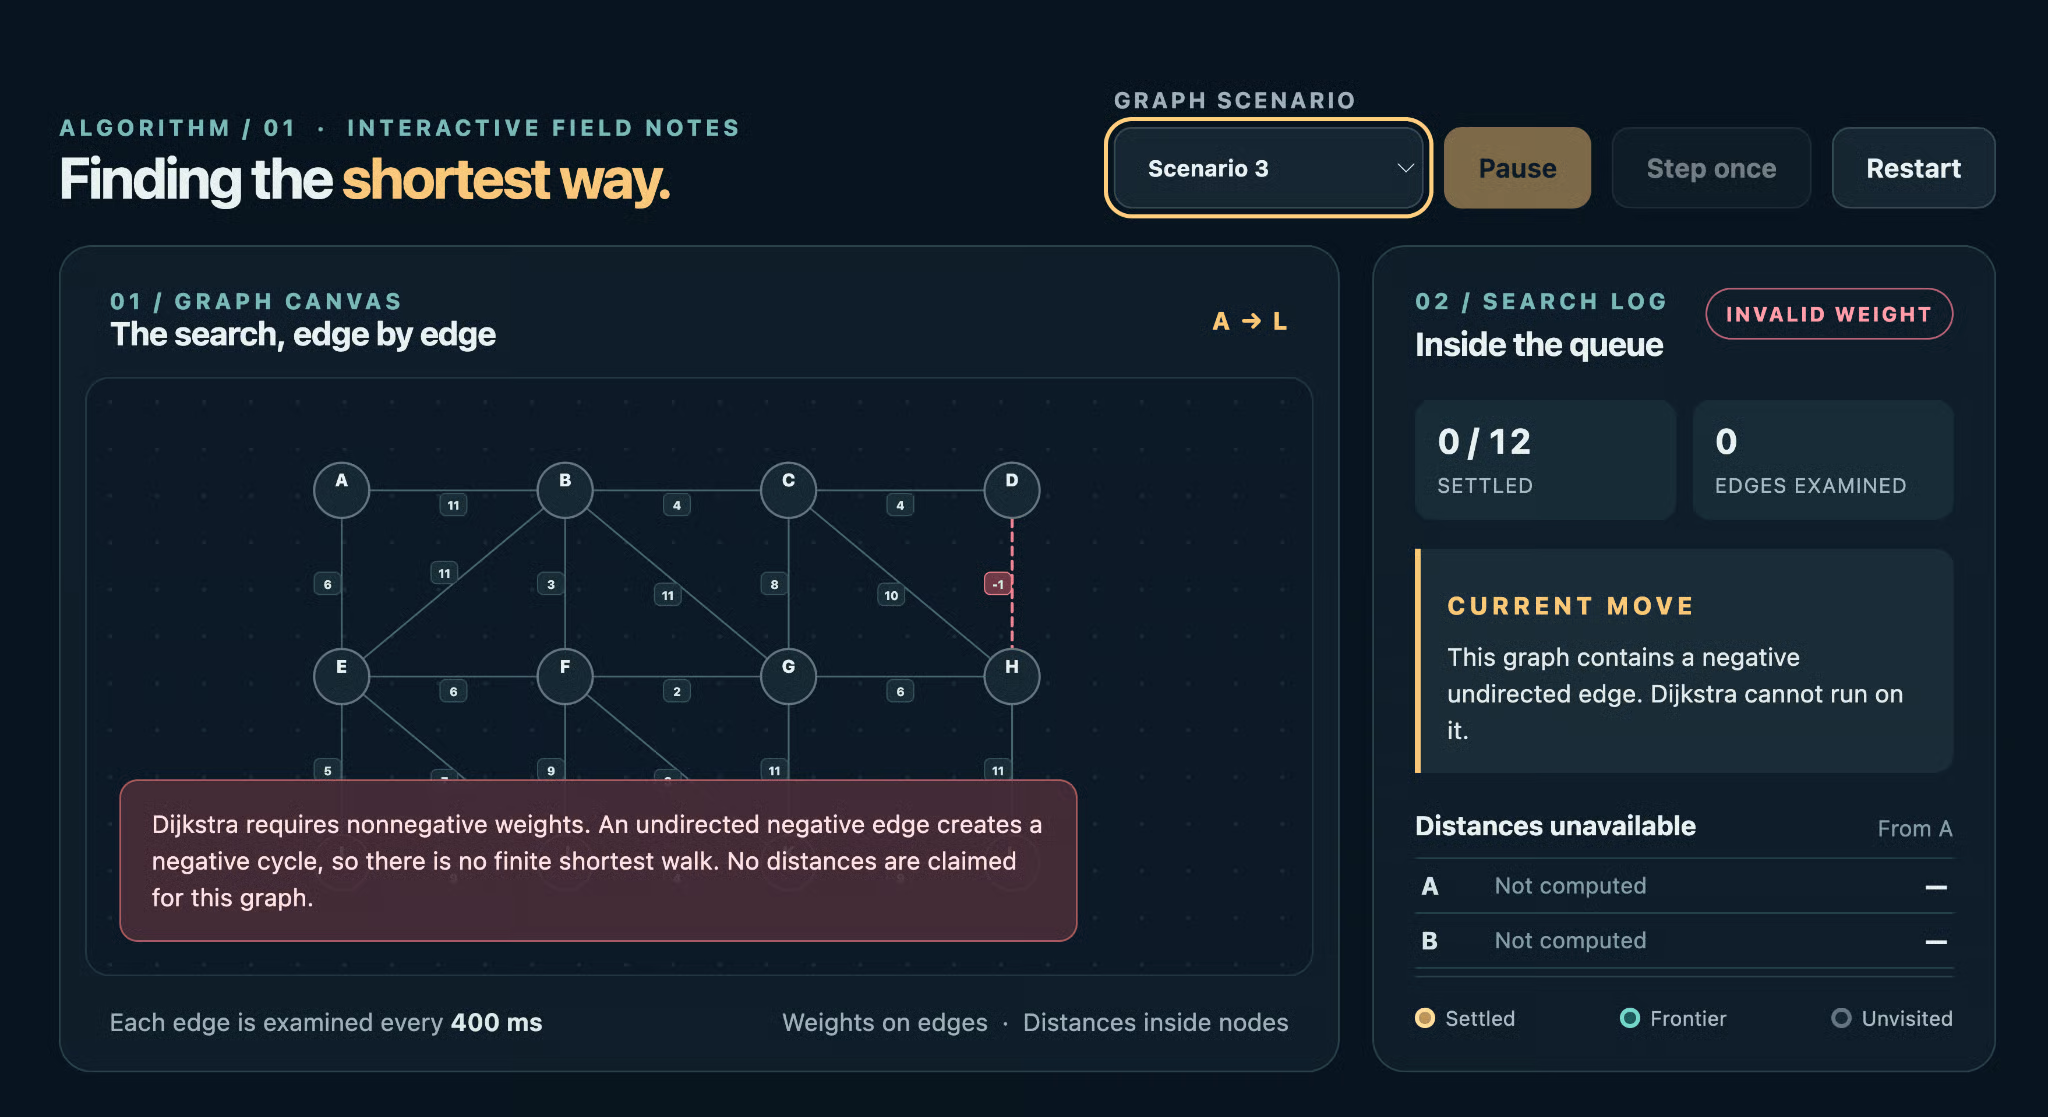
Diamo un'occhiata più da vicino. GPT-6 Sol ha rifiutato di eseguire l'algoritmo a causa del peso negativo e ha mostrato un messaggio di errore rosso ben visibile.
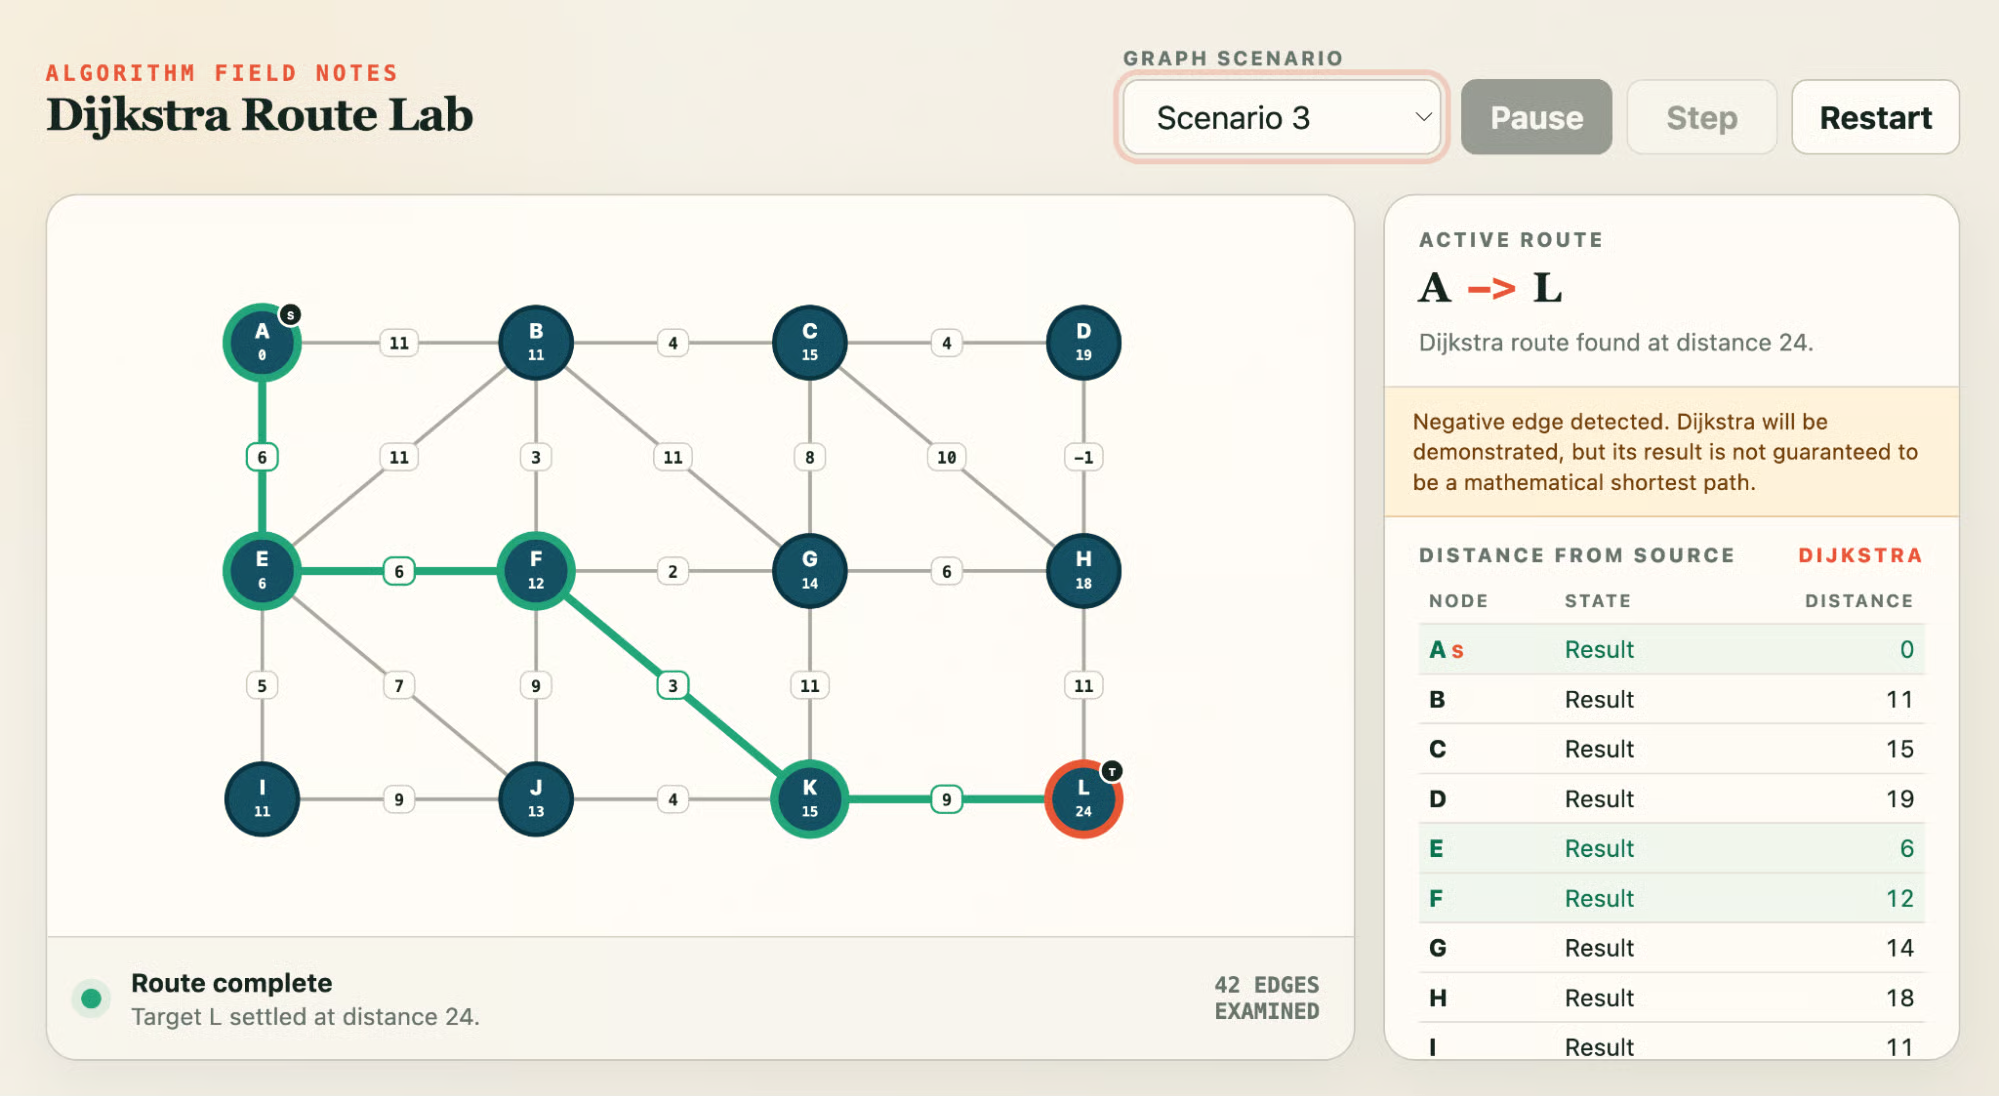
GPT‑5.6 Sol ha segnalato il peso negativo in una nota di avviso e poi ha eseguito comunque l'algoritmo, evidenziando un percorso e riempiendo la tabella delle distanze come se la risposta fosse valida. Un avviso accanto a una risposta sbagliata è comunque una risposta sbagliata. GPT‑5.6 Luna ha fatto la stessa cosa.
GPT‑6 Luna si è posizionato a metà: un banner che nomina l'arco e dichiara Dijkstra inapplicabile, poi una tabella delle distanze di infiniti negativi. Difendibile per un arco negativo non diretto, ma di lettura confusa.
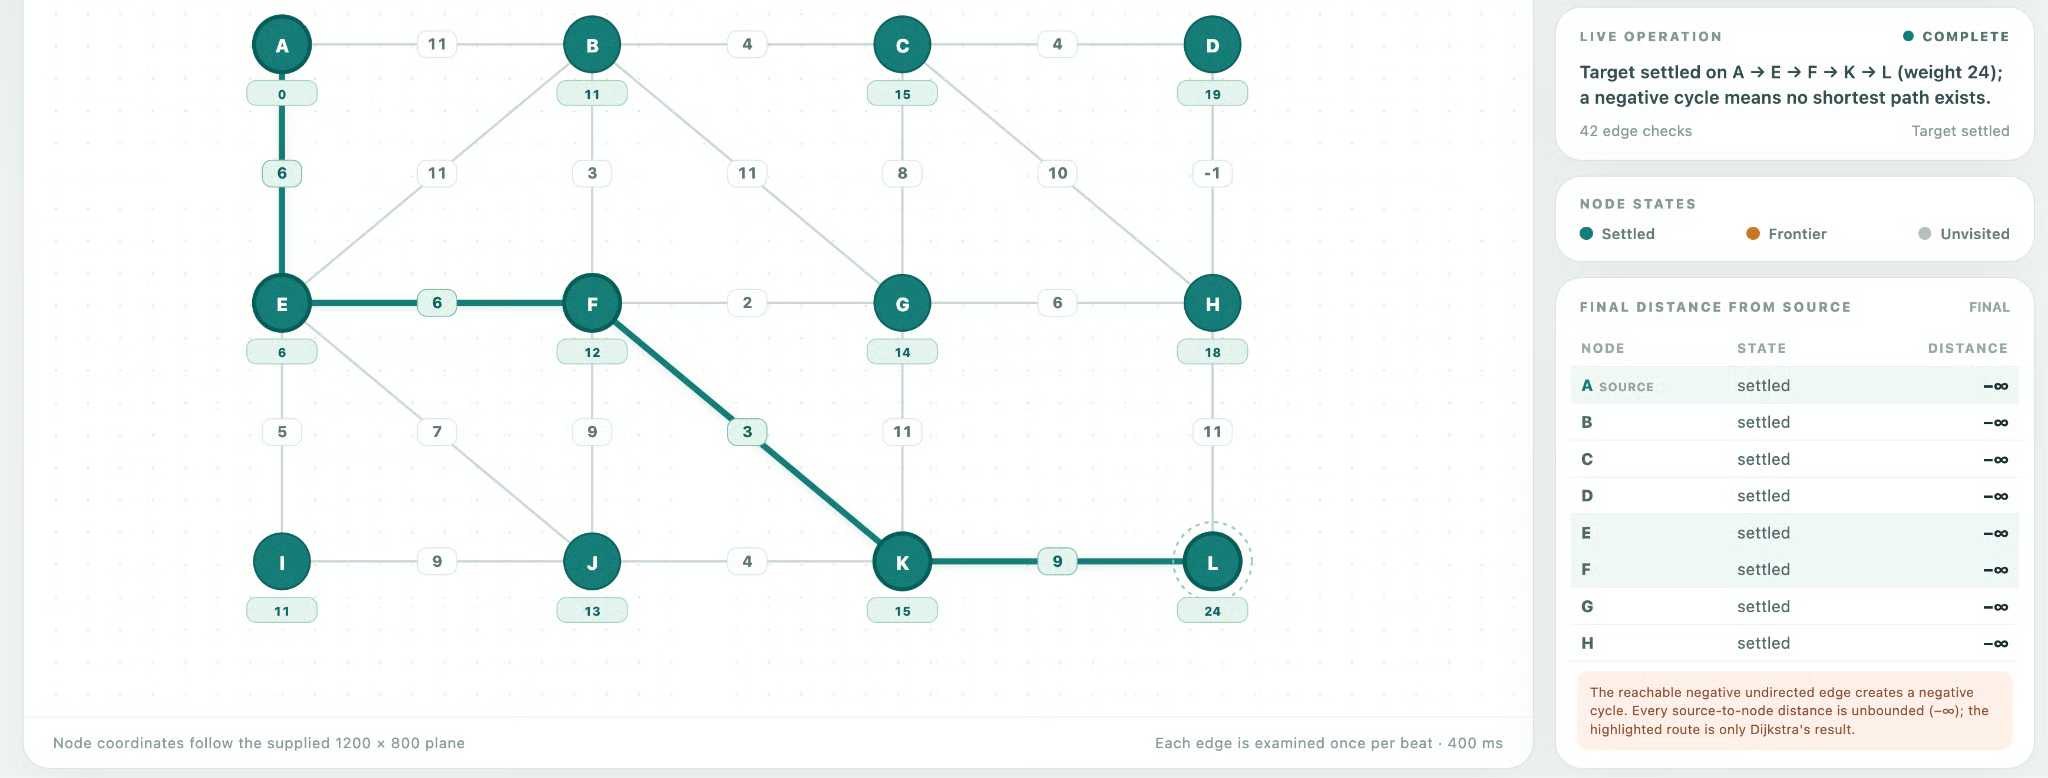
Quindi GPT‑6 è un vero passo avanti? Di poco, e solo su un aspetto, anche se importante. Sul task di build in sé, le generazioni sono in parità. La differenza sta interamente in come ciascun modello ha gestito un input che sapeva essere difettoso, cosa che riflette l'affermazione di OpenAI sull'onestà più che quella sul coding. Le due Luna non si sono differenziate affatto.
L'altra lezione riguarda il test: quando quattro modelli superano tutte le prove tranne una, l'asticella va alzata.
Ecco uno sguardo alla nuova struttura dei costi. Entrambi i tagli rappresentano una riduzione del 50% rispetto ai prezzi GPT‑5.6 dei rispettivi modelli.
| Per 1M token | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Input | $2 | $4 | $0.10 | $0.20 |
| Output | $10 | $20 | $0.50 | $1.20 |
Le letture di token di input in cache sono scontate del 90% su GPT‑6, quindi su lunghe esecuzioni di agent, il tasso di cache hit conta quanto il prezzo di listino. Il post di lancio di OpenAI non pubblica le tariffe batch per nessuno dei due modelli, e i due si collocano sotto i $10 input e $50 output di GPT‑6 Astra.
Le uniche condizioni di accesso nel post di lancio di OpenAI riguardano piano e superficie di prodotto, ed è qui che il quadro diventa specifico.
GPT‑6 Sol e Luna sono già disponibili su molte piattaforme:
ChatGPT Work e Codex per utenti Plus, Pro, Business, Enterprise ed Edu, con Luna disponibile anche per utenti Free e Go nell'app desktop.
Sull'API, sono disponibili come gpt-6-sol e gpt-6-luna. OpenAI segnala che il rollout su ChatGPT è scaglionato nell'arco della giornata, quindi potrebbe volerci un po' perché compaiano per tutti.
Inoltre, entrambi i modelli sono disponibili tramite OpenRouter (come openai/gpt-6-sol e openai/gpt-6-luna), in GitHub Copilot, su Azure AI Foundry e su AWS Bedrock.
Sull'API, sono disponibili come gpt-6-sol e gpt-6-luna. OpenAI segnala che il rollout su ChatGPT è scaglionato nell'arco della giornata, quindi potrebbe volerci un po' perché compaiano per tutti. Una chiamata minimale è questa:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Se stai migrando da GPT‑5.6, le linee guida sul modello GPT‑6 di OpenAI, scritte per Astra, dicono di rimuovere temperature e top_p, partire da low se usavi none o minimal e altrimenti mantenere il livello di effort attuale, e sostituire prompt_cache_retention con prompt_cache_options.ttl impostato a 30 minuti.
Sol e Luna prendono la ricetta di training dietro al top di gamma Astra e la usano per rendere il livello sottostante drasticamente più economico e veloce. Il comunicato di OpenAI nomina esplicitamente i modelli di Anthropic e rivendica vittorie su benchmark corretti per il costo. È un confronto interessante perché anche Opus 5.5 è una vittoria in efficienza.
La mia lettura: se esegui carichi di lavoro di agent o coding su GPT‑5.6 Sol o Luna, passa subito. Stessa scala di effort, metà del prezzo e, nel nostro test, l'unica cosa che GPT‑6 Sol ha fatto e il suo predecessore no è stata rifiutarsi di dare una risposta sicura a una domanda a cui l'algoritmo non poteva rispondere. Se usi Claude, i numeri corretti per il costo sono l'argomento per fare un confronto tuo invece di prendere per buone le parole di OpenAI.
Se vuoi costruire su questi modelli, ti consiglio l'skill track OpenAI Fundamentals, che copre l'API end-to-end in 15 ore.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min