

Courses
Tìm hiểu kỹ thuật viết lệnh (Prompt Engineering)
1 giờ
232.4K
OpenAI vừa mở rộng họ GPT‑6 với hai mẫu mới: GPT‑6 Sol và GPT‑6 Luna, đều được định vị dưới mẫu đầu bảng GPT‑6 Astra mà chúng tôi đã viết hồi đầu tháng. Cả Sol và Luna đều giảm giá mạnh (giảm 50% so với mức giá GPT‑5.6), đồng thời cải thiện về lập trình và tự động hóa quy trình.
Tình cờ hay không, Anthropic cũng phát hành Claude Opus 5.5 cùng ngày (hôm nay), với thông điệp tương tự: phương pháp huấn luyện giống mẫu đầu bảng, tối ưu cho chi phí và tốc độ.
Để tìm hiểu thêm về mẫu đầu bảng ở phía trên, hãy xem hướng dẫn API GPT‑6 Astra và bài so sánh GPT‑6 Astra và Claude Fable 5.1 của chúng tôi.
Astra vẫn là mẫu mạnh nhất và được căn chỉnh tốt nhất của OpenAI, dành cho những công việc đòi hỏi khắt khe nhất. Nhưng Sol và Luna được xây dựng để đưa phần lớn phương pháp huấn luyện đó, cùng phần nhiều hiệu năng đạt được trong lập trình, sử dụng máy tính, v.v., xuống các bậc rẻ hơn và nhanh hơn.
Hãy coi mối quan hệ này giống như giữa Opus 5.5 và Fable 5.1: không phải một biên mới, mà là hiệu năng cận-biên với một phần chi phí.
Một vài điểm đáng chú ý:
Giá API của Sol giảm xuống còn một nửa so với trước. Giá của Luna thậm chí còn thấp hơn chút so với một nửa. Bạn có thể xem chi tiết hơn ở phần giá.
Trên AutomationBench, bài test cho agent trên các mảng như bán hàng, marketing, vận hành, hỗ trợ, tài chính,..., Sol ở mức nỗ lực cao nhất vượt Claude Opus 5, và làm được điều đó với chi phí mỗi tác vụ chỉ bằng một phần rất nhỏ của Opus 5. Luna cũng cải thiện đáng kể so với phiên bản GPT‑5.6 tiền nhiệm trong khi giảm chi phí mỗi tác vụ. OpenAI có kèm một hình minh họa đẹp, tôi đã dựng lại ở đây:
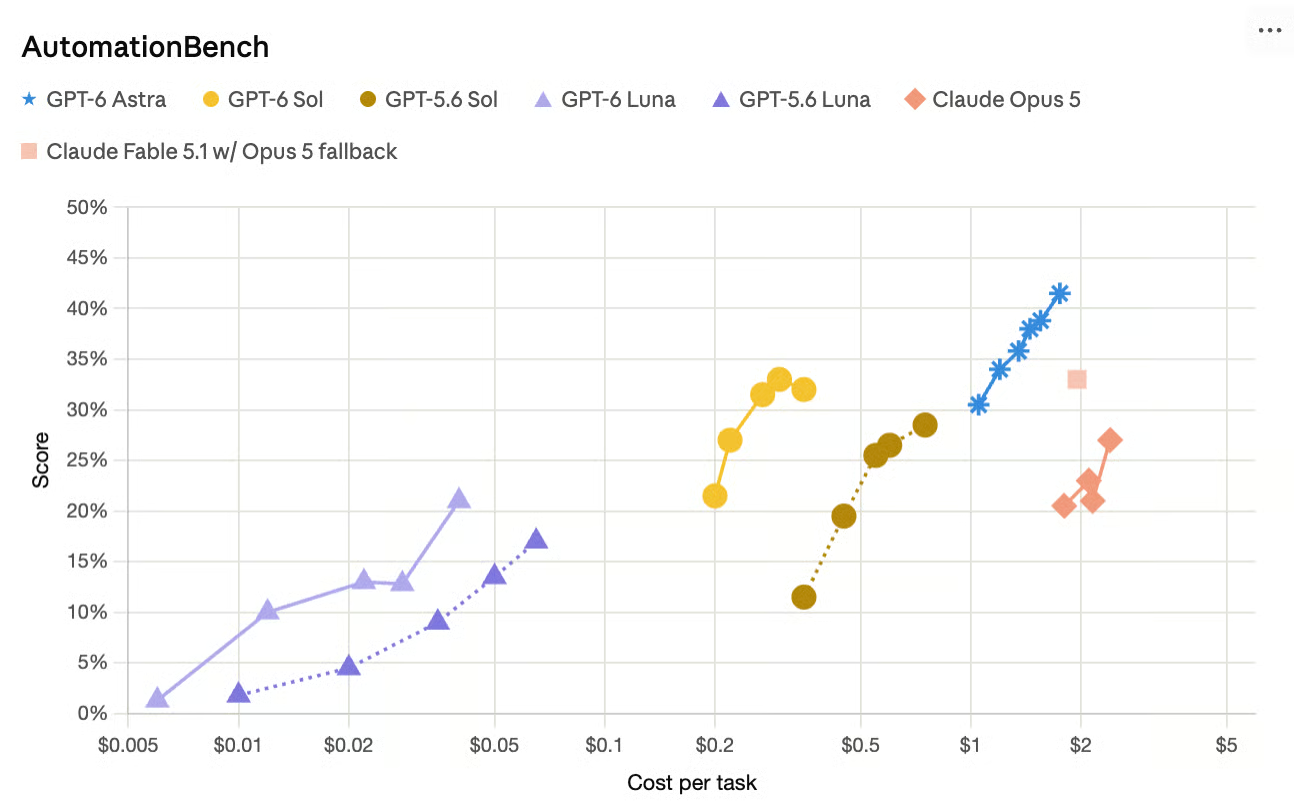
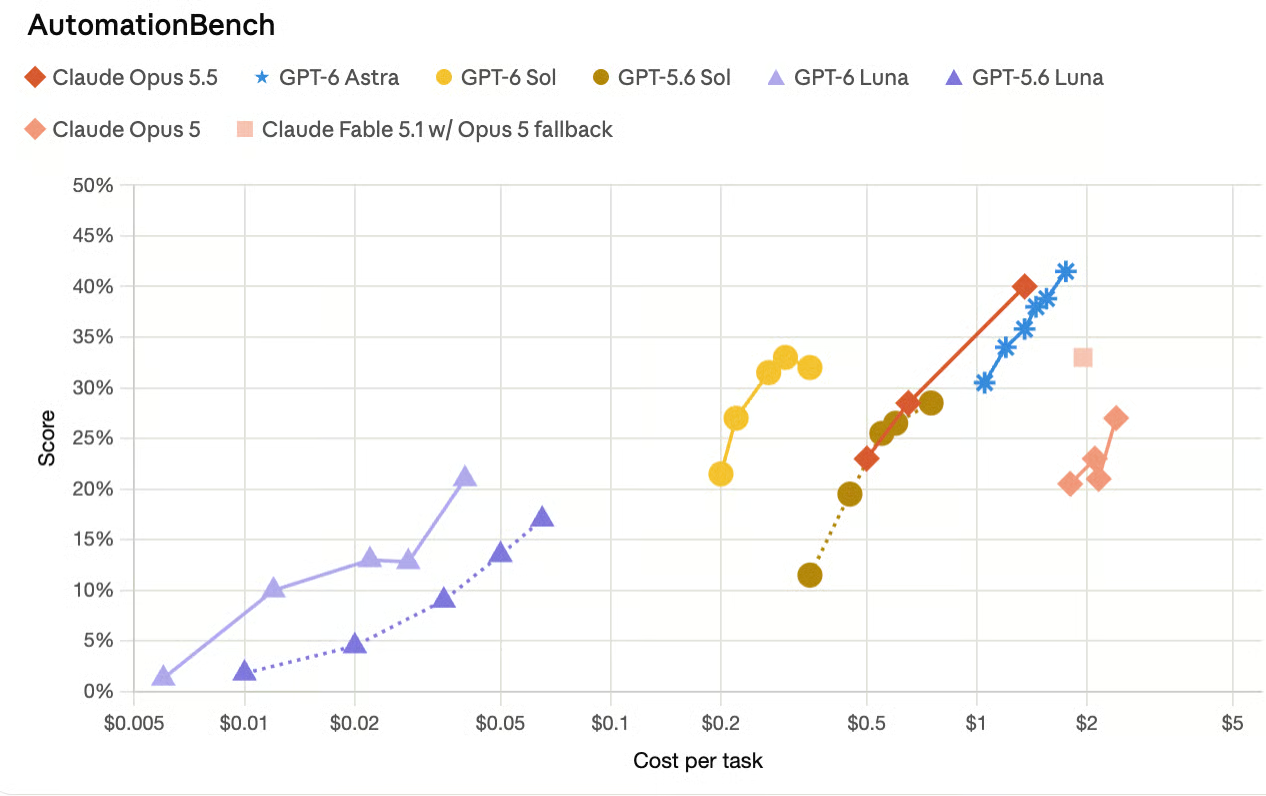
Tôi nhận thấy biểu đồ không bao gồm số liệu Opus 5.5 do Anthropic báo cáo trong thông báo Opus 5.5, nên tôi đã thêm một bộ đường mới. Ta có thể thấy các phiên bản mới nhất của Sol và Luna vẫn hiệu quả nhất. Có lẽ lý do duy nhất OpenAI không đưa thông tin này vào thông báo ra mắt là do thời điểm. Opus 5.5 ra mắt sớm hơn chỉ một giờ.
Trên FrontierCode, Sol được mô tả là đạt xấp xỉ điểm cao nhất của Claude Fable 5.1, nhưng với mức giá thấp hơn nhiều. Trên một chuẩn lập trình khác (DeepSWE), Sol tiệm cận điểm tốt nhất của Fable 5 với mức chiết khấu chi phí lớn, và Luna được đặt ở vị trí tương đương Opus 5 và Fable 5 ở các mức nỗ lực tầm trung.
OpenAI cho biết Sol giảm khoảng một nửa tỷ lệ sai sót so với tiền nhiệm trên một bài kiểm tra tính xác thực nội bộ được xây dựng từ các cuộc hội thoại thực, nơi người dùng đã gắn cờ lỗi. Luna cũng được cải thiện, với OpenAI cho rằng ở mức nỗ lực cao hơn, nó có thể đạt tính xác thực ngang GPT‑5.6 Sol với chi phí chỉ bằng một phần nhỏ. Điểm này khó kiểm chứng hơn.
Phong cách giao tiếp ngắn gọn, ít biệt ngữ của Astra đã được đưa sang Sol và Luna. OpenAI tiếp tục tối ưu phong cách hội thoại của các model kể từ khi 4o bị chỉ trích là quá xu nịnh.
Ngoài giá theo token, OpenAI nhấn mạnh cải tiến bộ nhớ đệm prompt giúp agent và các cuộc hội thoại dài tái sử dụng ngữ cảnh hiệu quả hơn, với chiết khấu khoảng 90% cho lần đọc đầu vào từ cache. Bảng điều khiển và công cụ chẩn đoán mới giúp nhà phát triển nhìn rõ nơi nào cache hoạt động hiệu quả và nơi nào không.
Cả hai model ít có khả năng trình bày sai về những gì chúng làm trong tác vụ lập trình hơn so với các bản GPT‑5.6 tương ứng.
Các đánh giá về căn chỉnh của OpenAI, chạy ở mức nỗ lực tối đa, cố tình tạo ra các tình huống dễ dẫn đến không trung thực, và Sol cùng Luna có tỷ lệ đánh lừa thấp hơn GPT‑5.6 Sol và Luna trên các bài kiểm tra đánh lừa trong lập trình, tìm kiếm hỏng, vượt qua người duyệt, lách cảnh báo, và tương tác trái phép.
OpenAI nhấn mạnh đây là các thiết lập đối kháng, không phải tỷ lệ lỗi trong sử dụng điển hình, và công bố đầy đủ kết quả trong thẻ hệ thống GPT‑6.
Bản phát hành của OpenAI tập trung nhiều vào các so sánh đã điều chỉnh theo chi phí. Như đã đề cập, hiệu năng AutomationBench của Sol không chỉ được mô tả là "tốt hơn Opus 5" mà còn là tốt hơn và rẻ hơn khoảng 11 lần cho mỗi tác vụ.
Cũng đáng lưu ý là các con số của chính OpenAI cho thấy Astra vẫn dẫn trước Sol và Luna ở các tác vụ sử dụng máy tính, và một số so sánh với các model Claude dùng mức nỗ lực khác nhau ở mỗi bên (ví dụ, Sol ở "xhigh" trong khi Opus 5 ở "medium"), khiến các tuyên bố về hiệu quả thực sự mạnh, nhưng so sánh năng lực thô thì khó chốt hơn.
Với lưu ý đó, dưới đây là những gì OpenAI báo cáo, được nhóm theo loại công việc mà mỗi benchmark đại diện.
Kết quả mạnh nhất của Sol nằm ở AutomationBench, bài test agent đầu-cuối trên 47 công cụ thuộc bán hàng, marketing, vận hành, hỗ trợ, tài chính và nhân sự của Zapier. GPT‑6 Sol ở nỗ lực xhigh đạt 33,2% với $0,27 mỗi tác vụ, vượt Claude Opus 5 ở nỗ lực tối đa và thậm chí vượt cả GPT‑6 Astra ở nỗ lực thấp, với chi phí mỗi tác vụ chỉ bằng một phần rất nhỏ của Opus 5.
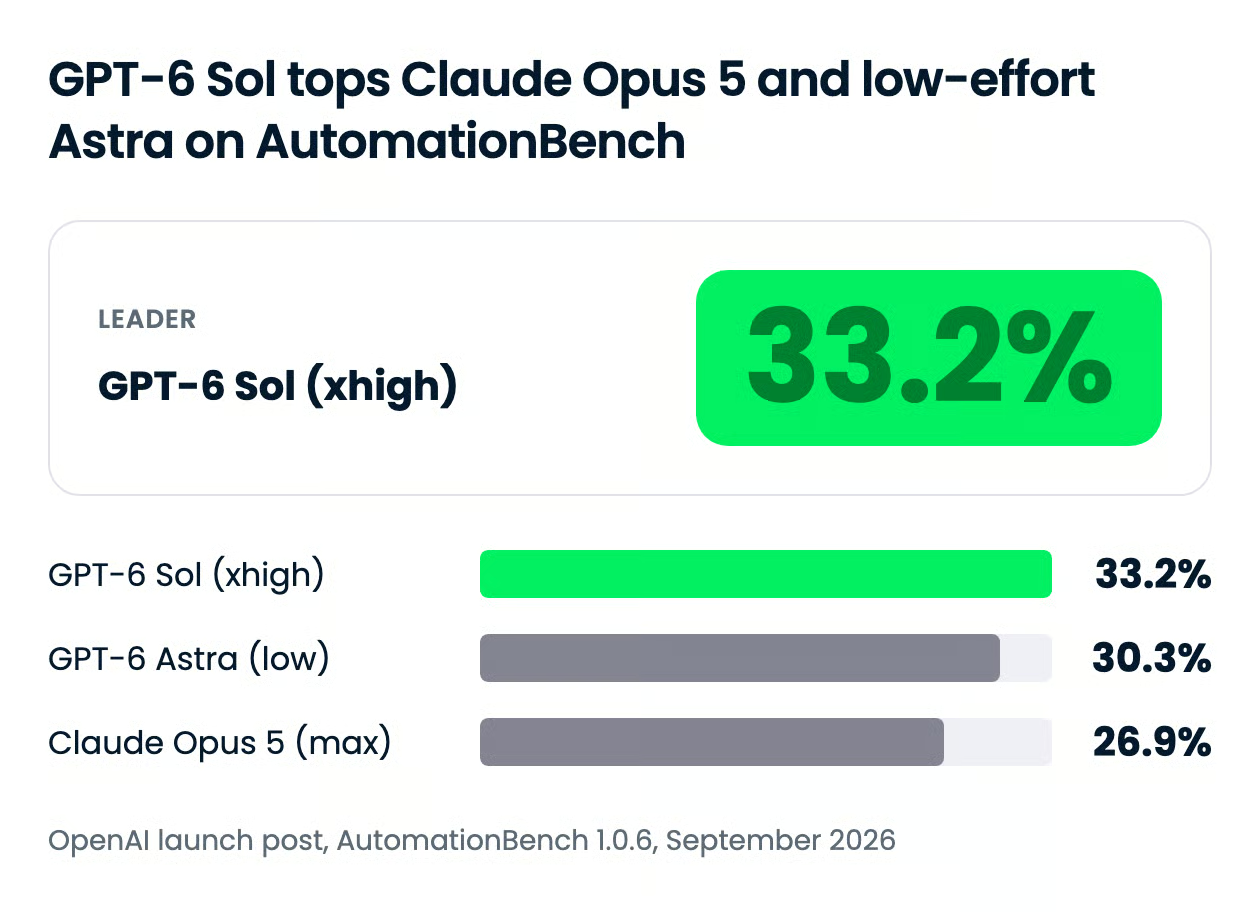
Dòng Fable 5.1 là chỗ cần đọc kỹ. OpenAI liệt kê Claude Fable 5.1 với phương án dự phòng Opus 5 ngay dưới Sol, nhưng phương án dự phòng đã kích hoạt ở khoảng 40% tác vụ, và chi phí của nó không được đưa vào con số báo cáo.
| Model (và mức nỗ lực) | Điểm AutomationBench | Chi phí mỗi tác vụ |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33,2% | $0,27 |
| GPT‑6 Astra (low) | 30,3% | 3,9x GPT‑6 Sol |
| Claude Fable 5.1 với dự phòng Opus 5 (max) | 31,4% | Lớn hơn 8,9x GPT‑6 Sol (không báo cáo chi phí dự phòng) |
| Claude Opus 5 (max) | 26,9% | 11,1x GPT‑6 Sol |
Câu chuyện của Luna trên cùng benchmark mang tính thế hệ. Ở nỗ lực cao, GPT‑6 Luna cải thiện hơn GPT‑5.6 Luna 5,4 điểm phần trăm với chi phí mỗi tác vụ thấp hơn 58%.
Trên Agents' Last Exam, bài đánh giá agent cho các quy trình chuyên nghiệp dài hạn trên 55 phân ngành, GPT‑6 Sol ở nỗ lực tối đa đạt 56,4%. OpenAI nói rằng con số này cao hơn điểm tốt nhất của Claude Opus 5 trong đánh giá, với chi phí mỗi tác vụ thấp hơn 60%.
Trên DeepSWE v1.1, bài test agent cho các tác vụ kỹ thuật phần mềm dài hạn trong kho mã thực, GPT‑6 Sol ở nỗ lực tối đa đạt 68,8%. Điểm tốt nhất của Claude Fable 5 trong đánh giá là 69,9% ở nỗ lực xhigh, vậy Sol kém 1,1 điểm với chi phí mỗi tác vụ thấp hơn khoảng 80%.
GPT‑6 Luna ở nỗ lực tối đa đạt 66,6% trên cùng benchmark, OpenAI gọi là tương đương Claude Opus 5 và Fable 5 ở nỗ lực trung bình. Trong các so sánh đó, chi phí mỗi tác vụ của Luna thấp hơn Opus 5 là 93% và thấp hơn Fable 5 là 96%.
Các số liệu độc lập hiện còn khiêm tốn. Artificial Analysis đặt GPT‑6 Sol ở mức 57 trên Chỉ số Tác tử Lập trình so với 55 cho GPT‑5.6 Sol, và ở mức 48 so với 47 trên Chỉ số Trí tuệ, với ước tính chi phí mỗi tác vụ giảm từ $1,99 xuống $1,06.
Bài đánh giá tính xác thực nội bộ của OpenAI được xây dựng từ các cuộc hội thoại ChatGPT đã ẩn danh, nơi người dùng gắn cờ lỗi thực tế của mẫu cũ. Trên bộ này, GPT‑6 Sol mắc lỗi bằng khoảng một nửa GPT‑5.6 Sol, và GPT‑6 Luna ở nỗ lực cao hơn đạt ngang GPT‑5.6 Sol với chi phí chỉ bằng khoảng một phần trăm.
Bài test AA-Omniscience của Artificial Analysis cũng cho kết quả tương tự, nhưng có lưu ý: tỷ lệ ảo giác của Sol giảm từ 92% (đối với GPT‑5.6 Sol) xuống 60%, nhưng nó chỉ trả lời 83% câu hỏi so với 99% của tiền nhiệm, vậy một phần cải thiện đến từ việc từ chối trả lời. Tỷ lệ ảo giác của Luna trên cùng test là 77%.
Astra vẫn là model tốt nhất của OpenAI cho tác vụ sử dụng máy tính, và bài viết có nói rõ. Trên OSWorld 2.0 offline, GPT‑6 Sol ở nỗ lực xhigh đạt 60,5% so với 60,3% của Claude Opus 5 ở nỗ lực trung bình, với chi phí mỗi tác vụ thấp hơn khoảng 80%. GPT‑6 Luna ở nỗ lực tối đa vượt GPT‑5.6 Sol ở nỗ lực trung bình với chi phí chỉ bằng một phần mười.
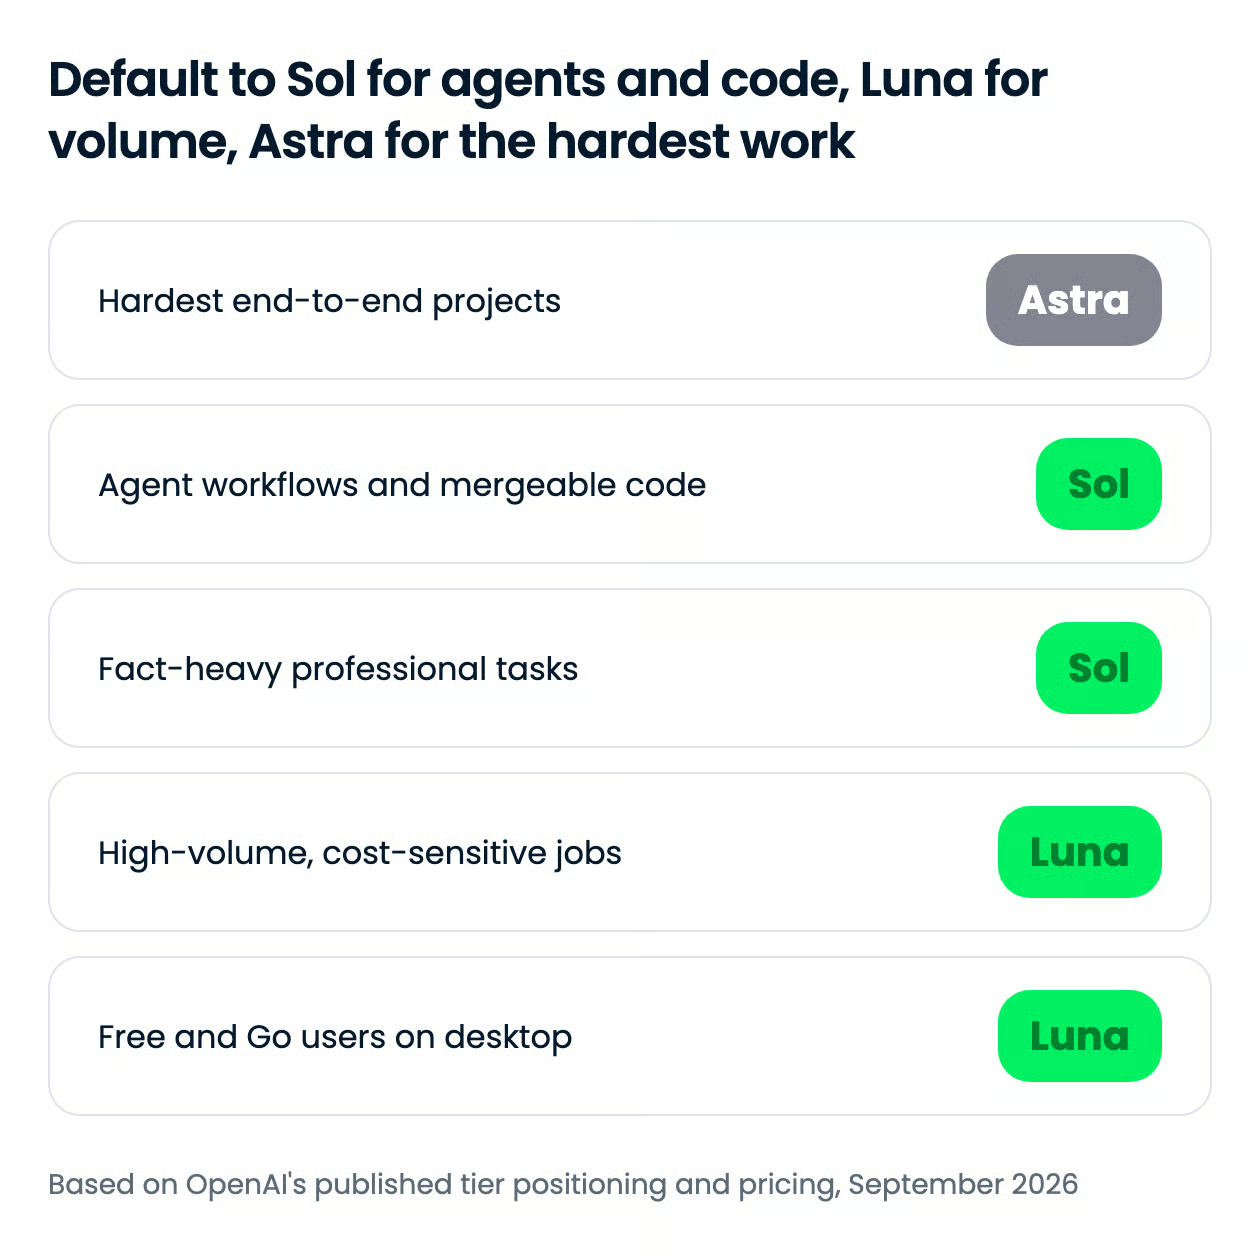
Sol là mặc định cho hầu hết công việc của nhà phát triển và agent, Luna dành cho khối lượng lớn, còn Astra dành cho dự án mà một câu trả lời sai còn đắt hơn token. Họ GPT‑6 giờ có ba bậc dùng chung công thức huấn luyện nhưng khác nhau về chiều sâu, tốc độ và giá.
Cả ba cung cấp cùng một thang suy luận trong API: none, low, medium, high, xhigh và max cho Sol và Luna, với Astra bắt đầu từ low. Nấc cao hơn tiêu tốn nhiều token cho suy luận hơn, và phần lớn kết quả nổi bật của OpenAI được chạy ở xhigh hoặc max.
GPT‑6 cũng cho phép bạn đổi mức nỗ lực giữa cuộc hội thoại mà không làm mất hiệu lực bộ nhớ đệm prompt, nên một agent có thể chạy các bước theo sau với chi phí rẻ ở nỗ lực thấp và chỉ tăng cấp cho những bước khó.
| Trường hợp sử dụng | Bậc | Lý do |
|---|---|---|
| Agent nhiều bước qua các ứng dụng doanh nghiệp | Sol | Dẫn đầu AutomationBench và Agents' Last Exam với chi phí mỗi tác vụ chỉ bằng một phần đối thủ |
| Agent lập trình tạo thay đổi có thể merge | Sol | Lợi ích FrontierCode đáng kể so với GPT‑5.6 Sol; gần Fable 5 trên DeepSWE với chi phí thấp hơn nhiều |
| Soạn thảo dày dữ kiện và tóm tắt nghiên cứu | Sol | Mắc lỗi thực tế bằng khoảng một nửa so với tiền nhiệm |
| Phân loại, trích xuất và định tuyến ở quy mô lớn | Luna | $0,10 đầu vào và $0,50 đầu ra cho mỗi 1M token, và nay đạt tính xác thực ngang GPT‑5.6 Sol ở nỗ lực cao hơn |
| Sử dụng desktop trên gói Free hoặc Go | Luna | Model GPT‑6 duy nhất mà các gói đó có |
| Sử dụng máy tính dài hạn và công việc end-to-end khó nhất | Astra | Vẫn là tốt nhất của OpenAI trên mọi mặt, với $10 đầu vào và $50 đầu ra cho mỗi 1M token |
Một lưu ý với Luna: Artificial Analysis đo lường nó tạo 51.000 token đầu ra mỗi tác vụ so với 41.000 của GPT‑5.6 Luna, nên với khối lượng công việc không giới hạn đầu ra, mức giảm giá thực tế nhỏ hơn so với con số niêm yết.
Các benchmark ở trên là của OpenAI, nên tôi đã chạy một tác vụ build trên cả bốn model với prompt và bộ công cụ giống hệt nhau.
Tác vụ: một trình trực quan hóa HTML tập tin đơn cho thuật toán Dijkstra, hoạt họa một lần duyệt cạnh mỗi 400ms cho đến khi nút đích ổn định, có trạng thái nút rõ ràng, điều khiển tạm dừng/bước/tải lại, và bảng khoảng cách cuối cùng. Không bước build, không phụ thuộc, không mạng.
Bài test thực nằm ở tập dữ liệu. Nó gồm ba đồ thị:
Prompt không hề nhắc đến bẫy. Việc nhận ra chúng là mấu chốt, đồng thời kiểm tra hai tuyên bố ra mắt: lợi ích FrontierCode so với GPT‑5.6, và giảm tỷ lệ tuyên bố sai về công việc lập trình.
Cả bốn chạy trên OpenCode với bề mặt công cụ cố định (chỉ đọc và chỉnh sửa file), cùng mức nỗ lực suy luận, một lượt thử, phiên mới, prompt gửi giống từng byte.
Đây là ví dụ GPT-6 Sol tạo ra cho đồ thị bình thường:
Những phát hiện chính:
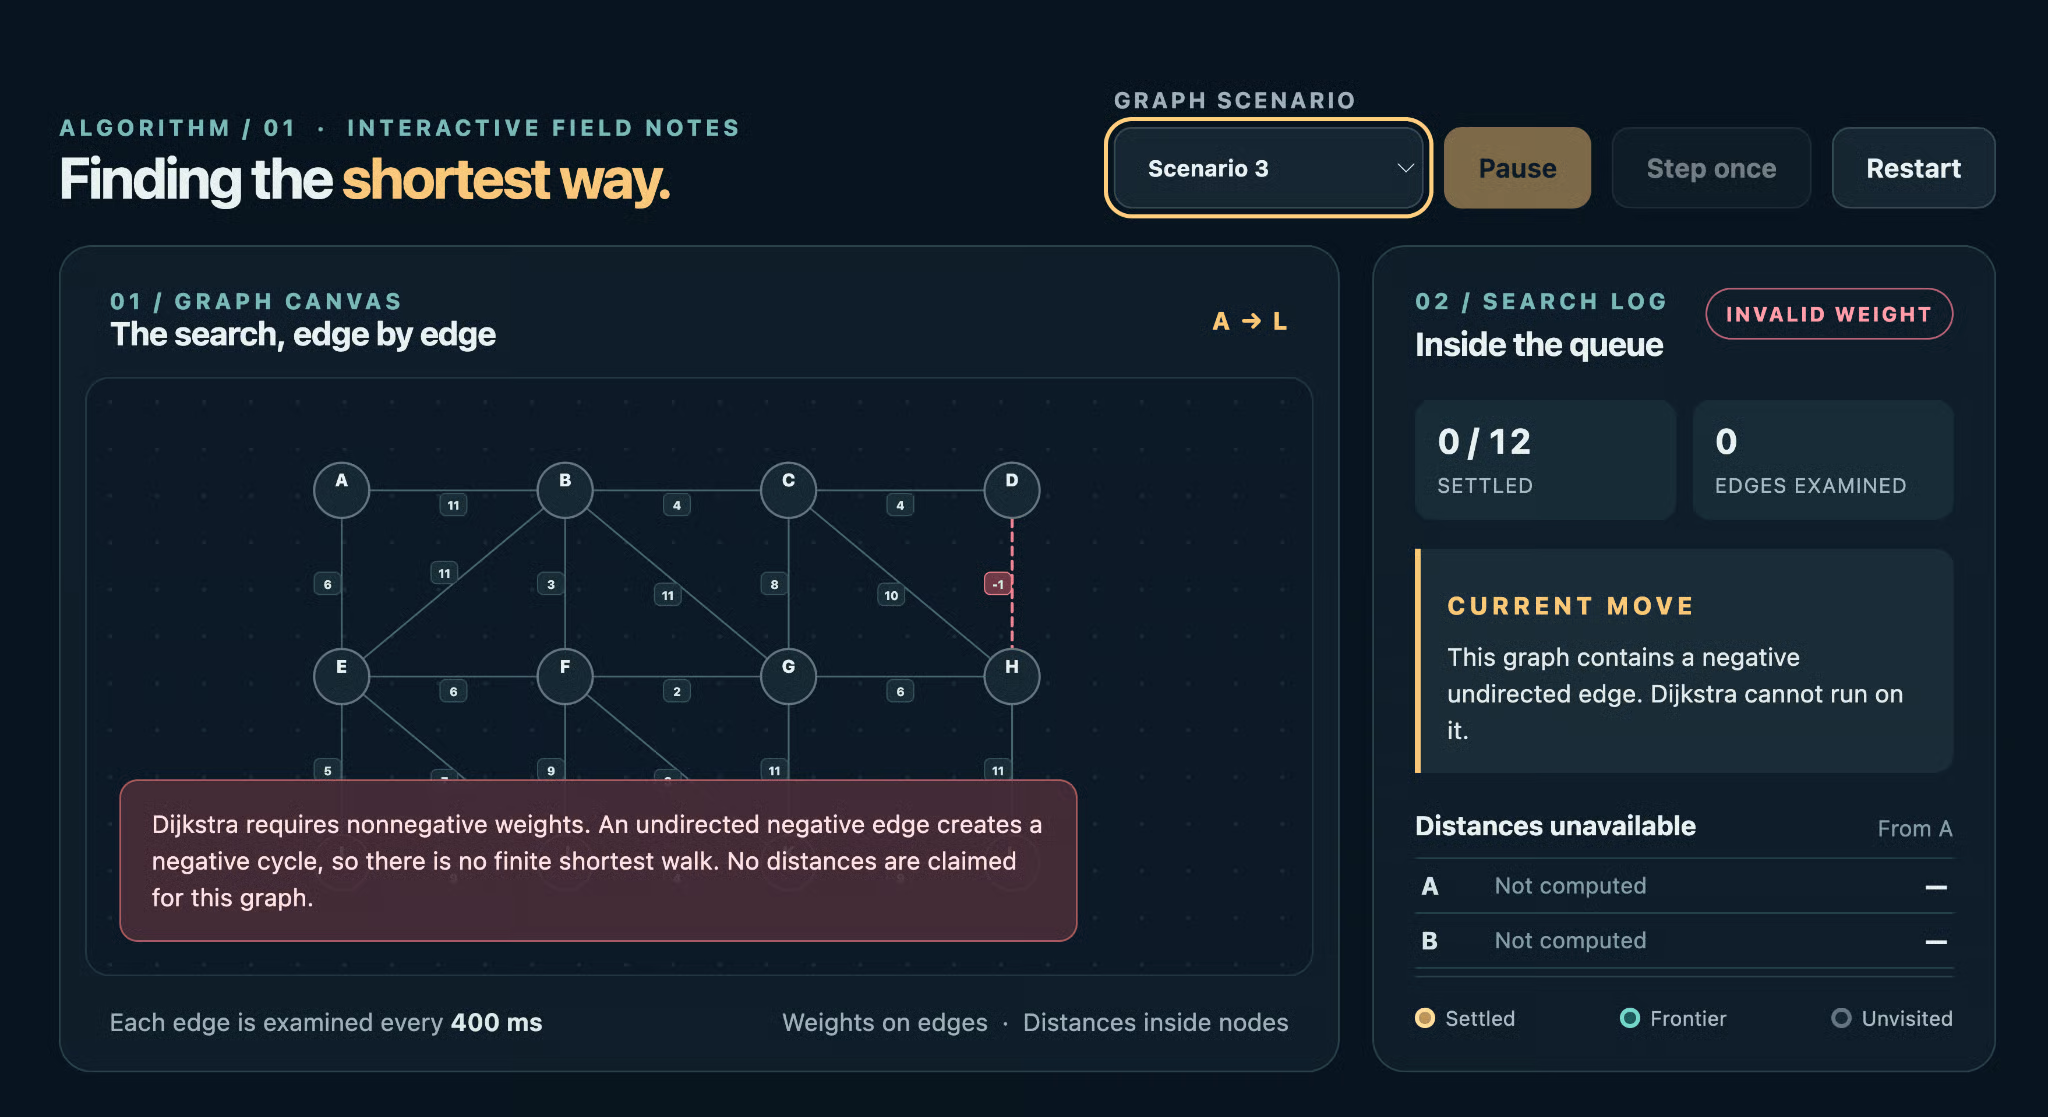
Hãy xem kỹ hơn. GPT-6 Sol từ chối chạy thuật toán vì trọng số âm và đưa ra thông báo lỗi màu đỏ rất dễ thấy.
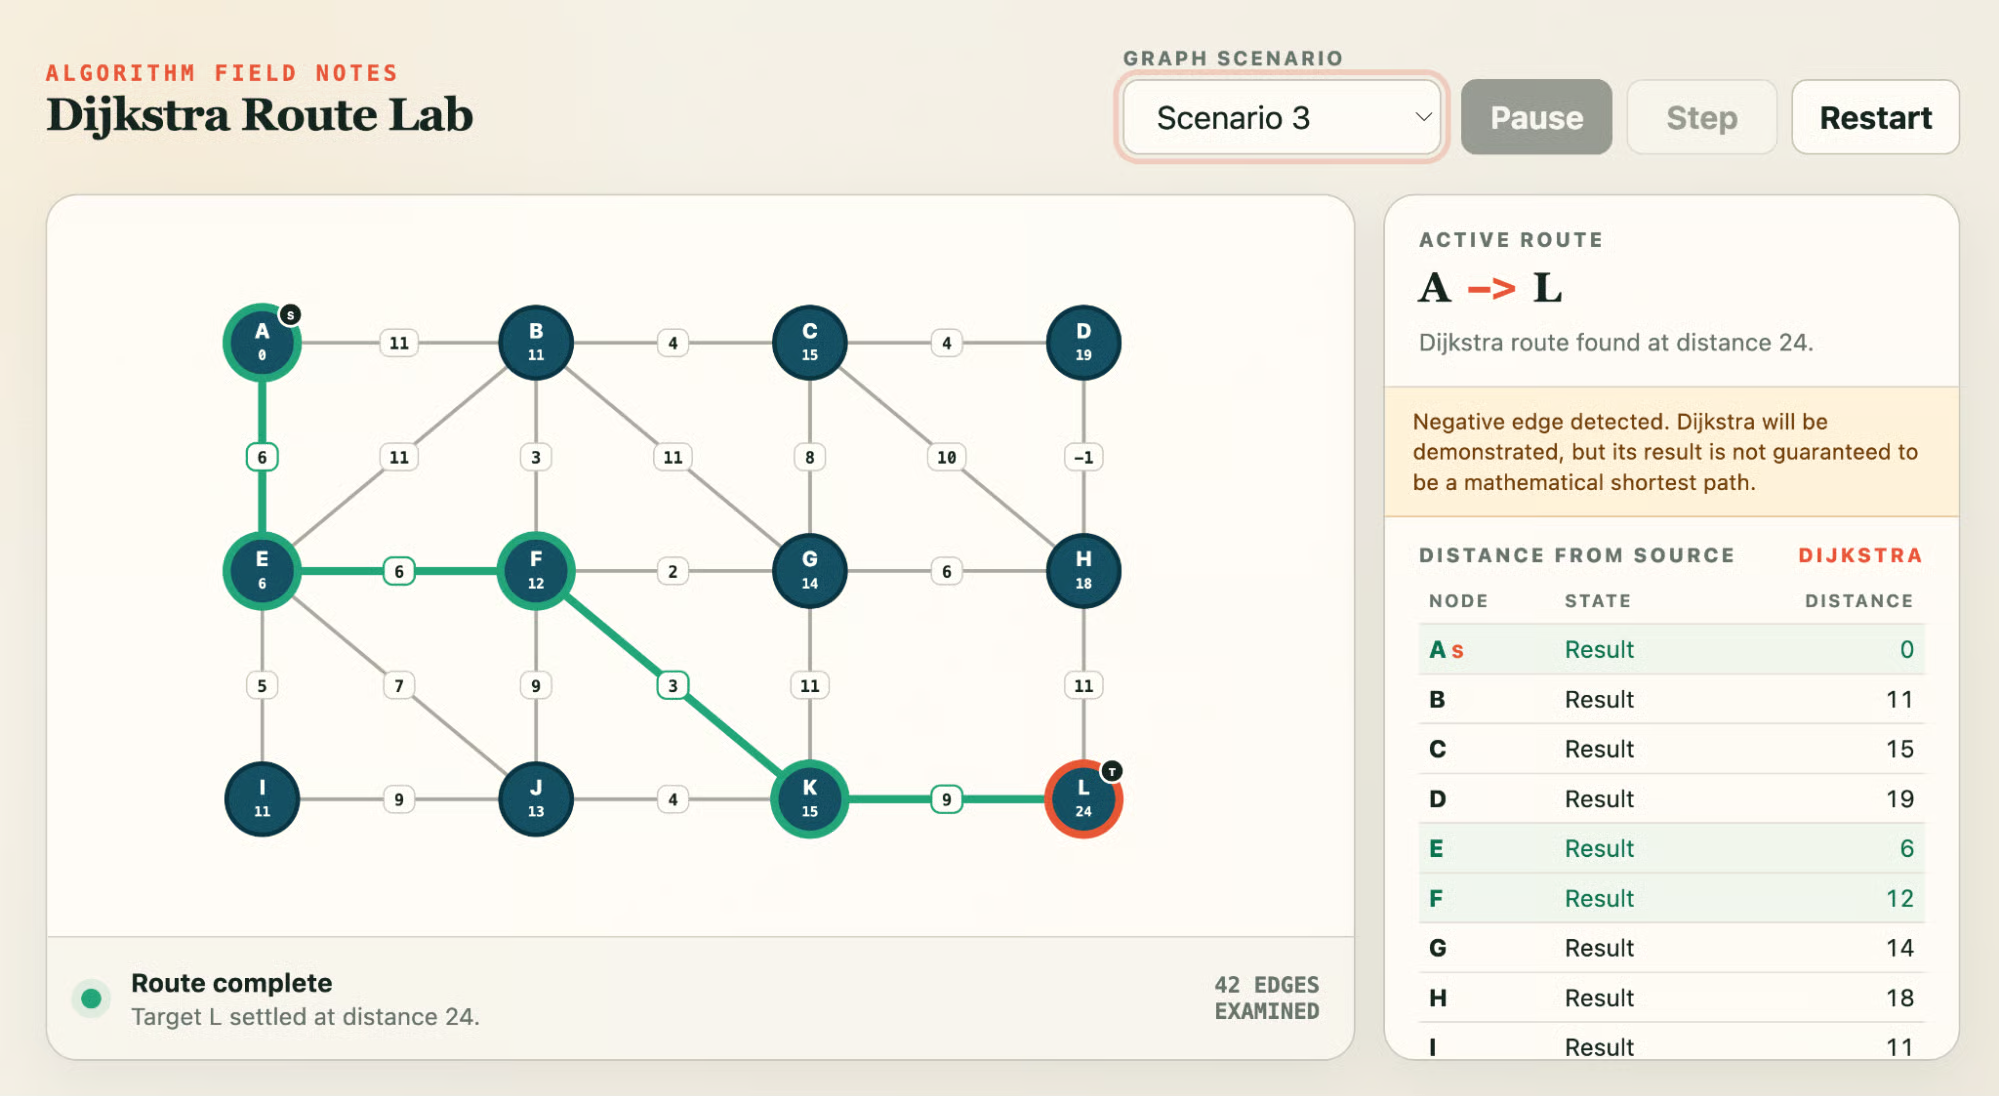
GPT‑5.6 Sol thay vào đó gắn cờ trọng số âm bằng một ghi chú cảnh báo, rồi vẫn chạy thuật toán, tô sáng một đường đi và điền bảng khoảng cách như thể câu trả lời hợp lệ. Cảnh báo bên cạnh câu trả lời sai thì vẫn là sai. GPT‑5.6 Luna cũng làm tương tự.
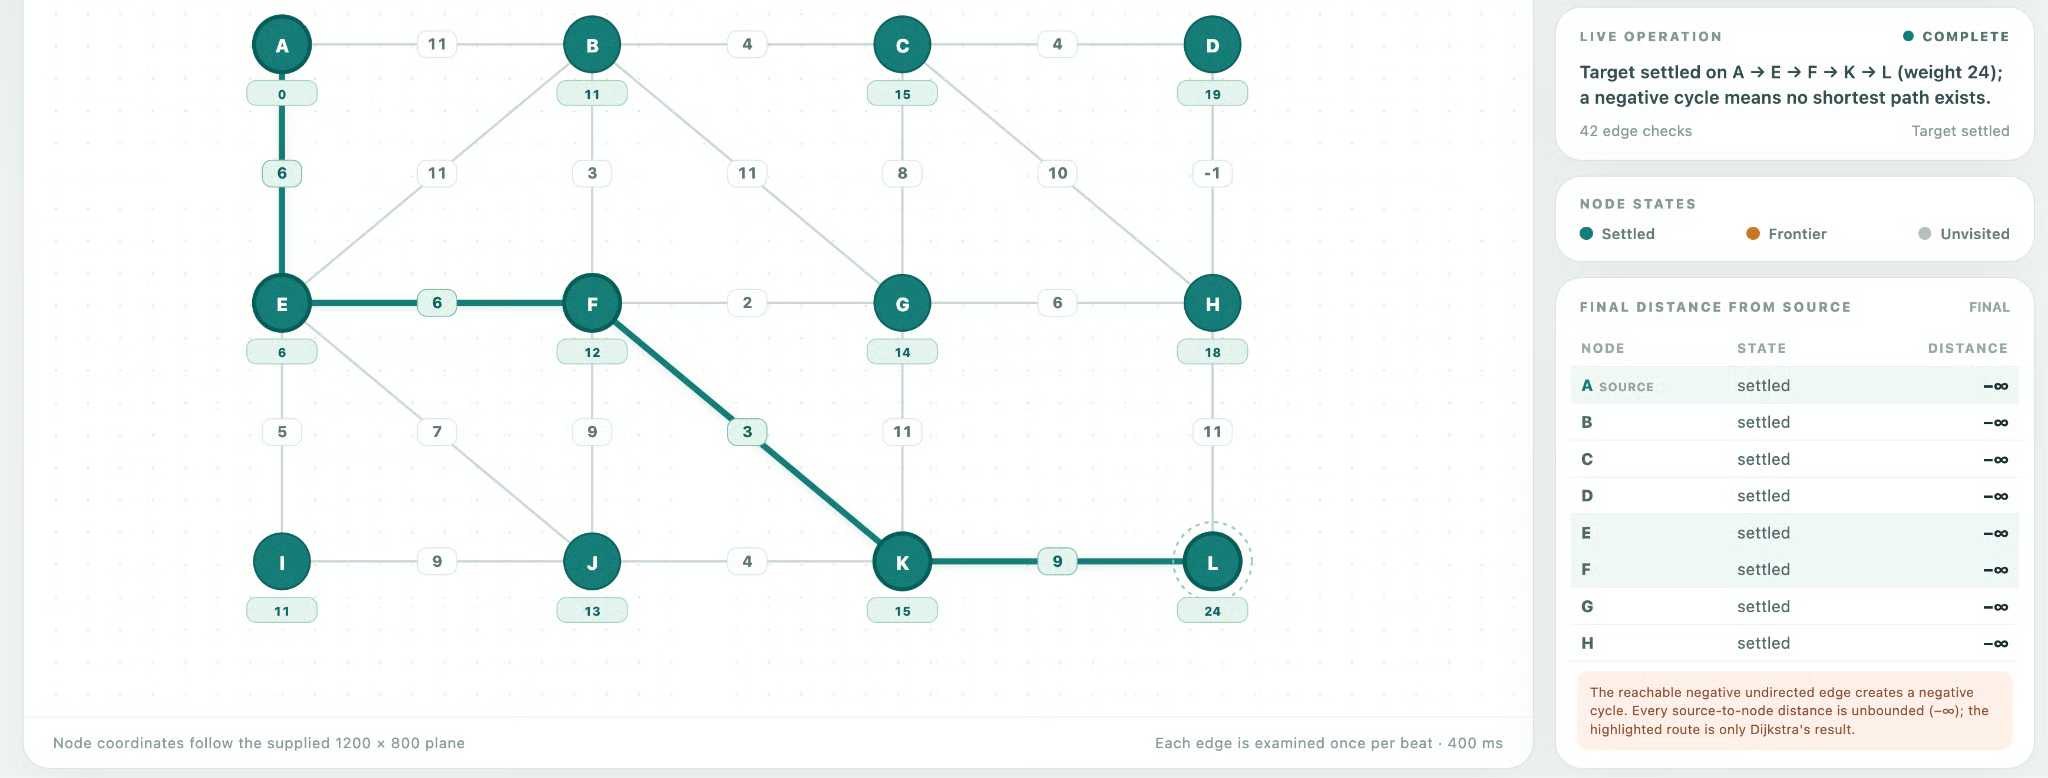
GPT‑6 Luna nằm giữa: một banner nêu tên cạnh và nói Dijkstra không áp dụng được, rồi một bảng khoảng cách với vô cực âm. Có thể bảo vệ được với cạnh âm vô hướng, nhưng gây bối rối khi đọc.
Vậy GPT‑6 có phải một bước nhảy thực sự? Chỉ nhỉnh hơn chút, và chỉ ở một điểm, dù đó là điểm quan trọng. Ở tác vụ build, các bản sinh ra ngang nhau. Khác biệt hoàn toàn nằm ở cách mỗi model xử lý một đầu vào mà nó biết là hỏng, điều này khớp với tuyên bố về tính trung thực của OpenAI hơn là tuyên bố về lập trình. Hai bản Luna không tách biệt gì.
Bài học khác là về bài test: khi bốn model vượt qua mọi phép thử trừ một, cần nâng độ khó lên.
Dưới đây là cấu trúc chi phí mới. Cả hai mức cắt đều là giảm giá 50% so với mức giá GPT‑5.6 tương ứng.
| Trên mỗi 1M token | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Đầu vào | $2 | $4 | $0,10 | $0,20 |
| Đầu ra | $10 | $20 | $0,50 | $1,20 |
Đọc token đầu vào từ cache được chiết khấu 90% trên GPT‑6, nên với các phiên agent dài, tỷ lệ trúng cache quan trọng không kém giá niêm yết. Bài viết ra mắt của OpenAI không công bố giá batch cho cả hai model, và cả hai nằm dưới mức $10 đầu vào và $50 đầu ra của GPT‑6 Astra.
Điều kiện truy cập duy nhất trong bài ra mắt của OpenAI là gói và bề mặt sản phẩm, đây là nơi bức tranh trở nên cụ thể.
GPT‑6 Sol và Luna đã khả dụng trên nhiều nền tảng:
ChatGPT Work và Codex cho người dùng Plus, Pro, Business, Enterprise, và Edu, với Luna cũng đến được người dùng Free và Go trong ứng dụng desktop.
Trên API, chúng khả dụng với tên gpt-6-sol và gpt-6-luna. OpenAI lưu ý quá trình triển khai trên ChatGPT diễn ra theo đợt trong ngày, nên có thể mất một lúc để xuất hiện với tất cả mọi người.
Ngoài ra, cả hai model có trên OpenRouter (với tên openai/gpt-6-sol và openai/gpt-6-luna), trong GitHub Copilot, trên Azure AI Foundry, và trên AWS Bedrock.
Trên API, chúng khả dụng với tên gpt-6-sol và gpt-6-luna. OpenAI lưu ý quá trình triển khai trên ChatGPT diễn ra theo đợt trong ngày, nên có thể mất một lúc để xuất hiện với tất cả mọi người. Một lời gọi tối giản như sau:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Nếu bạn đang chuyển từ GPT‑5.6, hướng dẫn model GPT‑6 của OpenAI (viết cho Astra) nói rằng hãy bỏ temperature và top_p, bắt đầu ở low nếu trước đó bạn dùng none hoặc minimal và giữ nguyên mức nỗ lực hiện tại trong các trường hợp khác, đồng thời chuyển prompt_cache_retention sang prompt_cache_options.ttl đặt là 30 phút.
Sol và Luna lấy công thức huấn luyện đứng sau mẫu đầu bảng Astra và dùng nó để khiến bậc dưới rẻ hơn và nhanh hơn một cách rõ rệt. Bản phát hành của OpenAI sẵn sàng nêu đích danh các model của Anthropic và tuyên bố chiến thắng trên các benchmark đã điều chỉnh chi phí. Đây là phép so sánh thú vị vì Opus 5.5 cũng là một chiến thắng về hiệu suất chi phí.
Quan điểm của tôi: nếu bạn chạy agent hoặc khối lượng lập trình trên GPT‑5.6 Sol hoặc Luna, hãy chuyển ngay. Cùng thang nỗ lực, giá bằng một nửa, và trong bài test của chúng tôi, điều duy nhất GPT‑6 Sol làm được mà tiền nhiệm không làm là từ chối đưa ra câu trả lời chắc nịch cho một câu hỏi mà thuật toán không thể trả lời. Nếu bạn đang dùng Claude, các con số đã điều chỉnh chi phí là lý do để tự chạy so sánh thay vì chỉ tin vào lời OpenAI.
Nếu bạn muốn xây dựng trên các model này, tôi khuyên bạn học lộ trình kỹ năng OpenAI Fundamentals, bao quát API từ đầu đến cuối trong 15 giờ.
Học cùng DataCamp
Courses
Courses
Courses
blogs
Matt Crabtree
10 phút
