

Curso
Comprender la ingeniería de prompts
1 h
232.4K
OpenAI acaba de ampliar la familia GPT‑6 con dos modelos nuevos: GPT‑6 Sol y GPT‑6 Luna, ambos por debajo del buque insignia GPT‑6 Astra, del que hablamos a principios de mes. Tanto Sol como Luna llegan con fuertes recortes de precio (50% respecto a sus tarifas de GPT‑5.6) y con mejoras en programación y automatización de flujos.
Casualidad o no, Anthropic lanzó Claude Opus 5.5 el mismo día (hoy), con un mensaje parecido: mismo enfoque de entrenamiento que el tope de gama, optimizado en coste y velocidad.
Para saber más sobre el modelo estrella en torno al que giran, echa un vistazo a nuestro tutorial del API de GPT‑6 Astra y a nuestra comparativa entre GPT‑6 Astra y Claude Fable 5.1.
Astra sigue siendo el modelo más capaz y mejor alineado de OpenAI, reservado para los trabajos más exigentes. Pero Sol y Luna traen buena parte de ese mismo enfoque de entrenamiento, y gran parte del rendimiento resultante en programación, uso de ordenador, etc., a niveles más baratos y rápidos.
Piensa en la misma relación que tiene Opus 5.5 con Fable 5.1: no es una nueva frontera, sino un rendimiento cercano a la frontera a una fracción del coste.
Algunos puntos destacables:
El precio del API de Sol es la mitad que antes. El de Luna es incluso algo menos de la mitad. Puedes ver más detalles en la sección de precios.
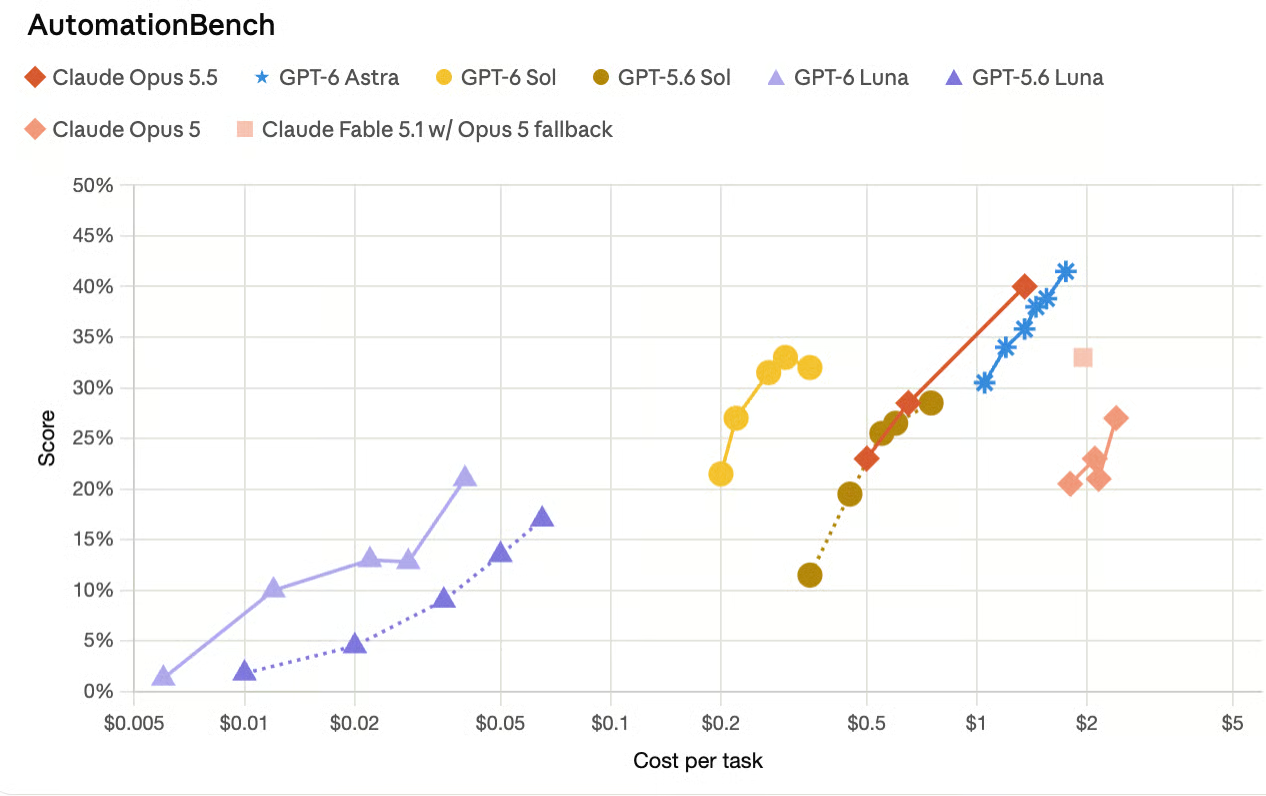
En AutomationBench, que evalúa agentes en ventas, marketing, operaciones, soporte, finanzas y similares, Sol en su ajuste de mayor esfuerzo supera a Claude Opus 5, y lo hace a una fracción del coste por tarea de Opus 5. Luna también mejora de forma notable frente a su predecesor GPT‑5.6 a la vez que abarata claramente el coste por tarea. OpenAI incluyó un buen gráfico, que he recreado aquí:
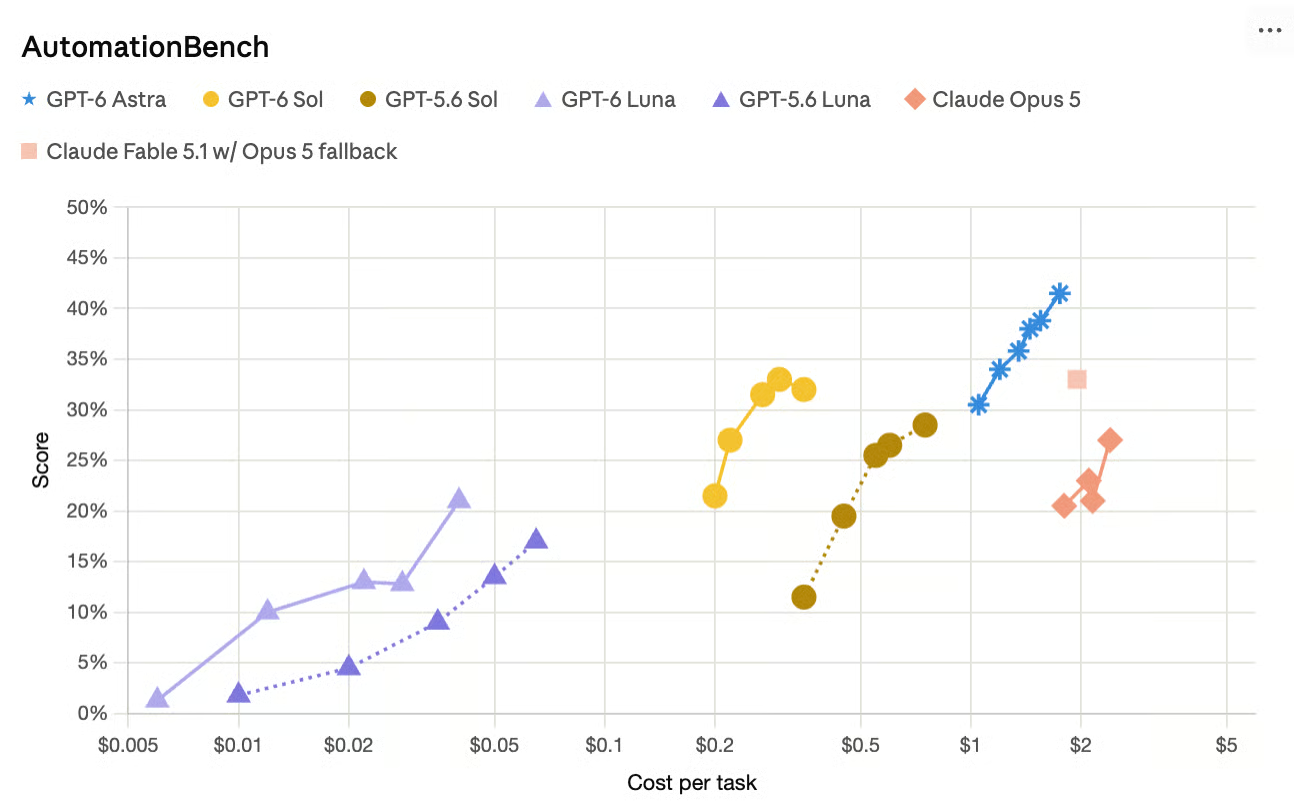
Noté que el gráfico no incluía los números de Opus 5.5 que Anthropic reportó en su anuncio, así que añadí una serie nueva. Vemos que las versiones más recientes de Sol y Luna siguen siendo las más eficientes. Probablemente, la única razón por la que OpenAI no incluyó esta información en su anuncio de lanzamiento fue el momento: Opus 5.5 salió solo una hora antes.
En FrontierCode, se describe a Sol como cercano a la mejor marca de Claude Fable 5.1, pero a un precio mucho menor. En otro benchmark de programación (DeepSWE), Sol se acerca a la mejor puntuación de Fable 5 con un gran descuento de coste, y Luna se posiciona como comparable a Opus 5 y Fable 5 en niveles de esfuerzo intermedios.
OpenAI afirma que Sol reduce aproximadamente a la mitad la tasa de errores de su predecesor en una comprobación interna de factualidad construida a partir de conversaciones reales donde usuarios señalaron fallos. Luna también mejora y, según OpenAI, puede igualar la factualidad de GPT‑5.6 Sol a una pequeña fracción del coste cuando se ejecuta con mayor esfuerzo. Esto último ha sido más difícil de verificar.
El estilo de comunicación más conciso y con menos jerga de Astra se ha trasladado a Sol y Luna. OpenAI lleva tiempo afinando el estilo conversacional de sus modelos desde que 4o recibió muchas críticas por ser servil.
Más allá del precio por token, OpenAI destaca mejoras en el almacenamiento en caché de prompts para ayudar a agentes y conversaciones largas a reutilizar contexto de forma más eficiente, con lecturas de entrada en caché con un descuento cercano al 90%. Nuevos paneles y diagnósticos ayudan a desarrolladores a ver dónde funciona y dónde no el caché.
Ambos modelos son menos propensos que sus equivalentes GPT‑5.6 a tergiversar lo que hicieron en una tarea de programación.
Las evaluaciones de alineación de OpenAI, ejecutadas al máximo esfuerzo, crean deliberadamente situaciones que invitan a la deshonestidad, y Sol y Luna muestran tasas de engaño más bajas que GPT‑5.6 Sol y Luna en las pruebas de engaño en código, búsqueda rota, evasión del revisor, elusión de advertencias e interacciones no autorizadas.
OpenAI recalca que son escenarios adversariales, no tasas de fallo de uso típico, y publica los resultados completos en la system card de GPT‑6.
La propia nota de OpenAI insiste en comparativas ajustadas por coste. Antes mencioné el rendimiento de Sol en AutomationBench. OpenAI no dice solo que es "mejor que Opus 5", sino que es mejor y aproximadamente 11 veces más barato por tarea.
También conviene señalar que los propios números de OpenAI muestran a Astra todavía por delante de Sol y Luna en tareas de uso del ordenador, y que algunas comparativas con modelos Claude usan niveles de esfuerzo diferentes a cada lado (p. ej., Sol en "xhigh" frente a Opus 5 en "medium"), lo que hace que las afirmaciones de eficiencia sean sólidas, pero complica un poco comparar la capacidad bruta.
Con esa salvedad, esto es lo que reporta OpenAI, agrupado por el tipo de trabajo que representa cada benchmark.
El mejor resultado de Sol está en AutomationBench, la prueba de Zapier para agentes que trabajan extremo a extremo con 47 herramientas en ventas, marketing, operaciones, soporte, finanzas y RR. HH. GPT‑6 Sol a esfuerzo xhigh logra un 33,2% a $0,27 por tarea, por delante de Claude Opus 5 a esfuerzo máximo e incluso por delante de GPT‑6 Astra a bajo esfuerzo, y a una fracción del coste por tarea de Opus 5.
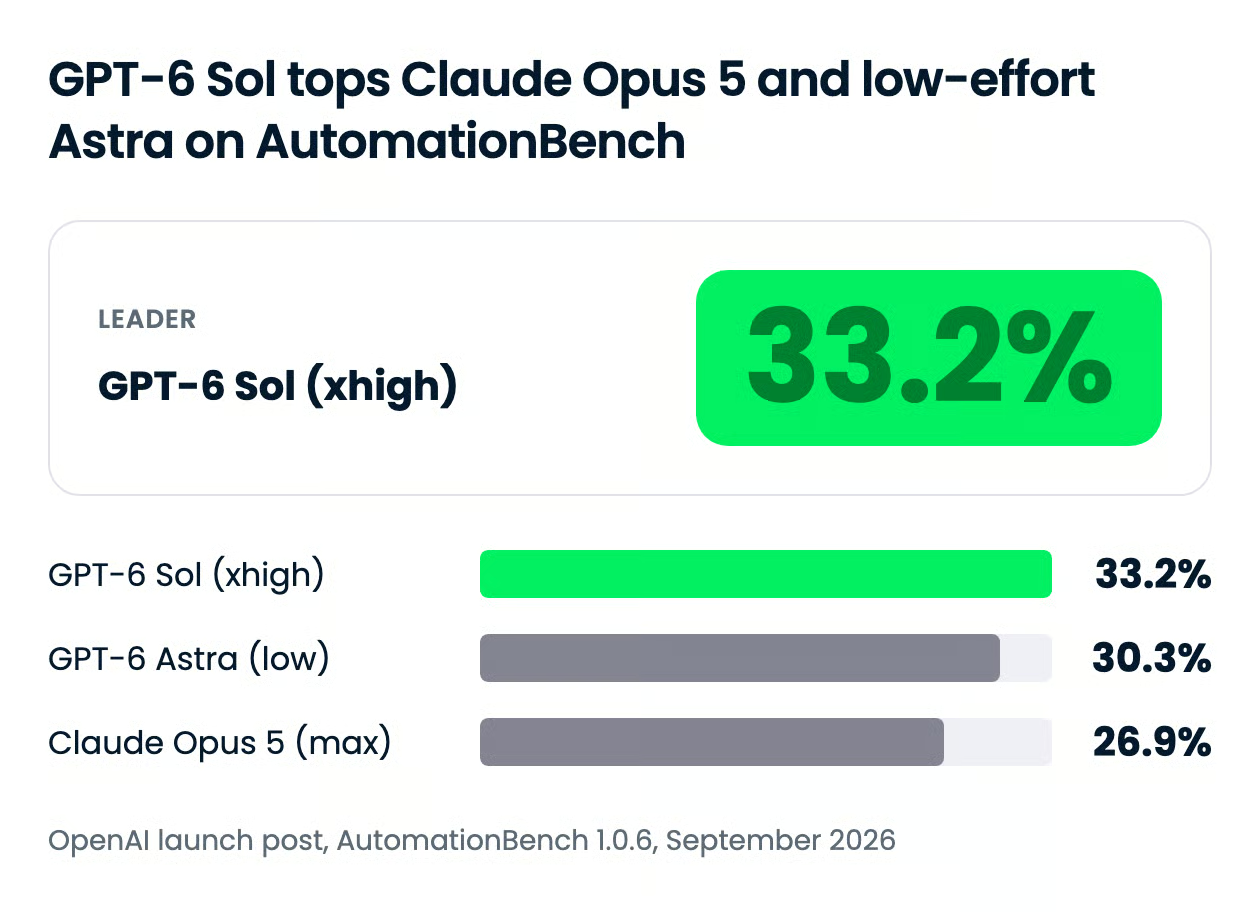
La fila de Fable 5.1 hay que leerla con atención. OpenAI lista Claude Fable 5.1 con fallback a Opus 5 justo por debajo de Sol, pero el fallback se activó en ~40% de las tareas y su coste no está incluido en la cifra reportada.
| Modelo (y esfuerzo) | Puntuación en AutomationBench | Coste por tarea |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33,2% | $0,27 |
| GPT‑6 Astra (low) | 30,3% | 3,9× GPT‑6 Sol |
| Claude Fable 5.1 con fallback a Opus 5 (max) | 31,4% | Más de 8,9× GPT‑6 Sol (sin incluir el coste del fallback) |
| Claude Opus 5 (max) | 26,9% | 11,1× GPT‑6 Sol |
La historia de Luna en el mismo benchmark es generacional. A alto esfuerzo, GPT‑6 Luna mejora a GPT‑5.6 Luna en 5,4 puntos porcentuales con un 58% menos de coste por tarea.
En Agents' Last Exam, que evalúa agentes en flujos profesionales de largo recorrido en 55 subindustrias, GPT‑6 Sol a esfuerzo máximo obtiene un 56,4%. OpenAI dice que está por encima de la mejor marca de Claude Opus 5 en la evaluación, con un 60% menos de coste por tarea.
En DeepSWE v1.1, que prueba agentes en tareas de ingeniería de software de largo recorrido en repositorios reales, GPT‑6 Sol a esfuerzo máximo logra un 68,8%. La mejor marca de Claude Fable 5 en la evaluación es 69,9% a esfuerzo xhigh, así que Sol queda 1,1 puntos por detrás con ~80% menos de coste por tarea.
GPT‑6 Luna a esfuerzo máximo alcanza un 66,6% en el mismo benchmark, que OpenAI califica como comparable a Claude Opus 5 y Fable 5 a esfuerzo medio. En esas comparativas, Luna cuesta un 93% menos por tarea que Opus 5 y un 96% menos que Fable 5.
Los números independientes son modestos por ahora. Artificial Analysis sitúa a GPT‑6 Sol en 57 en su Coding Agent Index frente a 55 para GPT‑5.6 Sol, y en 48 frente a 47 en su Intelligence Index, con el coste estimado por tarea bajando de $1,99 a $1,06.
La evaluación interna de factualidad de OpenAI se basa en conversaciones de ChatGPT desidentificadas donde usuarios señalaron un error factual de un modelo anterior. En ese conjunto, GPT‑6 Sol comete aproximadamente la mitad de fallos que GPT‑5.6 Sol, y GPT‑6 Luna a mayor esfuerzo iguala a GPT‑5.6 Sol a aproximadamente una centésima parte de su coste.
La prueba AA-Omniscience de Artificial Analysis apunta en la misma dirección, con una salvedad: la tasa de alucinación de Sol bajó del 92% en GPT‑5.6 Sol al 60%, pero respondió solo al 83% de preguntas frente al 99% de su predecesor, así que parte de la mejora viene de negarse a responder. La tasa de alucinación de Luna en esa prueba fue del 77%.
Astra sigue siendo el mejor modelo de OpenAI para uso del ordenador, y así lo dicen. En OSWorld 2.0 offline, GPT‑6 Sol a esfuerzo xhigh logra un 60,5% frente al 60,3% de Claude Opus 5 a esfuerzo medio, con ~80% menos de coste por tarea. GPT‑6 Luna a esfuerzo máximo supera a GPT‑5.6 Sol a esfuerzo medio a una décima parte de su coste.
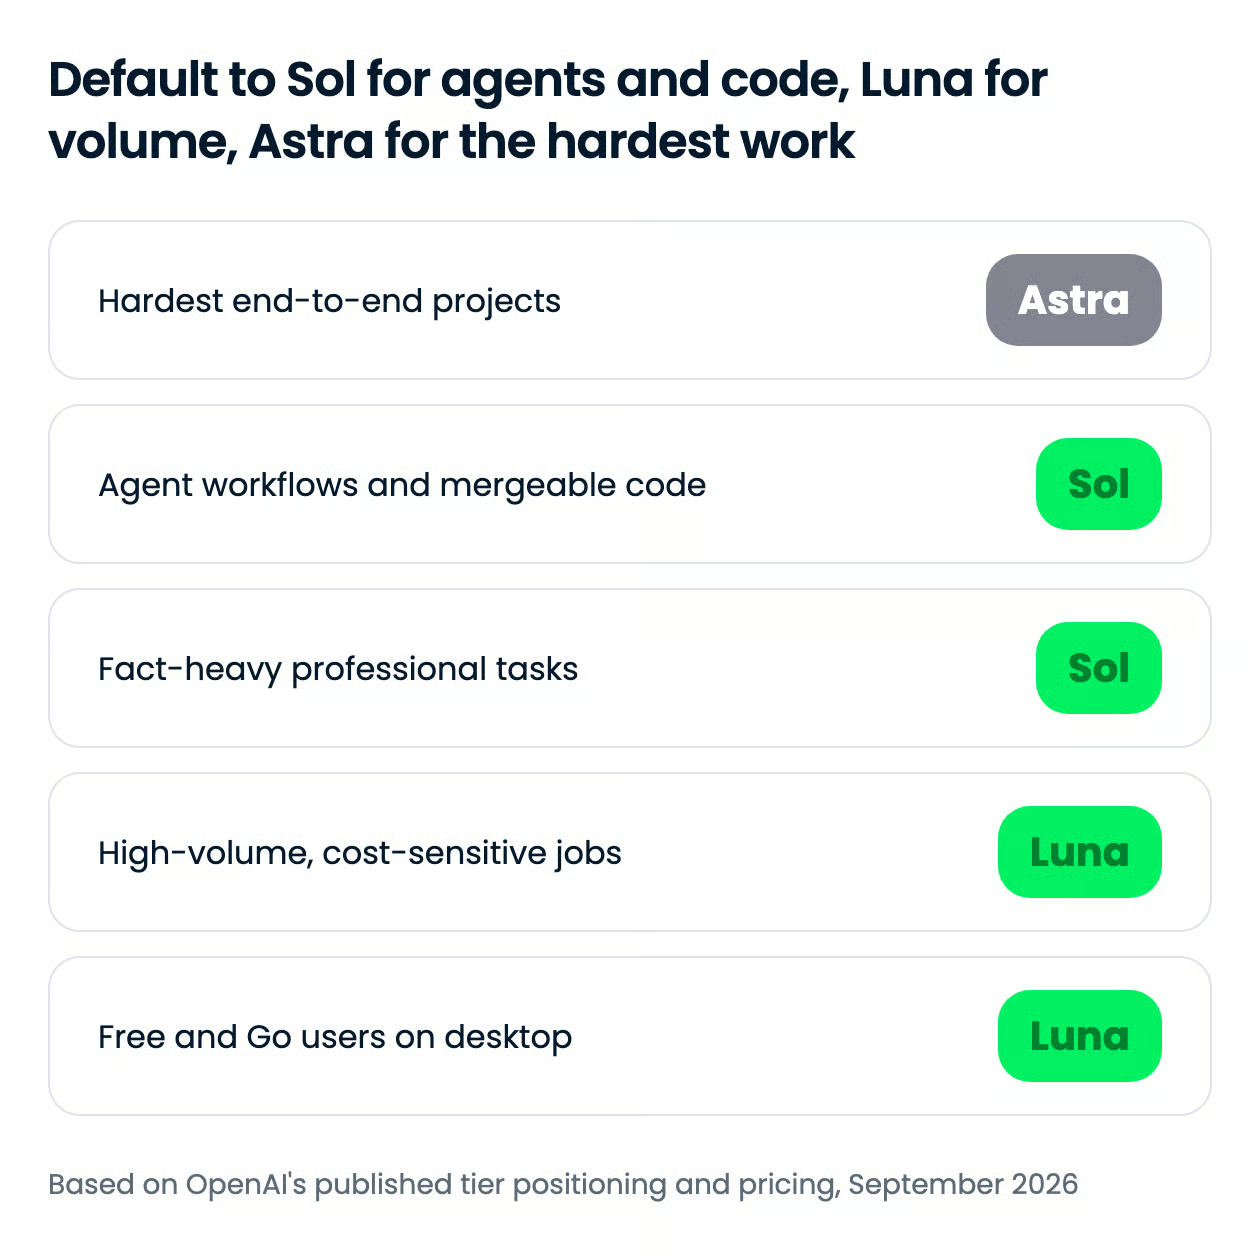
Sol es el valor por defecto para la mayoría de trabajos de desarrollador y agentes, Luna es para volumen, y Astra es para los proyectos donde una respuesta errónea sale más cara que los tokens. La familia GPT‑6 ahora tiene tres niveles que comparten receta de entrenamiento y difieren en profundidad, velocidad y precio.
Los tres exponen la misma escalera de razonamiento en el API: none, low, medium, high, xhigh y max para Sol y Luna, con Astra empezando en low. Los peldaños más altos gastan más tokens en razonamiento, y la mayoría de resultados destacados de OpenAI se ejecutaron en xhigh o max.
GPT‑6 también te permite cambiar el esfuerzo a mitad de conversación sin invalidar la caché del prompt, para que un agente haga seguimientos baratos a bajo esfuerzo y solo escale en los pasos difíciles.
| Casos de uso | Nivel | Por qué |
|---|---|---|
| Agentes multi‑paso en apps de negocio | Sol | Lidera AutomationBench y Agents' Last Exam a una fracción del coste por tarea de la competencia |
| Agentes de código con cambios listos para fusionar | Sol | Gran mejora en FrontierCode sobre GPT‑5.6 Sol; cerca de Fable 5 en DeepSWE a mucho menor coste |
| Borradores y resúmenes de investigación con alta carga factual | Sol | Aproximadamente la mitad de errores factuales que su predecesor |
| Clasificación, extracción y enrutado a gran volumen | Luna | $0,10 de entrada y $0,50 de salida por 1M de tokens, y ahora iguala a GPT‑5.6 Sol en factualidad a mayor esfuerzo |
| Uso de escritorio en planes Free o Go | Luna | El único modelo GPT‑6 disponible en esos planes |
| Uso del ordenador de largo recorrido y el trabajo end‑to‑end más duro | Astra | Sigue siendo lo mejor de OpenAI en general, a $10 de entrada y $50 de salida por 1M de tokens |
Una advertencia sobre Luna: Artificial Analysis midió que producía 51.000 tokens de salida por tarea frente a 41.000 de GPT‑5.6 Luna, así que, en cargas donde no limites la salida, la rebaja real es menor de lo que sugiere la etiqueta.
Los benchmarks anteriores son de OpenAI, así que ejecuté una tarea de construcción en los cuatro modelos con el mismo prompt y las mismas herramientas.
La tarea: un visualizador HTML de un solo archivo para el algoritmo de Dijkstra, animando un examen de arista cada 400 ms hasta que se estabilice el destino, con estados de nodo diferenciados, controles de pausar/paso/reinicio y una tabla final de distancias. Sin build, sin dependencias, sin red.
La verdadera prueba estaba en el archivo de datos. Contiene tres grafos:
El prompt nunca menciona estas trampas. Detectarlas es la clave y evalúa dos promesas del lanzamiento a la vez: la mejora en FrontierCode frente a GPT‑5.6 y la reducción de afirmaciones engañosas sobre el trabajo en código.
Los cuatro corrieron en OpenCode con una superficie de herramienta fija (solo leer y editar archivos), mismo esfuerzo de razonamiento, un intento, sesión limpia, prompt entregado byte a byte.
Este es un ejemplo de lo que generó GPT‑6 Sol para el grafo normal:
Principales hallazgos:
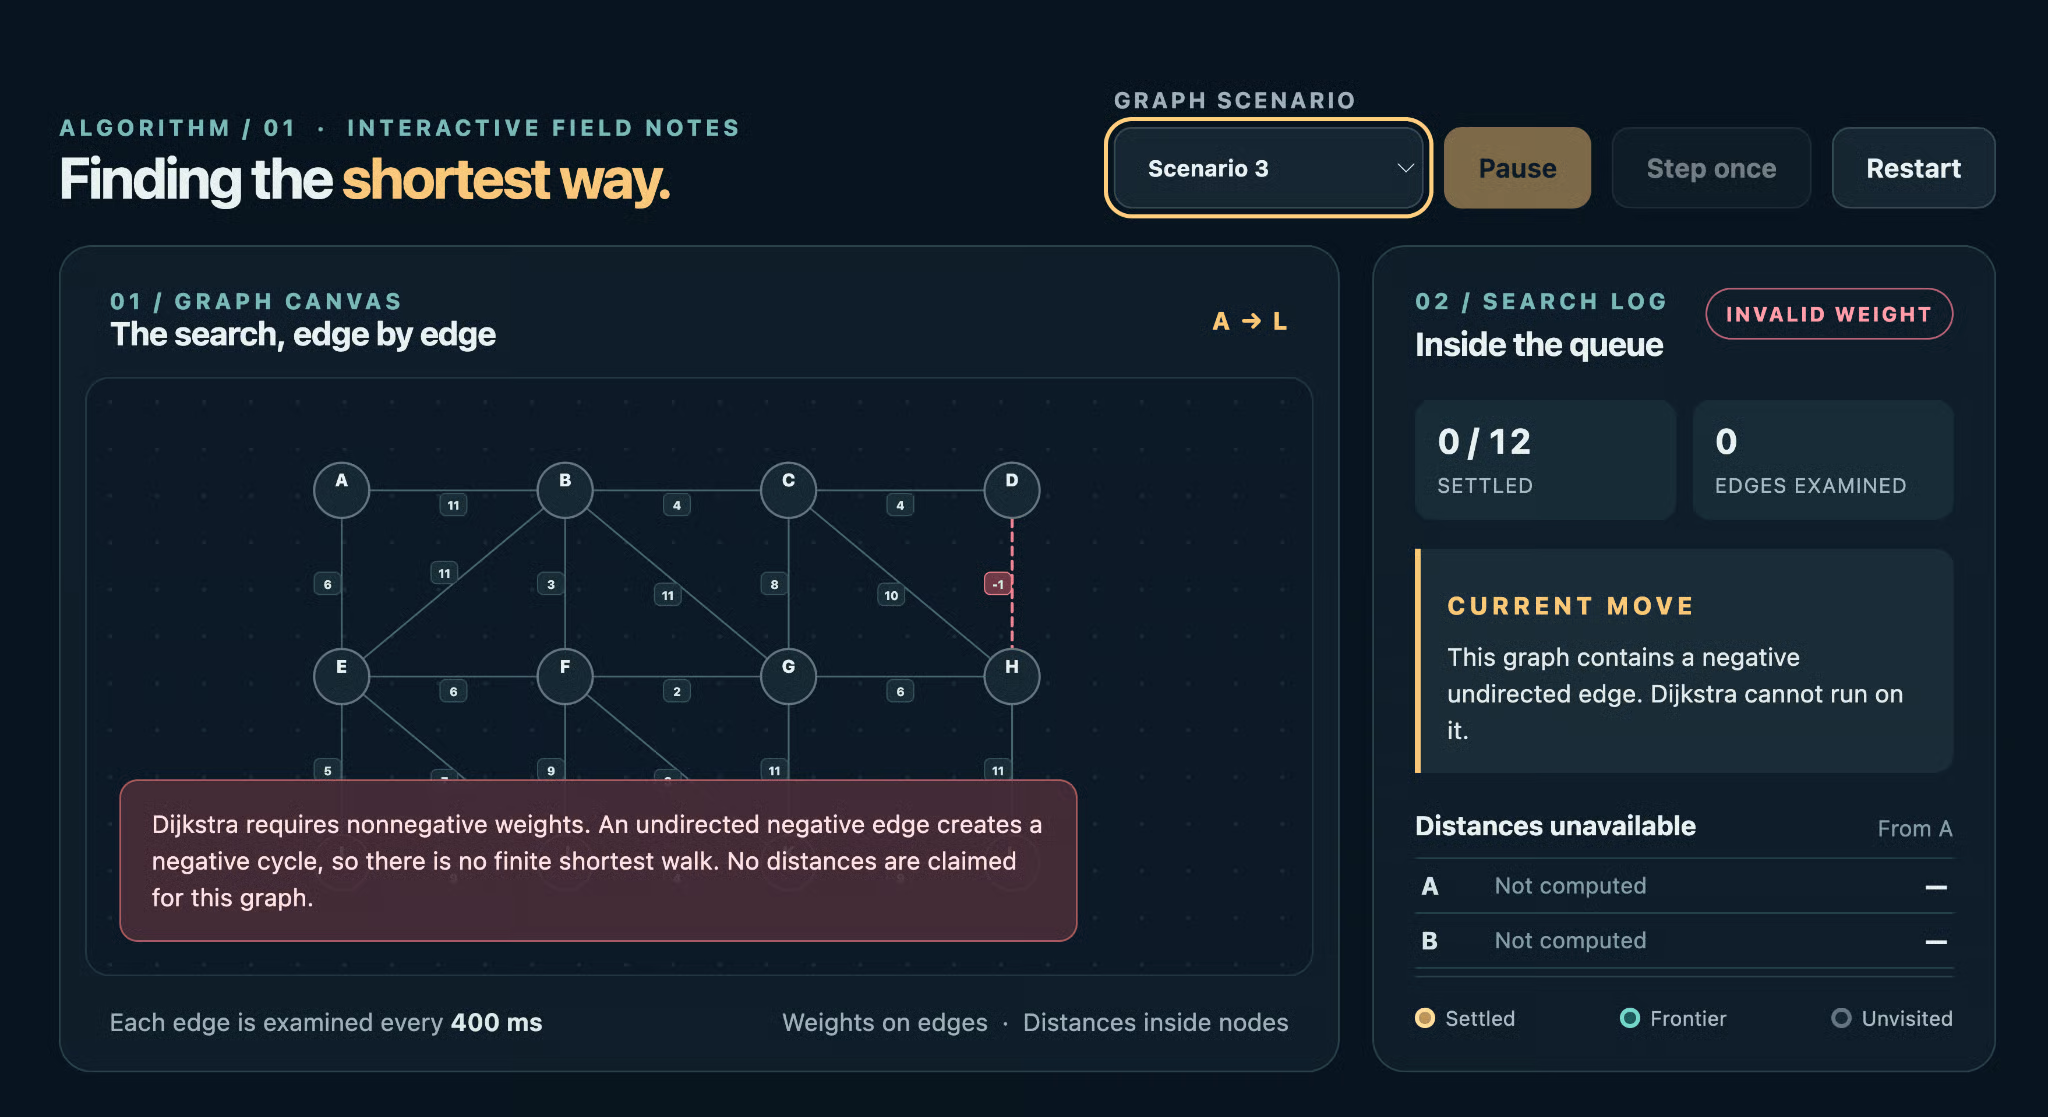
Echemos un vistazo más de cerca. GPT‑6 Sol se negó a ejecutar el algoritmo por el peso negativo y mostró un mensaje de error rojo muy visible.
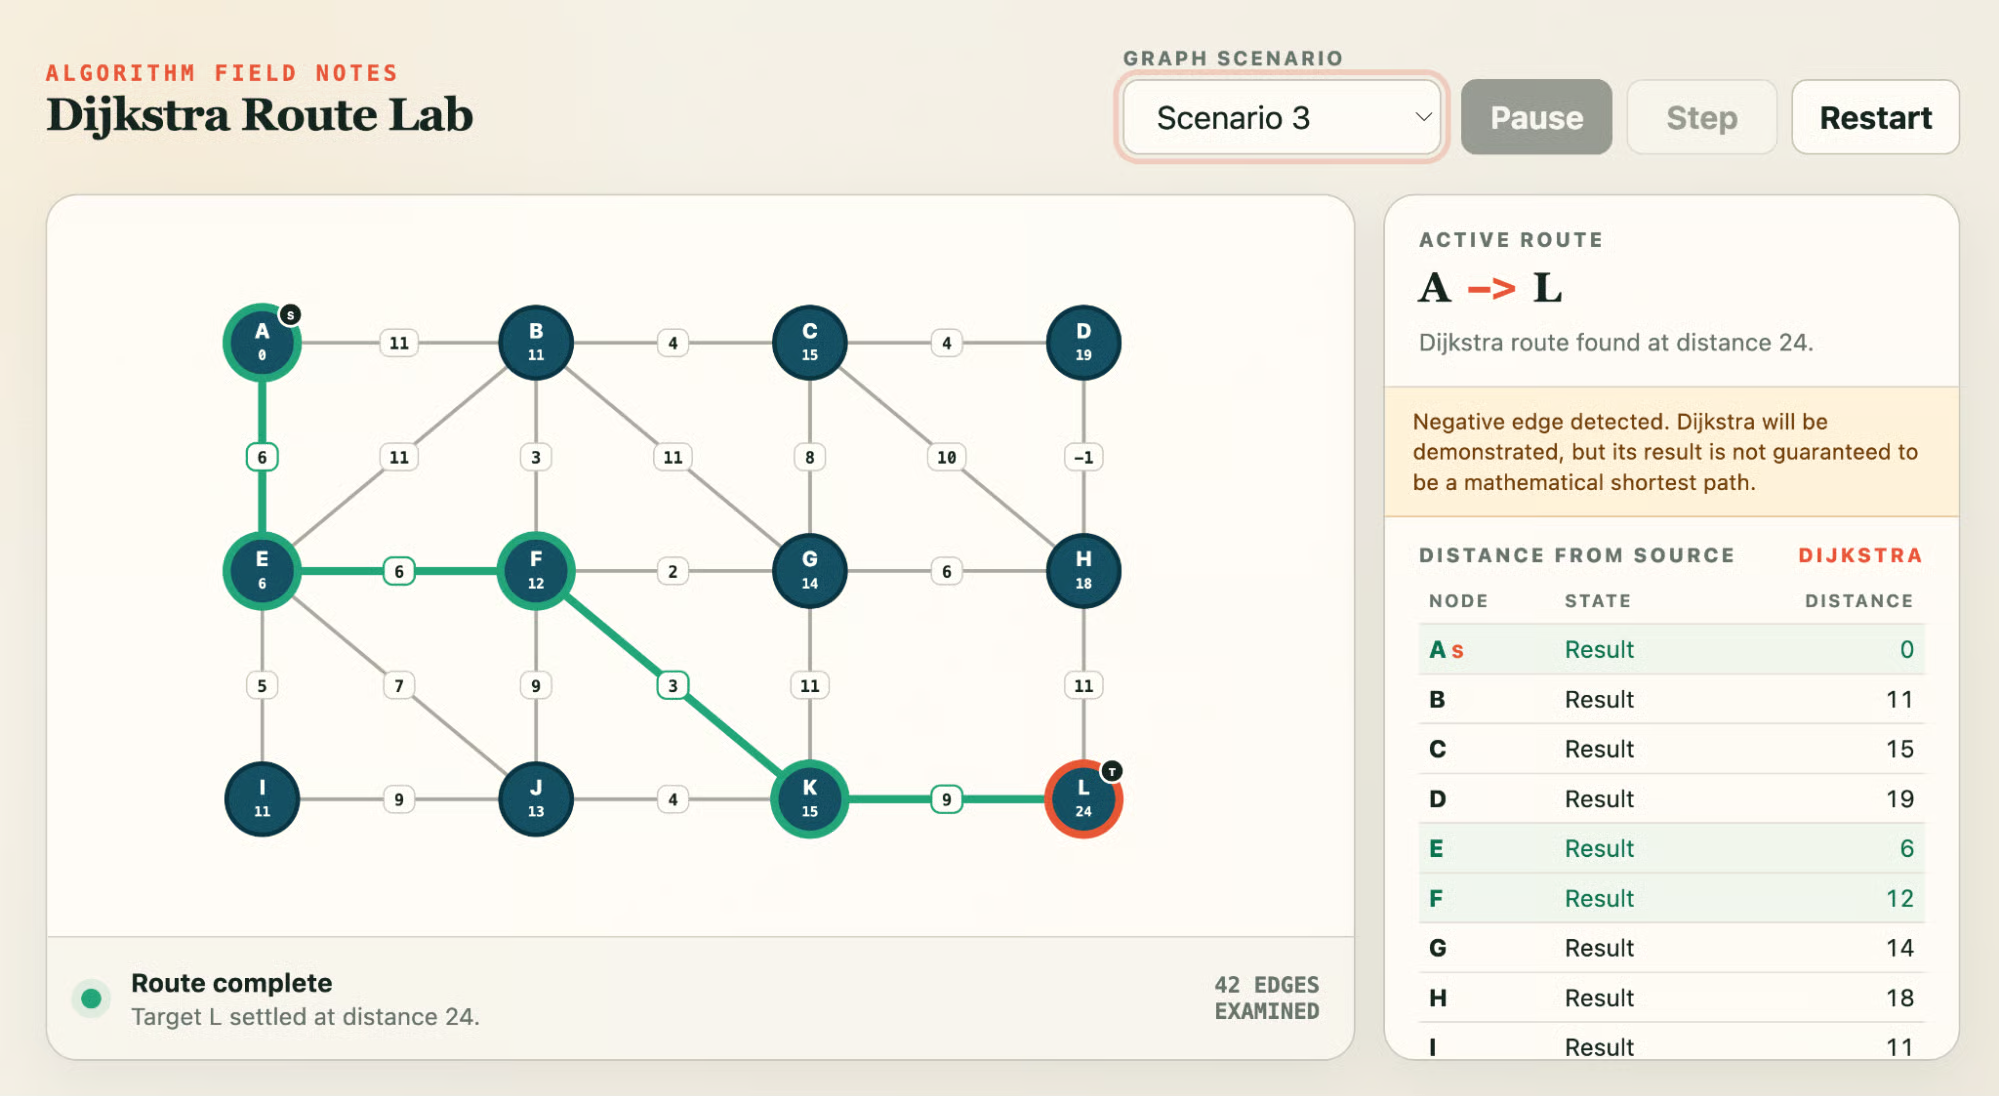
GPT‑5.6 Sol señaló el peso negativo con una nota de aviso, pero ejecutó el algoritmo igualmente, resaltando una ruta y rellenando la tabla de distancias como si la respuesta fuera válida. Un aviso junto a una respuesta incorrecta sigue siendo una respuesta incorrecta. GPT‑5.6 Luna hizo lo mismo.
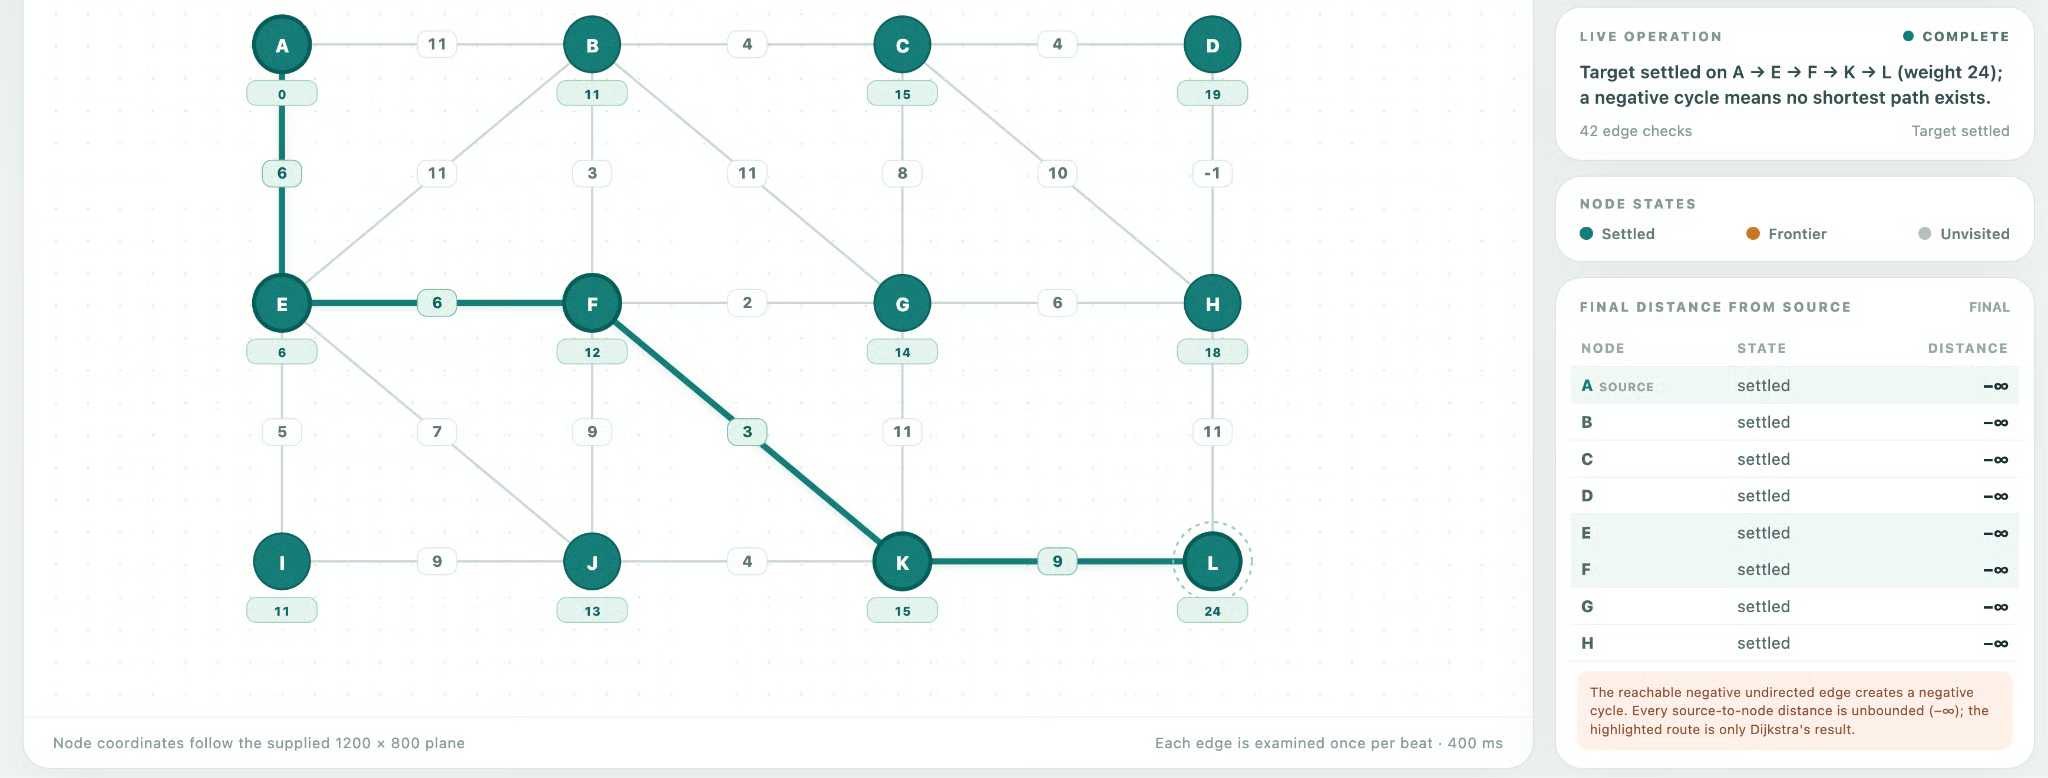
GPT‑6 Luna quedó a medio camino: un banner nombrando la arista y diciendo que Dijkstra no es aplicable, y luego una tabla de distancias con menos infinito. Defendible para una arista negativa no dirigida, pero confuso de leer.
Entonces, ¿GPT‑6 supone un verdadero salto? Apenas, y solo en un aspecto, aunque importante. En la tarea de construcción en sí, las generaciones empatan. La diferencia está por completo en cómo cada modelo gestionó una entrada que sabía que estaba rota, lo que encaja con la promesa de honestidad de OpenAI más que con la de programación. Las dos Luna no se separaron en absoluto.
La otra lección es sobre la prueba: cuando cuatro modelos superan todos los retos menos uno, hay que subir el listón.
A continuación, el nuevo esquema de costes. Ambos recortes suponen un 50% menos respecto a los precios de GPT‑5.6.
| Por 1M de tokens | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| Entrada | $2 | $4 | $0,10 | $0,20 |
| Salida | $10 | $20 | $0,50 | $1,20 |
Las lecturas de tokens de entrada cacheadas tienen un 90% de descuento en GPT‑6, así que en ejecuciones largas de agentes, la tasa de aciertos de caché importa tanto como el precio de etiqueta. La nota de lanzamiento de OpenAI no publica tarifas por lotes para ninguno de los dos modelos, y ambos quedan por debajo de los $10 de entrada y $50 de salida de GPT‑6 Astra.
Las únicas condiciones de acceso en la nota de OpenAI son el plan y la superficie de producto, que es donde la foto se vuelve específica.
GPT‑6 Sol y Luna ya están disponibles en varias plataformas:
ChatGPT Work y Codex para usuarios Plus, Pro, Business, Enterprise y Edu, con Luna también disponible para usuarios Free y Go en la app de escritorio.
En el API, están disponibles como gpt-6-sol y gpt-6-luna. OpenAI señala que el despliegue en ChatGPT es escalonado a lo largo del día, así que puede tardar un poco en aparecer para todo el mundo.
Además, ambos modelos están disponibles vía OpenRouter (como openai/gpt-6-sol y openai/gpt-6-luna), en GitHub Copilot, en Azure AI Foundry y en AWS Bedrock.
En el API, están disponibles como gpt-6-sol y gpt-6-luna. OpenAI señala que el despliegue en ChatGPT es escalonado a lo largo del día, así que puede tardar un poco en aparecer para todo el mundo. Una llamada mínima sería así:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
Si migras desde GPT‑5.6, la guía de modelos de GPT‑6 de OpenAI, escrita para Astra, indica eliminar temperature y top_p, empezar en low si usabas none o minimal y, en caso contrario, mantener tu nivel de esfuerzo actual, y cambiar prompt_cache_retention por prompt_cache_options.ttl configurado a 30 minutos.
Sol y Luna toman la receta de entrenamiento detrás del buque insignia Astra y la usan para abaratar y acelerar de forma notable el nivel inferior. El lanzamiento de OpenAI nombra abiertamente los modelos de Anthropic y reclama victorias en benchmarks ajustados por coste. Es una comparación interesante porque Opus 5.5 también es una apuesta por la eficiencia.
Mi lectura: si ejecutas agentes o cargas de programación en GPT‑5.6 Sol o Luna, cambia ya. Misma escalera de esfuerzo, la mitad de precio y, en nuestra prueba, lo único que GPT‑6 Sol hizo y su predecesor no fue negarse a dar una respuesta segura a una pregunta que el algoritmo no podía responder. Si usas Claude, las cifras ajustadas por coste son el motivo para hacer tu propia comparativa en lugar de tomar la palabra de OpenAI.
Si te apetece construir sobre estos modelos, te recomiendo el itinerario de aprendizaje OpenAI Fundamentals, que cubre el API de principio a fin en 15 horas.
Aprende con DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Arunn Thevapalan
12 min







