Courses
プロンプトエンジニアリングを理解する
1時間
232.4K
OpenAI は GPT‑6 ファミリーを拡充し、GPT‑6 Sol と GPT‑6 Luna の2モデルを追加しました。いずれも今月初めに紹介したフラッグシップの GPT‑6 Astra の下位に位置付けられます。Sol と Luna はいずれも大幅な値下げ(GPT‑5.6 時の価格から50%オフ)に加え、コーディングとワークフロー自動化での向上が見られます。
偶然かどうかはさておき、Anthropic も同日に Claude Opus 5.5 を発表しました。こちらも、フラッグシップと同様の学習手法を用いながら、コストと速度を最適化したという打ち出しです。
両モデルが位置するフラッグシップについて詳しくは、GPT‑6 Astra API チュートリアルと、GPT‑6 Astra と Claude Fable 5.1 の比較をご覧ください。
Astra は OpenAI で最も高性能かつ整合性の高いモデルで、最も厳しい用途に充てられます。一方、Sol と Luna は、同様の学習アプローチと、その結果として得られるコーディングやコンピュータ操作などの性能の多くを、より安価かつ高速なティアへと落とし込むために設計されています。
関係性としては、Opus 5.5 と Fable 5.1 の間柄に似ています。まったく新しい最前線というより、その近傍の性能をごく一部のコストで実現する、という位置付けです。
注目点をいくつか挙げます。
Sol の API 価格は以前の半分。Luna はさらに半分弱になりました。詳細は後述の価格セクションで確認できます。
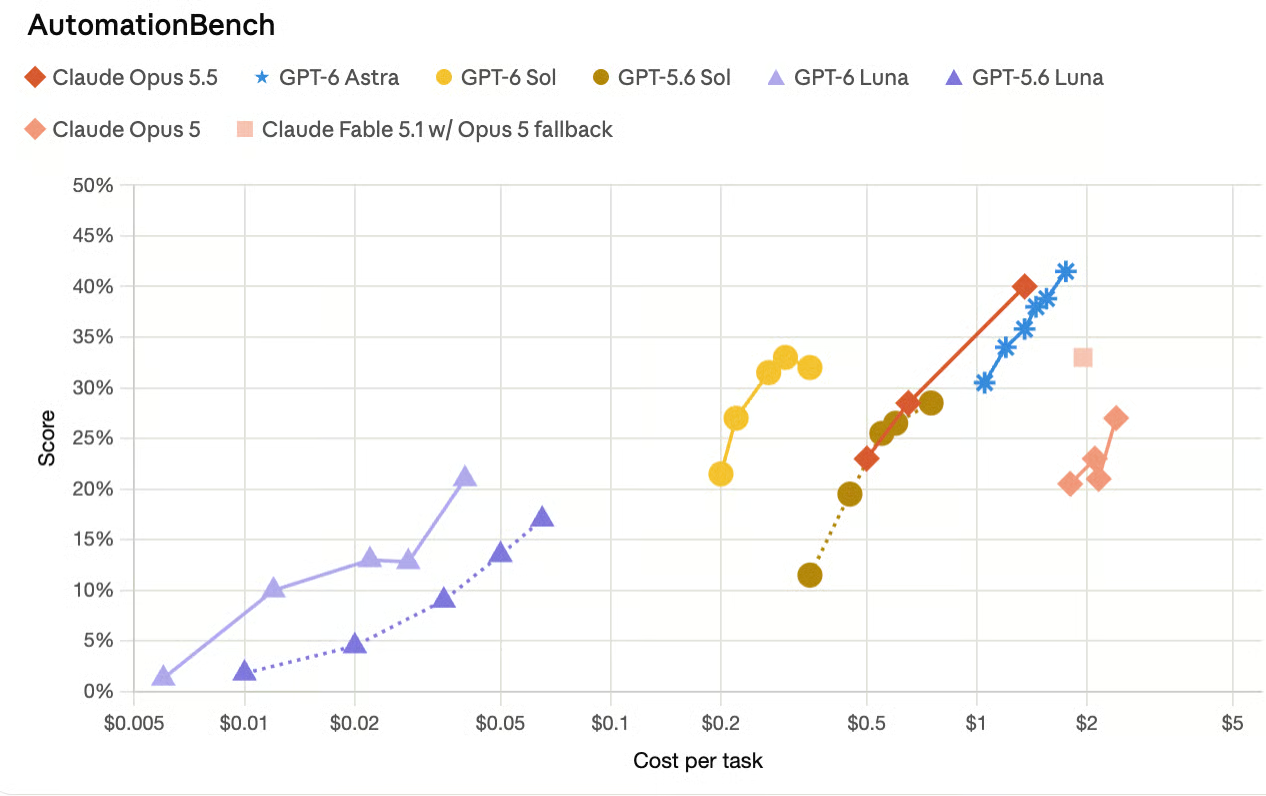
営業、マーケティング、オペレーション、サポート、財務などの領域でエージェントを評価する AutomationBench では、最大努力設定の Sol が Claude Opus 5 を上回り、そのタスク単価は Opus 5 のごく一部にとどまります。Luna も前世代の GPT‑5.6 版から有意に改善し、タスク単価は大きく低下しました。OpenAI は良い図版を提示しており、ここで再掲します。
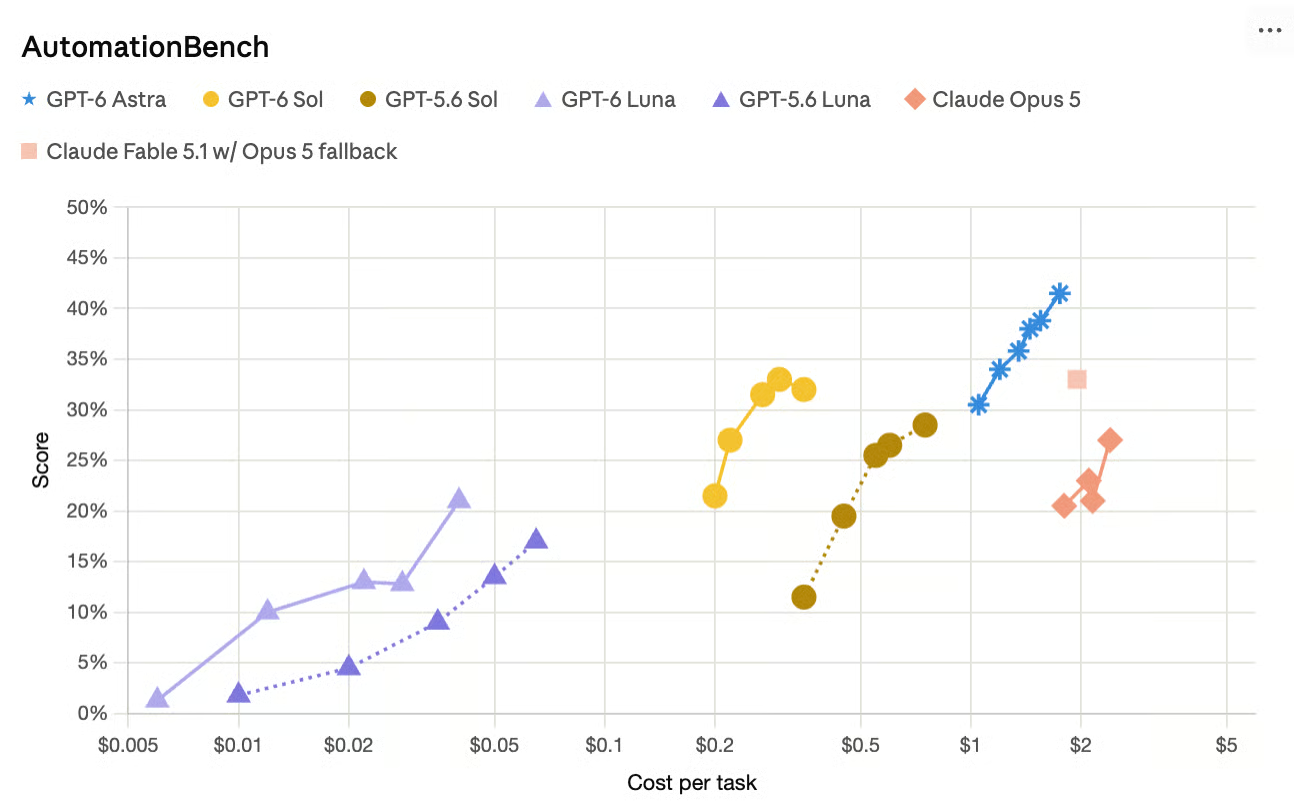
なお、このグラフには Anthropic がOpus 5.5 の発表で報告した数値が含まれていなかったため、筆者がラインを追加しました。最新の Sol と Luna が依然として最も効率的であることが分かります。おそらく OpenAI がローンチ発表にこの情報を含めなかったのは、タイミングの問題でしょう。Opus 5.5 は発表のわずか1時間前に公開されました。
FrontierCode では、Sol は Claude Fable 5.1 の最高スコアに概ね肩を並べつつ、価格は大幅に安いとされています。別のコーディングベンチマーク(DeepSWE)でも、Sol は Fable 5 の最高スコアに近づきつつ大幅なコスト割引を実現し、Luna は中位の努力設定で Opus 5 と Fable 5 に匹敵する位置取りです。
OpenAI によれば、ユーザーが誤りを指摘した実際の会話から作られた社内のファクチュアリティ検査で、Sol は前世代のミス率を概ね半減。Luna も改善し、高い努力設定では GPT‑5.6 Sol と同等の正確性を、コストのごく一部で達成できるとしています。これについては検証が難しい面もありました。
Astra の簡潔で専門用語を抑えたコミュニケーションスタイルが、Sol と Luna にも反映されました。4o が迎合的だとの批判を受けて以来、OpenAI は会話スタイルの最適化を継続しています。
トークン単価以外にも、OpenAI はプロンプトキャッシュの改善を強調しています。エージェントや長い会話で文脈を効率よく再利用できるようにし、キャッシュされた入力の読み出しは約90%割引。キャッシュの効き具合を可視化するための新しいダッシュボードや診断機能も提供されます。
両モデルは、コーディングタスクでの実施内容を取り違えて表現する可能性が、GPT‑5.6 の対応モデルより低いとされています。
OpenAI のアラインメント評価は最大努力で実施され、不誠実さを誘発する状況を意図的に設定しますが、Sol と Luna は、コーディング欺瞞、検索破綻、レビュー回避、警告回避、不正な相互作用といったテストで、GPT‑5.6 Sol/Luna よりも低い欺瞞率を示しました。
これらは敵対的な設定であり、通常利用での失敗率ではないことを OpenAI は強調しており、詳細はGPT‑6 システムカードに公開されています。
OpenAI の発表は、コスト調整済みの比較に強く依拠しています。先ほど触れた Sol の AutomationBench の結果においても、単に「Opus 5 より良い」と言うのではなく、「良く、かつタスク単価が約11分の1」としています。
また、OpenAI 自身の数値でも、コンピュータ操作タスクでは Astra が依然として Sol と Luna より先行していること、さらに Claude 系との一部比較では双方の努力設定が異なる(例:Sol は「xhigh」、Opus 5 は「medium」)ことが示されています。これにより、効率の主張は非常に強固である一方、生の能力比較はやや捉えにくくなっています。
以上を踏まえ、各ベンチマークが表す業務種別ごとに OpenAI の報告を整理します。
Sol の最良の結果は AutomationBench です。Zapier が提供するこのテストは、営業・マーケ・オペレーション・サポート・財務・人事の47ツールをまたいで、エージェントのエンドツーエンド性能を測るもの。GPT‑6 Sol は xhigh 努力で 33.2% を記録し、タスク単価 $0.27。最大努力の Claude Opus 5 を上回り、低努力の GPT‑6 Astra も上回り、しかも Opus 5 のタスク単価のごく一部です。
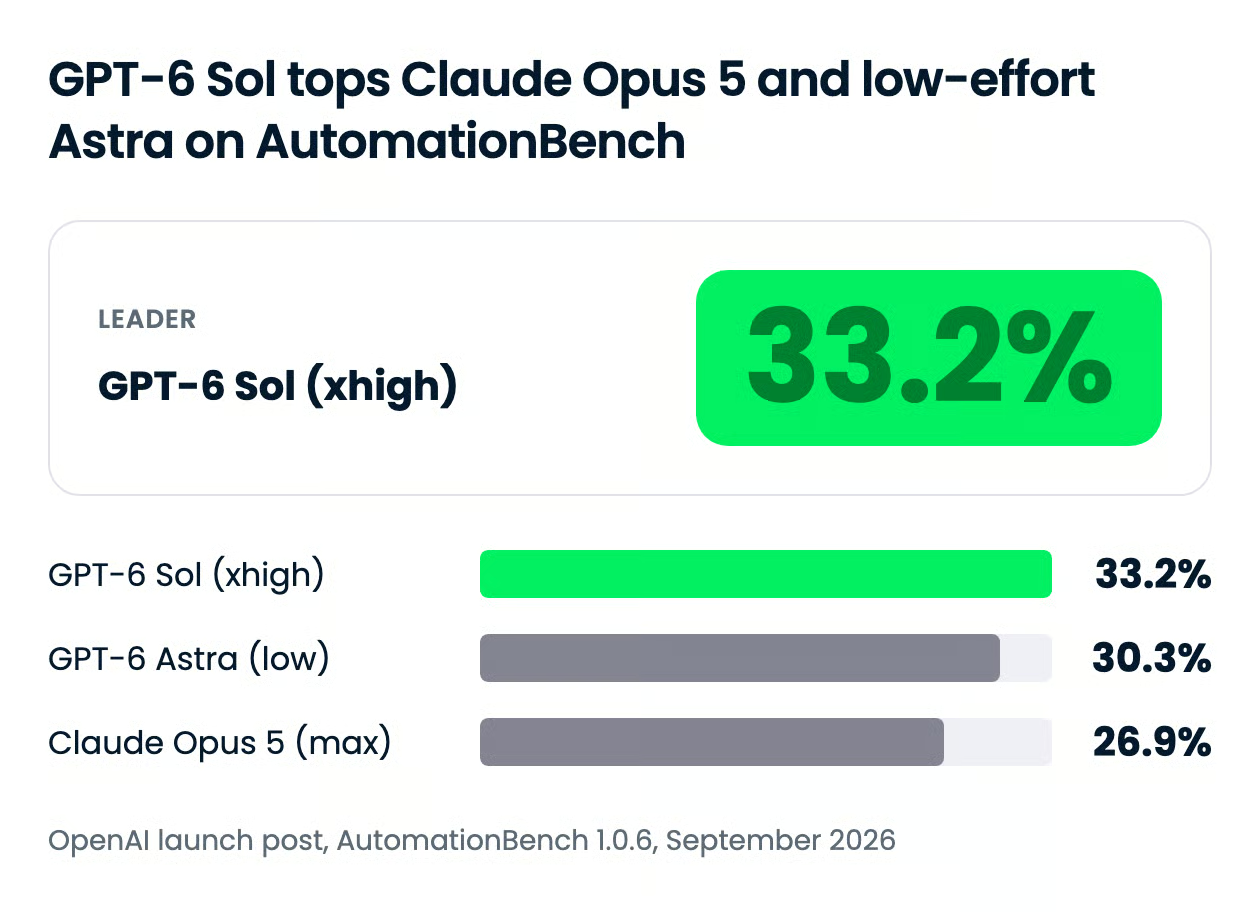
Fable 5.1 の行は注意して読む必要があります。OpenAI は、Sol のすぐ下に Opus 5 フォールバック付きの Claude Fable 5.1(最大努力)を掲載していますが、約40%のタスクでフォールバックが発火しており、そのコストは報告値に含まれていません。
| モデル(努力) | AutomationBench スコア | タスク単価 |
|---|---|---|
| GPT‑6 Sol(xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra(low) | 30.3% | GPT‑6 Sol の 3.9 倍 |
| Claude Fable 5.1(Opus 5 フォールバック付き、max) | 31.4% | GPT‑6 Sol の 8.9 倍超(フォールバック費用は未算入) |
| Claude Opus 5(max) | 26.9% | GPT‑6 Sol の 11.1 倍 |
同じベンチマークにおける Luna は、世代間の進歩が物語です。高努力では、GPT‑6 Luna は GPT‑5.6 Luna を 5.4 ポイント上回り、タスク単価は 58% 削減されました。
Agents' Last Exam(55 のサブ業界にわたる長期的なプロフェッショナルワークフローを評価)では、GPT‑6 Sol は最大努力で 56.4% を記録。OpenAI によれば、Claude Opus 5 のベストスコアを上回り、タスク単価は 60% 低いとされています。
実リポジトリにおける長期ソフトウェア工学タスクを評価する DeepSWE v1.1 では、GPT‑6 Sol は最大努力で 68.8%。Claude Fable 5 の評価内ベストは xhigh 努力で 69.9% なので、Sol は 1.1 ポイント差で、タスク単価は約 80% 低い位置づけです。
同ベンチマークで GPT‑6 Luna は最大努力で 66.6%。OpenAI は、これは中位努力の Claude Opus 5 と Fable 5 に相当するとし、Luna はタスク単価で Opus 5 比 93% 減、Fable 5 比 96% 減としています。
独立系の数値は現時点で控えめです。Artificial Analysis は、Coding Agent Index で GPT‑6 Sol を 57(GPT‑5.6 Sol は 55)、Intelligence Index で 48(同 47)とし、推定タスク単価は $1.99 から $1.06 に低下と見積もっています。
OpenAI の社内ファクチュアリティ評価は、過去モデルに関する事実誤りをユーザーが指摘した ChatGPT の会話(個人情報は削除)で構成。そこで GPT‑6 Sol は GPT‑5.6 Sol に比べ、ミスを約半分に減少。GPT‑6 Luna は高努力で GPT‑5.6 Sol に匹敵し、コストは約 100 分の 1 とされています。
Artificial Analysis の AA-Omniscience でも同様の傾向ですが但し書きあり。Sol のハルシネーション率は GPT‑5.6 Sol の 92% から 60% に低下した一方で、回答率は 99% から 83% に下がっており、向上の一部は「回答を控える」ことによるものです。Luna の同テストでのハルシネーション率は 77% でした。
Astra は依然として OpenAI の最良のコンピュータ操作モデルであると明言されています。OSWorld 2.0 オフラインでは、GPT‑6 Sol(xhigh 努力)が 60.5% を記録し、Claude Opus 5(medium 努力)の 60.3% を上回りつつ、タスク単価は約 80% 低い。GPT‑6 Luna(max)は、GPT‑5.6 Sol(medium)を上回り、その 10 分の 1 のコストです。
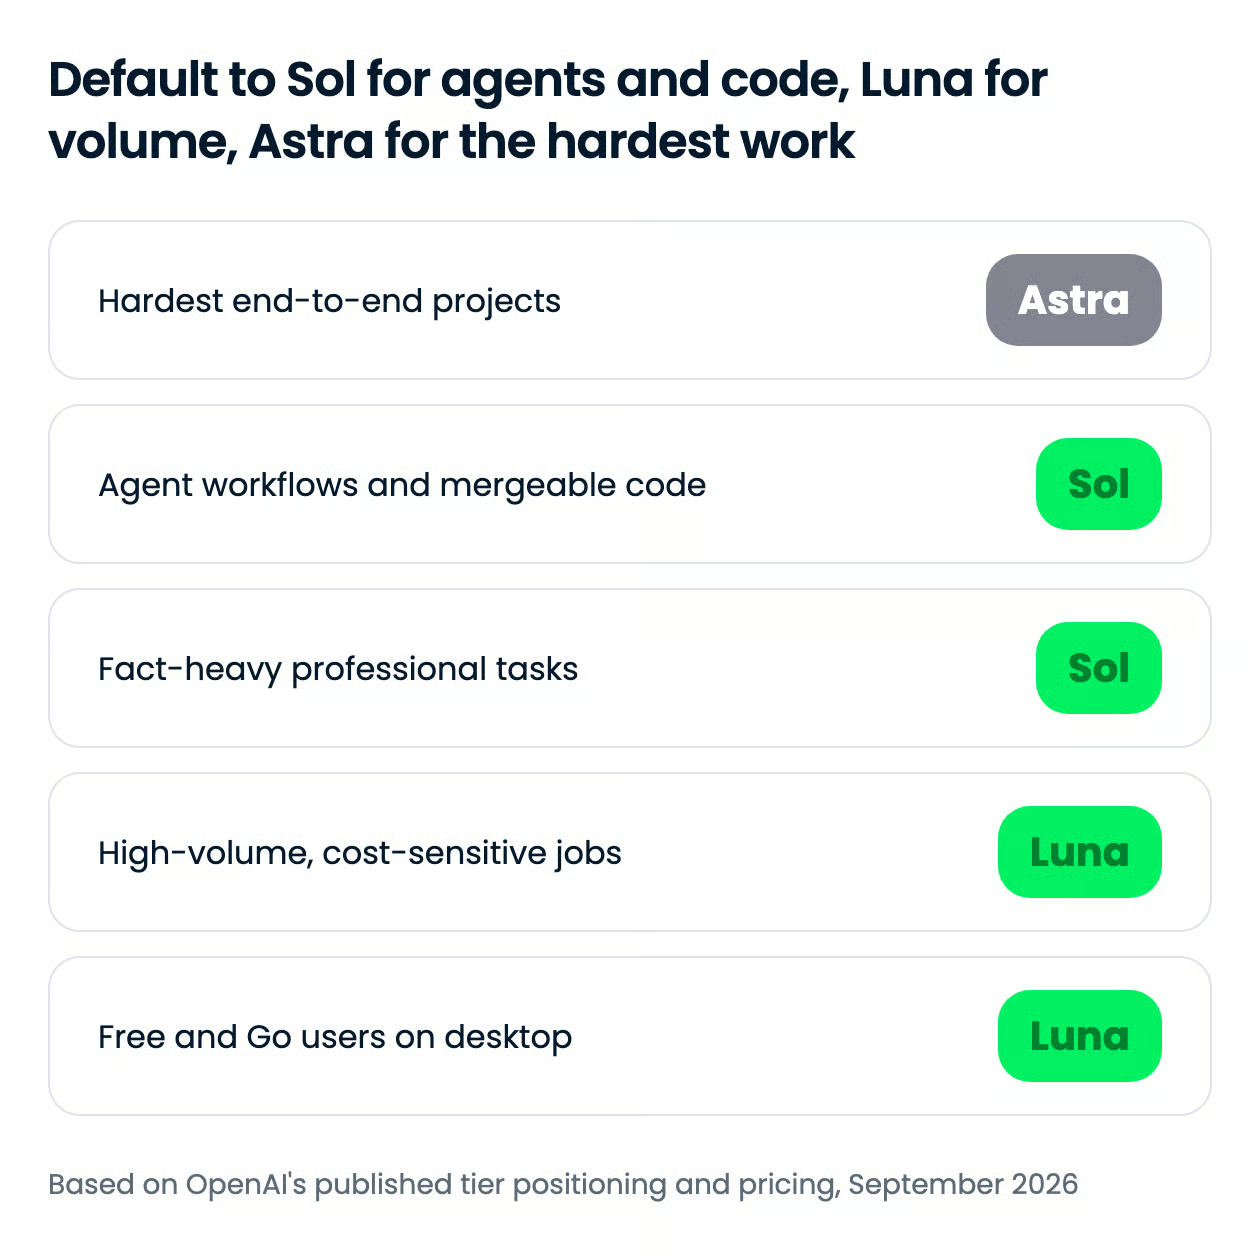
開発者およびエージェント用途の標準は Sol、ボリューム重視は Luna、誤答のコストがトークン代を上回るプロジェクトには Astra、という住み分けです。GPT‑6 ファミリーは、同じ学習レシピを共有しつつ、深さ・速度・価格で差別化された3ティアになりました。
いずれも API では同じ推論ラダーを公開しています。Sol/Luna は none、low、medium、high、xhigh、max、Astra は low から。上位の段ほど推論に費やすトークンが増え、OpenAI の主要な結果は多くが xhigh か max で実行されています。
GPT‑6 では、プロンプトキャッシュを無効化せずに会話の途中で努力レベルを切り替えられるため、エージェントは簡単な追跡処理を低努力で安く回し、難所だけ引き上げることが可能です。
| ユースケース | 推奨ティア | 理由 |
|---|---|---|
| ビジネスアプリ横断のマルチステップエージェント | Sol | AutomationBench と Agents' Last Exam を、競合のタスク単価の一部でリード |
| マージ可能な変更を出すコーディングエージェント | Sol | GPT‑5.6 Sol から FrontierCode で大幅向上。DeepSWE でも Fable 5 に近い性能を低コストで |
| 事実依存の下書きや調査サマリー | Sol | 前世代の事実誤りを約半減 |
| 大量の分類・抽出・ルーティング | Luna | 100万トークンあたり入力 $0.10、出力 $0.50。高努力ではファクチュアリティで GPT‑5.6 Sol に匹敵 |
| Free または Go プランでのデスクトップ利用 | Luna | これらのプランで利用可能な唯一の GPT‑6 モデル |
| 長期的なコンピュータ操作や最難関のエンドツーエンド作業 | Astra | 依然として総合的に最良。100万トークンあたり入力 $10、出力 $50 |
Luna に関する注意:Artificial Analysis は、タスクあたりの出力トークンが GPT‑5.6 Luna の 41,000 に対して Luna は 51,000 と測定しました。出力を制限しないワークロードでは、表示価格ほどの値下げが効かない場合があります。
上記のベンチマークは OpenAI 自身のものなので、同一プロンプトと同一ツール構成で4モデルすべてに同じビルドタスクを投げました。
タスク:ダイクストラ法の単一ファイル HTML ビジュアライザ。ターゲットが確定するまで 400ms ごとに 1 辺ずつ評価をアニメーションし、ノード状態を区別、停止/ステップ/再開の操作、最終的な距離表を表示。ビルド工程なし、依存なし、ネットワークなし。
実質的な試金石はデータファイルでした。そこには 3 つのグラフが含まれています。
プロンプトにはこれらの罠について一切触れていません。気づけるかが肝であり、GPT‑5.6 比での FrontierCode の向上と、コーディング作業に関する誤解を招く主張の減少という 2 点を同時に検証します。
4 モデルとも OpenCode 上で固定ツール(ファイル読込・編集のみ)、同一の推論努力、1 回限りの試行、新規セッション、プロンプトはバイト単位で同一に投入しました。
以下は、通常のグラフで GPT‑6 Sol が生成した例です。
主な発見点:
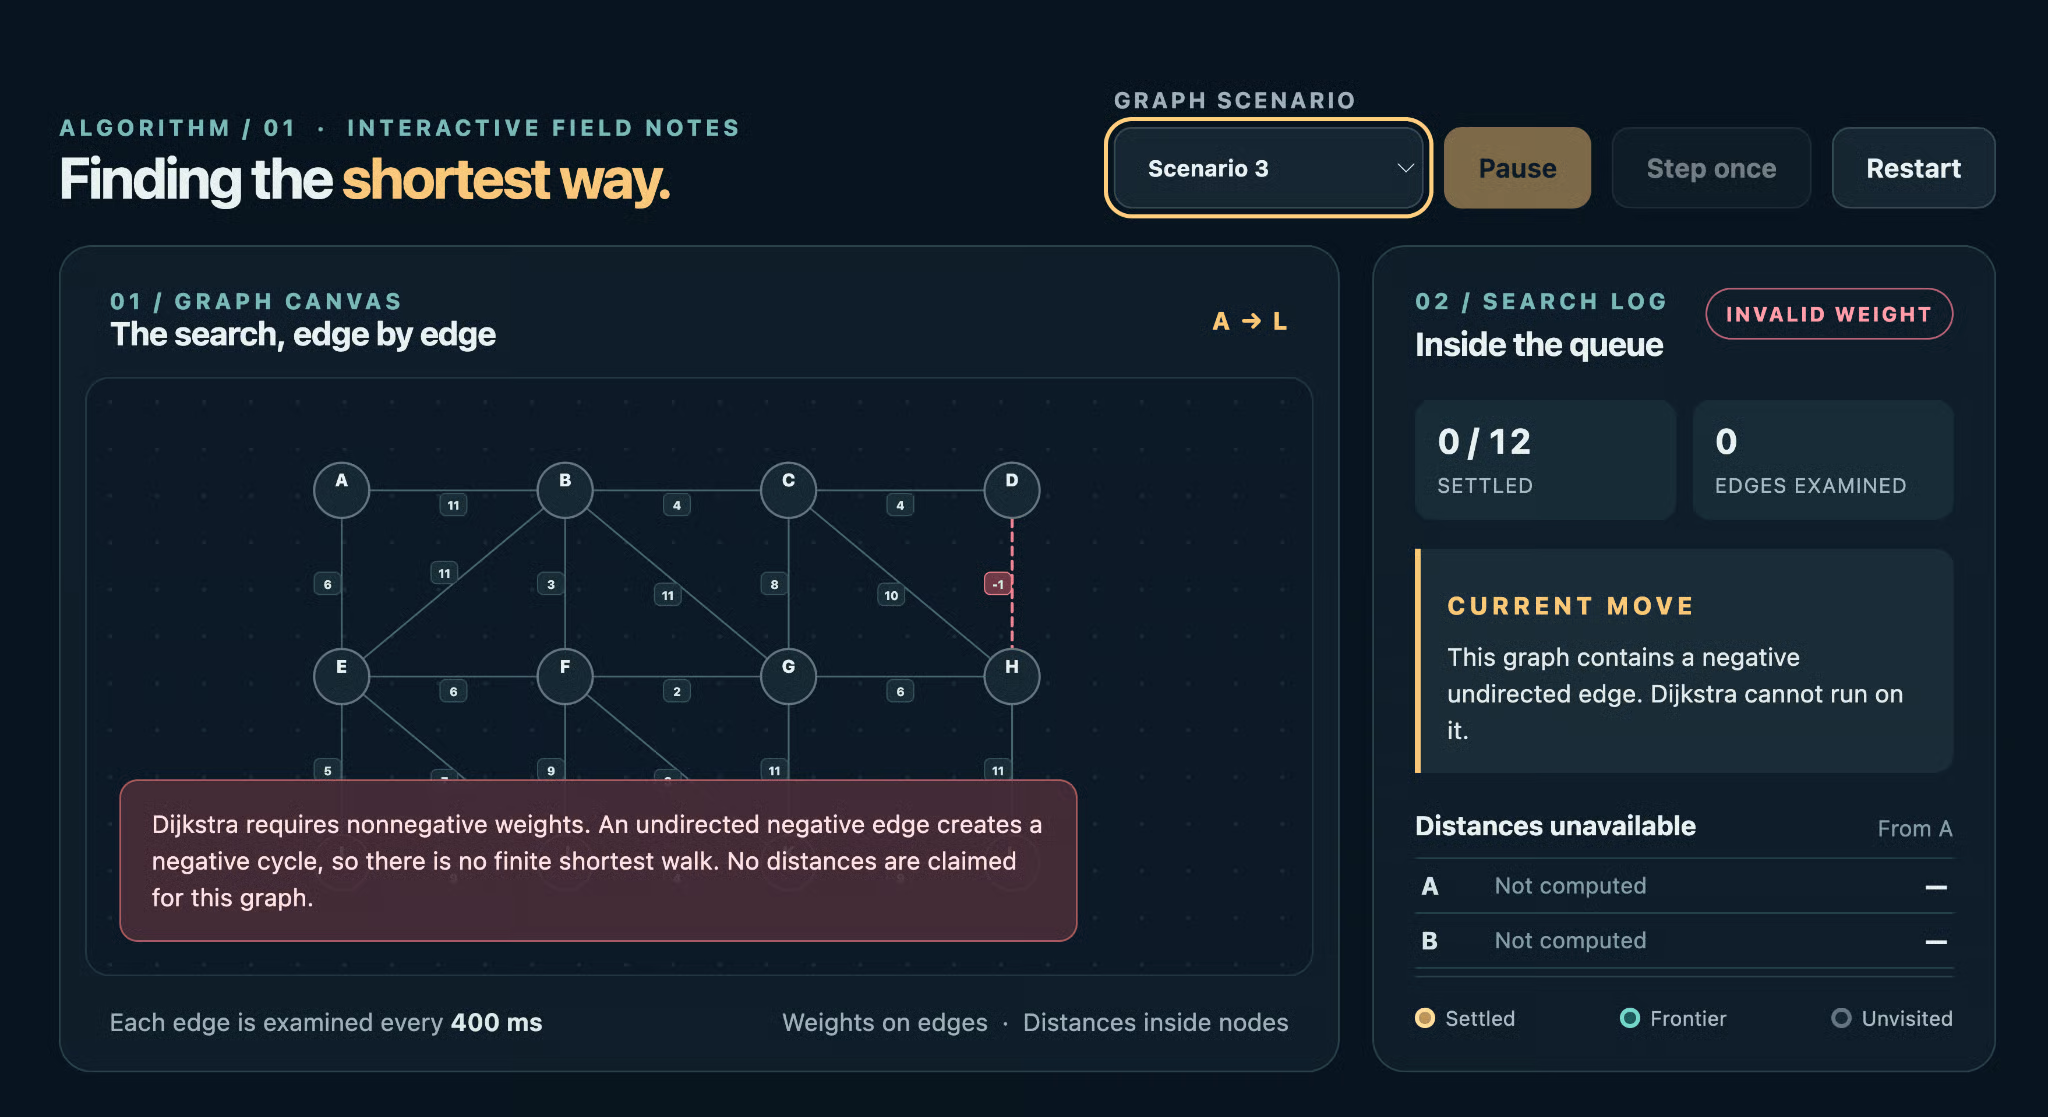
詳しく見ていきます。GPT-6 Sol は負の重みを理由にアルゴリズムの実行を拒否し、非常に目立つ赤いエラーメッセージを出しました。
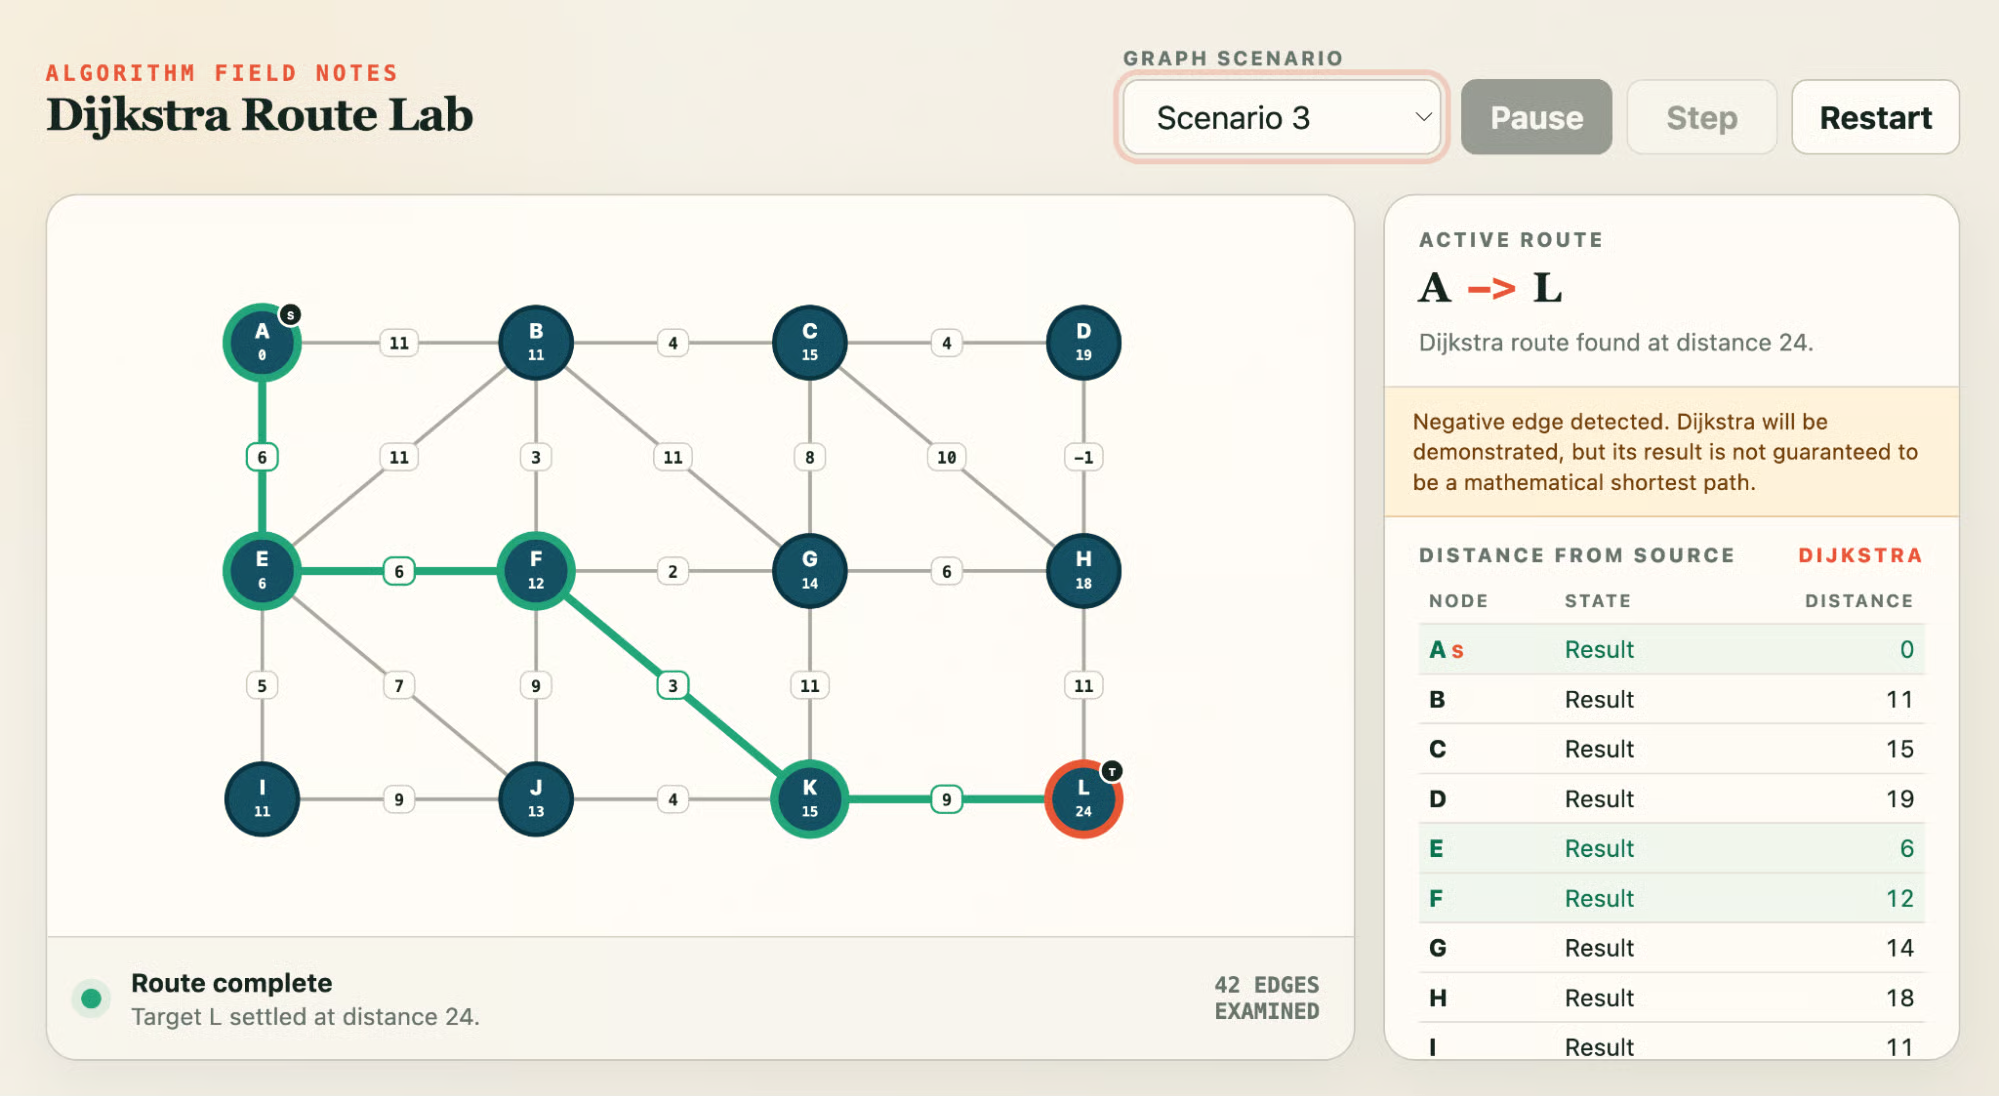
GPT‑5.6 Sol は負の重みを警告として示したものの、そのままアルゴリズムを実行し、あたかも正答であるかのように経路を強調表示し、距離表を埋めました。誤答に添えられた警告は、やはり誤答です。GPT‑5.6 Luna も同様でした。
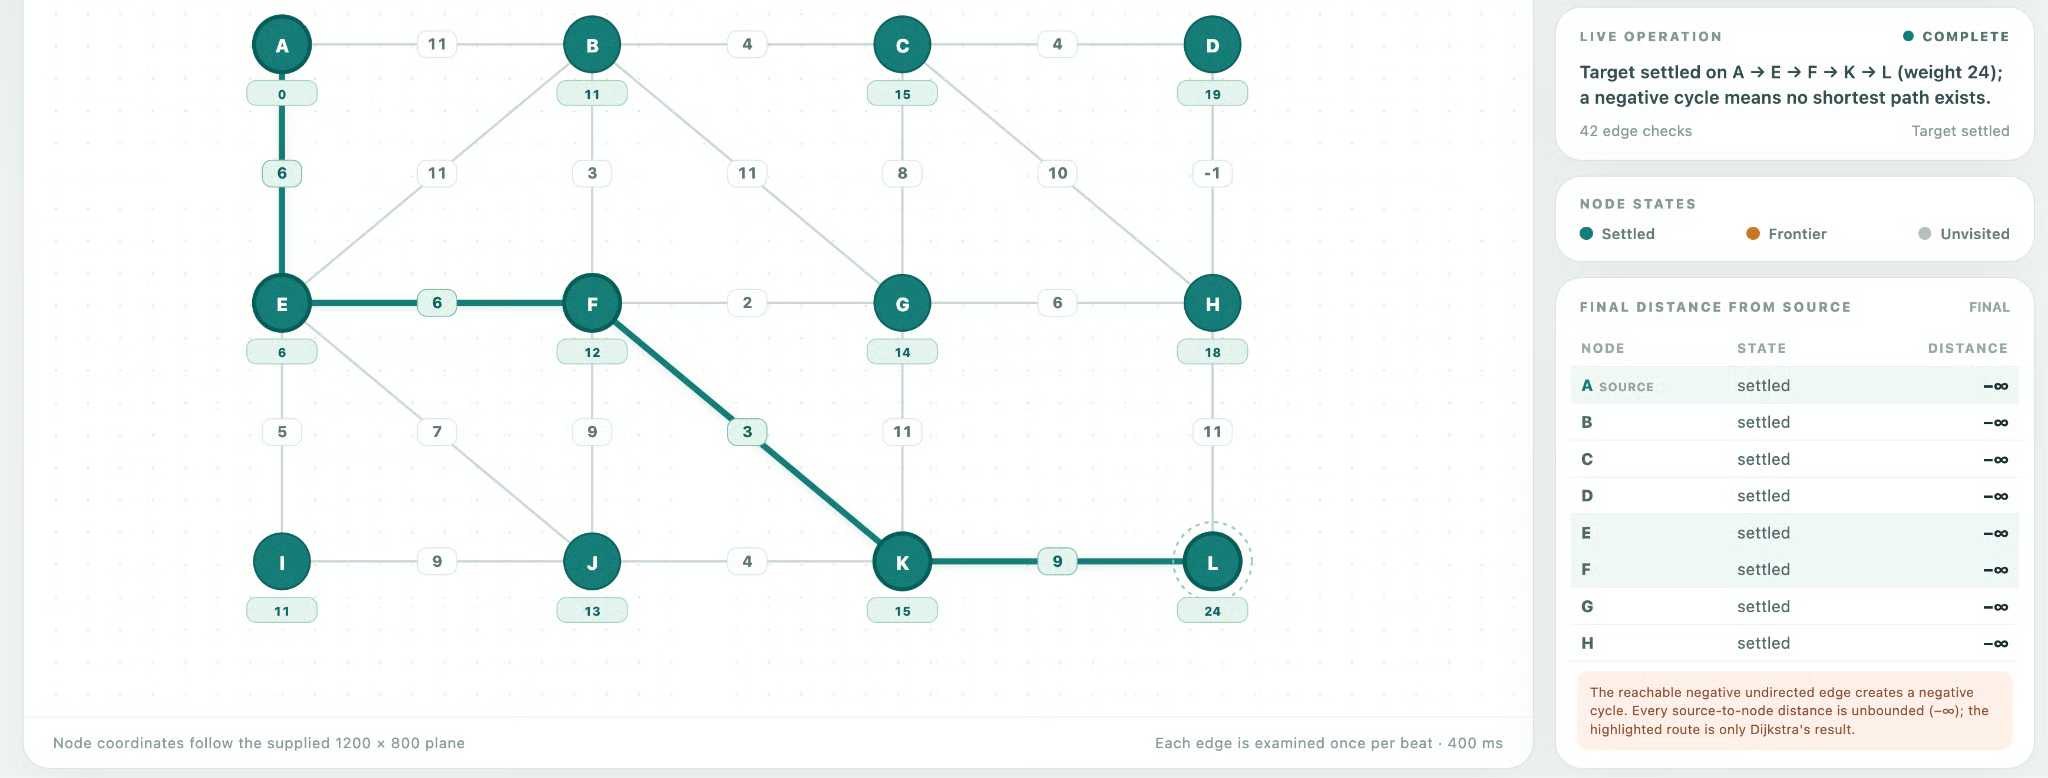
GPT‑6 Luna は中間的な挙動でした。該当辺を明示して Dijkstra は不適用とするバナーを出しつつ、距離表は負の無限大で埋める、というもの。無向負辺では理屈としては擁護可能ですが、読み手には分かりにくいでしょう。
では GPT‑6 は実際に前進したのか?わずかに、しかも 1 点だけ。ただし重要な点です。ビルドタスク自体の生成品質は横並びで、差は壊れた入力をどう扱ったかに尽きます。これは OpenAI の「誠実さ」の主張には対応しますが、「コーディング力」の主張とは別軸です。Luna の 2 モデル間では差は出ませんでした。
もう 1 つの教訓はテスト設計です。4 モデルが 1 つを除くすべてのプローブを難なく越えるなら、合格基準は引き上げる必要があります。
新しいコスト構造は以下のとおり。いずれも GPT‑5.6 時の各モデルから 50% の値下げです。
| 100万トークンあたり | GPT‑6 Sol | GPT‑5.6 Sol | GPT‑6 Luna | GPT‑5.6 Luna |
|---|---|---|---|---|
| 入力 | $2 | $4 | $0.10 | $0.20 |
| 出力 | $10 | $20 | $0.50 | $1.20 |
GPT‑6 ではキャッシュ済み入力トークンの読み出しが 90% 割引となるため、長時間のエージェント実行では、キャッシュヒット率が表示価格と同等に重要です。OpenAI のローンチ投稿ではバッチ料金は非公開で、両モデルは GPT‑6 Astra(入力 $10/出力 $50)より下位に位置付けられます。
アクセス条件は、OpenAI のローンチ投稿ではプランとプロダクト面が明示され、ここで具体的になります。
GPT‑6 Sol と Luna はすでに多くのプラットフォームで利用可能です。
ChatGPT Work と Codex:Plus、Pro、Business、Enterprise、Edu の各ユーザー向け。デスクトップアプリでは Free と Go のユーザーにも Luna が提供されます。
API では gpt-6-sol と gpt-6-luna として利用可能。ChatGPT へのロールアウトは一日を通じて段階的に進むため、反映に時間がかかる場合があります。
さらに、両モデルは OpenRouter(openai/gpt-6-sol と openai/gpt-6-luna)、GitHub Copilot、Azure AI Foundry、AWS Bedrock でも利用できます。
API では gpt-6-sol と gpt-6-luna として利用可能です。ChatGPT へのロールアウトは一日を通して段階的に行われるため、全員に表示されるまで少し時間がかかる場合があります。最小限の呼び出しは次のとおりです。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="List the open pull requests that touch billing code and summarize the risk of each.",
)
print(response.output_text)
GPT‑5.6 から移行する場合、Astra を前提に書かれた OpenAI の GPT‑6 モデルガイダンスでは、temperature と top_p を外し、none または minimal を使っていたなら low から始め、それ以外は現在の努力レベルを維持すること、prompt_cache_retention を prompt_cache_options.ttl(30 分)に変更することを推奨しています。
Sol と Luna は、フラッグシップ Astra の学習レシピを下位ティアに適用し、大幅に安く速くしました。OpenAI の発表は、Anthropic のモデルを名指しし、コスト調整済みベンチマークでの優位を主張しているのが特徴的です。比較対象としても興味深く、Opus 5.5 も効率面の勝利だからです。
所感:GPT‑5.6 の Sol または Luna でエージェントやコーディングのワークロードを回しているなら、今すぐ切り替えを。努力ラダーは同じで価格は半分。今回のテストでは、GPT‑6 Sol が前世代と違ったのは、アルゴリズムが答えられない問いに自信満々の答えを出さなかったこと。Claude を使っている場合は、コスト調整済みの数値を根拠に、OpenAI の主張をうのみにせず自分で比較テストするのが筋でしょう。
これらのモデルで開発してみたい方には、API を 15 時間で端から端までカバーする OpenAI Fundamentals スキルトラックをおすすめします。
DataCamp で学ぶ
Courses
Courses
Courses