
Last chance! 50% off DataCamp Premium
Sale ends in
Her makine öğrenimi projesi eninde sonunda etiketli veriye ihtiyaç duyar ve bu veriyi etiketlemek, çoğu ekibin karşılayabileceğinden daha fazla zaman ve paraya mal olur.
Bir milyon görseli etiketlemek ya da bir milyon ses klibini yazıya dökmek için bir ekip tutmak altı haneli maliyetlere çıkabilir. Aynı zamanda internet, etiketlenmemiş metin, görsel, ses ve video ile doludur. ML ekiplerinin kullanabileceklerinden çok daha fazla ham verisi vardır, ancak bunların neredeyse hiçbirinde modeli eğitmek için gereken etiketler bulunmaz.
Kendi kendini denetimli öğrenme etiketleme adımını gerektirmez. Verinin kendi yapısını eğitim bilgisine dönüştürür. Bir görselde ne olduğunu ya da bir cümlenin ne anlama geldiğini söylemeleri için insanlara ödeme yapmak yerine, verinin zaten kendi başına cevaplayabildiği bir görev kurarsınız - örneğin bir kelimeyi gizleyip modelin çevresindeki kelimelerden tahmin etmesini istemek gibi.
Bu yazıda, kendi kendini denetimli öğrenmenin nasıl çalıştığını parçalarına ayıracağım, başlıca tekniklerini ele alacağım ve denetimli, denetimsiz ve yarı denetimli öğrenmeyle nasıl karşılaştırıldığını göstereceğim.
Kendi kendini denetimli öğrenme, veriyi önce birinin elle etiketlemesine gerek kalmadan modelleri eğitmenin bir yoludur.
Bir kişinin her örneği etiketlemesi yerine, verinin kendi cevap anahtarı vardır. Model girdinin bir kısmına bakar, başka bir kısmını gizler ve aradaki boşluğu doldurmaya çalışarak öğrenir. İnsan müdahalesine gerek yoktur.
Örneğin bir cümleyi alıp bir kelimeyi gizleyebilir ve modelden onu etrafındaki kelimelerden tahmin etmesini isteyebilirsiniz. "Mühendis ___ ögesini ana dala itti" ifadesi, kimse doğru cevabı söylemeden modelin bağlamdan "kodu" veya "değişiklikleri" tahmin edebilmesi için yeterli ipucu verir. Cümlenin kendisi etikettir.
Kendi kendini denetimli öğrenme, iki kategori arasında tuhaf bir konumdadır. Eğitim hedefi denetimli öğrenmeye benzer - net bir girdi, net bir hedef ve tahminin ne kadar hatalı olduğunu ölçen bir kayıp fonksiyonu vardır. Ancak bu hedefleri bir insan oluşturmadığı için, genellikle denetimsiz öğrenme ile aynı gruba konur; o da ham, etiketlenmemiş verilerle çalışır. Kendi kendini denetimli öğrenme, birinden mekanikleri, diğerinden veri kaynağını ödünç alır.
Süreç, ne tür veriyle çalışırsanız çalışın tekrarlanabilir bir kalıbı izler. Adımlar şunlardır:
Ört-görev sadece bir eğitim alıştırmasıdır. Kimse sırf eğlence için gizli kelimeleri tahmin eden bir modeli üretime almaz - asıl değer, yol üzerinde edindiği ve gerçek problemlere aktarılabilen temsillerden gelir.
Kendi kendini denetimli öğrenmeyi anlamanın en kolay yolu, diğer eğitim paradigmalarıyla nerede örtüştüğünü ve nerede ayrıştığını görmektir.
Denetimli öğrenme her girdi için etiketli bir örnek gerektirir; örneğin "köpek" etiketi taşıyan bir görsel ya da "olumsuz" etiketi taşıyan bir yorum. Bu etiketleri birinin elle üretmesi gerekir; bu da maliyet, zaman ve gerçekte ne kadar veri kullanabileceğinize dair bir tavan anlamına gelir.
Kendi kendini denetimli öğrenmede modelin yine tahmin edeceği bir hedefi vardır, ancak hedef verinin kendisinden gelir - gizli bir kelime ya da bir dizideki bir sonraki token gibi. Eğitim sinyalini üretmek için insan anotasyonuna gerek yoktur.
Her iki yöntem de etiketlenmemiş veriler üzerinde çalışır, bu yüzden sıklıkla karıştırılır. Fark hedefte yatar.
Denetimsiz öğrenme belirli bir tahmin hedefi olmadan yapı arar; örneğin benzer müşterileri kümelendirmek veya bir veri kümesinin boyutunu azaltmak gibi. Kendi kendini denetimli öğrenme, veriden açık bir tahmin görevi üretir ve modeli bunu çözmek üzere eğitir. Bu tahmin hedefi, etiketler kendiliğinden üretilmiş olsa da, kendi kendini denetimli öğrenmeye denetimli tarzda bir eğitim döngüsü kazandırır.
Yarı denetimli öğrenme küçük bir etiketli veri kümesini daha büyük bir etiketlenmemiş olanla bilinçli olarak harmanlar ve ikisini aynı anda kullanarak modeli geliştirir.
Kendi kendini denetimli ön eğitim, başlamak için hiçbir etikete ihtiyaç duymaz. Ön eğitimi tamamen etiketlenmemiş veri üzerinde yapabilir, ardından isteğe bağlı olarak daha sonra ince ayar için etiketli bir veri kümesine devredebilir. Etiketler, eğer devreye girerse, ön eğitimden sonra gelir.
| Etiket gerekir | Öğrenme sinyali kaynağı | Tipik kullanım | |
|---|---|---|---|
| Denetimli | Evet, her örnek için | İnsan yapımı etiketler | Modeli doğrudan hedef görev üzerinde eğitme |
| Denetimsiz | Hayır | Verideki yapı (kümeler, desenler) | Kümelendirme, boyut indirgeme |
| Yarı denetimli | Bazı, etiketlenmemiş veriyle karışık | Etiketli örnekler artı etiketlenmemiş verideki desenler | Etiketli veri az olduğunda doğruluğu artırma |
| Kendi kendini denetimli | Hayır, ön eğitimde | Verinin kendisinden kurulan bir ört-görev | Aşağı akış göreve ince ayardan önce ön eğitim |
Kendi kendini denetimli öğrenmenin diğer yöntemlerle karşılaştırması
Kendi kendini denetimli yöntemler, her biri farklı bir ört-görev türü etrafında şekillenen birkaç geniş aileye ayrılır.
Karşıtsal öğrenme, bir modeli ilişkili örnekleri ilişkisiz olanlardan ayırt edecek şekilde eğitir. "Benzer"i tanımlamak için hiç manuel etiket kullanmadan, benzer örneklerin temsillerini birbirine yaklaştırır, benzer olmayanlarınkini uzaklaştırır.
Aynı görselin iki artırılmış sürümü ilişkili sayılır. Bir görsel ve ona karşılık gelen altyazı da ilişkilidir. SimCLR bu fikri tek bir modalite içinde uygular; aynı görselin farklı kırpımları veya dönüşümlerini karşılaştırır. CLIP ise bunu çapraz modalitelerde uygular; görselleri onları tanımlayan metinle hizalar.
Maskeli modelleme girdinin bir kısmını gizler ve modeli bunu yeniden kuracak şekilde eğitir. Bu, daha önceki boşluk doldurma örneğinin daha geniş uygulanmış halidir.
Dilde, bu maskeli dil modelleme olarak karşımıza çıkar; bir cümlede birkaç kelimeyi gizleyip geri kalanından tahmin etmek gibi. Görüntüde, maskeli görüntü modelleme olarak görünür; bir görselin yamalarını gizleyip modelden eksik pikselleri veya alttaki temsili yeniden kurmasını istemek gibi.
Oto-gerileyen öğrenme, bir dizideki bir sonraki öğeyi ondan önce gelen her şeyi kullanarak tahmin eder. Bir cümlenin başlangıcı verildiğinde model bir sonraki kelimeyi tahmin eder; o kelime verildiğinde bir sonrakini ve bu şekilde devam eder.
Bu, modern dil modeli ön eğitiminin arkasındaki hedeftir. Metin için doğal bir uyumdur; dil zaten soldan sağa bir dizi halinde gelir ve ek bir kurulum gerektirmeden devasa metin külliyatlarına sorunsuz ölçeklenir.
Kendini damıtma, modelin hedef olarak veride gizli sabit bir cevap yerine kendi tahminlerini kullandığı bir eğitim yaklaşımıdır.
Yaygın bir kurulumda aynı ağın iki sürümü - bir "öğrenci" ve bir "öğretmen" - aynı girdinin farklı görünümleri üzerinde çalıştırılır. Öğrenci, öğretmenin çıktısını eşleştirmeyi öğrenir ve öğretmen, öğrencinin yavaş hareket eden ortalaması olarak güncellenir. DINO ve BYOL bu yaklaşımın temsilcileridir. Negatif örneklere veya maskeli girdilere gerek yoktur; model, görünümler arasındaki tutarlılıktan kendi denetimini kendisi üretir.
Kendi kendine denetim, büyük dil modelleri için tüm ön eğitim aşamasıdır. Kullandığınız her büyük dil modeli, tek bir insan yapımı etiket olmadan; yalnızca ham metin üzerinde kendi kendini denetimli ört-görevleri çözerek dil yapısını, olguları ve akıl yürütme kalıplarını öğrenmiştir.
Modern LLM'lerin çoğu, sonraki token tahminiyle ön eğitim yapar: bir token dizisi verildiğinde sıradaki geleni tahmin et. Model bir pozisyondan önce gelen her şeyi okur ve ardından ne geldiğini tahmin eder, gerçek sonraki tokene karşı kendini kontrol eder ve ayarlar.
Bunu web sitelerinden ve kod depolarından kazınan trilyonlarca token üzerinde çalıştırırsanız, model yol boyunca dilbilgisi, olgular ve hatta akıl yürütme kalıplarının işleyen bir modelini kurar. Bu, daha önce değinilen oto-gerileyen hedefin aynısıdır; sadece ölçekli olarak uygulanır.
Oto-gerileyen ön eğitim yaygınlaşmadan önce, BERT gibi modeller farklı bir ört-görev kullandı. Sıradaki geleni tahmin etmek yerine, BERT bir cümle boyunca rastgele tokenleri gizler ve her iki yandaki bağlamı kullanarak bunları tahmin eder.
Bu iki yönlü bağlam, maskeli dil modellerini sınıflandırma ve soru-cevaplama gibi anlama görevlerinde iyi yapar; her ne kadar sonraki token tahmini modellerinin yaptığı gibi metin üretmese de.
Bunların hiçbiri hacim olmadan işlemez. Ön eğitim; web sayfaları, kitaplar, kod depoları ve forumlardan elde edilen verileri filtreleyip yinelenenleri gidererek milyarlarca veya trilyonlarca token içeren külliyatlara dönüştürür. Külliyat ne kadar büyük ve çeşitliyse, ortaya çıkan temsiller o kadar genel olur.
Ön eğitim, kendi kendine denetimin işini yaptığı yerdir ama son aşama değildir. İnce ayar, insan yazımı talimat örnekleri üzerinde modeli yönergelere uymaya öğretir ve RLHF veya DPO gibi tercih optimizasyonu yöntemleri, yanıtları biçimlendirmek için derecelendirilmiş insan tercihlerini kullanır. Bu iki sonraki aşamanın ikisi de etiketli veri gerektirir. Kendi kendini denetimli ön eğitim ise etiket gerektirmeyen tek aşamadır.
Bilgisayarlı görü, etiketli verinin yeterince olmadığı alanın adeta mükemmel bir örneğidir. Sınırlayıcı kutular ve bölütleme maskeleri, bir metin parçasına tek bir etiket koymaktan çok daha uzun sürer; bu da kendi kendini denetimli yöntemleri burada özellikle değerli kılmıştır.
Karşıtsal görüntü öğrenme, daha önce değinilen bir araya çekme/itme fikrini uygular; aynı fotoğrafın iki artırılmış sürümünü (bir kırpma veya çevirme) alıp modeli bunları ilişkili tanımaya, partideki diğer görselleri ilişkisiz saymaya eğitmek gibi. SimCLR, bu yaklaşımın görsellere uygulanmış iyi bilinen bir örneğidir.
Maskeli görüntü modelleme, dildeki boşluk doldurma fikrini alıp piksellere uygular. Fikir, bir görselin yamalarını gizlemek ve modeli eksik içeriği ham pikseller olarak veya öğrenilmiş bir özellik temsili olarak yeniden kuracak şekilde eğitmektir. Bu, MAE (Maskeli Otomatik Kodlayıcılar) hedefinin arkasındaki fikirdir.
Görsel-metin hizalama, bir görseli onu tanımlayan altyazıyla eşleyecek şekilde modeli eğitir; eşleşen çiftleri ortak bir gömme uzayında birbirine yaklaştırır, eşleşmeyenleri ayırır. CLIP en bilinen örnektir ve bu şekilde eğitilen modellerin sıfır örnekli sınıflandırmayı desteklemesinin bir nedenidir - yalnızca bir görseli bir metin açıklamasıyla karşılaştırarak, açıkça eğitilmedikleri kategorileri tanıyabilirler.
Ört-görev her zaman verinin şekline uyar; bu yüzden nerede çokça etiketlenmemiş veri varsa, genellikle onun etrafında bir kendi kendini denetimli görev tasarlayabilirsiniz.
Konuşma ve seste, modeller maskeli ses segmentlerini tahmin eder veya görme modellerinin görüntü kırpımlarını karşılaştırdığı gibi farklı klipleri karşıtlar; böylece, baştan yazıya dökülmüş eğitim verisine ihtiyaç duymadan konuşma tanıma gibi görevler için faydalı temsiller öğrenirler.
Videoda, ört-görev gelecekteki kareleri tahmin etmeyi veya aynı kaynak videodan gelen klipleri eşleştirmeyi içerebilir; bu da modele tek bir görselin sağlayamayacağı bir hareket ve zamansal yapı duygusu kazandırır.
Çok kipli (multimodal) modeller, bu fikirlerin iki veya daha fazlasını aynı anda birleştirir; metin, görsel, ses ve videoyu, CLIP'in görselleri ve metni hizalamasına benzer şekilde ortak bir temsil uzayında hizalar; sadece daha fazla veri türüne genişletilmiş olarak.
Kendi kendine denetim, bilimsel ve sensör verilerinde bile karşımıza çıkar - genom dizileri veya zaman serisi sensör okumaları gibi - burada sinyalin parçalarını maskelemek veya tahmin etmek, bir modelin ilk etapta "etiketlenmek" için tasarlanmamış ölçümlerden yapı öğrenmesini sağlar.
Ön eğitim, bir ört-görevi iyi çözen bir model üretir. Kimse gerçekte bunu umursamaz; gerçekten önemli olan, sonrasında onunla ne yaptığınızdır.
İnce ayar, önceden eğitilmiş modeli alır ve tüm ağırlıklarını, bu kez gerçekten istediğiniz görev için etiketli veriler üzerinde eğitmeye devam eder. Model zaten alanın yapısını anladığı için, sıfırdan bir modeli eğitmeye kıyasla genellikle çok daha az etiketli veri gerekir.
Doğrusal yoklama, önceden eğitilmiş modeli tamamen dondurur ve yalnızca çıktısının üzerine tek bir doğrusal katman eğitir. Basit bir doğrusal sınıflandırıcı, bu donmuş özellikleri kullanarak sınıfları ayırabiliyorsa, ön eğitimli temsiller gerçek bir yapı yakalamıştır. Bu, doğrusal yoklamayı, tam modelin ne kadar iyi ince ayarlanabildiğinden bağımsız olarak, temsil kalitesini tek başına test etmek için yaygın bir yöntem yapar.
Özellik çıkarımı, doğrusal yoklamayla aynı şekilde çalışır ama doğrusal kısmı olmadan. Donmuş temsilleri alır ve dilediğiniz herhangi bir aşağı akış algoritmasına verirsiniz. Ön eğitimli modelin tek işi iyi gömmeler üretmektir; ondan sonrası size kalmıştır.
Bazı temsiller, hiç aşağı akış eğitimi olmadan bile kullanılacak kadar iyidir. CLIP bunu bir görseli ve aday metin etiketleri kümesini aynı uzaya gömerek, ardından görsele en yakın etiketi seçerek yapar. Az örnekli öğrenme ise aynı fikri alır ve az sayıda etiketli örnek ekler; temsiller zaten modelin ihtiyaç duyduğu yapının çoğunu taşıdığı için bu genellikle yeterlidir.
Kendi kendini denetimli öğrenmeyle yeniden kullanılabilir temsiller elde edersiniz. Bir kez ön eğitim yapar, sonra aynı çekirdeği ihtiyaç duyduğunuz kadar çok aşağı akış görevinde ince ayarlar, yoklar, özellik çıkarır veya sorgularsınız. Pahalı işin çoğu, görev başına bir kez değil, ön eğitim sırasında tek seferde gerçekleşir.
Burada, sıfırdan inşa edilmiş bir kendi kendini denetimli sistem değil, önceden eğitilmiş bir modeli kullanan hafif bir örnek yer alıyor - sadece iş akışının mantığını görmeniz için.
all-MiniLM-L6-v2, sentence-transformers paketi üzerinden erişilebilen, maskeli dil modelleme hedefiyle önceden eğitilmiş ve ardından cümle çiftleri üzerinde karşıtsal bir hedefle daha da eğitilmiştir. Kendi kendini denetimli kısım sizin için zaten yapılmıştır - siz sadece ortaya çıkan temsilleri işe koşuyorsunuz.
Başlamak için, bağımlılıkları kurduğunuzdan emin olun:
pip install sentence-transformers scikit-learnŞimdi koda geçelim:
from sentence_transformers import SentenceTransformer
from sklearn.linear_model import LogisticRegression

# Create unlabeled data
support_tickets = [
    "My order arrived damaged and I need a replacement.",
    "The app crashes every time I try to upload a photo.",
    "I love how fast the checkout process is now.",
    "Can you tell me when my refund will be processed?",
    "The new dashboard layout is so much easier to use.",
    "I can't log in, it keeps saying my password is wrong.",
]

# Load a model pretrained with a self-supervised objective
model = SentenceTransformer("all-MiniLM-L6-v2")

# Obtain learned representations
embeddings = model.encode(support_tickets)
print(embeddings.shape)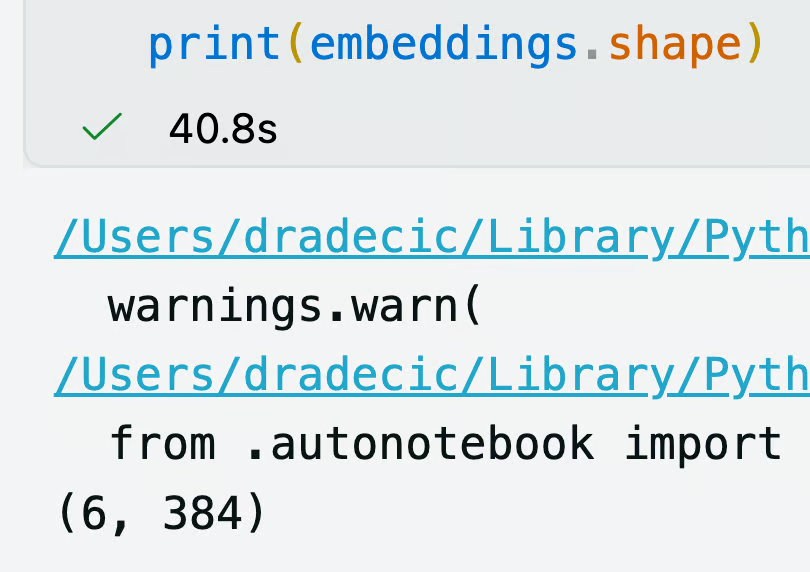
Gömme vektörlerinin boyutu
.encode() yöntemi, her bileti ön eğitimli modelden geçirir ve anlamını temsil eden yoğun bir vektör döndürür. Buradan sonra, aşağı akıştaki bir görevin yalnızca bir avuç etiketli örneğe ihtiyacı olur; çünkü gömmeler yapının çoğunu zaten taşır:
# Use the representations for a downstream task, 1 = complaint, 0 = positive feedback
labels = [1, 1, 0, 1, 0, 1]

clf = LogisticRegression()
clf.fit(embeddings, labels)

new_ticket = ["The delivery was late and no one responded to my email."]
new_embedding = model.encode(new_ticket)
print(clf.predict(new_embedding))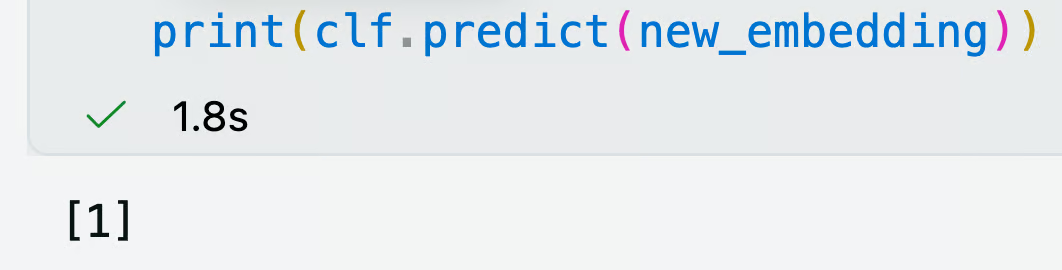
Lojistik regresyon tahmini
Altı etiketli bilet ve bir LogisticRegression sınıflandırıcı burada yeterlidir; çünkü işi çoğunlukla sınıflandırıcı değil, temsiller yapmaktadır.
Şimdi kendi kendini denetimli öğrenmenin artı ve eksilerini ele alayım.
Kendi kendini denetimli öğrenme, temel (foundation) modelleri mümkün kılan şeydir.
Modern modellerin gerektirdiği ölçekte ön eğitim, manuel etiketlere bağlı olsaydı erişilemez olurdu. Kimse trilyon tokenlık metni veya milyar görseli elle etiketlemez. Kendi kendine denetim, internet ölçekli koleksiyonlar üzerinde ön eğitimi pratik hale getirdi; ardından bu tek modeli her görev için ayrı bir model eğitmek yerine geniş bir aşağı akış görev yelpazesinde yeniden kullanmayı sağladı.
Birçok göreve özel modelden, birçok kullanıma uyarlanan tek bir genel amaçlı ön eğitimli modele geçiş, modern yapay zekânın büyük ölçüde yöneldiği doğrultudur. Bu geçişi mümkün kılan mekanizma kendi kendini denetimli öğrenmedir.
Kendi kendini denetimli öğrenme, bir insanın yazdığı etiketler yerine, etiketlenmemiş verinin yapısından kendi denetimini üretir. Tipik kalıp bir kelimeyi gizlemek ya da bir sonraki tokenı tahmin etmektir. Veri kendi sorularını kendi yanıtlar ve model bu yanıtları doğru bulmaya çalışarak öğrenir.
Başlıca yaklaşımların hepsi aynı fikri farklı şekillerde inşa eder. Karşıtsal öğrenme ilişkili örnekleri bir araya çeker, ilişkisizleri uzaklaştırır. Maskeli modelleme girdinin bir kısmını gizler ve modeli bunu yeniden kuracak şekilde eğitir. Oto-gerileyen öğrenme, bir dizideki bir sonraki öğeyi ondan önce gelen her şeyden tahmin eder. Mekanikler farklıdır; ancak eğitimin sinyalini verinin kendi yapısına bırakan temel ilke aynıdır.
Bu ilke, zaten kullandığınız dil, görme ve çok kipli modellerin çoğunun arkasında olmasının nedenidir. Bugünün LLM'leri sonraki token tahminiyle ön eğitilir; görme modelleri karşıtsal ve maskeli hedeflerle ön eğitilir ve iki alanı bir araya getiren çok kipli modeller görsel-metin hizalamasıyla ön eğitilir.
Sıfırdan bir LLM oluşturmayı öğrenmek istiyorsanız, PyTorch, Hugging Face ve en güncel NLP tekniklerini uygulamalı görmek için Büyük Dil Modelleri Geliştirme öğrenim yolumuza kaydolun.
DataCamp ile Öğrenin
Kurs
Kurs
Kurs
