GPT-4 是 OpenAI 开发的最先进生成式 AI,正在改变我们的工作方式。然而,GPT-4 并非开源,这意味着我们无法访问其代码、模型架构、数据或模型权重来复现结果,因此也无法自行打造一个像 GPT-4 一样的聊天机器人。
为平衡这种局面,开源 LLM 社区开始着手打造 GPT-4 的替代方案,这些方案在性能与功能上接近,同时所需计算资源更少。
您可以通过查阅 What is GPT-4 and Why Does it Matter? 了解 GPT-1、GPT-2、GPT-3 与 GPT-4,或学习如何将 ChatGPT 应用于数据科学项目,并掌握提示工程,以更好地构建端到端的数据科学项目。
本文将介绍 12 个 GPT-4 替代方案,并附上简要说明及相关论文、博文、聊天机器人演示、源码与模型卡的链接。
注意:其中一些模型采用非商业许可,仅限科研与学术用途。在使用前请务必了解这些限制。
1. ColossalChat
ColossalChat 是一个开源项目,提供完整的 RLHF(基于人类反馈的强化学习)流水线,允许您克隆 AI 模型。
该项目完全开源,包含双语数据集、训练代码、演示以及 4 位量化推理。所有组件都将帮助您更快更省成本地创建定制聊天机器人。
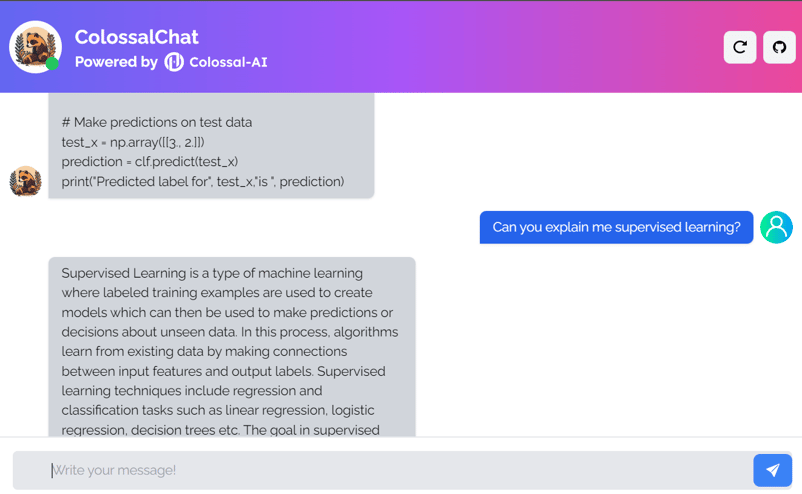
图片来源:ColossalChat
2. Alpaca-LoRA
Alpaca-LoRA 基于 Stanford Alpaca 与 低秩适配(LoRA) 训练而成。借助低秩适配,我们可以在仅有 4GB 内存的树莓派 4 上运行与 GPT-3.5 质量相近的 Instruct 模型。
该项目提供源码、微调示例、推理代码、模型权重、数据集与演示。更棒的是,我们可以在单张 RTX 4090 上用几小时完成训练。
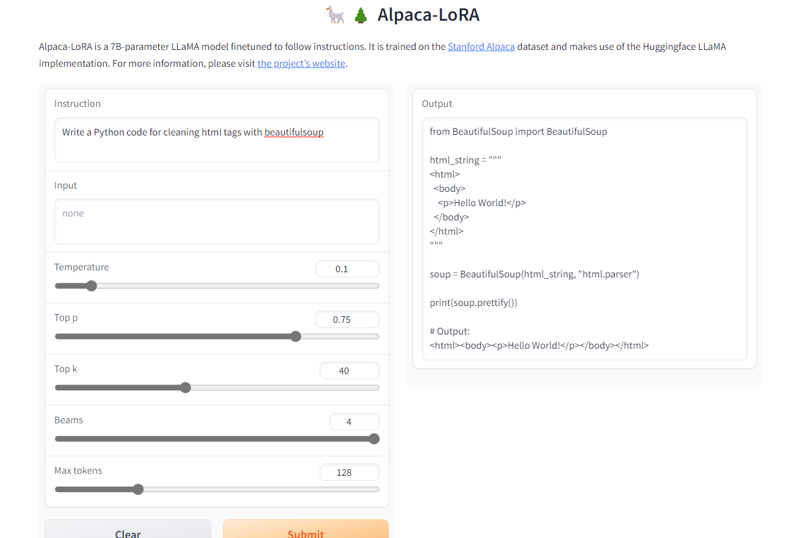
图片来源:Alpaca-LoRA
3. Vicuna
Vicuna 可为聊天机器人生成连贯且有创意的文本。它基于 Transformer 架构,并在来自 ShareGPT.com 的对话数据集上进行了微调。
Vicuna 的表现大约达到 ChatGPT 的 90%。它是 FastChat 的一部分,FastChat 是一个允许用户训练、部署与评估聊天机器人的开放平台,提供构建自定义聊天机器人模型所需的全部组件与工具。
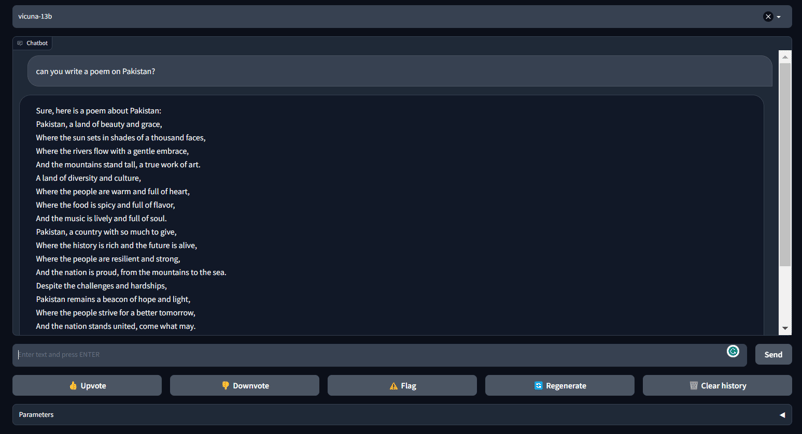
图片来源:FastChat (lmsys.org)
4. GPT4ALL
GPT4ALL 是 Nomic AI 团队开发的聊天机器人,基于大量精心整理的助理交互数据(如应用题、代码、故事、描述与多轮对话)。模型架构基于 LLaMa,并利用低时延的机器学习加速器在 CPU 上实现更快推理。
使用 GPT4ALL,您将获得 Python 客户端、GPU 与 CPU 推理、Typescript 绑定、聊天界面以及 Langchain 后端。
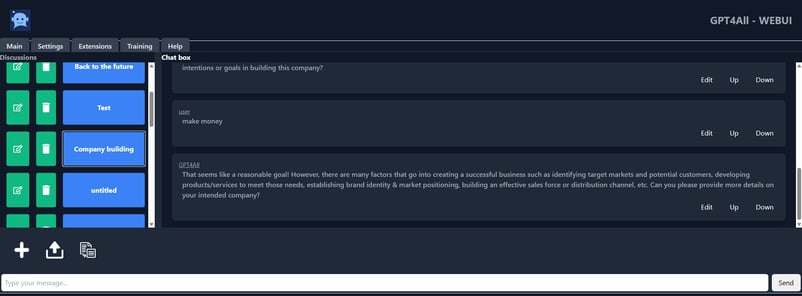
图片来源:gpt4all-ui
5. Raven RWKV
Raven RWKV 属于 ChatRWKV 项目,它是一个类似 ChatGPT 的开源模型,但由 RWKV(100% RNN)语言模型驱动,而非基于 Transformer。
通过采用 RNN,该模型在质量与可扩展性方面可与 Transformer 比肩,同时具备更快的处理速度与更省 VRAM 的优势。Raven 经指令微调,并在 Stanford Alpaca、code-alpaca 等数据集上进行了训练。
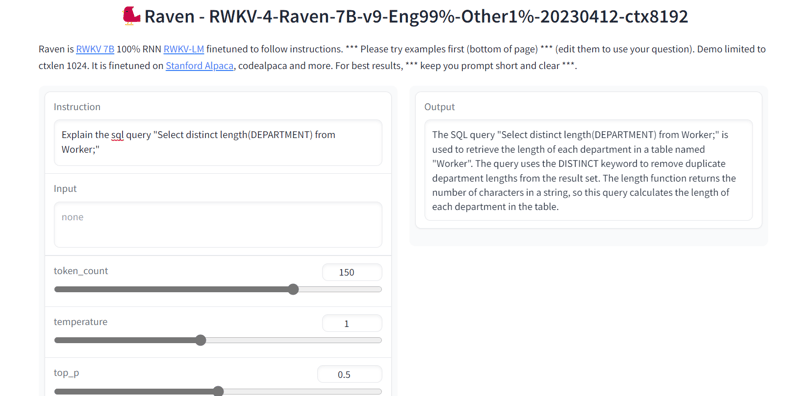
图片来源:Raven RWKV 7B
6. OpenChatKit
OpenChatKit 是一个完整的工具包,为开发聊天机器人应用提供 ChatGPT 的开源替代方案。
该工具包包含训练您自己的指令微调大语言模型的分步指南、微调流程,以及用于动态更新机器人回复的可扩展检索系统。同时还包含可帮助过滤不当提问的内容管理功能。
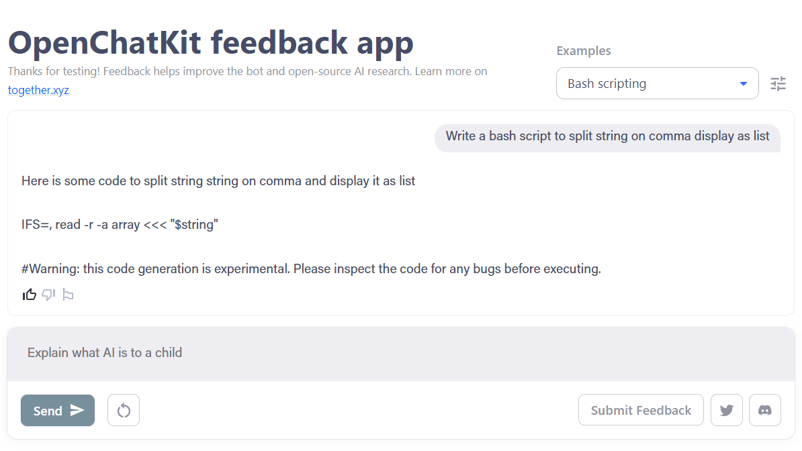
图片来源:OpenChatKit
7. OPT
OPT(Open Pre-trained Transformer)语言模型虽未达到 ChatGPT 的质量,但在零样本与小样本学习以及刻板偏见分析方面展现了出色能力。
OPT 是一系列大语言模型,参数规模从 125M 到 175B 不等。模型为仅解码式 Transformer,意味着其以自回归方式从左至右生成文本。
图片来源:A Watermark for LLMs
8. Flan-T5-XXL
Flan-T5-XXL 是在大量以“指令”形式呈现的数据集上微调的 T5 模型。这类微调显著提升了多个模型家族(如 PaLM、T5、U-PaLM)的表现。此外,Flan-T5-XXL 在 1000+ 个额外任务上进行了指令微调,覆盖多种语言。
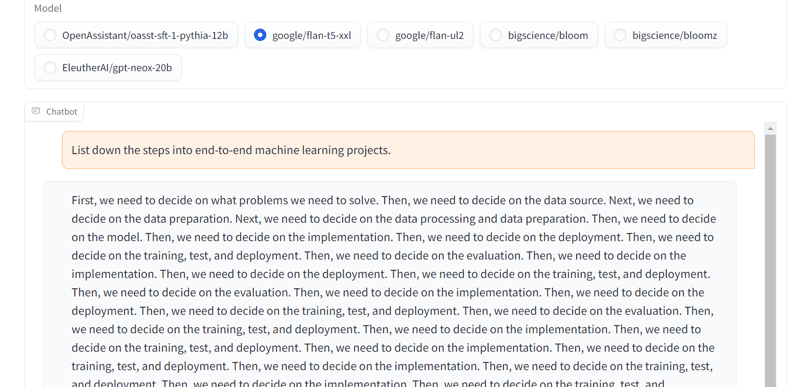
图片来源:Chat Llm Streaming
9. Baize
Baize 在多轮对话方面表现出色,得益于其用于降低潜在风险的防护措施。这一成绩源自高质量的多轮聊天语料库,该语料通过让 ChatGPT 与自身对话而构建。
Baize 的源码、模型与数据集以非商业(科研目的)许可发布。
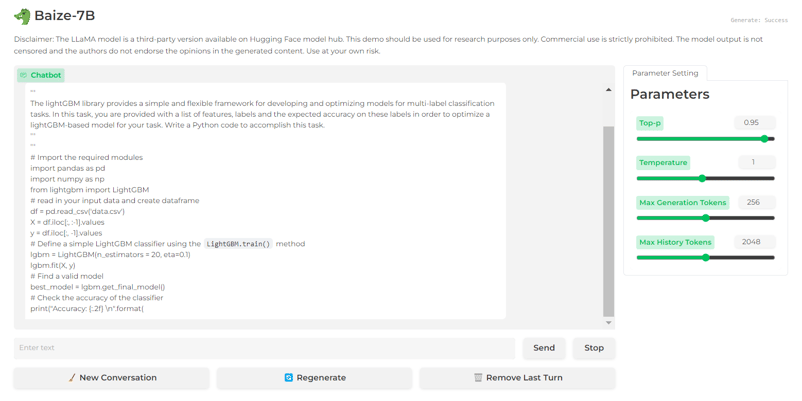 图片来源:Baize 7B
10. Koala
Koala 是在从网络抓取的对话数据集上对 LLaMa 进行微调而得到的聊天机器人。在许多场景中,Koala 的表现优于 Alpaca,并与 ChatGPT 相近。
Koala 提供训练代码、公开权重与对话微调器,并由 100 位人类参与评估。
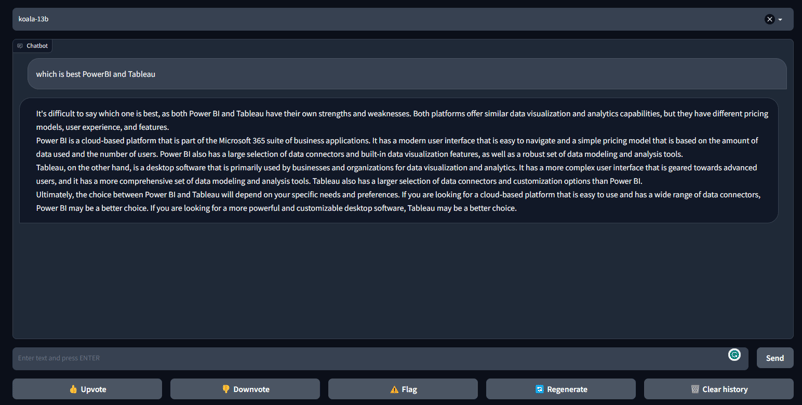
图片来源:FastChat/Koala
11. Dolly
Dolly 是 Databricks 团队训练的大语言模型,旨在证明我们可以使用旧的开源语言模型赋予其类似 ChatGPT 的指令跟随能力。模型训练在一台机器上用高质量训练数据即可在 30 分钟内完成。即便不是超大模型也能获得高质量表现。团队使用的是 60 亿参数的模型,而 GPT-3 为 1750 亿。
查看 Dolly 2.0,这是一款可商业使用的指令跟随语言模型。
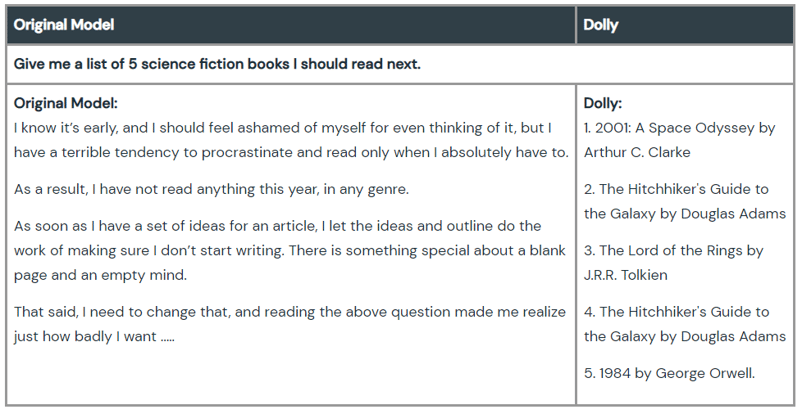
图片来源:Hello Dolly
12. Open Assistant
Open Assistant 是一个真正开源的项目,旨在让每个人都能访问顶级的基于聊天的大语言模型。其目标是推动语言领域的创新,使人们能够与第三方系统交互、动态检索信息,并用语言创建新应用。
您可以在一张高端消费级 GPU 上运行这个大语言模型聊天机器人,其代码、模型与数据均采用开源许可。
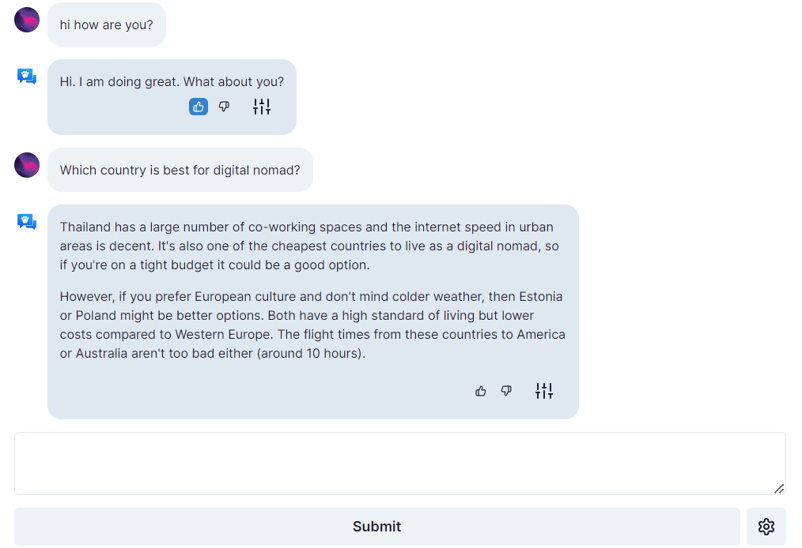
图片来源:open-assistant.io
GPT-4 替代方案:对比概览
下面这张对比表回顾了我们至今涵盖的要点:
| 模型名称 | 关键特性 | 优势 | 许可 |
| ColossalChat | 完整 RLHF 流水线、双语数据集、4 位量化推理 | 更快、更低成本的聊天机器人定制 | 开源 |
| Alpaca-LoRA | 低秩适配,可在树莓派 4 上运行 | 在受限硬件上实现高质量 Instruct 模型 | 开源 |
| Vicuna | 在 ShareGPT.com 对话数据集上微调 | 接近 ChatGPT 90% 的性能,属于 FastChat 平台的一部分 | 开源 |
| GPT4ALL | LLaMa 架构、低时延加速器 | CPU 上快速推理、多轮对话 | 开源 |
| Raven RWKV | 基于 RNN 的语言模型(非 Transformer) | 处理更快,更省 VRAM | 开源 |
| OpenChatKit | 指令微调 LLM、微调流程、内容管理功能 | 聊天机器人开发的完整工具包 | 开源 |
| OPT | 仅解码式 Transformer,多种参数规模 | 零样本与小样本学习、刻板偏见分析 |
|
| Flan-T5-XXL | 在 1000+ 任务上进行指令微调,支持多语言 | 在多类模型上提升表现 | 开源 |
| Baize | 多轮对话、风险缓解防护 | 高质量聊天语料 |
|
| Koala | 在对话数据集上微调的 LLaMa | 表现优于 Alpaca,许多场景与 ChatGPT 相近 | 开源 |
| Dolly | 在单机 30 分钟内完成训练的指令跟随 LLM | 以更小模型展现 ChatGPT 式能力 | 开源 |
| Open Assistant | 单张消费级 GPU 可运行的大语言模型聊天机器人 | 真正开源,支持动态信息检索 | 开源 |
重要考量
尽管这些开源替代方案带来诸多可能性,但与 GPT-4 相比仍存在一些局限。
- 性能差距:尽管部分模型已接近 GPT-4 的能力,但尚无模型能在所有任务上完全复现其表现。
- 资源约束:某些模型在训练与微调时可能需要大量计算资源。
- 社区驱动:开源项目依赖社区贡献,质量与支持水平可能参差不齐。
结语
这些 GPT-4 替代方案可帮助研究人员、开发者与中小企业打造自有的语言技术,与行业巨头竞争。虽然当前这些模型的性能尚不及 GPT-4,但随着时间推移与社区贡献的积累,其中一些有望后来居上。
如果您刚接触 ChatGPT,建议先学习我们的 Introduction to ChatGPT 课程;若您已了解生成式 AI,可通过查阅详尽的 ChatGPT Cheat Sheet for Data Science 提升提示技巧,或参考下方资源。


GPT-4 是 OpenAI 开发的最先进生成式 AI,正在改变我们的工作方式。然而,GPT-4 并非开源,这意味着我们无法访问其代码、模型架构、数据或模型权重来复现结果,因此也无法自行打造一个像 GPT-4 一样的聊天机器人。
为平衡这种局面,开源 LLM 社区开始着手打造 GPT-4 的替代方案,这些方案在性能与功能上接近,同时所需计算资源更少。
您可以通过查阅 What is GPT-4 and Why Does it Matter? 了解 GPT-1、GPT-2、GPT-3 与 GPT-4,或学习如何将 ChatGPT 应用于数据科学项目,并掌握提示工程,以更好地构建端到端的数据科学项目。
本文将介绍 12 个 GPT-4 替代方案,并附上简要说明及相关论文、博文、聊天机器人演示、源码与模型卡的链接。
注意:其中一些模型采用非商业许可,仅限科研与学术用途。在使用前请务必了解这些限制。
1. ColossalChat
ColossalChat 是一个开源项目,提供完整的 RLHF(基于人类反馈的强化学习)流水线,允许您克隆 AI 模型。
该项目完全开源,包含双语数据集、训练代码、演示以及 4 位量化推理。所有组件都将帮助您更快更省成本地创建定制聊天机器人。
图片来源:ColossalChat
2. Alpaca-LoRA
Alpaca-LoRA 基于 Stanford Alpaca 与 低秩适配(LoRA) 训练而成。借助低秩适配,我们可以在仅有 4GB 内存的树莓派 4 上运行与 GPT-3.5 质量相近的 Instruct 模型。
该项目提供源码、微调示例、推理代码、模型权重、数据集与演示。更棒的是,我们可以在单张 RTX 4090 上用几小时完成训练。
图片来源:Alpaca-LoRA
3. Vicuna
Vicuna 可为聊天机器人生成连贯且有创意的文本。它基于 Transformer 架构,并在来自 ShareGPT.com 的对话数据集上进行了微调。
Vicuna 的表现大约达到 ChatGPT 的 90%。它是 FastChat 的一部分,FastChat 是一个允许用户训练、部署与评估聊天机器人的开放平台,提供构建自定义聊天机器人模型所需的全部组件与工具。
图片来源:FastChat (lmsys.org)
4. GPT4ALL
GPT4ALL 是 Nomic AI 团队开发的聊天机器人,基于大量精心整理的助理交互数据(如应用题、代码、故事、描述与多轮对话)。模型架构基于 LLaMa,并利用低时延的机器学习加速器在 CPU 上实现更快推理。
使用 GPT4ALL,您将获得 Python 客户端、GPU 与 CPU 推理、Typescript 绑定、聊天界面以及 Langchain 后端。
图片来源:gpt4all-ui
5. Raven RWKV
Raven RWKV 属于 ChatRWKV 项目,它是一个类似 ChatGPT 的开源模型,但由 RWKV(100% RNN)语言模型驱动,而非基于 Transformer。
通过采用 RNN,该模型在质量与可扩展性方面可与 Transformer 比肩,同时具备更快的处理速度与更省 VRAM 的优势。Raven 经指令微调,并在 Stanford Alpaca、code-alpaca 等数据集上进行了训练。
图片来源:Raven RWKV 7B
6. OpenChatKit
OpenChatKit 是一个完整的工具包,为开发聊天机器人应用提供 ChatGPT 的开源替代方案。
该工具包包含训练您自己的指令微调大语言模型的分步指南、微调流程,以及用于动态更新机器人回复的可扩展检索系统。同时还包含可帮助过滤不当提问的内容管理功能。
图片来源:OpenChatKit
7. OPT
OPT(Open Pre-trained Transformer)语言模型虽未达到 ChatGPT 的质量,但在零样本与小样本学习以及刻板偏见分析方面展现了出色能力。
OPT 是一系列大语言模型,参数规模从 125M 到 175B 不等。模型为仅解码式 Transformer,意味着其以自回归方式从左至右生成文本。
图片来源:A Watermark for LLMs
8. Flan-T5-XXL
Flan-T5-XXL 是在大量以“指令”形式呈现的数据集上微调的 T5 模型。这类微调显著提升了多个模型家族(如 PaLM、T5、U-PaLM)的表现。此外,Flan-T5-XXL 在 1000+ 个额外任务上进行了指令微调,覆盖多种语言。
图片来源:Chat Llm Streaming
9. Baize
Baize 在多轮对话方面表现出色,得益于其用于降低潜在风险的防护措施。这一成绩源自高质量的多轮聊天语料库,该语料通过让 ChatGPT 与自身对话而构建。
Baize 的源码、模型与数据集以非商业(科研目的)许可发布。
10. Koala
Koala 是在从网络抓取的对话数据集上对 LLaMa 进行微调而得到的聊天机器人。在许多场景中,Koala 的表现优于 Alpaca,并与 ChatGPT 相近。
Koala 提供训练代码、公开权重与对话微调器,并由 100 位人类参与评估。
图片来源:FastChat/Koala
11. Dolly
Dolly 是 Databricks 团队训练的大语言模型,旨在证明我们可以使用旧的开源语言模型赋予其类似 ChatGPT 的指令跟随能力。模型训练在一台机器上用高质量训练数据即可在 30 分钟内完成。即便不是超大模型也能获得高质量表现。团队使用的是 60 亿参数的模型,而 GPT-3 为 1750 亿。
查看 Dolly 2.0,这是一款可商业使用的指令跟随语言模型。
图片来源:Hello Dolly
12. Open Assistant
Open Assistant 是一个真正开源的项目,旨在让每个人都能访问顶级的基于聊天的大语言模型。其目标是推动语言领域的创新,使人们能够与第三方系统交互、动态检索信息,并用语言创建新应用。
您可以在一张高端消费级 GPU 上运行这个大语言模型聊天机器人,其代码、模型与数据均采用开源许可。
图片来源:open-assistant.io
GPT-4 替代方案:对比概览
下面这张对比表回顾了我们至今涵盖的要点:
重要考量
尽管这些开源替代方案带来诸多可能性,但与 GPT-4 相比仍存在一些局限。
结语
这些 GPT-4 替代方案可帮助研究人员、开发者与中小企业打造自有的语言技术,与行业巨头竞争。虽然当前这些模型的性能尚不及 GPT-4,但随着时间推移与社区贡献的积累,其中一些有望后来居上。
如果您刚接触 ChatGPT,建议先学习我们的 Introduction to ChatGPT 课程;若您已了解生成式 AI,可通过查阅详尽的 ChatGPT Cheat Sheet for Data Science 提升提示技巧,或参考下方资源。