GPT-4 OpenAI द्वारा विकसित अब तक का सबसे उन्नत जेनेरेटिव एआई है। यह हमारे काम करने के तरीके का परिदृश्य बदल रहा है। हालांकि, GPT-4 ओपन-सोर्स नहीं है, यानी हमारे पास परिणामों को पुनरुत्पादित करने के लिए कोड, मॉडल आर्किटेक्चर, डेटा, या मॉडल वेट्स तक पहुंच नहीं है। हम अपना GPT-4 जैसा चैटबॉट नहीं बना सकते।
संतुलन बनाने के लिए, ओपन-सोर्स LLM समुदायों ने GPT-4 के ऐसे विकल्पों पर काम शुरू किया है जो लगभग समान प्रदर्शन और कार्यक्षमता प्रदान करते हैं और कम कम्प्यूटेशनल संसाधनों की जरूरत होती है।
आप GPT-1, GPT-2, GPT-3, और GPT-4 के बारे में यहां पढ़ सकते हैं: GPT-4 क्या है और यह क्यों अहम है?, या आप डेटा साइंस प्रोजेक्ट्स के लिए ChatGPT का उपयोग करना सीख सकते हैं और प्रॉम्प्ट इंजीनियरिंग में महारत हासिल कर एंड-टू-एंड डेटा साइंस प्रोजेक्ट बनाने में बेहतर हो सकते हैं।
इस लेख में, हम 12 GPT-4 विकल्पों का परिचय देंगे, साथ में संक्षिप्त विवरण और संबंधित शोध पत्र, ब्लॉग पोस्ट, चैटबॉट डेमो, कोड सोर्स, और मॉडल कार्ड के लिंक प्रदान करेंगे।
नोट: उल्लिखित कुछ मॉडलों में नॉन-कमर्शियल लाइसेंस है, जो उनके उपयोग को केवल अनुसंधान और शैक्षणिक उद्देश्यों तक सीमित करता है। इन्हें इस्तेमाल करने से पहले आपको इन सीमाओं को समझना होगा।
1. ColossalChat
ColossalChat एक ओपन-सोर्स प्रोजेक्ट है जो आपको संपूर्ण RLHF (Reinforcement Learning from Human Feedback) पाइपलाइन का उपयोग करके एआई मॉडल क्लोन करने देता है।
यह पूरी तरह ओपन-सोर्स प्रोजेक्ट है, जिसमें द्विभाषी डेटासेट, ट्रेनिंग कोड, डेमो, और 4-बिट क्वांटाइज़्ड इन्फरेंस शामिल हैं। ये सभी घटक आपको कम लागत और तेज गति से एक कस्टमाइज़्ड चैटबॉट बनाने में मदद करेंगे।
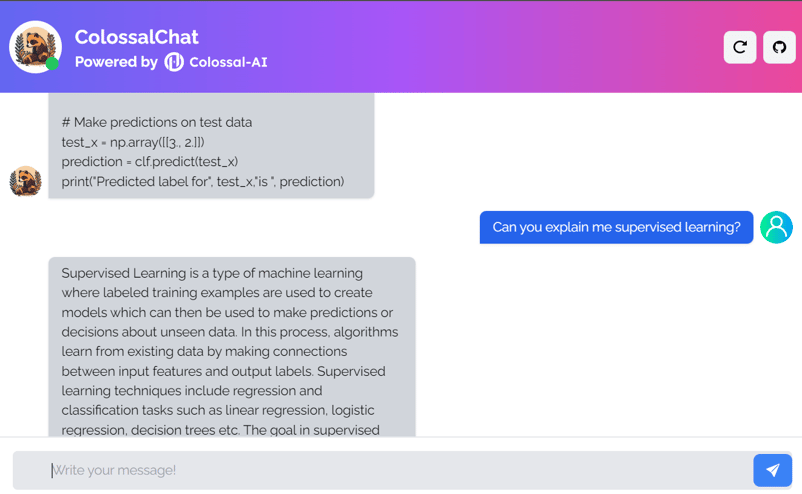
ColossalChat से छवि
2. Alpaca-LoRA
Alpaca-LoRA एक मॉडल है जिसे Stanford Alpaca और लो-रैंक अडैप्टेशन (LoRA) का उपयोग करके बनाया गया है। लो-रैंक अडॉप्शन हमें 4GB RAM वाले Raspberry Pi 4 पर GPT-3.5 की गुणवत्ता जैसे Instruct मॉडल चलाने की अनुमति देता है।
प्रोजेक्ट सोर्स कोड, फाइन-ट्यूनिंग उदाहरण, इन्फरेंस कोड, मॉडल वेट्स, डेटासेट और डेमो प्रदान करता है। सबसे अच्छी बात यह है कि हम अपना मॉडल एकल RTX 4090 पर कुछ घंटों के भीतर ट्रेन कर सकते हैं।
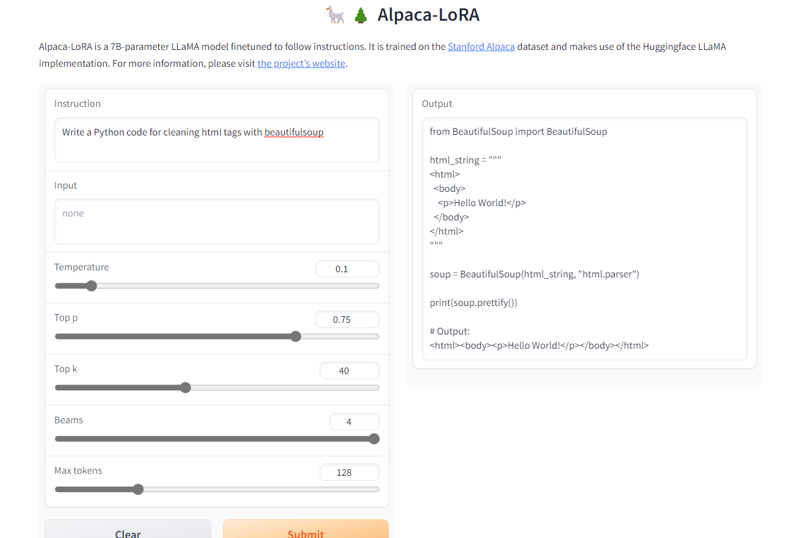
Alpaca-LoRA से छवि
3. Vicuna
Vicuna चैटबॉट्स के लिए सुसंगत और रचनात्मक पाठ जनरेट कर सकता है। यह एक ट्रांसफॉर्मर-आधारित आर्किटेक्चर है जिसे ShareGPT.com से एकत्रित संवादात्मक डेटासेट पर फाइन-ट्यून किया गया था।
Vicuna लगभग 90% ChatGPT प्रदर्शन प्रदान करता है। यह FastChat का हिस्सा है, जो एक ओपन प्लेटफॉर्म है जो उपयोगकर्ताओं को अपने चैटबॉट्स को ट्रेन, सर्व और इवैल्यूएट करने की अनुमति देता है। FastChat कस्टम चैटबॉट मॉडल बनाने के लिए सभी आवश्यक घटक और टूल प्रदान करता है।
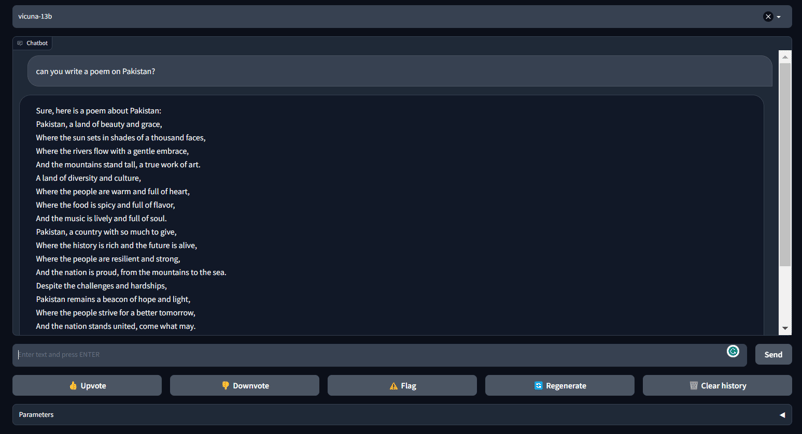
छवि स्रोत: FastChat (lmsys.org)
4. GPT4ALL
GPT4ALL एक चैटबॉट है जिसे Nomic AI टीम ने सहायक इंटरैक्शन के बड़े क्यूरेटेड डेटा, जैसे शब्द-समस्याएं, कोड, कहानियां, वर्णन, और मल्टी-टर्न डायलॉग पर विकसित किया है। मॉडल आर्किटेक्चर LLaMa पर आधारित है, और यह CPU पर तेज इन्फरेंस के लिए लो-लेटेंसी मशीन-लर्निंग एक्सीलरेटर का उपयोग करता है।
GPT4ALL के साथ, आपको Python क्लाइंट, GPU और CPU इन्फरेंस, TypeScript बाइंडिंग्स, एक चैट इंटरफेस, और Langchain बैकएंड मिलता है।
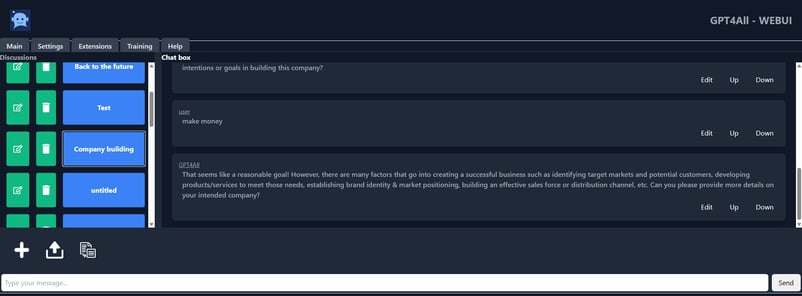
gpt4all-ui से छवि
5. Raven RWKV
Raven RWKV ChatRWKV का हिस्सा है, जो ChatGPT जैसा ओपन-सोर्स मॉडल है, लेकिन यह ट्रांसफॉर्मर पर आधारित नहीं बल्कि RWKV (100% RNN) भाषा मॉडल द्वारा संचालित है।
RNNs का उपयोग करके, मॉडल ट्रांसफॉर्मर्स के समान गुणवत्ता और स्केलेबिलिटी स्तर प्राप्त करता है, साथ ही तेज प्रोसेसिंग स्पीड और VRAM की बचत के फायदे भी देता है। Raven को निर्देशों का पालन करने के लिए फाइन-ट्यून किया गया था, और इसे Stanford Alpaca, code-alpaca, और अन्य डेटासेट्स पर फाइन-ट्यून किया गया।
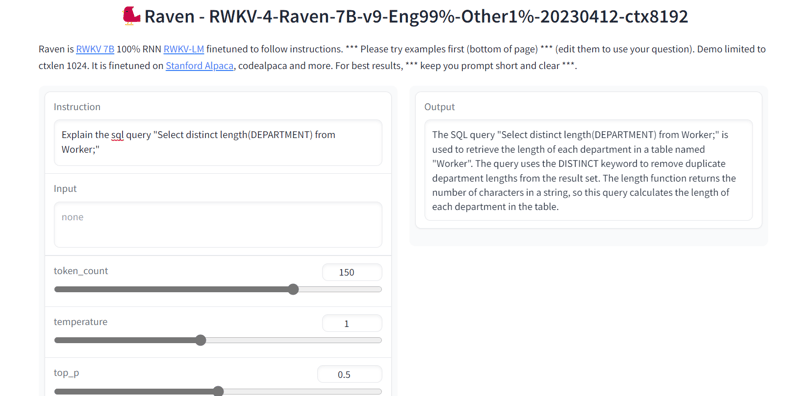
Raven RWKV 7B से छवि
6. OpenChatKit
OpenChatKit एक व्यापक टूलकिट है जो चैटबॉट एप्लिकेशन विकसित करने के लिए ChatGPT का ओपन-सोर्स विकल्प प्रदान करता है।
टूलकिट में अपना स्वयं का इंस्ट्रक्शन-ट्यून किया हुआ बड़ा भाषा मॉडल ट्रेन करने, मॉडल को फाइन-ट्यून करने, और बॉट की प्रतिक्रियाओं को अपडेट करने के लिए एक एक्स्टेंसिबल रिट्रीवल सिस्टम के चरण-दर-चरण निर्देश शामिल हैं। इसके अलावा, इसमें मॉडरेशन फीचर्स भी शामिल हैं जो अनुचित प्रश्नों को फ़िल्टर करने में मदद कर सकते हैं।
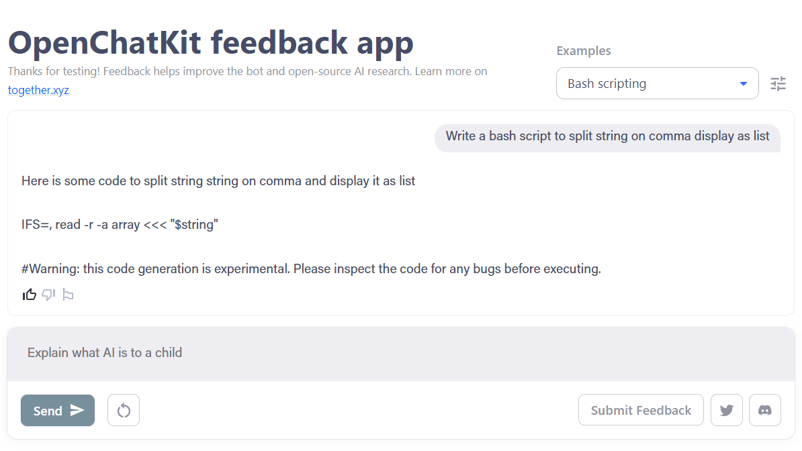
OpenChatKit से छवि
7. OPT
OPT (Open Pre-trained Transformer) भाषा मॉडलों ने, भले ही वे ChatGPT की गुणवत्ता तक नहीं पहुंचते, फिर भी जीरो-शॉट और फ्यू-शॉट लर्निंग के साथ-साथ स्टिरियोटाइपिकल बायस विश्लेषण में उल्लेखनीय क्षमताएं प्रदर्शित की हैं।
OPT बड़े भाषा मॉडलों का एक परिवार है, जिसमें 125M से 175B पैरामीटर्स तक के मॉडल शामिल हैं। मॉडल डिकोडर-ओनली ट्रांसफॉर्मर्स हैं, यानी वे बाएं से दाएं ऑटोरिग्रेसिव तरीके से टेक्स्ट जनरेट करते हैं।
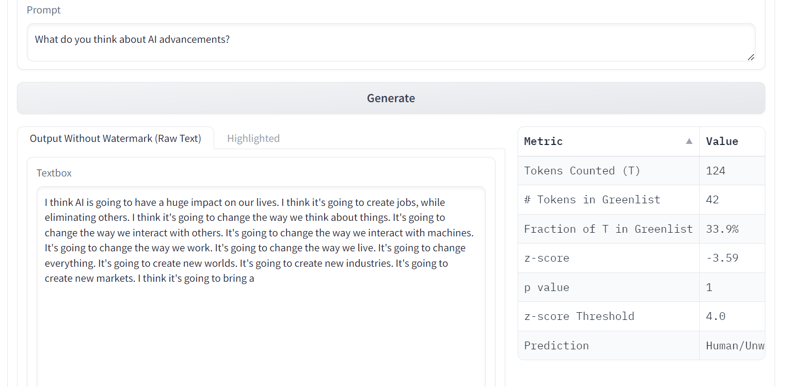
A Watermark for LLMs से छवि
8. Flan-T5-XXL
Flan-T5-XXL वे फाइन-ट्यून किए गए T5 मॉडल हैं जिन्हें निर्देशों के रूप में प्रस्तुत विशाल डेटासेट्स पर प्रशिक्षित किया गया है। इस प्रकार की फाइन-ट्यूनिंग ने PaLM, T5 और U-PaLM जैसे विभिन्न मॉडल वर्गों पर प्रदर्शन में उल्लेखनीय सुधार किया है। इसके अलावा, Flan-T5-XXL मॉडल को 1000 से अधिक अतिरिक्त कार्यों पर, जो कई भाषाओं को कवर करते हैं, फाइन-ट्यून किया गया।
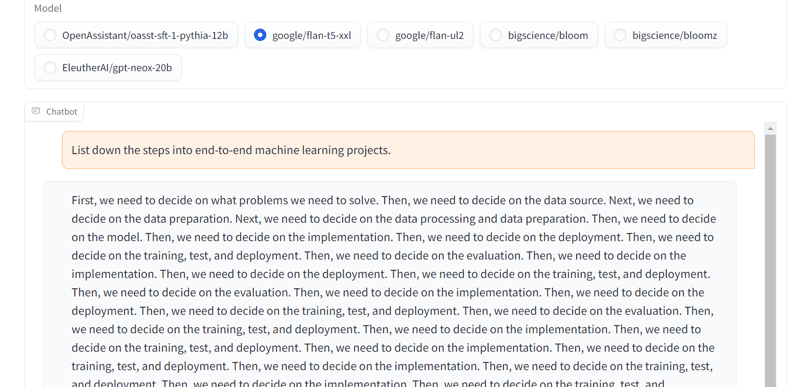
Chat Llm Streaming से छवि
9. Baize
Baize अपने गार्डरेल्स की बदौलत मल्टी-टर्न डायलॉग्स में प्रभावशाली प्रदर्शन दिखाता है, जो संभावित जोखिमों को कम करने में मदद करते हैं। इसने यह उपलब्धि उच्च-गुणवत्ता वाले मल्टी-टर्न चैट कॉर्पस के माध्यम से हासिल की, जिसे ChatGPT का खुद से संवाद करवाकर तैयार किया गया।
Baize का कोड सोर्स, मॉडल, और डेटासेट नॉन-कमर्शियल (केवल अनुसंधान प्रयोजन) लाइसेंस के तहत जारी किए गए हैं।
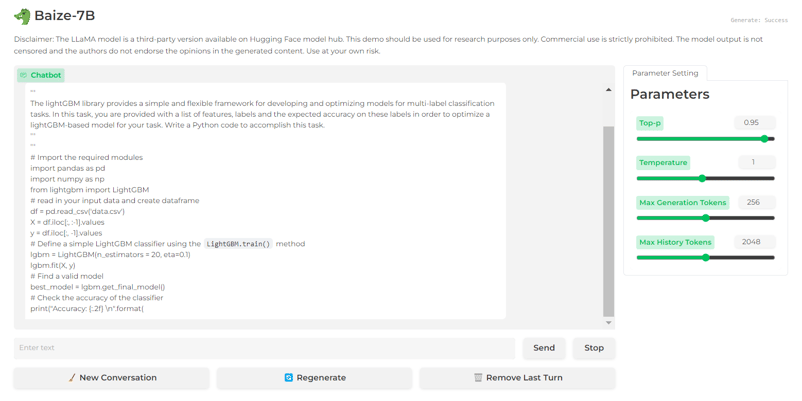 छवि स्रोत: Baize 7B
10. Koala
Koala एक चैटबॉट है जिसे वेब से स्क्रैप किए गए डायलॉग डेटासेट पर LLaMa को फाइन-ट्यून करके प्रशिक्षित किया गया है। Koala ने Alpaca से बेहतर प्रदर्शन किया है और कई मामलों में ChatGPT के समान है।
Koala ट्रेनिंग कोड, पब्लिक वेट्स, और डायलॉग फाइन-ट्यूनर प्रदान करता है, और इसका 100 मनुष्यों द्वारा मूल्यांकन किया गया।
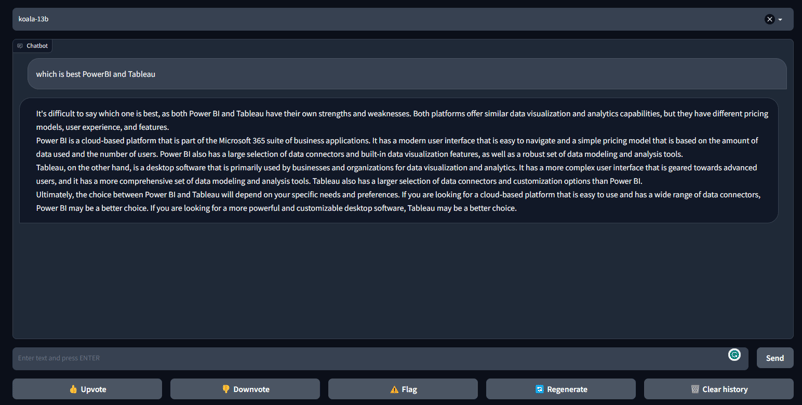
FastChat/Koala से छवि
11. Dolly
Dolly एक बड़ा भाषा मॉडल है जिसे Databricks मशीन ने इस बात को प्रदर्शित करने के लिए प्रशिक्षित किया कि हम पुराने ओपन-सोर्स भाषा मॉडलों का उपयोग कर सकते हैं और उन्हें ChatGPT जैसी निर्देश-अनुसरण क्षमता दे सकते हैं। उच्च-गुणवत्ता वाले ट्रेनिंग डेटा का उपयोग करते हुए, मॉडल ट्रेनिंग के लिए एक मशीन पर 30 मिनट लगते हैं। उच्च गुणवत्ता हासिल करने के लिए आपको बड़े मॉडलों की भी आवश्यकता नहीं है। टीम ने 6 बिलियन पैरामीटर्स वाले मॉडल का उपयोग किया, जबकि GPT-3 के लिए 175 बिलियन हैं।
Dolly 2.0 देखें, एक निर्देश-अनुसरण करने वाला भाषा मॉडल जिसे व्यावसायिक रूप से उपयोग किया जा सकता है।
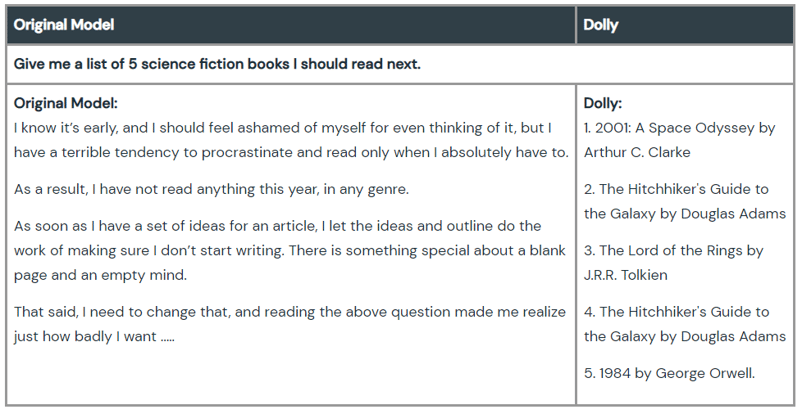
Hello Dolly से छवि
12. Open Assistant
Open Assistant एक सच्चा ओपन-सोर्स प्रोजेक्ट है, जिसका अर्थ है कि हर किसी को शीर्ष चैट-आधारित बड़े भाषा मॉडलों तक पहुंच देना। इसका उद्देश्य लोगों को थर्ड-पार्टी सिस्टम्स के साथ इंटरैक्ट करने, डायनेमिक रूप से जानकारी प्राप्त करने, और भाषा का उपयोग करके नए एप्लिकेशन बनाने में सक्षम बनाकर भाषा में नवाचार की क्रांति लाना है।
आप एक हाई-एंड कंज्यूमर GPU पर बड़े भाषा चैटबॉट को चला सकते हैं, और इसका कोड, मॉडल, और डेटा ओपन-सोर्स लाइसेंस के तहत लाइसेंस प्राप्त हैं।
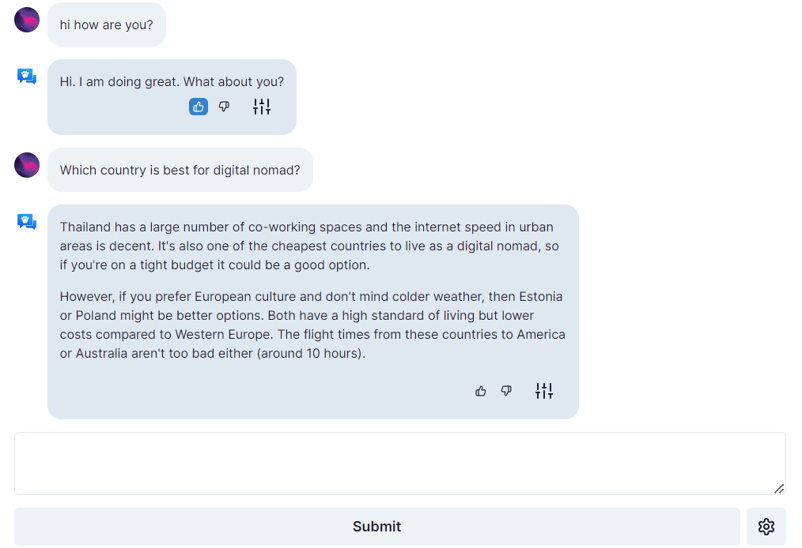
छवि स्रोत: open-assistant.io
GPT-4 के विकल्प: एक तुलनात्मक दृष्टिकोण
आइए इस तुलनात्मक तालिका में अब तक कवर की गई बातों की समीक्षा करें:
| मॉडल नाम | मुख्य विशेषताएं | फायदे | लाइसेंसिंग |
| ColossalChat | पूर्ण RLHF पाइपलाइन, द्विभाषी डेटासेट, 4-बिट क्वांटाइज़्ड इन्फरेंस | तेज़, किफायती चैटबॉट कस्टमाइज़ेशन | ओपन-सोर्स |
| Alpaca-LoRA | लो-रैंक अडैप्टेशन, Raspberry Pi 4 पर चलता है | सीमित हार्डवेयर पर उच्च-गुणवत्ता वाला Instruct मॉडल | ओपन-सोर्स |
| Vicuna | ShareGPT.com के संवादात्मक डेटासेट पर फाइन-ट्यून | ChatGPT के प्रदर्शन का लगभग 90%, FastChat प्लेटफॉर्म का हिस्सा | ओपन-सोर्स |
| GPT4ALL | LLaMa आर्किटेक्चर, लो-लेटेंसी एक्सीलरेटर्स | CPU पर तेज इन्फरेंस, मल्टी-टर्न डायलॉग | ओपन-सोर्स |
| Raven RWKV | RNN-आधारित भाषा मॉडल (ट्रांसफॉर्मर नहीं) | तेज़ प्रोसेसिंग, VRAM की बचत | ओपन-सोर्स |
| OpenChatKit | इंस्ट्रक्शन-ट्यून किया गया LLM, फाइन-ट्यूनिंग, मॉडरेशन फीचर्स | चैटबॉट डेवलपमेंट के लिए व्यापक टूलकिट | ओपन-सोर्स |
| OPT | डिकोडर-ओनली ट्रांसफॉर्मर्स, विभिन्न पैरामीटर साइज़ | जीरो-शॉट और फ्यू-शॉट लर्निंग, स्टिरियोटाइपिकल बायस विश्लेषण |
नॉन-कमर्शियल लाइसेंस (केवल अनुसंधान और शैक्षणिक)
|
| Flan-T5-XXL | 1000+ कार्यों पर इंस्ट्रक्शन-फाइन-ट्यून, बहुभाषी | विभिन्न मॉडल वर्गों में बेहतर प्रदर्शन | ओपन-सोर्स |
| Baize | मल्टी-टर्न डायलॉग, जोखिम शमन के लिए गार्डरेल्स | उच्च-गुणवत्ता वाला चैट कॉर्पस |
नॉन-कमर्शियल लाइसेंस (केवल अनुसंधान और शैक्षणिक)
|
| Koala | डायलॉग डेटासेट पर फाइन-ट्यून किया गया LLaMa | प्रदर्शन Alpaca से बेहतर, कई मामलों में ChatGPT के समान | ओपन-सोर्स |
| Dolly | एक मशीन पर 30 मिनट में प्रशिक्षित निर्देश-अनुसरण LLM | छोटे मॉडलों के साथ ChatGPT जैसी क्षमताएं प्रदर्शित करता है | ओपन-सोर्स |
| Open Assistant | एकल कंज्यूमर GPU पर बड़ा भाषा चैटबॉट | वास्तव में ओपन-सोर्स, डायनेमिक सूचना रिट्रीवल | ओपन-सोर्स |
महत्वपूर्ण विचार
हालांकि ये ओपन-सोर्स विकल्प रोमांचक संभावनाएं पेश करते हैं, GPT-4 की तुलना में उनकी सीमाओं से अवगत रहना महत्वपूर्ण है।
- प्रदर्शन अंतर: कुछ मॉडल GPT-4 की क्षमताओं के करीब पहुंचते हैं, लेकिन किसी ने भी सभी कार्यों में उसके प्रदर्शन की पूरी तरह नकल नहीं की है।
- संसाधन बाधाएं: कुछ मॉडलों को ट्रेनिंग और फाइन-ट्यूनिंग के लिए पर्याप्त कम्प्यूटेशनल संसाधनों की आवश्यकता हो सकती है।
- समुदाय-चालित: ओपन-सोर्स प्रोजेक्ट्स समुदाय के योगदान पर निर्भर होते हैं, जिससे गुणवत्ता और समर्थन में भिन्नताएं हो सकती हैं।
निष्कर्ष
ये GPT-4 विकल्प शोधकर्ताओं, डेवलपर्स, और छोटी कंपनियों को अपनी भाषा-आधारित तकनीक बनाने और उद्योग के दिग्गजों से प्रतिस्पर्धा करने में मदद कर सकते हैं। मॉडलों का प्रदर्शन GPT-4 से ऊपर नहीं है, लेकिन समय और समुदाय के योगदान के साथ, कुछ में GPT-4 को पीछे छोड़ने की क्षमता हो सकती है।
यदि आप ChatGPT के लिए नए हैं, तो हमारा Introduction to ChatGPT कोर्स आज़माएं, और यदि आप जनरेटिव एआई से परिचित हैं, तो व्यापक ChatGPT Cheat Sheet for Data Science की समीक्षा करके या नीचे दिए गए संसाधनों को देखकर अपनी प्रॉम्प्टिंग बेहतर कर सकते हैं।


GPT-4 OpenAI द्वारा विकसित अब तक का सबसे उन्नत जेनेरेटिव एआई है। यह हमारे काम करने के तरीके का परिदृश्य बदल रहा है। हालांकि, GPT-4 ओपन-सोर्स नहीं है, यानी हमारे पास परिणामों को पुनरुत्पादित करने के लिए कोड, मॉडल आर्किटेक्चर, डेटा, या मॉडल वेट्स तक पहुंच नहीं है। हम अपना GPT-4 जैसा चैटबॉट नहीं बना सकते।
संतुलन बनाने के लिए, ओपन-सोर्स LLM समुदायों ने GPT-4 के ऐसे विकल्पों पर काम शुरू किया है जो लगभग समान प्रदर्शन और कार्यक्षमता प्रदान करते हैं और कम कम्प्यूटेशनल संसाधनों की जरूरत होती है।
आप GPT-1, GPT-2, GPT-3, और GPT-4 के बारे में यहां पढ़ सकते हैं: GPT-4 क्या है और यह क्यों अहम है?, या आप डेटा साइंस प्रोजेक्ट्स के लिए ChatGPT का उपयोग करना सीख सकते हैं और प्रॉम्प्ट इंजीनियरिंग में महारत हासिल कर एंड-टू-एंड डेटा साइंस प्रोजेक्ट बनाने में बेहतर हो सकते हैं।
इस लेख में, हम 12 GPT-4 विकल्पों का परिचय देंगे, साथ में संक्षिप्त विवरण और संबंधित शोध पत्र, ब्लॉग पोस्ट, चैटबॉट डेमो, कोड सोर्स, और मॉडल कार्ड के लिंक प्रदान करेंगे।
नोट: उल्लिखित कुछ मॉडलों में नॉन-कमर्शियल लाइसेंस है, जो उनके उपयोग को केवल अनुसंधान और शैक्षणिक उद्देश्यों तक सीमित करता है। इन्हें इस्तेमाल करने से पहले आपको इन सीमाओं को समझना होगा।
1. ColossalChat
ColossalChat एक ओपन-सोर्स प्रोजेक्ट है जो आपको संपूर्ण RLHF (Reinforcement Learning from Human Feedback) पाइपलाइन का उपयोग करके एआई मॉडल क्लोन करने देता है।
यह पूरी तरह ओपन-सोर्स प्रोजेक्ट है, जिसमें द्विभाषी डेटासेट, ट्रेनिंग कोड, डेमो, और 4-बिट क्वांटाइज़्ड इन्फरेंस शामिल हैं। ये सभी घटक आपको कम लागत और तेज गति से एक कस्टमाइज़्ड चैटबॉट बनाने में मदद करेंगे।
ColossalChat से छवि
2. Alpaca-LoRA
Alpaca-LoRA एक मॉडल है जिसे Stanford Alpaca और लो-रैंक अडैप्टेशन (LoRA) का उपयोग करके बनाया गया है। लो-रैंक अडॉप्शन हमें 4GB RAM वाले Raspberry Pi 4 पर GPT-3.5 की गुणवत्ता जैसे Instruct मॉडल चलाने की अनुमति देता है।
प्रोजेक्ट सोर्स कोड, फाइन-ट्यूनिंग उदाहरण, इन्फरेंस कोड, मॉडल वेट्स, डेटासेट और डेमो प्रदान करता है। सबसे अच्छी बात यह है कि हम अपना मॉडल एकल RTX 4090 पर कुछ घंटों के भीतर ट्रेन कर सकते हैं।
Alpaca-LoRA से छवि
3. Vicuna
Vicuna चैटबॉट्स के लिए सुसंगत और रचनात्मक पाठ जनरेट कर सकता है। यह एक ट्रांसफॉर्मर-आधारित आर्किटेक्चर है जिसे ShareGPT.com से एकत्रित संवादात्मक डेटासेट पर फाइन-ट्यून किया गया था।
Vicuna लगभग 90% ChatGPT प्रदर्शन प्रदान करता है। यह FastChat का हिस्सा है, जो एक ओपन प्लेटफॉर्म है जो उपयोगकर्ताओं को अपने चैटबॉट्स को ट्रेन, सर्व और इवैल्यूएट करने की अनुमति देता है। FastChat कस्टम चैटबॉट मॉडल बनाने के लिए सभी आवश्यक घटक और टूल प्रदान करता है।
छवि स्रोत: FastChat (lmsys.org)
4. GPT4ALL
GPT4ALL एक चैटबॉट है जिसे Nomic AI टीम ने सहायक इंटरैक्शन के बड़े क्यूरेटेड डेटा, जैसे शब्द-समस्याएं, कोड, कहानियां, वर्णन, और मल्टी-टर्न डायलॉग पर विकसित किया है। मॉडल आर्किटेक्चर LLaMa पर आधारित है, और यह CPU पर तेज इन्फरेंस के लिए लो-लेटेंसी मशीन-लर्निंग एक्सीलरेटर का उपयोग करता है।
GPT4ALL के साथ, आपको Python क्लाइंट, GPU और CPU इन्फरेंस, TypeScript बाइंडिंग्स, एक चैट इंटरफेस, और Langchain बैकएंड मिलता है।
gpt4all-ui से छवि
5. Raven RWKV
Raven RWKV ChatRWKV का हिस्सा है, जो ChatGPT जैसा ओपन-सोर्स मॉडल है, लेकिन यह ट्रांसफॉर्मर पर आधारित नहीं बल्कि RWKV (100% RNN) भाषा मॉडल द्वारा संचालित है।
RNNs का उपयोग करके, मॉडल ट्रांसफॉर्मर्स के समान गुणवत्ता और स्केलेबिलिटी स्तर प्राप्त करता है, साथ ही तेज प्रोसेसिंग स्पीड और VRAM की बचत के फायदे भी देता है। Raven को निर्देशों का पालन करने के लिए फाइन-ट्यून किया गया था, और इसे Stanford Alpaca, code-alpaca, और अन्य डेटासेट्स पर फाइन-ट्यून किया गया।
Raven RWKV 7B से छवि
6. OpenChatKit
OpenChatKit एक व्यापक टूलकिट है जो चैटबॉट एप्लिकेशन विकसित करने के लिए ChatGPT का ओपन-सोर्स विकल्प प्रदान करता है।
टूलकिट में अपना स्वयं का इंस्ट्रक्शन-ट्यून किया हुआ बड़ा भाषा मॉडल ट्रेन करने, मॉडल को फाइन-ट्यून करने, और बॉट की प्रतिक्रियाओं को अपडेट करने के लिए एक एक्स्टेंसिबल रिट्रीवल सिस्टम के चरण-दर-चरण निर्देश शामिल हैं। इसके अलावा, इसमें मॉडरेशन फीचर्स भी शामिल हैं जो अनुचित प्रश्नों को फ़िल्टर करने में मदद कर सकते हैं।
OpenChatKit से छवि
7. OPT
OPT (Open Pre-trained Transformer) भाषा मॉडलों ने, भले ही वे ChatGPT की गुणवत्ता तक नहीं पहुंचते, फिर भी जीरो-शॉट और फ्यू-शॉट लर्निंग के साथ-साथ स्टिरियोटाइपिकल बायस विश्लेषण में उल्लेखनीय क्षमताएं प्रदर्शित की हैं।
OPT बड़े भाषा मॉडलों का एक परिवार है, जिसमें 125M से 175B पैरामीटर्स तक के मॉडल शामिल हैं। मॉडल डिकोडर-ओनली ट्रांसफॉर्मर्स हैं, यानी वे बाएं से दाएं ऑटोरिग्रेसिव तरीके से टेक्स्ट जनरेट करते हैं।
A Watermark for LLMs से छवि
8. Flan-T5-XXL
Flan-T5-XXL वे फाइन-ट्यून किए गए T5 मॉडल हैं जिन्हें निर्देशों के रूप में प्रस्तुत विशाल डेटासेट्स पर प्रशिक्षित किया गया है। इस प्रकार की फाइन-ट्यूनिंग ने PaLM, T5 और U-PaLM जैसे विभिन्न मॉडल वर्गों पर प्रदर्शन में उल्लेखनीय सुधार किया है। इसके अलावा, Flan-T5-XXL मॉडल को 1000 से अधिक अतिरिक्त कार्यों पर, जो कई भाषाओं को कवर करते हैं, फाइन-ट्यून किया गया।
Chat Llm Streaming से छवि
9. Baize
Baize अपने गार्डरेल्स की बदौलत मल्टी-टर्न डायलॉग्स में प्रभावशाली प्रदर्शन दिखाता है, जो संभावित जोखिमों को कम करने में मदद करते हैं। इसने यह उपलब्धि उच्च-गुणवत्ता वाले मल्टी-टर्न चैट कॉर्पस के माध्यम से हासिल की, जिसे ChatGPT का खुद से संवाद करवाकर तैयार किया गया।
Baize का कोड सोर्स, मॉडल, और डेटासेट नॉन-कमर्शियल (केवल अनुसंधान प्रयोजन) लाइसेंस के तहत जारी किए गए हैं।
10. Koala
Koala एक चैटबॉट है जिसे वेब से स्क्रैप किए गए डायलॉग डेटासेट पर LLaMa को फाइन-ट्यून करके प्रशिक्षित किया गया है। Koala ने Alpaca से बेहतर प्रदर्शन किया है और कई मामलों में ChatGPT के समान है।
Koala ट्रेनिंग कोड, पब्लिक वेट्स, और डायलॉग फाइन-ट्यूनर प्रदान करता है, और इसका 100 मनुष्यों द्वारा मूल्यांकन किया गया।
FastChat/Koala से छवि
11. Dolly
Dolly एक बड़ा भाषा मॉडल है जिसे Databricks मशीन ने इस बात को प्रदर्शित करने के लिए प्रशिक्षित किया कि हम पुराने ओपन-सोर्स भाषा मॉडलों का उपयोग कर सकते हैं और उन्हें ChatGPT जैसी निर्देश-अनुसरण क्षमता दे सकते हैं। उच्च-गुणवत्ता वाले ट्रेनिंग डेटा का उपयोग करते हुए, मॉडल ट्रेनिंग के लिए एक मशीन पर 30 मिनट लगते हैं। उच्च गुणवत्ता हासिल करने के लिए आपको बड़े मॉडलों की भी आवश्यकता नहीं है। टीम ने 6 बिलियन पैरामीटर्स वाले मॉडल का उपयोग किया, जबकि GPT-3 के लिए 175 बिलियन हैं।
Dolly 2.0 देखें, एक निर्देश-अनुसरण करने वाला भाषा मॉडल जिसे व्यावसायिक रूप से उपयोग किया जा सकता है।
Hello Dolly से छवि
12. Open Assistant
Open Assistant एक सच्चा ओपन-सोर्स प्रोजेक्ट है, जिसका अर्थ है कि हर किसी को शीर्ष चैट-आधारित बड़े भाषा मॉडलों तक पहुंच देना। इसका उद्देश्य लोगों को थर्ड-पार्टी सिस्टम्स के साथ इंटरैक्ट करने, डायनेमिक रूप से जानकारी प्राप्त करने, और भाषा का उपयोग करके नए एप्लिकेशन बनाने में सक्षम बनाकर भाषा में नवाचार की क्रांति लाना है।
आप एक हाई-एंड कंज्यूमर GPU पर बड़े भाषा चैटबॉट को चला सकते हैं, और इसका कोड, मॉडल, और डेटा ओपन-सोर्स लाइसेंस के तहत लाइसेंस प्राप्त हैं।
छवि स्रोत: open-assistant.io
GPT-4 के विकल्प: एक तुलनात्मक दृष्टिकोण
आइए इस तुलनात्मक तालिका में अब तक कवर की गई बातों की समीक्षा करें:
महत्वपूर्ण विचार
हालांकि ये ओपन-सोर्स विकल्प रोमांचक संभावनाएं पेश करते हैं, GPT-4 की तुलना में उनकी सीमाओं से अवगत रहना महत्वपूर्ण है।
निष्कर्ष
ये GPT-4 विकल्प शोधकर्ताओं, डेवलपर्स, और छोटी कंपनियों को अपनी भाषा-आधारित तकनीक बनाने और उद्योग के दिग्गजों से प्रतिस्पर्धा करने में मदद कर सकते हैं। मॉडलों का प्रदर्शन GPT-4 से ऊपर नहीं है, लेकिन समय और समुदाय के योगदान के साथ, कुछ में GPT-4 को पीछे छोड़ने की क्षमता हो सकती है।
यदि आप ChatGPT के लिए नए हैं, तो हमारा Introduction to ChatGPT कोर्स आज़माएं, और यदि आप जनरेटिव एआई से परिचित हैं, तो व्यापक ChatGPT Cheat Sheet for Data Science की समीक्षा करके या नीचे दिए गए संसाधनों को देखकर अपनी प्रॉम्प्टिंग बेहतर कर सकते हैं।