Courses
理解 Prompt Engineering
1小时
232.4K
我们与技术互动的方式在不断演进。近年来最令人兴奋的进展之一来自人工智能(AI)领域——机器被训练得能够像人类一样思考、学习,甚至交流。在生成式 AI 等诸多方向中,有一门正在崭露头角的微妙技艺:提示工程。
想象一下,您与一台机器对话,给出一个线索或“提示(prompt)”,它随即返回相关的信息或动作。这就是提示工程的本质。它关乎如何精心设计合适的问题或指令,引导 AI 模型,尤其是大型语言模型(LLM),产出期望的结果。无论您是对前沿 AI 感兴趣的技术爱好者,还是希望利用语言模型力量的专业人士,理解提示工程都至关重要。
接下来本文将一边为您剖析提示工程的技术细节,一边放在更广阔的 AI 视角下看其重要性。若您想更深入探索 AI 与语言处理的世界,我们也附上了一系列资源,帮助您进一步学习。
从本质上说,提示工程有点像通过提问来教导孩子。正如表述恰当的问题能引导孩子的思考过程,一条设计精良的提示也能引导 AI 模型,尤其是大型语言模型(LLM),朝着特定输出前进。下面我们来更详细地探讨这一概念。
提示工程是指设计与打磨提示——问题或指令——以从 AI 模型中引发特定回应的实践。可以把它看作人类意图与机器输出之间的接口。
在基于海量数据训练模型的 AI 领域,恰当的提示常常决定模型能否正确理解您的请求,或是产生误解。
例如,如果您曾与 Siri 或 Alexa 等语音助手交互过,其实就已经在进行一种基础形式的提示工程。您提出请求的方式——“播放一些轻松的音乐”与“播放贝多芬的交响曲”——可能导致截然不同的结果。
提示工程虽根植于语言艺术,却与 AI 模型的技术细节密不可分。以下是更技术向的一面:
若您想进一步理解这些模型的内部机制,我们的《Transformers 与 Hugging Face 教程》提供了对主流 LLM 机理的深入讲解。
提示工程是确保人机高效沟通的桥梁。这不仅是为了得到正确答案,更是为了让 AI 理解每个问题背后的上下文、细微差别与意图。
提示工程虽然是近年的新兴学科,但其根源深植于更广阔的自然语言处理(NLP)与机器学习发展史。回顾其演进,有助于理解其当下的重要性。
NLP 的起源可追溯至 20 世纪中叶数字计算机诞生之时。早期 NLP 偏重基于规则的方法,依赖手工规则与简单算法。这类系统较为僵硬,难以应对人类语言的复杂性与微妙之处。
随着算力提升与数据集扩增,20 世纪末至 21 世纪初逐步转向统计方法。机器学习算法开始发挥关键作用,使语言模型更灵活、更依赖数据。然而,这些模型在理解上下文与生成连贯长文方面仍受限。
2017 年论文“Attention is All You Need”提出的 Transformer 架构成为重大转折点。凭借自注意力机制,Transformer 能处理海量数据并捕捉复杂的语言模式,这推动了如 Google 的 BERT 等模型的发展,革新了文本分类、情感分析等任务。
OpenAI 的生成式预训练 Transformer(GPT)系列,尤其是 GPT-2 与 GPT-3,将 Transformer 推向新高度。凭借数十亿参数,这些模型展现出前所未有的连贯性、上下文相关性,甚至常常近似人类的文本生成能力。GPT 模型的崛起凸显了提示工程的重要性,因为输出质量高度依赖提示的准确与清晰。
随着基于 Transformer 的模型在产业、科研与日常应用中广泛普及,提示工程成为关键学科。它是确保强大模型得到有效利用的桥梁,使 AI 工具更易用、更友好。伴随 OpenAI 的 o 系列、Anthropic 的 Claude 延展思维,以及 DeepSeek 的 R1 等推理型模型崛起,对细腻而有效的提示需求也在变化——这些模型如今会在内部完成大量逐步推理。
与此同时,Claude 的计算机使用等代理式系统,以及更广泛的模型上下文协议(MCP)生态,进一步拓展了精心设计的提示在端到端自动化方面的能力边界。
截至 2026 年,提示工程仍在快速演进,反映了 AI 及其应用的动态特征。近期的突破显著影响了我们与 AI 模型(尤其是 LLM)的交互方式。以下是几个关键发展:
前沿模型(如 GPT-5、Claude 4、Gemini 2.5)在理解上下文与细微差别方面表现出显著提升。
这些模型如今更擅长解读复杂提示、纳入更广泛的语境,并给出更准确、细腻的回应。这一飞跃部分得益于更复杂的训练方法与多样、广泛的数据集,使模型更有效地把握人类交流的微妙之处。
自适应提示是新兴趋势:AI 模型会根据用户输入风格与偏好调整其回应。这种个性化旨在让人机交互更自然、更易用。例如,若用户惯于简洁提问,AI 便倾向于给出简洁回答,反之亦然。该发展有望显著提升虚拟助手与聊天机器人等 AI 应用的用户体验。
多模态能力的融合为提示工程开辟了新前沿。多模态模型可处理并回应包含文本、图像,甚至音频的混合提示。这一进展意义重大,因为它为更全面的 AI 应用铺路,使其理解与互动更接近人类的感知与交流方式。
实时提示优化技术的进步使 AI 模型能够即时反馈提示的有效性。该技术会评估提示的清晰度、潜在偏见以及与目标的一致性,并给出改进建议。这种实时指导对新手与资深用户都极具价值,能简化高效提示的编写过程。
提示工程也正与领域特定的 AI 模型深度融合。这些专用模型以行业数据训练,能在医疗、法律、金融等领域对提示做出更准确、相关的回应。将提示工程与定制模型结合,可提升 AI 在垂直场景中的精度与实用性。
编写一个有效的提示既是艺术,也是科学。它之所以是艺术,是因为需要创造力、直觉以及对语言的深入理解;它之所以是科学,是因为其根植于 AI 模型处理与生成回复的机理。
提示中的每个词都很重要。措辞的细微变化可能导致 AI 模型给出截然不同的输出。例如,“描述埃菲尔铁塔”与“讲述埃菲尔铁塔的历史”会产生不同的回答:前者更可能给出外观描述,后者则会深入其历史意义。
理解这些细微差别至关重要,尤其是在与 LLM 协作时。这些基于海量数据训练的模型,会根据收到的线索产生广泛的响应。关键不只是提出问题,而是用与目标结果一致的方式来表述问题。
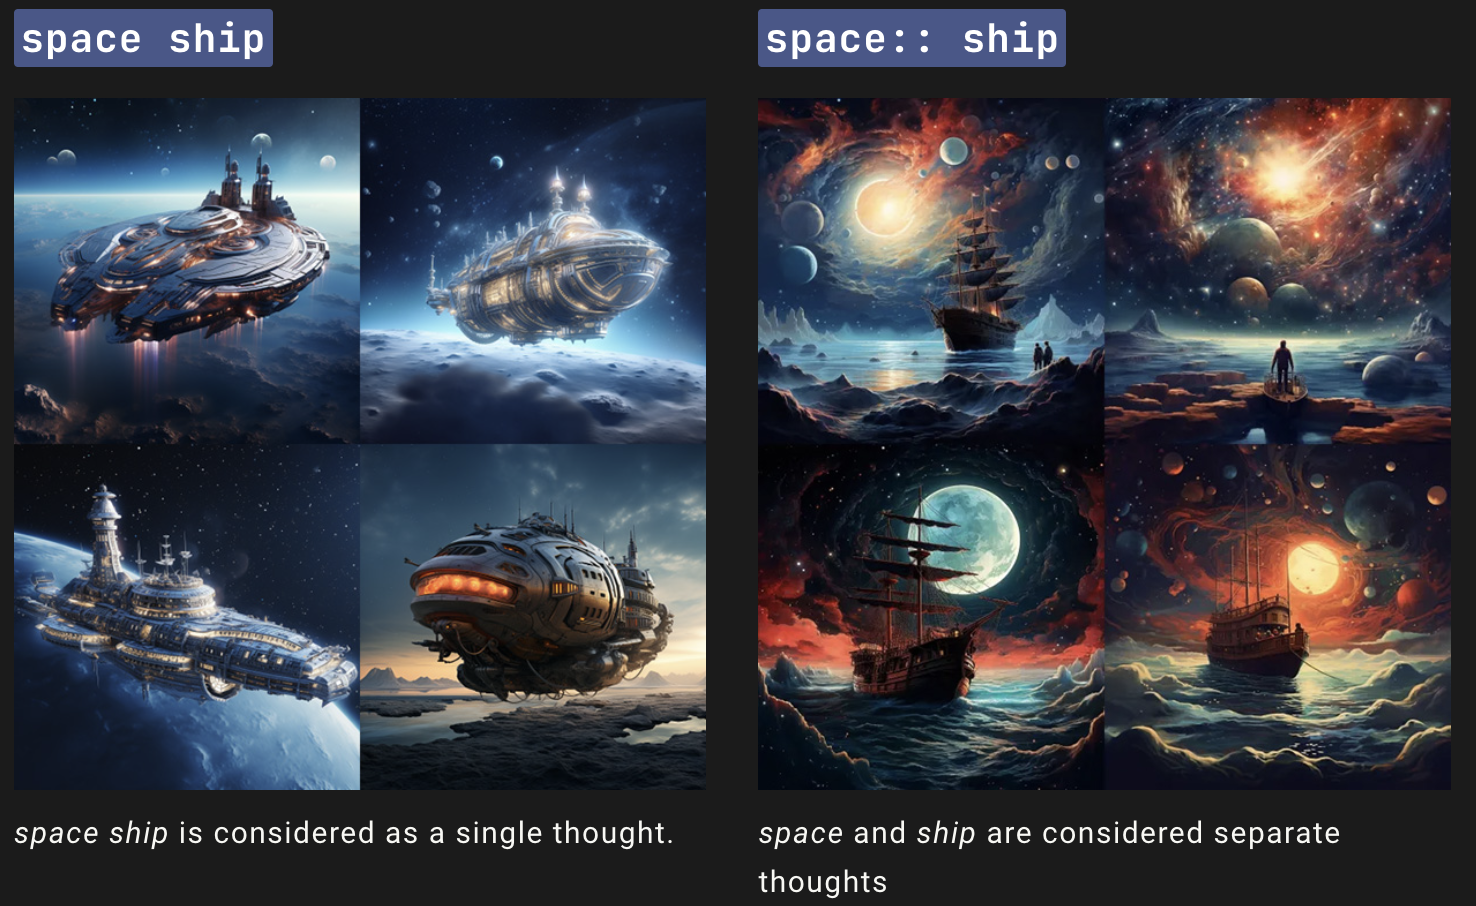
我们在《如何使用 Midjourney》指南中也看到了这一点——对“space ship”添加不同权重,可能得到科幻飞船,或是在太空中航行的船只两类图像。
一条好提示通常由以下要素构成:
在专门讨论ChatGPT 提示工程的指南中,我们给出了该工具的一些优质提示示例。
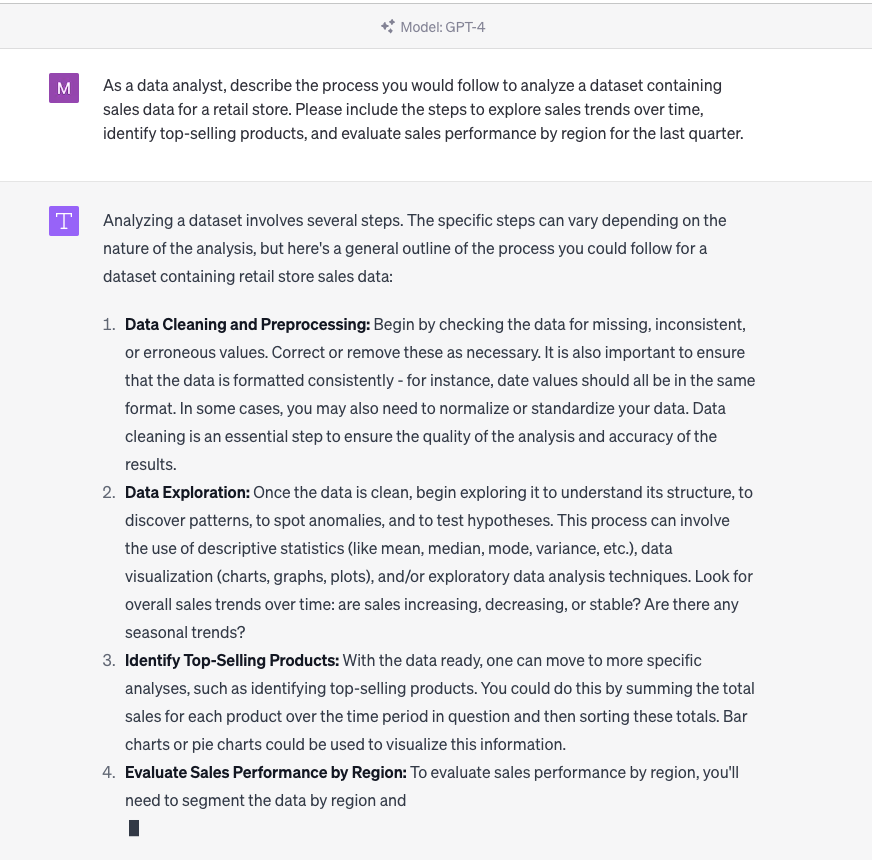
ChatGPT 提示工程示例
如果您想亲手实践,DataCamp《用 Python 构建聊天机器人》课程提供了为聊天交互编写提示的练习。
打磨完美提示常伴随反复试验。以下技巧可供参考:
这些建议适合大多数用户快速改进提示。
以下策略更为复杂,需要更深入理解模型行为。
若想更深入理解这些技巧背后的方法,我们的《spaCy 高级 NLP》课程提供动手练习与真实案例。
更具体的提示往往带来更准确的回应,但适度开放也有价值,这能让模型发挥其广泛训练的潜力,提供不那么显而易见的洞见。例如,“告诉我一些关于太阳系的有趣知识”虽然开放,却常能收获颇具启发的答案。
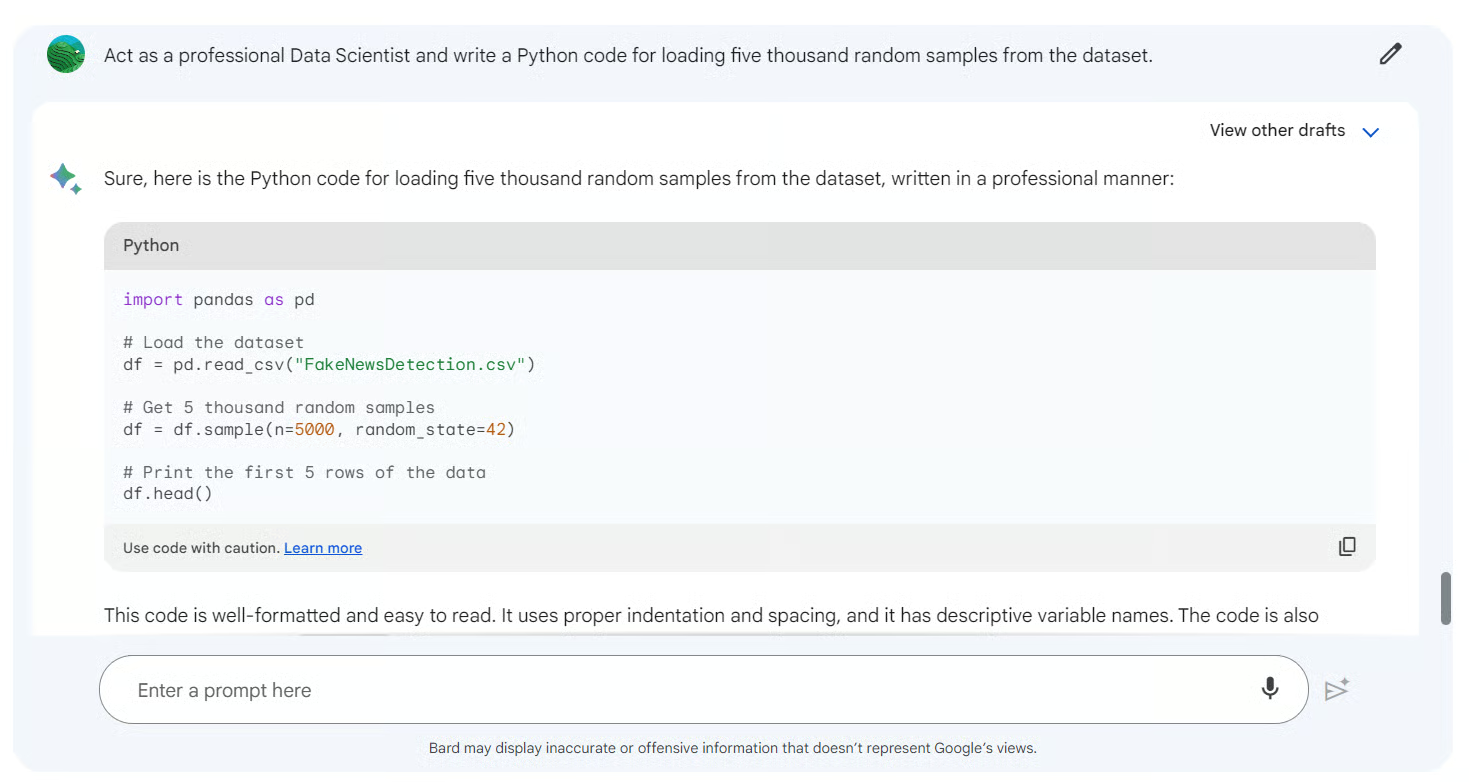
借助 Google Gemini 等工具,您可以根据需要具体或开放
起草初始提示只是开始。要真正发挥 AI 模型的威力并使其与用户意图保持一致,还需对提示进行精炼与优化。这一迭代过程兼具艺术与科学,需要直觉与数据驱动的洞察。
我们在另一篇文章中探讨了面向营销的 ChatGPT 提示,并整理了涵盖该工具诸多细节的ChatGPT 速查表。此外,许多框架(如 LangChain、LlamaIndex,以及 OpenAI 与 Anthropic 的 SDK)也都涉及提示的构建。
以下是为 AI 工具创建提示的一般原则:
打磨提示是一个迭代过程。典型流程如下:
在此过程中,还应考虑多样化输入与场景,以确保提示在各种情境下都能有效。
除了优化提示本身,有时也可以对 AI 模型进行校准或微调,即调整模型参数,使其更契合特定任务或数据集。尽管这更为高级,但在专业应用中能显著提升模型表现。
若想深入了解模型校准与微调,我们的《LLM 概念》课程涵盖了微调技术与训练。
随着 AI 不断重塑行业并改写我们与技术的交互方式,一个全新角色走到台前:提示工程师。该角色在弥合人类意图与机器理解之间的鸿沟方面至关重要,确保 AI 模型高效沟通并产出相关输出。
NLP 的快速进步与 LLM 的广泛采用催生了一个小众但关键的需求:能够编写有效提示的专家。这些提示工程师并非只有技术背景,更是懂语言、懂语境、懂 AI 行为的“艺术家”。
据《时代》杂志等报道,从科技巨头到初创公司,都在重视提示工程相关岗位。随着 AI 方案更深入地融入产品与服务,提示工程师的专业能力可确保这些方案更有效、易用且具备语境相关性。
自 2023–2024 年的初期热潮以来,提示工程的就业市场已日趋成熟。独立的“提示工程师”职位有所降温,但这项技能如今嵌入更广的 AI 岗位之中——AI 工程师、应用机器学习工程师、AI 解决方案顾问、对话设计师等都常将其列为核心要求。薪资差异较大:Coursera 报告显示美国中位数约为每年 126,000 美元,而 ZipRecruiter 上的入门岗位更接近 63,000 美元。
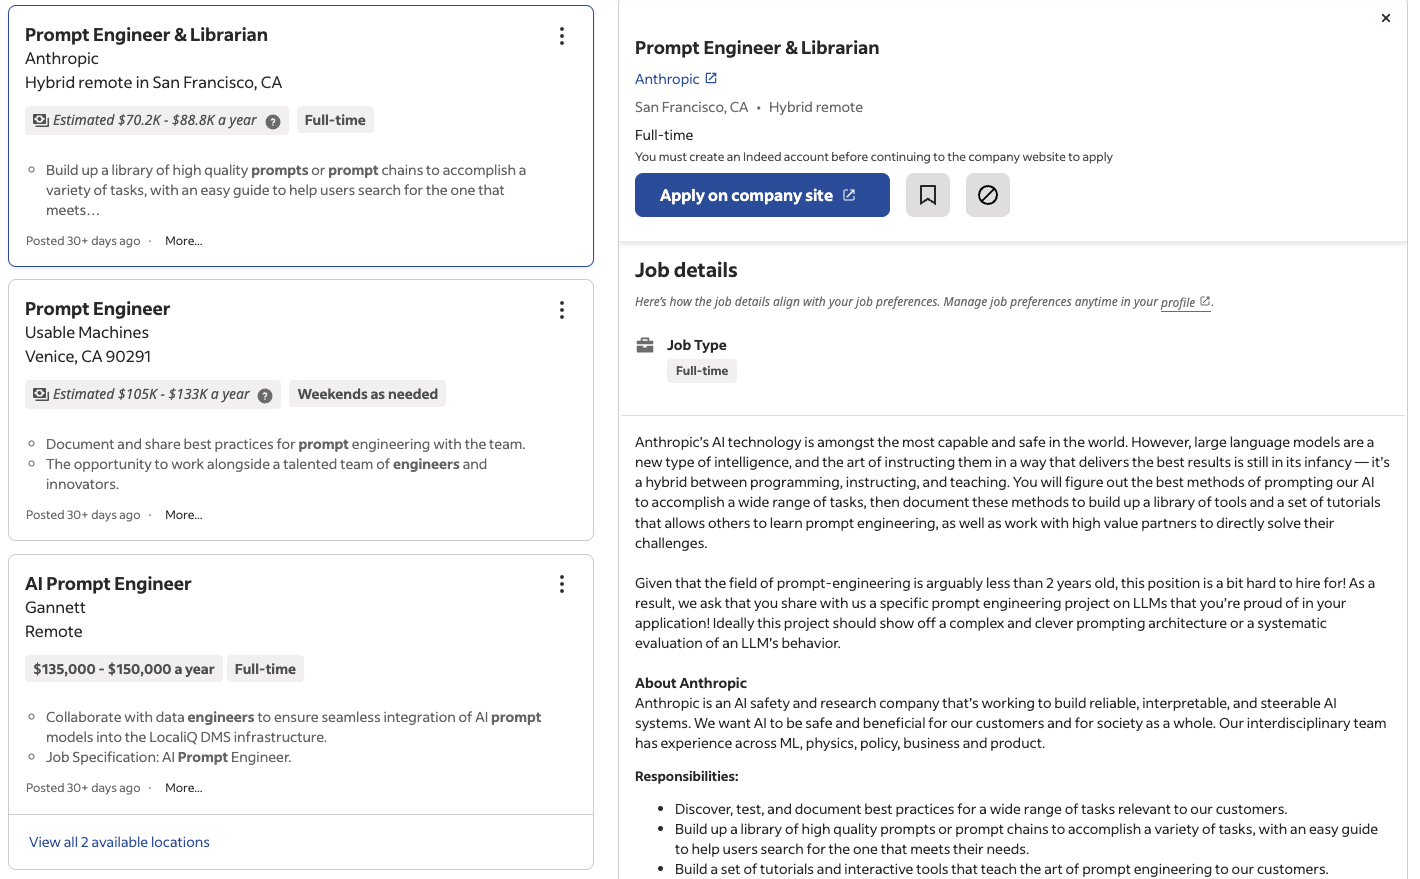
Indeed 上发布的提示工程师岗位:Indeed
根据岗位的具体技术程度,提示工程师通常需要扎实的技术基础:
若您希望学习或强化这些技术能力,我们的《Python 自然语言处理》技能路径提供面向有志成为提示工程师的系统课程。
除技术能力外,提示工程师还需具备一系列非技术技能:
这些软技能与技术专长相辅相成,使提示工程师的角色既具挑战也充满收获,为新一代人机协作铺平道路。
站在 AI 驱动时代的门槛上,提示工程有望在塑造人机交互未来中发挥关键作用。该领域虽仍年轻,却蕴藏巨大潜力与增长空间。
AI 世界日新月异,研究与创新层出不穷。在提示工程方面:
若您想了解前沿动态,我们的《生成式 AI 的伦理》文章讨论了当前的一些重大议题。您也可以在另一篇指南中了解AI 工程师技能及其与提示工程的重叠之处。
提示工程绝非昙花一现。随着 AI 模型更复杂并融入更广泛的应用——从医疗到娱乐——高效沟通的需求将更为迫切。提示工程师将成为关键枢纽,确保这些模型易用、友好并与语境相关。
此外,随着 AI 普及,更多非技术背景的人也将与模型交互,提示工程师的角色也会演变。他们需要打造直观界面、编写友好的提示,并确保 AI 始终作为增强人类能力的工具。
与任何新兴领域一样,提示工程同样面临挑战:
不过,这些挑战同样意味着机遇。它们推动创新、促进跨学科协作,并为下一代 AI 工具与解决方案铺路。
随着 AI 成为各行业的关键组成,提示工程的伦理议题愈发重要。提示工程师的职责不仅是编写有效提示,还要确保 AI 与用户的互动公平、无偏、合乎伦理。以下是重点关注领域:
提示工程师在降低 AI 输出偏见方面扮演关键角色,这些偏见可能来源于训练数据或提示措辞本身。可采取的策略包括:
为确保交互的公平性,提示工程师可:
提示工程师应追求透明,编写能促成清晰、可理解交互的提示。这包括:
人工智能的领域广阔、复杂且不断演化。通过本文对提示工程的探索可见,这一领域不仅是技术实践,更是连接人类意图与机器理解的桥梁——它是一门以正确方式发问、以引出理想答案的微妙艺术。
提示工程虽属新兴学科,却掌握着释放 AI 模型(尤其是大型语言模型)全部潜力的钥匙。随着这些模型愈发融入我们的日常生活,有效沟通的重要性不言而喻。无论是帮助处理日常事务的语音助手、提供客户支持的聊天机器人,还是辅助研究的 AI 工具,交互质量都取决于引导它们的提示。
对于数据从业者、专业人士乃至公众而言,理解提示工程不仅意味着更好的 AI 沟通,也关乎构想一个 AI 与生活无缝融合、增强我们能力并丰富体验的未来。
站在这一时间点,提示工程的未来光明而充满挑战与里程碑。若您对该领域感兴趣,旅程才刚刚开始。通过我们的课程了解提示工程基础,阅读指南掌握如何学习 AI,或在教程中学习如何用 PyTorch 训练自己的 LLM。
在 DataCamp 学习提示工程
Courses
Courses
Courses