在使用AI 智能体时,通过提示语给出的指令在一次性任务中尚可管理。
然而,随着指令集不断增多,模型的注意力会被分散。这会导致部分指令无法像人类工程师那样被“优先处理”。相反,每个 token 都要在上下文窗口中竞争。指令越是异质化,越容易让无关约束稀释关键信息。
借助智能体技能,可以用更好的方式来处理。我们不再构建单一的“万能”提示语,而是工程化出模块化、可组合的能力,仅在需要时加载。
本文将介绍什么是智能体技能、渐进式披露架构如何实现它们、它们与提示语和工具的差异,以及如何在规模化场景中进行治理。
如果您对最新的 AI 进展感兴趣,建议查看以下 LLM 指南:
什么是智能体技能?
先快速明确一下智能体技能的定义。
界定技能单元
智能体技能是可移植、内聚的领域知识与过程逻辑单元。它不仅包含“做什么”,还包含“如何做”的工作流,而不仅是回忆哪些事实或调用哪个 API。从软件角度来说,技能更像服务对象或领域模块,而不是一次函数调用。
理解技能要点的一个有用区分:
- Know-that:事实或数据检索。
- Do-this:原子化的工具执行(如调用 API)。
- Know-how:多步推理、编排与决策规则。
技能运行在“know-how”层面。它们内嵌排序逻辑、校验步骤、条件分支和输出格式标准。更重要的是,它们编码了领域判断。这种判断力让工作流有别于机械的 API 调用。
例如,以“客户流失分析”技能为例:
- 输入:数据集模式、流失定义。
- 过程:校验字段、计算留存指标、分割队列、总结洞见。
- 输出:结构化分析报告。
在此示例中,技能是一个结构化过程,在应用特定领域推理的同时,可能编排多个工具。
AI 智能体可能会根据数据粒度选择合适的留存指标。当流失定义与数据集不一致时,它可能发出提醒。
与其把流失分析逻辑全局嵌入,智能体只在请求流失分析时加载该技能。这种分离有助于可维护性,并减少不同任务之间的非预期干扰。
上下文污染问题
当前常用的基于提示语的上下文方式面临的主要问题之一,是智能体过载的风险。
当智能体被塞入所有可能场景的指令时,会发生注意力稀释。大型语言模型(LLM)依赖对整个上下文窗口进行条件化的概率式 token 预测。当无关指令并存时,它们会以微妙方式影响生成概率。
无关指令仍留在上下文中,彼此争夺注意力。在纯技术任务中,模型可能会过分强调文风或合规模板。这些副作用很难溯源。
智能体技能通过保持上下文窗口干净来解决这一问题。只有当需要某项能力时,系统才注入相关指令块。这样可隔离工作流,降低模型的“认知噪音”。
在实践中,这应当带来更可预测的推理模式和更低的幻觉率。
可移植性与标准化
技能的一大战略性优势是可移植性。
一个良好设计的技能应具备以下特性:
- 可跨智能体复用。
- 可跨项目共享。
- 可集中化版本管理与迭代。
技能成为人类意图与模型执行之间的标准化接口。组织不必为每个项目重写指令,而是维护技能注册表。智能体可动态发现并调用这些标准化组件。
在这方面,技能类似软件工程中的包。它们可以有语义化版本号、变更日志、回归测试与归属元数据。随着时间推移,组织会积累可复用的“制度化推理”库。
智能体技能示例
多个当下的AI 智能体框架展示了这些理念在实践中的运用:
- LangChain 工具包
- Microsoft 的 AutoGen 技能
- Claude Skills
- CrewAI 1.x “capabilities”
一个经典实现是文件夹中包含 SKILL.md 文件以及任务指令。
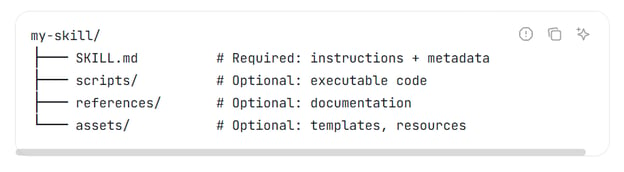
来源:Agentskills.io
尽管包含 SKILL.md 清单等约定有助于文档化,但需要指出,目前尚无正式的行业级技能打包标准。
不同框架采用不同格式:有的使用 YAML 清单(如 LangChain 和 CrewAI),也有将技能定义为 Python 模块或 JSON 模式(如 Microsoft 的 AutoGen)。关于这三种多智能体框架的对比,可参阅我们的指南:CrewAI vs LangGraph vs AutoGen。
智能体技能架构
智能体技能的独特之处在于其渐进式披露格式。下面我们来看相关概念。
渐进式披露
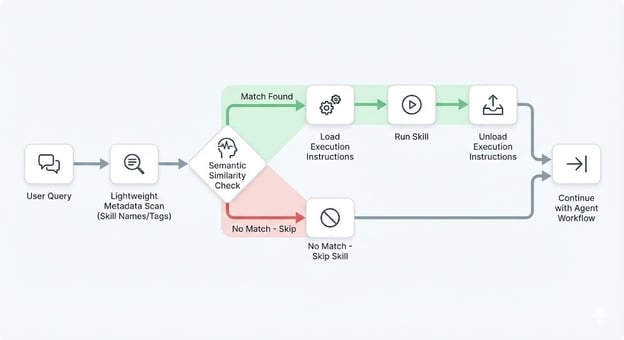
渐进式披露将“发现”与“执行”分离。这种架构模式能最小化不必要的上下文注入,并提升路由精度。
它包含两个层次:一个用于发现元数据,另一个用于执行指令主体。
发现层:
执行层:
- 详细推理步骤
- 结构化清单
- 少量示例(few-shot)
当用户提交请求时,智能体首先只扫描轻量的元数据。它进行语义匹配以识别相关技能。只有在选择之后,才将完整的指令集加载进活动上下文。
这种设计可避免把所有可能的技能指令同时挤满上下文窗口。
隐式与显式调用
技能可通过两种方式触发:
- 显式调用:用户指令:“运行 SEO 审核技能。”
- 隐式调用:智能体根据语义自行推断需求。
隐式调用依赖用户输入与技能描述之间的语义相似度。
例如,当被问到“您能审查我的博客并提出排名改进建议吗?”,智能体可能会匹配到带有“SEO”“内容审核”“搜索排名优化”等标签的技能。这种匹配通常使用嵌入相似度。
有效的技能描述相当于路由钩子。描述含糊则选择失败;描述精准且关键词丰富,则更易被正确选中。
动态上下文管理
渐进式披露支持对上下文进行动态“注入与卸载”。
也就是说,系统不会常驻所有技能逻辑,而是随着对话演进按需切换能力。
- 当技能被激活时,注入其指令。
- 步骤完成后,可移除指令。
- 随后为下一阶段加载另一项技能。
在多步会话中,这种切换机制提升效率并减轻 token 压力,也让推理边界更清晰。可将其类比如下工作流:
- 加载数据清洗技能。
- 执行并卸载。
- 加载可视化技能。
- 执行并卸载。
每个阶段都由聚焦的指令集治理,而不是不断膨胀的提示语。
智能体技能 vs. 技术栈
技能与当前智能体 AI 技术栈中的组件存在一些关键差异。我们将逐一说明。
|
组件
|
定义
|
持续性
|
目的
|
示例用例
|
|
系统提示语
|
在交互前定义的基础性指令、人格与政策约束。
|
持久化。跨所有交互保持不变的参数。
|
定义整体角色、语气、伦理边界和指导方针。
|
将人格设置为“安全编码助手”,且永不泄露内部指令。
|
|
工具
|
可执行的函数或接口(如 API、数据库),用于执行模型外部的操作。
|
任务特定。仅在需要执行某个动作时动态调用。
|
扩展超越文本生成的能力,以便与数据或现实世界交互。
|
使用“网页搜索”工具获取实时信息,或用“计算器”进行数学计算。
|
|
技能
|
可复用的程序化知识,定义如何为特定任务组合动作/工具。
|
定义持久、执行按需。逻辑被保存,但仅在相关时应用。
|
为复杂多步任务提供标准化工作流,确保一致性。
|
“生成月度报告”技能,编排数据库查询、格式化与发送邮件等步骤。
|
|
规则引擎
|
通过显式“if-then”逻辑语句执行确定性决策的独立系统。
|
持久化。固定策略,除非被显式修改。
|
强制执行业务逻辑、合规模块与可预测结果。
|
银行规则:“如果交易 >$10k 且为国际交易,则标记为欺诈复核。”
|
智能体技能 vs. 系统提示语
系统提示语是全局且常驻的。它们定义语气、身份,以及如安全姿态或品牌语调等高层约束,应保持稳定且精简。
技能是瞬时且任务特定的。仅在需要时引入详细的执行逻辑。
最佳实践:
- 让系统提示语聚焦于身份、安全与高层政策。
- 将任务特定的工作流放入技能中。
这种分离可降低幻觉风险并提升模块化程度。将任务逻辑作为离散单元存放,而不是埋在系统提示语中,更易调试与迭代,且不会破坏整个智能体的稳定性。
这也使技能成为推进智能体 AI 的更优路径。
智能体技能 vs. 工具
我们也将技能与 AI 智能体所用的工具做个对比。
工具提供原子能力:
技能提供使用这些工具的过程。
可以把工具看作“执行者”,把技能看作“管理者”。执行者完成特定动作;管理者决定何时、为何以及如何协调多个执行者。
示例:
工具会运行以下代码块来执行任务。
get_sales_data(start_date, end_date)技术支持
技能会提供如下上下文与指令:
- 校验日期范围。
- 调用
get_sales_data。
- 按地区分段。
- 计算增长率。
- 生成管理层摘要。
那么,何时使用哪一个?
- 如果能力是确定性的且为外部动作(如 API 调用),请编写工具。
- 如果能力需要推理、排序与判断,请编写技能。
技能 vs. 规则引擎
规则引擎是护栏,用于强制执行约束。它们回答“什么不应发生?”。规则引擎可能会阻止泄露 PII(“报告中不得包含客户邮箱地址”),或强制语气(“拒绝含有粗俗语的输出”)。
与之相对,智能体技能用于赋能能力。它们回答“如何完成这件事?”。简而言之,规则引擎提供任务的必要合规边界,技能提供任务的操作步骤。
规则引擎位于外层(始终活跃、不可协商),而技能在内层执行层运作(按条件加载)。两者结合可塑造平衡的智能体:既有安全边界,又有有效流程。
使用时机:
- 将规则引擎用于合规、安全与质量关卡
- 将智能体技能用于领域工作流与多步推理
这种分离可避免规则膨胀进任务逻辑,同时确保技能不会绕过治理。
智能体技能的设计原则
为确保智能体可靠,您可以遵循一些核心设计原则作为指南。
优化语义发现
技能描述至关重要,因为发现过程常常发生在模型可见执行逻辑之前。您需要优化它们以提升可发现性。
一种方法是关注元数据,它相当于技能库的索引。
有效元数据应具备:
正反示例:
- 糟糕的描述:“帮助写作。”
- 更好的描述:“分析长篇技术博客,并给出 SEO 优化建议,包括标题结构调整与内链策略。”
关键词密度与命名约定会显著影响路由表现。因此应将技能命名视作 API 设计来处理,以减少歧义。
通过结构提升确定性
技能应包含刚性的结构化元素,以减少生成输出的波动。语言模型具有概率性,引入刚性结构可限制并收敛解空间。
示例:
示例技能骨架:
- 校验输入。
- 若缺少字段,则请求澄清。
- 执行核心工作流。
- 按 JSON 模式生成输出:摘要、风险与建议。
合理划定范围以提升可靠性
还需避免“全能技能”的反模式,即一个技能试图解决过多松散相关的问题。
例如,一个技能同时处理:
这种技能会因指令主体膨胀、内部不一致而降低可靠性。
相反,应将工作流拆解为更小、可串联的单元。每个技能都应范围狭窄、精度高。更小的技能更易测试、版本化与调试。
智能体技能的治理
在规模化部署智能体时,需要考虑一些治理方面的内容。
所有权层级
技能治理可在多个层级运作:
- 系统层:不可变且与安全密切相关的指令。
- 组织层:共享的领域工作流。
- 用户层:个人或实验性技能。
当用户定义的技能与组织标准相矛盾时会产生冲突。治理策略应定义优先级规则,通常自上而下,以确保安全。
清晰的版本管理、归属元数据与审批流程也有助于降低歧义。
安全与沙箱
技能可编排工具并访问数据,因此引入了安全考虑。
风险包括:
缓解措施:
- 将技能限制在特定工具范围内。
- 定义权限边界。
- 对敏感数据强制只读模式。
例如,财务报告技能不应对交易系统拥有写权限,除非明确需要。为企业级部署,需要精心设计并细化的权限模型。
评估技能性能
智能体技能也可以进行性能度量。
主要有两项指标:
- 召回:该技能在应触发时是否触发?
- 精度:它是否正确执行?
评估流程可使用“LLM 作为评审”的框架:
- 生成输出。
- 将输出传递给评估模型。
- 依据评分标准进行打分。
- 存储指标以便监控。
随着时间推移,低召回的技能可通过改进元数据来优化;低精度的技能可通过收紧结构与示例来优化。关于这两个指标的详细解释与比较,建议阅读我们的指南:Precision vs Recall。
未来 AI 生态中的智能体技能
展望智能体技能的未来,我们可以预见一些趋势将会兴起。以下是其中几项。
多智能体协作
在更高级的系统中,多个智能体可能分别专精于:
技能成为它们之间的契约。一个智能体可以将技能暴露为可调用接口,另一个智能体可将其作为更大工作流的一部分来调用。
这种连接将能力与实现解耦,支持分布式推理架构。
技能市场的兴起
随着生态成熟,组织更可能下载经过验证的技能,而非从零开始构建一切。
这带来了新的需求:
这些可确保 AI 技能可信、准确。
提示工程也可能演变为包管理。技能可能会被签名、审计,并通过注册表分发,类似当今的软件库。
意图的标准化
行业正朝着通用技能定义模式迈进:
- 结构化元数据字段。
- 明确的输入/输出契约。
- 与模型无关的定义。
长期目标是实现“一次编写、到处运行”的技能,能跨不同模型家族和平台通用。
标准化还能降低供应商锁定,加速生态发展。
结论
智能体技能标志着从简单提示链向稳健工程化 AI 系统的转变。它们是实现 AI 智能体可持续扩展的关键。事实上,它们就像连接原始模型智能与可靠、可投产工作流的桥梁。
接下来,您可以这样做:回顾当前的智能体工作流,识别重复出现的推理模式,将其抽离并重构为模块化技能。
想要系统化更深入地学习?我们的Introduction to AI Agents课程和AI Agent Fundamentals学习路径是很好的起点。


在使用AI 智能体时,通过提示语给出的指令在一次性任务中尚可管理。
然而,随着指令集不断增多,模型的注意力会被分散。这会导致部分指令无法像人类工程师那样被“优先处理”。相反,每个 token 都要在上下文窗口中竞争。指令越是异质化,越容易让无关约束稀释关键信息。
借助智能体技能,可以用更好的方式来处理。我们不再构建单一的“万能”提示语,而是工程化出模块化、可组合的能力,仅在需要时加载。
本文将介绍什么是智能体技能、渐进式披露架构如何实现它们、它们与提示语和工具的差异,以及如何在规模化场景中进行治理。
如果您对最新的 AI 进展感兴趣,建议查看以下 LLM 指南:
什么是智能体技能?
先快速明确一下智能体技能的定义。
界定技能单元
智能体技能是可移植、内聚的领域知识与过程逻辑单元。它不仅包含“做什么”,还包含“如何做”的工作流,而不仅是回忆哪些事实或调用哪个 API。从软件角度来说,技能更像服务对象或领域模块,而不是一次函数调用。
理解技能要点的一个有用区分:
技能运行在“know-how”层面。它们内嵌排序逻辑、校验步骤、条件分支和输出格式标准。更重要的是,它们编码了领域判断。这种判断力让工作流有别于机械的 API 调用。
例如,以“客户流失分析”技能为例:
在此示例中,技能是一个结构化过程,在应用特定领域推理的同时,可能编排多个工具。
AI 智能体可能会根据数据粒度选择合适的留存指标。当流失定义与数据集不一致时,它可能发出提醒。
与其把流失分析逻辑全局嵌入,智能体只在请求流失分析时加载该技能。这种分离有助于可维护性,并减少不同任务之间的非预期干扰。
上下文污染问题
当前常用的基于提示语的上下文方式面临的主要问题之一,是智能体过载的风险。
当智能体被塞入所有可能场景的指令时,会发生注意力稀释。大型语言模型(LLM)依赖对整个上下文窗口进行条件化的概率式 token 预测。当无关指令并存时,它们会以微妙方式影响生成概率。
无关指令仍留在上下文中,彼此争夺注意力。在纯技术任务中,模型可能会过分强调文风或合规模板。这些副作用很难溯源。
智能体技能通过保持上下文窗口干净来解决这一问题。只有当需要某项能力时,系统才注入相关指令块。这样可隔离工作流,降低模型的“认知噪音”。
在实践中,这应当带来更可预测的推理模式和更低的幻觉率。
可移植性与标准化
技能的一大战略性优势是可移植性。
一个良好设计的技能应具备以下特性:
技能成为人类意图与模型执行之间的标准化接口。组织不必为每个项目重写指令,而是维护技能注册表。智能体可动态发现并调用这些标准化组件。
在这方面,技能类似软件工程中的包。它们可以有语义化版本号、变更日志、回归测试与归属元数据。随着时间推移,组织会积累可复用的“制度化推理”库。
智能体技能示例
多个当下的AI 智能体框架展示了这些理念在实践中的运用:
一个经典实现是文件夹中包含
SKILL.md文件以及任务指令。来源:Agentskills.io
尽管包含
SKILL.md清单等约定有助于文档化,但需要指出,目前尚无正式的行业级技能打包标准。不同框架采用不同格式:有的使用 YAML 清单(如 LangChain 和 CrewAI),也有将技能定义为 Python 模块或 JSON 模式(如 Microsoft 的 AutoGen)。关于这三种多智能体框架的对比,可参阅我们的指南:CrewAI vs LangGraph vs AutoGen。
智能体技能架构
智能体技能的独特之处在于其渐进式披露格式。下面我们来看相关概念。
渐进式披露
渐进式披露将“发现”与“执行”分离。这种架构模式能最小化不必要的上下文注入,并提升路由精度。
它包含两个层次:一个用于发现元数据,另一个用于执行指令主体。
发现层:
执行层:
当用户提交请求时,智能体首先只扫描轻量的元数据。它进行语义匹配以识别相关技能。只有在选择之后,才将完整的指令集加载进活动上下文。
这种设计可避免把所有可能的技能指令同时挤满上下文窗口。
隐式与显式调用
技能可通过两种方式触发:
隐式调用依赖用户输入与技能描述之间的语义相似度。
例如,当被问到“您能审查我的博客并提出排名改进建议吗?”,智能体可能会匹配到带有“SEO”“内容审核”“搜索排名优化”等标签的技能。这种匹配通常使用嵌入相似度。
有效的技能描述相当于路由钩子。描述含糊则选择失败;描述精准且关键词丰富,则更易被正确选中。
动态上下文管理
渐进式披露支持对上下文进行动态“注入与卸载”。
也就是说,系统不会常驻所有技能逻辑,而是随着对话演进按需切换能力。
在多步会话中,这种切换机制提升效率并减轻 token 压力,也让推理边界更清晰。可将其类比如下工作流:
每个阶段都由聚焦的指令集治理,而不是不断膨胀的提示语。
智能体技能 vs. 技术栈
技能与当前智能体 AI 技术栈中的组件存在一些关键差异。我们将逐一说明。
组件
定义
持续性
目的
示例用例
系统提示语
在交互前定义的基础性指令、人格与政策约束。
持久化。跨所有交互保持不变的参数。
定义整体角色、语气、伦理边界和指导方针。
将人格设置为“安全编码助手”,且永不泄露内部指令。
工具
可执行的函数或接口(如 API、数据库),用于执行模型外部的操作。
任务特定。仅在需要执行某个动作时动态调用。
扩展超越文本生成的能力,以便与数据或现实世界交互。
使用“网页搜索”工具获取实时信息,或用“计算器”进行数学计算。
技能
可复用的程序化知识,定义如何为特定任务组合动作/工具。
定义持久、执行按需。逻辑被保存,但仅在相关时应用。
为复杂多步任务提供标准化工作流,确保一致性。
“生成月度报告”技能,编排数据库查询、格式化与发送邮件等步骤。
规则引擎
通过显式“if-then”逻辑语句执行确定性决策的独立系统。
持久化。固定策略,除非被显式修改。
强制执行业务逻辑、合规模块与可预测结果。
银行规则:“如果交易 >$10k 且为国际交易,则标记为欺诈复核。”
智能体技能 vs. 系统提示语
系统提示语是全局且常驻的。它们定义语气、身份,以及如安全姿态或品牌语调等高层约束,应保持稳定且精简。
技能是瞬时且任务特定的。仅在需要时引入详细的执行逻辑。
最佳实践:
这种分离可降低幻觉风险并提升模块化程度。将任务逻辑作为离散单元存放,而不是埋在系统提示语中,更易调试与迭代,且不会破坏整个智能体的稳定性。
这也使技能成为推进智能体 AI 的更优路径。
智能体技能 vs. 工具
我们也将技能与 AI 智能体所用的工具做个对比。
工具提供原子能力:
技能提供使用这些工具的过程。
可以把工具看作“执行者”,把技能看作“管理者”。执行者完成特定动作;管理者决定何时、为何以及如何协调多个执行者。
示例:
工具会运行以下代码块来执行任务。
技能会提供如下上下文与指令:
get_sales_data。那么,何时使用哪一个?
技能 vs. 规则引擎
规则引擎是护栏,用于强制执行约束。它们回答“什么不应发生?”。规则引擎可能会阻止泄露 PII(“报告中不得包含客户邮箱地址”),或强制语气(“拒绝含有粗俗语的输出”)。
与之相对,智能体技能用于赋能能力。它们回答“如何完成这件事?”。简而言之,规则引擎提供任务的必要合规边界,技能提供任务的操作步骤。
规则引擎位于外层(始终活跃、不可协商),而技能在内层执行层运作(按条件加载)。两者结合可塑造平衡的智能体:既有安全边界,又有有效流程。
使用时机:
这种分离可避免规则膨胀进任务逻辑,同时确保技能不会绕过治理。
智能体技能的设计原则
为确保智能体可靠,您可以遵循一些核心设计原则作为指南。
优化语义发现
技能描述至关重要,因为发现过程常常发生在模型可见执行逻辑之前。您需要优化它们以提升可发现性。
一种方法是关注元数据,它相当于技能库的索引。
有效元数据应具备:
正反示例:
关键词密度与命名约定会显著影响路由表现。因此应将技能命名视作 API 设计来处理,以减少歧义。
通过结构提升确定性
技能应包含刚性的结构化元素,以减少生成输出的波动。语言模型具有概率性,引入刚性结构可限制并收敛解空间。
示例:
示例技能骨架:
合理划定范围以提升可靠性
还需避免“全能技能”的反模式,即一个技能试图解决过多松散相关的问题。
例如,一个技能同时处理:
这种技能会因指令主体膨胀、内部不一致而降低可靠性。
相反,应将工作流拆解为更小、可串联的单元。每个技能都应范围狭窄、精度高。更小的技能更易测试、版本化与调试。
智能体技能的治理
在规模化部署智能体时,需要考虑一些治理方面的内容。
所有权层级
技能治理可在多个层级运作:
当用户定义的技能与组织标准相矛盾时会产生冲突。治理策略应定义优先级规则,通常自上而下,以确保安全。
清晰的版本管理、归属元数据与审批流程也有助于降低歧义。
安全与沙箱
技能可编排工具并访问数据,因此引入了安全考虑。
风险包括:
缓解措施:
例如,财务报告技能不应对交易系统拥有写权限,除非明确需要。为企业级部署,需要精心设计并细化的权限模型。
评估技能性能
智能体技能也可以进行性能度量。
主要有两项指标:
评估流程可使用“LLM 作为评审”的框架:
随着时间推移,低召回的技能可通过改进元数据来优化;低精度的技能可通过收紧结构与示例来优化。关于这两个指标的详细解释与比较,建议阅读我们的指南:Precision vs Recall。
未来 AI 生态中的智能体技能
展望智能体技能的未来,我们可以预见一些趋势将会兴起。以下是其中几项。
多智能体协作
在更高级的系统中,多个智能体可能分别专精于:
技能成为它们之间的契约。一个智能体可以将技能暴露为可调用接口,另一个智能体可将其作为更大工作流的一部分来调用。
这种连接将能力与实现解耦,支持分布式推理架构。
技能市场的兴起
随着生态成熟,组织更可能下载经过验证的技能,而非从零开始构建一切。
这带来了新的需求:
这些可确保 AI 技能可信、准确。
提示工程也可能演变为包管理。技能可能会被签名、审计,并通过注册表分发,类似当今的软件库。
意图的标准化
行业正朝着通用技能定义模式迈进:
长期目标是实现“一次编写、到处运行”的技能,能跨不同模型家族和平台通用。
标准化还能降低供应商锁定,加速生态发展。
结论
智能体技能标志着从简单提示链向稳健工程化 AI 系统的转变。它们是实现 AI 智能体可持续扩展的关键。事实上,它们就像连接原始模型智能与可靠、可投产工作流的桥梁。
接下来,您可以这样做:回顾当前的智能体工作流,识别重复出现的推理模式,将其抽离并重构为模块化技能。
想要系统化更深入地学习?我们的Introduction to AI Agents课程和AI Agent Fundamentals学习路径是很好的起点。