一个准确率达到 98% 的机器学习模型听起来很惊人——但真的是这样吗?当您处理欺诈或疾病这类罕见事件时,准确率往往会带来一种虚假的安全感。
这就是精确率与召回率发挥作用的地方。本文将探讨这两个指标如何超越简单的准确率,不仅衡量您有多常做对,更要看清楚您究竟是如何做错的。
如果您想走出理论、真正掌握分类问题,Fraud Detection in Python 课程是不二之选。
为何仅有准确率还不够
在大多数情况下,准确率是衡量统计或机器学习模型对某个标签预测效果的自然选择。它通过将正确预测的数量与观测总数进行比较来计算。
通常而言,如果一个模型能以较高的准确率稳定识别正确标签,那么它表现不错。然而,在类别不平衡的数据集中,当一个类别样本显著多于另一个时,准确率会被扭曲。这样的数据集在欺诈检测或疾病诊断中很常见。
假设一个模型以 98% 的准确率将交易分类为欺诈。乍一看,这个数很棒。但如果欺诈仅占数据集中 2% 的交易呢?在这种情况下,模型每次都选择“非欺诈”也能达到 98% 的准确率,却一个欺诈都抓不到,这显然不是我们想要的结果。
显然,这类情形需要更细致的指标。两个常用指标是精确率(precision)与召回率(recall)。
什么是精确率与召回率?
简而言之:
- 精确率(质量):衡量您的正类预测是否可靠。模型说“欺诈”时,实际上是不是欺诈?
- 召回率(数量):衡量您覆盖了多少真实的正类。模型是否抓住了所有欺诈,还是有一些漏掉了?
要理解如何计算这些指标,我们首先需要界定混淆矩阵中的术语。
真正类、假正类与负类
想象一家信用卡公司使用机器学习模型来检测欺诈交易。假设在 10,000 笔交易的样本中,有 9,800 笔为合法交易,200 笔为欺诈。
为了衡量模型的有效性,需要将“欺诈”或“非欺诈”中的一个指定为正类,另一个指定为负类。由于我们关注欺诈案例,因此将其标记为“正类”。(当然,这并不意味着从伦理角度看欺诈是正面的;“正类”标签仅表示我们所关注的那一类。)
当模型运行时,风险分数高于某个概率阈值(比如 70%)的交易会被认为是欺诈。将被预测为欺诈的案例与实际为欺诈的案例进行比较。
为了理清这些数据,我们使用以下命名方式。
- 真正类(TP):160 个欺诈案例被正确预测为欺诈。
- 真负类(TN):9500 个案例被正确识别为非欺诈。
- 假正类(FP):300 个案例被错误标记为欺诈。
- 假负类(FN):40 个案例被错误标记为非欺诈。
第二个字母(P 或 N)表示预测为正或负,第一个字母表示该预测是真(T)还是假(F)。
“假正类”表示系统预测为正,但实际为负。例如,假负类则是被预测为负,实际却为正。
混淆矩阵
以上信息通常会展示在所谓的混淆矩阵中,它用于记录模型将错误预测与实际结果(FN、FP)混淆的频率。混淆矩阵帮助我们区分模型预测了什么以及实际发生了什么。我们的示例的混淆矩阵如下所示:
| |
实际欺诈(实际正类)
|
实际合法(实际负类)
|
|
预测为欺诈(预测正类)
|
160 (TP)
|
300 (FP)
|
|
预测为合法(预测负类)
|
40 (FN)
|
9500 (TN)
|
现在,我们来看行和列的合计。行和表示总的预测数量,列和表示总的实际数量。
| |
实际欺诈(实际正类)
|
实际合法(实际负类)
| |
|
预测为欺诈(预测正类)
|
160 (TP)
|
300 (FP)
|
460 (TP + FP) 预测正类总数
|
|
预测为合法(预测负类)
|
40 (FN)
|
9500 (TN)
|
9540 (FN + TN) 预测负类总数
|
| |
200 (TP + FN) 实际正类总数
|
9800 (FP + TN) 实际负类总数
|
10,000
|
这些合计代表什么?
- 第一行合计(460)表示预测为欺诈的总数(TP + FP)。
- 第二行合计(9,540)表示预测为合法的总数(FN + TN)。
- 第一列合计(200)表示实际欺诈的总数(TP + FN)。
- 第二列合计(9,800)表示实际合法的总数(FP + TN)。
- 总计(10,000)等于样本的总规模。
什么是精确率?
精确率衡量正类预测的质量。它告诉我们被预测为正类的案例中有多少实际上为正类。
高精确率意味着很少出现误报。如果模型说某事为真,它大概率是真的。比如,若一款网络游戏要封禁作弊者,那必须确保是真的作弊。过多不应有的封禁会疏远合法用户并带来差评。
按上文术语,精确率等于真正类占预测正类的比例。
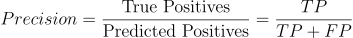
在上述示例中,精确率为 160/460,约 34.8%。
什么是召回率?
召回率衡量覆盖度。它展示了实际正类中有多少被预测为正类。定义为真正类占实际正类总数的比例。
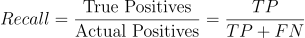
以癌症的初步复查诊断为例。是宁可过度诊断还是宁可漏诊?大多数人会同意前者。
在早期筛查中,收到一次虚惊可能令人震惊;但在您确实患癌时被告知没有癌症却是灾难性的,尤其是可能因此错过挽救生命的治疗。
在上述示例中,召回率为 160/200,即 80%。
精确率与召回率的权衡
精确率和召回率之间存在此消彼长的关系。通常,精确率上升时,召回率会下降,反之亦然。
为了解其原因,让我们回到欺诈示例。
大多数欺诈被抓到了,但假正类很多。假设由于客户投诉,管理层决定将决策阈值从 0.7 提高到 0.8。要将交易标记为欺诈,现在必须至少达到 0.8 的分数,而不是 0.7。
这使模型更为保守。它更少预测为欺诈。被错误标记为欺诈的交易减少了,但代价是更多真实的欺诈漏网。阈值更改后,假正类从 300 降至 60,但假负类从 40 升至 80。
新模型的混淆矩阵如下所示:
| |
实际欺诈(实际正类)
|
实际合法(实际负类)
| |
|
预测为欺诈(预测正类)
|
120 (TP)
|
60 (FP)
|
180 (TP + FP) 预测正类总数
|
|
预测为合法(预测负类)
|
80 (FN)
|
9740 (TN)
|
9820 (FN + TN) 预测负类总数
|
| |
200 (TP + FN) 实际正类总数
|
9800 (FP + TN) 实际负类总数
|
10,000
|
可以看到,在 180 个被预测为欺诈的案例中,120 个确为欺诈,因此精确率从 34.8% 提升到了 66.7%。
提高精确率的代价是召回率下降:200 个欺诈案例中有 120 个被预测为欺诈,召回率从最初的 80% 降至 60%。
该模型总体上抓到的欺诈变少了,但一旦标记为欺诈,置信度更高。这表明同时平衡这两个指标的重要性,我们稍后会讨论。
精确率-召回率曲线
为可视化精确率与召回率之间的权衡,数据科学家使用精确率-召回率(PR)曲线。
该图将精确率绘于纵轴、召回率绘于横轴,覆盖每一个可能的决策阈值(从 0 到 1)。当您降低阈值以捕获更多正类(提高召回率)时,必然会带来更多误报(降低精确率)。
“完美”的模型会达到右上角(100% 精确率与召回率),但在现实中,您必须在曲线上选择一个满足特定业务需求的点。
在我们的欺诈示例中,模型会为每笔交易输出一个欺诈分数。若交易分数至少达到阈值,就会被标记为欺诈。随着阈值降低,预测正类变多,通常会捕获更多真正类(召回率上升),但也会带来更多误报(精确率下降)。
来看实际中可能的情况。假设您的公司每天处理 10,000 笔交易。由于估计欺诈率为 2%,您预计每天有 200 笔欺诈交易。另假设欺诈运营团队每天可以人工审核 200 笔被标记的交易(预测正类)。
您评估了几个阈值,得到以下结果:
- 在阈值 0.9 时,预测正类为 100,精确率为 0.8(80 个真实欺诈,20 个误报),召回率为 0.4(捕获 200 个欺诈中的 80 个)。您未充分利用产能,因为每天只标记了 100 笔,但您可以审核 200 笔。
- 在阈值 0.5 时,预测正类为 500,精确率为 0.35(175 个真实欺诈,325 个误报),召回率为 0.875(捕获 200 个欺诈中的 175 个)。此时超出产能,因为您无法审核 500 笔被标记的案例。
- 在阈值 0.7 时,预测正类为 200,精确率为 0.6(120 个真实欺诈,80 个误报),召回率为 0.6(捕获 200 个欺诈中的 120 个)。这可能是您会使用的阈值,因为可以用满产能,同时获得尚可的 0.6 召回率。
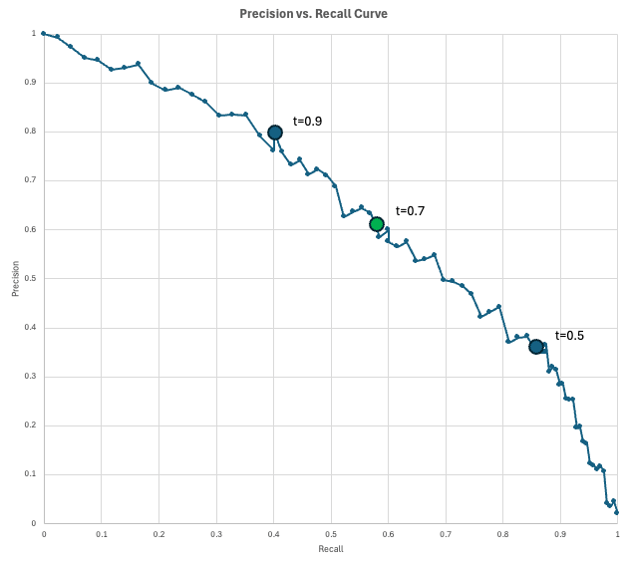
这条曲线告诉您,在给定召回率下可以“买到”的精确率是多少(或反之)。
何时使用精确率或召回率
由于二者存在权衡关系,正确的指标取决于您的具体用例。
何时关注精确率
精确率与假正类之间呈反比。因此,高精确率的模型能很好地区分真正类与假正类,它是可信的。
当假正类代价很高时,请优化精确率。典型情形包括:
- 不可逆的操作:自动化司法或封禁账号系统。因为模型错误(假正类)而冤枉无辜或永久删除用户账号,会造成无法弥补的损害。
- 高成本干预:石油钻探或停产整条工厂流水线。若依据正类预测采取行动需要耗费数百万美元,就必须在推进前确保预测正确。
- 垃圾邮件过滤:电子邮箱。看到一封垃圾邮件(假负类)固然恼人,但把重要的录用通知扔进垃圾箱(假正类)是不可接受的。
何时关注召回率
同样地,召回率与假负类呈反比。假负类很多会导致召回率低。因此,高召回率的模型能很好地区分真正类与假负类,它是安全的。
如果避免漏掉真实案例比接受一些误报更重要,您应优先考虑召回率而非精确率。示例用例如下:
- 医疗安全:疾病筛查(如癌症或脓毒症)。漏掉一位病人可能是致命的,而误报只会带来进一步检查,这是可接受的成本。
- 网络安全:恶意软件检测或网络入侵。标记几个无辜登录为可疑要优于让一个黑客不被察觉地入侵系统。
- 制造质量:缺陷检测。放行一件有缺陷的产品(假负类)会带来安全责任与声誉损害,因此宁可丢弃一些边缘样品,也不要让有缺陷的产品通过。
用 F1 分数平衡精确率与召回率
如果您不确定应优化精确率还是召回率,或者希望同时考虑两者,可以参考 F1 分数。
F1 分数定义为精确率与召回率的调和平均,当您想在两者之间取得平衡时使用。
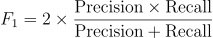
当精确率与召回率相等时,F1 分数就等于该值。然而,如果两者之一接近于零,F1 也会非常低。
在上述示例中,精确率为 66.7%,召回率为 60%。按照上面的公式,我们得到 F1 分数约为 63.2%:
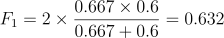
下表将 F1 分数与准确率、精确率、召回率进行了比较。
|
指标
|
它回答的问题
|
何时优化该指标
|
示例
|
|
准确率
|
“总体上我们有多常预测正确?”
|
类别均衡,且 FP 与 FN 的代价相近。
|
手写数字分类。
|
|
精确率
|
“在所有预测为正类的案例中,我们有多常是正确的?”
|
当假正类代价高、惩罚性强或会造成客户痛点时。
|
欺诈拦截、封禁用户、侵入性医疗操作。
|
|
召回率
|
“在所有实际正类中,我们标记了多少?”
|
不可接受假负类时。
|
医疗筛查、入侵检测。
|
|
F1
|
“精确率与召回率的平衡如何?”
|
您同时在意正类捕获与误报。
|
处理类不平衡问题的早期模型选择。
|
在 Python 中计算精确率与召回率
在 Python 中有多种方式计算精确率、召回率与 F1 分数。下面我将介绍两种方法:直接套用公式,以及使用 scikit-learn 包中的专用函数。
使用公式计算精确率与召回率
如果您知道混淆矩阵中的数值,就可以直接用上文公式轻松算出指标。
TP = 120
FP = 60
FN = 80
TN = 9740
precision = TP / (TP + FP)
recall = TP / (TP + FN)
f1 = 2 * precision * recall / (precision + recall)
print(f"{'Precision':<10} {precision:.1%}")
print(f"{'Recall':<10} {recall:.1%}")
print(f"{'F1':<10} {f1:.1%}")技术支持
Precision	66.7%
Recall		60.0%
F1		63.2%技术支持
该代码的输出与我们先前的手算结果一致。
使用 scikit-learn 计算精确率与召回率
您也可以使用 scikit-learn 库直接从数据计算指标。下面的示例中,我们模拟 y_true 与 y_predicted。然后使用 precision_score(y_true, y_false) 方法计算精确率。同理计算召回率与 F1 分数。最后输出结果。
import numpy as np
from sklearn.metrics import precision_score, recall_score, f1_score
TP, FP, FN, TN = 120, 60, 80, 9740
y_true = np.array(TP * [1] + FP * [0] + FN * [1] + TN * [0])
y_pred = np.array(TP * [1] + FP * [1] + FN * [0] + TN * [0])
precision = precision_score(y_true, y_pred, zero_division=0)
recall = recall_score(y_true, y_pred, zero_division=0)
f1 = f1_score(y_true, y_pred, zero_division=0)
print(f"{'Precision':<10} {precision:.1%}")
print(f"{'Recall':<10} {recall:.1%}")
print(f"{'F1':<10} {f1:.1%}")技术支持
Precision	66.7%
Recall		60.0%
F1		63.2%技术支持
如预期,这些数值与我们之前的计算一致。
结语
虽然准确率是一个有用的起点,但它常常掩盖了理解模型为何失败所需的细节。精确率与召回率通过迫使您审视误报与漏检之间的权衡,为您提供更清晰的图景。
归根结底,选择合适的指标不仅是数学问题;它更是一个务实的决策,即您的系统能够承受哪一种类型的错误。
准备好构建您自己的机器学习模型了吗?从Machine Learning Fundamentals in Python 技能路径开始吧!


一个准确率达到 98% 的机器学习模型听起来很惊人——但真的是这样吗?当您处理欺诈或疾病这类罕见事件时,准确率往往会带来一种虚假的安全感。
这就是精确率与召回率发挥作用的地方。本文将探讨这两个指标如何超越简单的准确率,不仅衡量您有多常做对,更要看清楚您究竟是如何做错的。
如果您想走出理论、真正掌握分类问题,Fraud Detection in Python 课程是不二之选。
为何仅有准确率还不够
在大多数情况下,准确率是衡量统计或机器学习模型对某个标签预测效果的自然选择。它通过将正确预测的数量与观测总数进行比较来计算。
通常而言,如果一个模型能以较高的准确率稳定识别正确标签,那么它表现不错。然而,在类别不平衡的数据集中,当一个类别样本显著多于另一个时,准确率会被扭曲。这样的数据集在欺诈检测或疾病诊断中很常见。
假设一个模型以 98% 的准确率将交易分类为欺诈。乍一看,这个数很棒。但如果欺诈仅占数据集中 2% 的交易呢?在这种情况下,模型每次都选择“非欺诈”也能达到 98% 的准确率,却一个欺诈都抓不到,这显然不是我们想要的结果。
显然,这类情形需要更细致的指标。两个常用指标是精确率(precision)与召回率(recall)。
什么是精确率与召回率?
简而言之:
要理解如何计算这些指标,我们首先需要界定混淆矩阵中的术语。
真正类、假正类与负类
想象一家信用卡公司使用机器学习模型来检测欺诈交易。假设在 10,000 笔交易的样本中,有 9,800 笔为合法交易,200 笔为欺诈。
为了衡量模型的有效性,需要将“欺诈”或“非欺诈”中的一个指定为正类,另一个指定为负类。由于我们关注欺诈案例,因此将其标记为“正类”。(当然,这并不意味着从伦理角度看欺诈是正面的;“正类”标签仅表示我们所关注的那一类。)
当模型运行时,风险分数高于某个概率阈值(比如 70%)的交易会被认为是欺诈。将被预测为欺诈的案例与实际为欺诈的案例进行比较。
为了理清这些数据,我们使用以下命名方式。
第二个字母(P 或 N)表示预测为正或负,第一个字母表示该预测是真(T)还是假(F)。
“假正类”表示系统预测为正,但实际为负。例如,假负类则是被预测为负,实际却为正。
混淆矩阵
以上信息通常会展示在所谓的混淆矩阵中,它用于记录模型将错误预测与实际结果(FN、FP)混淆的频率。混淆矩阵帮助我们区分模型预测了什么以及实际发生了什么。我们的示例的混淆矩阵如下所示:
实际欺诈(实际正类)
实际合法(实际负类)
预测为欺诈(预测正类)
160 (TP)
300 (FP)
预测为合法(预测负类)
40 (FN)
9500 (TN)
现在,我们来看行和列的合计。行和表示总的预测数量,列和表示总的实际数量。
实际欺诈(实际正类)
实际合法(实际负类)
预测为欺诈(预测正类)
160 (TP)
300 (FP)
460 (TP + FP) 预测正类总数
预测为合法(预测负类)
40 (FN)
9500 (TN)
9540 (FN + TN) 预测负类总数
200 (TP + FN) 实际正类总数
9800 (FP + TN) 实际负类总数
10,000
这些合计代表什么?
什么是精确率?
精确率衡量正类预测的质量。它告诉我们被预测为正类的案例中有多少实际上为正类。
高精确率意味着很少出现误报。如果模型说某事为真,它大概率是真的。比如,若一款网络游戏要封禁作弊者,那必须确保是真的作弊。过多不应有的封禁会疏远合法用户并带来差评。
按上文术语,精确率等于真正类占预测正类的比例。
在上述示例中,精确率为 160/460,约 34.8%。
什么是召回率?
召回率衡量覆盖度。它展示了实际正类中有多少被预测为正类。定义为真正类占实际正类总数的比例。
以癌症的初步复查诊断为例。是宁可过度诊断还是宁可漏诊?大多数人会同意前者。
在早期筛查中,收到一次虚惊可能令人震惊;但在您确实患癌时被告知没有癌症却是灾难性的,尤其是可能因此错过挽救生命的治疗。
在上述示例中,召回率为 160/200,即 80%。
精确率与召回率的权衡
精确率和召回率之间存在此消彼长的关系。通常,精确率上升时,召回率会下降,反之亦然。
为了解其原因,让我们回到欺诈示例。
大多数欺诈被抓到了,但假正类很多。假设由于客户投诉,管理层决定将决策阈值从 0.7 提高到 0.8。要将交易标记为欺诈,现在必须至少达到 0.8 的分数,而不是 0.7。
这使模型更为保守。它更少预测为欺诈。被错误标记为欺诈的交易减少了,但代价是更多真实的欺诈漏网。阈值更改后,假正类从 300 降至 60,但假负类从 40 升至 80。
新模型的混淆矩阵如下所示:
实际欺诈(实际正类)
实际合法(实际负类)
预测为欺诈(预测正类)
120 (TP)
60 (FP)
180 (TP + FP) 预测正类总数
预测为合法(预测负类)
80 (FN)
9740 (TN)
9820 (FN + TN) 预测负类总数
200 (TP + FN) 实际正类总数
9800 (FP + TN) 实际负类总数
10,000
可以看到,在 180 个被预测为欺诈的案例中,120 个确为欺诈,因此精确率从 34.8% 提升到了 66.7%。
提高精确率的代价是召回率下降:200 个欺诈案例中有 120 个被预测为欺诈,召回率从最初的 80% 降至 60%。
该模型总体上抓到的欺诈变少了,但一旦标记为欺诈,置信度更高。这表明同时平衡这两个指标的重要性,我们稍后会讨论。
精确率-召回率曲线
为可视化精确率与召回率之间的权衡,数据科学家使用精确率-召回率(PR)曲线。
该图将精确率绘于纵轴、召回率绘于横轴,覆盖每一个可能的决策阈值(从 0 到 1)。当您降低阈值以捕获更多正类(提高召回率)时,必然会带来更多误报(降低精确率)。
“完美”的模型会达到右上角(100% 精确率与召回率),但在现实中,您必须在曲线上选择一个满足特定业务需求的点。
在我们的欺诈示例中,模型会为每笔交易输出一个欺诈分数。若交易分数至少达到阈值,就会被标记为欺诈。随着阈值降低,预测正类变多,通常会捕获更多真正类(召回率上升),但也会带来更多误报(精确率下降)。
来看实际中可能的情况。假设您的公司每天处理 10,000 笔交易。由于估计欺诈率为 2%,您预计每天有 200 笔欺诈交易。另假设欺诈运营团队每天可以人工审核 200 笔被标记的交易(预测正类)。
您评估了几个阈值,得到以下结果:
这条曲线告诉您,在给定召回率下可以“买到”的精确率是多少(或反之)。
何时使用精确率或召回率
由于二者存在权衡关系,正确的指标取决于您的具体用例。
何时关注精确率
精确率与假正类之间呈反比。因此,高精确率的模型能很好地区分真正类与假正类,它是可信的。
当假正类代价很高时,请优化精确率。典型情形包括:
何时关注召回率
同样地,召回率与假负类呈反比。假负类很多会导致召回率低。因此,高召回率的模型能很好地区分真正类与假负类,它是安全的。
如果避免漏掉真实案例比接受一些误报更重要,您应优先考虑召回率而非精确率。示例用例如下:
用 F1 分数平衡精确率与召回率
如果您不确定应优化精确率还是召回率,或者希望同时考虑两者,可以参考 F1 分数。
F1 分数定义为精确率与召回率的调和平均,当您想在两者之间取得平衡时使用。
当精确率与召回率相等时,F1 分数就等于该值。然而,如果两者之一接近于零,F1 也会非常低。
在上述示例中,精确率为 66.7%,召回率为 60%。按照上面的公式,我们得到 F1 分数约为 63.2%:
下表将 F1 分数与准确率、精确率、召回率进行了比较。
指标
它回答的问题
何时优化该指标
示例
准确率
“总体上我们有多常预测正确?”
类别均衡,且 FP 与 FN 的代价相近。
手写数字分类。
精确率
“在所有预测为正类的案例中,我们有多常是正确的?”
当假正类代价高、惩罚性强或会造成客户痛点时。
欺诈拦截、封禁用户、侵入性医疗操作。
召回率
“在所有实际正类中,我们标记了多少?”
不可接受假负类时。
医疗筛查、入侵检测。
F1
“精确率与召回率的平衡如何?”
您同时在意正类捕获与误报。
处理类不平衡问题的早期模型选择。
在 Python 中计算精确率与召回率
在 Python 中有多种方式计算精确率、召回率与 F1 分数。下面我将介绍两种方法:直接套用公式,以及使用
scikit-learn包中的专用函数。使用公式计算精确率与召回率
如果您知道混淆矩阵中的数值,就可以直接用上文公式轻松算出指标。
该代码的输出与我们先前的手算结果一致。
使用 scikit-learn 计算精确率与召回率
您也可以使用 scikit-learn 库直接从数据计算指标。下面的示例中,我们模拟
y_true与y_predicted。然后使用precision_score(y_true, y_false)方法计算精确率。同理计算召回率与 F1 分数。最后输出结果。如预期,这些数值与我们之前的计算一致。
结语
虽然准确率是一个有用的起点,但它常常掩盖了理解模型为何失败所需的细节。精确率与召回率通过迫使您审视误报与漏检之间的权衡,为您提供更清晰的图景。
归根结底,选择合适的指标不仅是数学问题;它更是一个务实的决策,即您的系统能够承受哪一种类型的错误。
准备好构建您自己的机器学习模型了吗?从Machine Learning Fundamentals in Python 技能路径开始吧!