什么是 Claude Sonnet 4.6?
Claude Sonnet 4.6 是 Anthropic 最新的大型语言模型(LLM)。它大幅侧重于 Agent 编程、计算机操作及其他 Agent 能力,相较于近期发布的旗舰模型 Claude Opus 4.6,它属于更轻量的模型。
这个看似小幅的更新在不久前或许会令人意外,但与近期节奏相符。我对版本号的理解是:Claude Sonnet 4.6 或许没有引入太多全新的独立功能,而是把近期推出的功能整合进 Sonnet 系列。
除了让此前仅限付费的功能向所有用户开放外,Claude Sonnet 4.6 的整体表现也较前代显著提升,同时仍保持与 Claude Sonnet 4.5 相同的 API 价格(输入/输出每百万 Token 分别为 $3/$15)。它已可通过 Claude 网页聊天界面与 API 即刻使用。
Claude Sonnet 4.6 的关键功能
Anthropic 此次发布的思路似乎是以 Sonnet 的价格提供接近 Opus 的旗舰性能。虽然这听起来雄心勃勃,但随后会看到的基准测试结果显示,这一目标已基本达成。
一个突出的例子是 Claude Sonnet 4.6 的计算机操作 Agent 能力:它在 OSWorld-Verified 上取得了相当亮眼的 72.5%。从下图可以看到,Sonnet 模型在不到一年的时间里将该分数提升了两倍多。
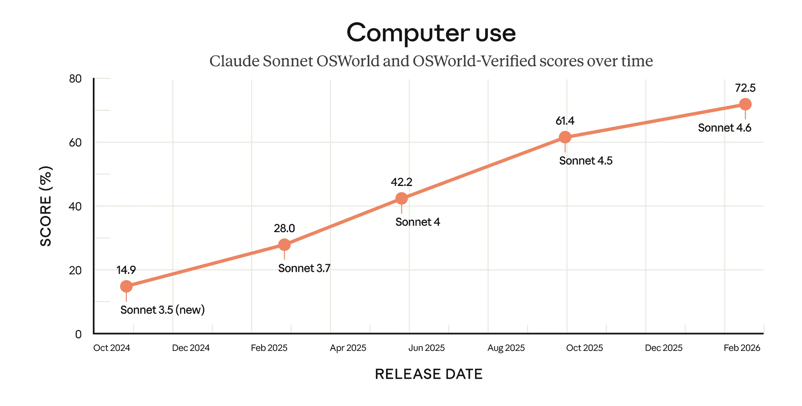
Claude Sonnet 各版本随时间的 OSWorld-Verified 分数 (来源:Anthropic)
下面来看新模型的几个亮点:
接近 Opus 的编程与推理能力
Claude Sonnet 4.6 在广泛任务上实现全面技能升级,包括:
- 编程
- 长程推理
- Agent 规划
- 知识性工作
- 设计
根据发布说明,Anthropic 发现 Beta 测试者在约 59% 的情况下更偏好使用 Sonnet 4.6 而非仅两周前还是旗舰的 Opus 4.5。
他们给出的理由包括更佳的指令遵循、更少的幻觉,以及更可靠的多步问题求解。
前沿级 Agent 能力与更强安全性
该模型在许多真实软件任务上展现出接近人类水平的能力,例如:
- 操作复杂的电子表格
- 多步网页表单
- 多标签页工作流
这在其出色的 OSWorld-Verified 分数以及我们稍后讨论的一些领域相关基准中都有体现。
模型开发的另一重点是安全性,这在向 Agent 化 AI 转变的过程中尤为重要。Anthropic 称,与 Sonnet 4.5 相比,Claude Sonnet 4.6 对提示注入的抵御能力显著提升,并与 Opus 4.6 大致相当。
长程规划
最吸引眼球的说法或许来自于扩展的上下文窗口,如今已达 100 万 Token。这让 Sonnet 4.6 能在一次请求中摄入更大的代码库、冗长的合同,或体量庞大的研究材料,并在该上下文中进行有效推理。扩展后的上下文窗口使 Sonnet 4.6 与 Google 的 Gemini 3 处于同一量级。
长程规划改进的一个例子是 Vending-Bench Arena,它测试模型在一段时间内运营模拟业务的能力,同时引入模型之间的竞争元素。通过在初期重投基础设施并在后期收获回报,Sonnet 4.6 将 Sonnet 4.5 在一年后的平均收益几乎提升了三倍。
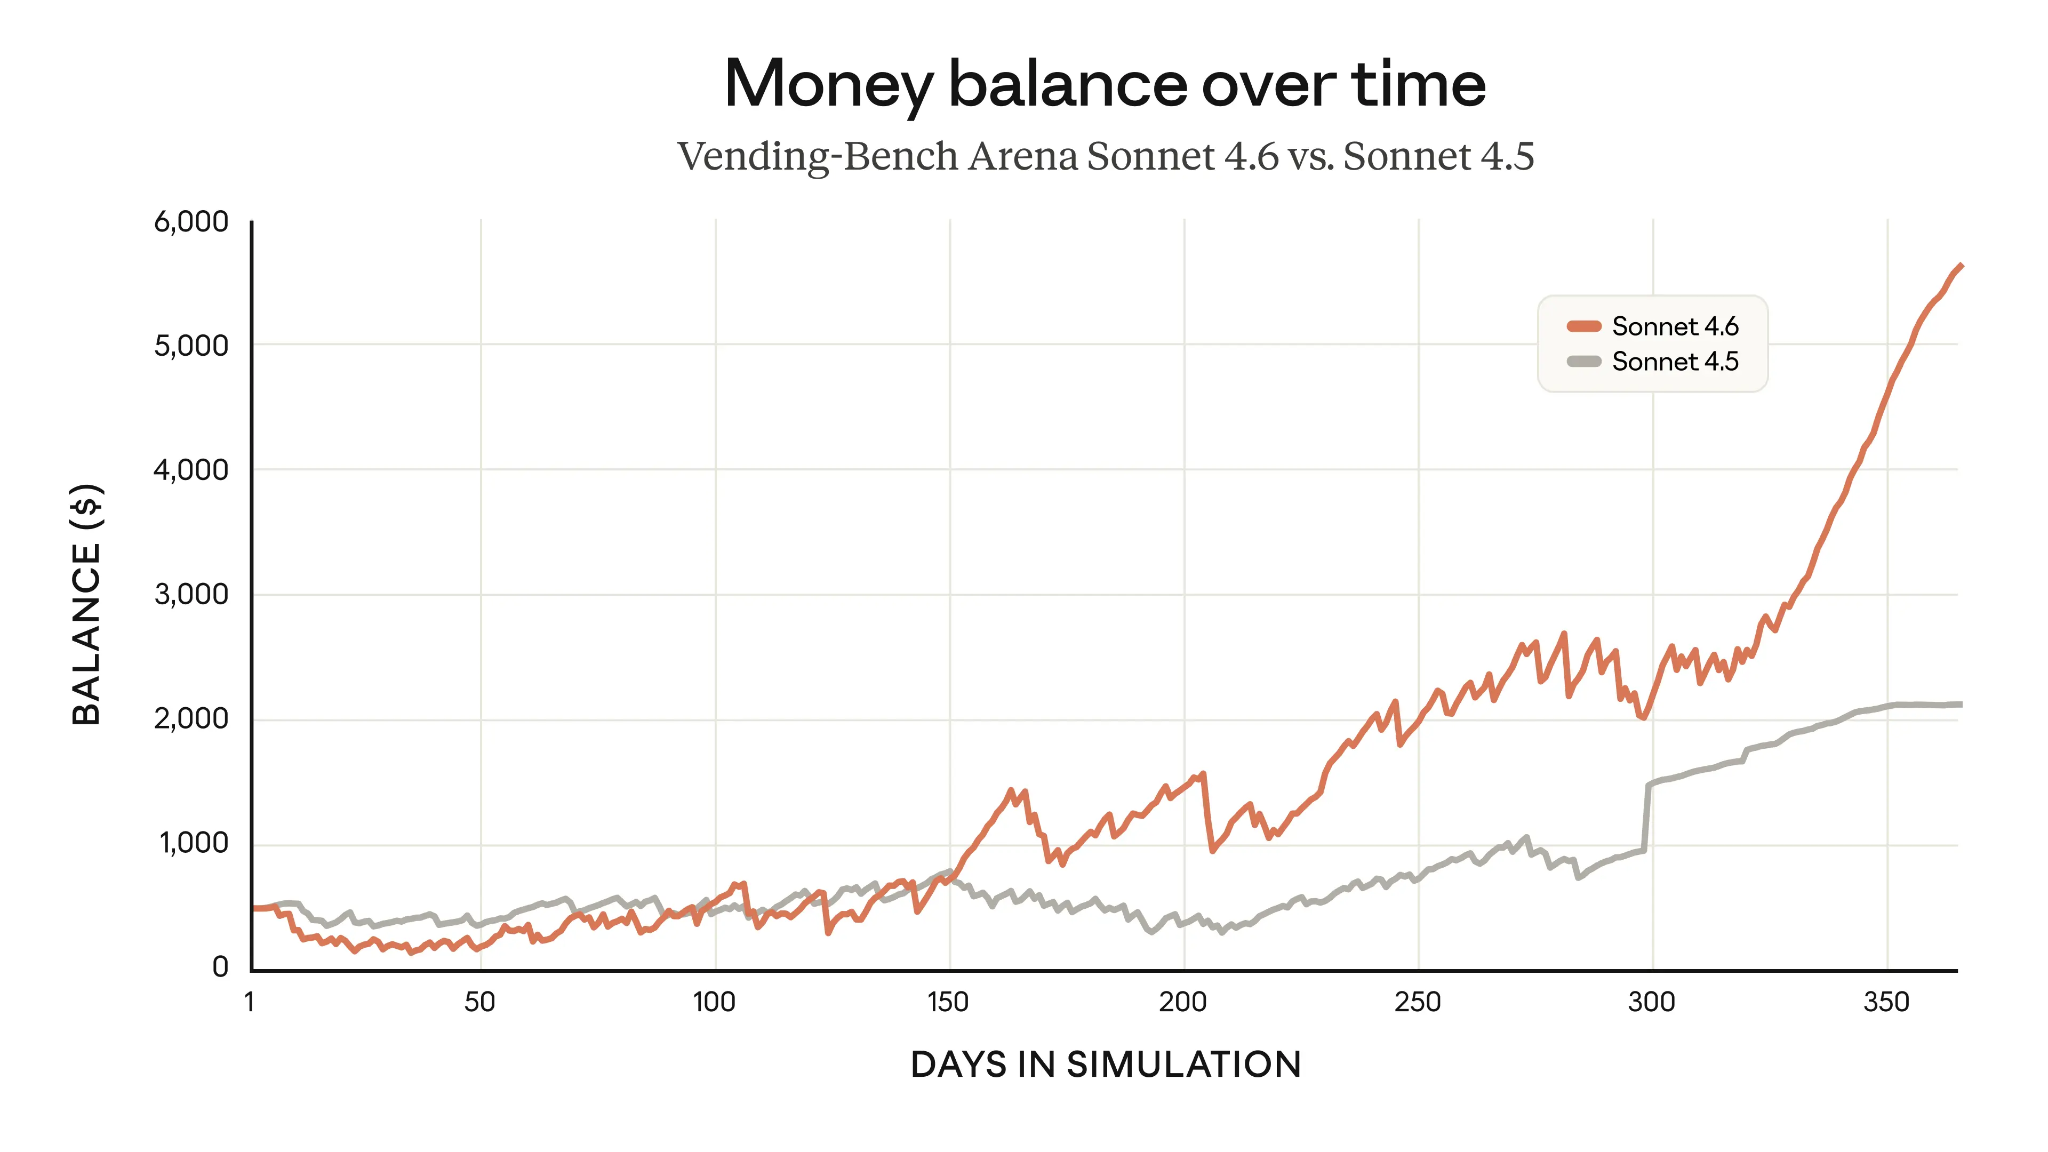
Claude Sonnet 4.6 vs 4.5 的 Vending-Bench 分数(来源:Anthropic)
先进的工作流增强
在 Claude 平台与 API 上,Sonnet 4.6 将此前仅限 Opus 或付费层的部分功能开放给所有用户免费使用。
自适应思考
随 Claude Opus 4.6 一同引入的一项实用功能是自适应思考。它让 Claude 能自动决定在回答前何时以及思考到何种程度。在 API 中,可通过设置 thinking: {type: “adaptive”} 启用。在网页聊天界面中,Sonnet 4.6 与 Opus 4.6 已默认内置。
连接器
连接器基于 MCP 提供集成,意味着它们可直接访问如 Google Workspace 与 Slack 等外部应用。这样,Sonnet 4.6 能在对话中获取并操作这些工具的实时数据。连接器最初仅面向付费层,但随着 Sonnet 4.6 成为默认模型,免费用户也可使用。
测试 Claude Sonnet 4.6
我想看看 Claude Sonnet 4.6 在我们用于《Claude Opus 4.6 指南》中的同一组任务上表现如何,以便直接比较。测试设计为多步任务,重点考察数学与代码相关推理。
测试 1:十六进制转十进制的逻辑谜题
第一个测试针对数学能力:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.我们先自行计算,以便核对结果是否正确:
- 第 6 个质数是 13。
- 13 的平方是 169。
- 169 的十六进制为 A9,包含 1 个字母与 1 个数字。
- 1 × 1 等于 1。
- 第 1 个质数是2。
此测试的思路在于用不同的计数逻辑与数字格式来混淆模型。与 Opus 4.6 一样,Sonnet 4.6 成功完成每一步并得出正确结论:
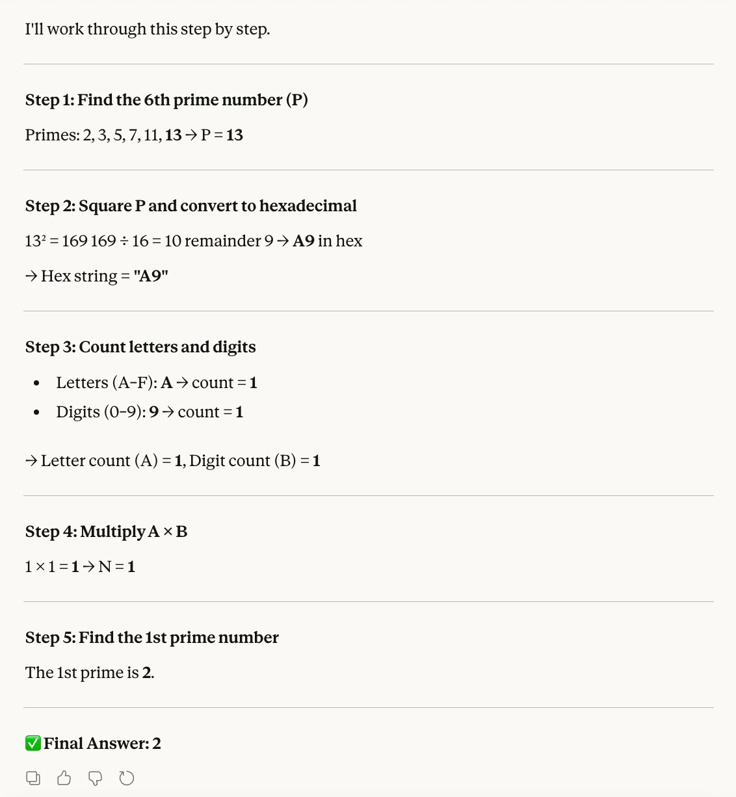
测试 2:矩阵旋转
下一个测试面向空间推理,这是许多 LLM 的公认弱点:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
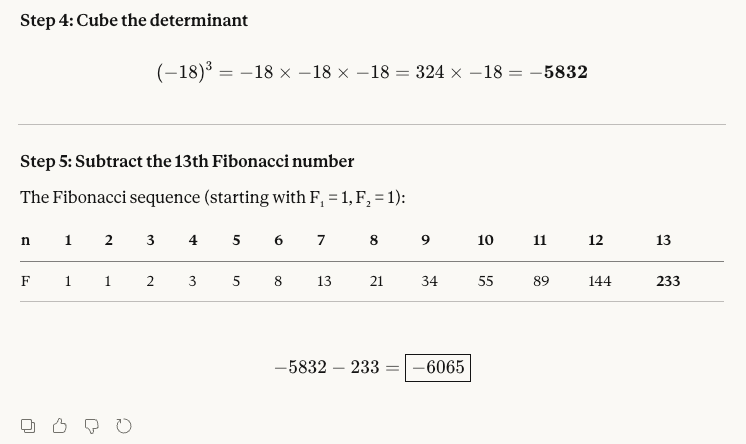
Step 5: Subtract the 13th Fibonacci number from the result.正确答案是 -6,065:
- 初始矩阵为 [[4, 2], [1, 5]]。
- 旋转后的矩阵为 [[1, 4], [5, 2]]。
- 行列式为两条对角线乘积之差,本例为 -18。
- -18 的立方为 -5,832。
- -5,832 - 233 等于-6,065。
Sonnet 4.6 处理这一任务没有问题。它能够理解矩阵的空间关系并正确旋转,对负数的处理也同样稳健:
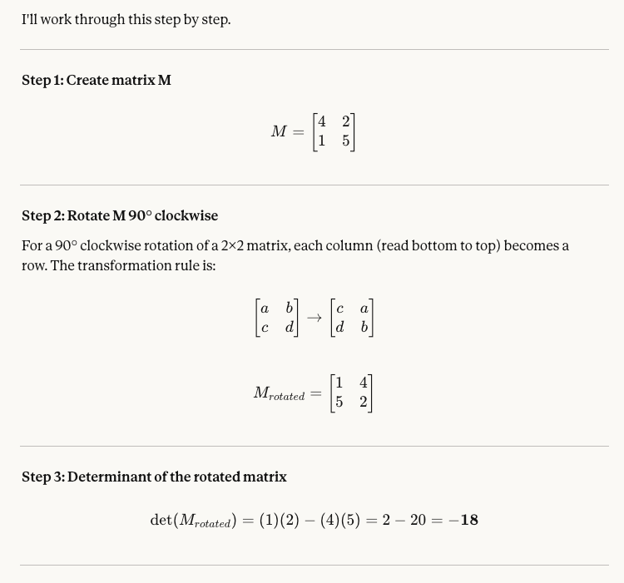
测试 3:代码调试
最后,我们来考察代码调试,这是 Sonnet 4.6 的强项之一。该测试用于检验模型在面对特定 Bug 时的上下文理解能力。
A developer wrote this Python function to compute a running average:
def running_average(data, window=3):
result = []
for i in range(len(data)):
start = max(0, i - window + 1)
chunk = data[start:i + 1]
result.append(round(sum(chunk) / window, 2))
return result
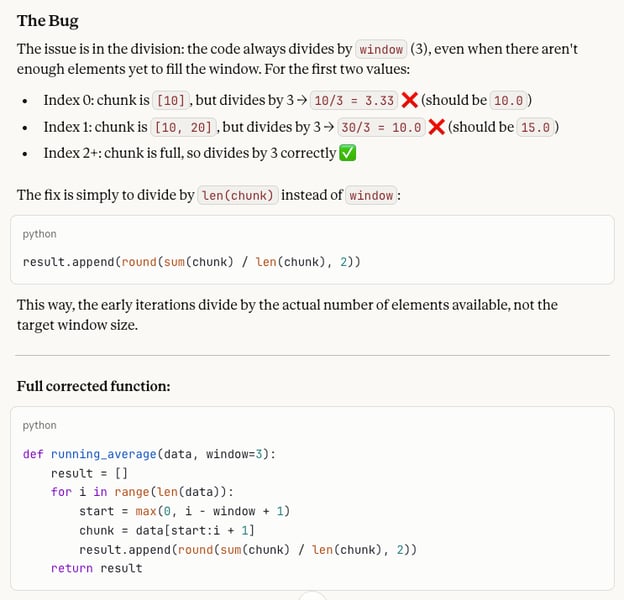
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!这段代码的问题在于函数始终用 window (3) 做除法,即便在列表开头的分段元素不足 3 个时也是如此。故障输出为 [3.33, 10.0, 20.0, 30.0, 40.0],但前两项应为 10.0 与 15.0,因为对应分段仅含 1 与 2 个元素,应分别以该数量做除法。因此,修复方法是用 分段长度来除,即 len(chunk),而不是 window。
这个测试巧妙之处在于瞄准了 LLM 的一处弱点:它们常能把循环执行得完美,却误以为输出就一定正确。原因是它们看到逐步计算均无报错,却未思考函数应当完成的目标。只有当模型能将函数目的与执行过程关联起来时,才能发现此类错误。
该模型再次通过测试。当然,这只是您可对模型进行的众多测试中的一小部分,但至少在这些示例中,Sonnet 4.6 的表现与 Opus 4.6 旗鼓相当。
Claude Sonnet 4.6 基准测试
随着近期模型更新频率之高,我们已经习惯了各大基准榜单前列的此起彼伏。尽管如此,Claude Sonnet 4.6 在多个LLM 基准上的初步成绩仍令人印象深刻,尤其考虑到它并非 Anthropic 的旗舰。
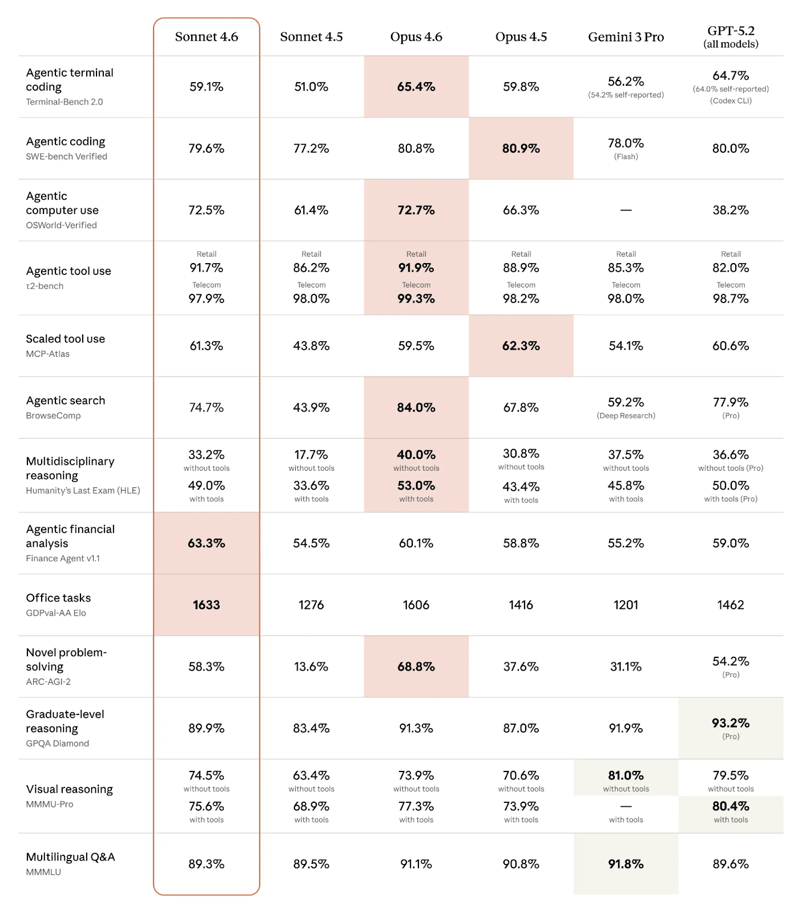
Claude Sonnet 4.6 与竞品的基准分数(来源:Anthropic)
从表中可见,Claude Sonnet 4.6 在 Agent 类基准中表现出色:
- Agent 计算机操作:OSWorld-Verified 分数为 72.5%,仅以微弱差距位列 Claude Opus 4.6(72.7%)之后,同时显著领先 OpenAI 新旗舰 GPT-5.3 Codex(64.7%)。
- Agent 编程:在 SWE-bench verified 中,Claude Sonnet 4.6 达到 79.6%。近期 Claude 与竞争模型总体都处于同一水平,分数大致收敛到 80% 左右。
- Agent 终端编程:相较 Sonnet 4.5 提升明显(Terminal-Bench 2.0 从 51% 升至 59.1%),但略落后于 Opus 4.6(65.4%),与 GPT-5.3 Codex(75.1%)仍有不小差距。
尤其值得注意的是,Anthropic 在特定领域相关的 Agent 任务上似乎跑在了前面:
- Agent 金融分析:在 Finance Agent v1.1 中,Claude Sonnet 4.6 以 63.3% 夺得第一,甚至超过 Opus 4.6(60.1%)。
- 办公任务:在 GDPval-AA 中,Sonnet 4.6 以 Elo 1633 名列第一,再次将 Opus 4.6(1606)置于第二。
如何使用 Claude Sonnet 4.6
您现在可以通过多种渠道使用 Claude Sonnet 4.6。具体方式如下:
聊天入口
Sonnet 4.6 可通过 Claude.ai 网页聊天界面、其 iOS 与 Android 应用,以及集成 Claude Cowork 的 macOS 桌面应用使用。
在这些平台上,它都是新的默认模型,甚至包括免费层。这意味着文件创建、连接器、技能与上下文压缩如今向所有用户开放。
API 访问
开发者可通过 Anthropic API 使用 Claude Sonnet 4.6,模型 ID 为 claude-sonnet-4-6。价格与前代保持一致:每百万输入 Token 收费 $3,每百万输出 Token 收费 $15。
在企业级部署方面,Sonnet 4.6 可在多种云平台上获取,如 AWS Bedrock 或 Google Vertex AI,各自采用定制定价。
编程工具
Claude Sonnet 4.6 现已为 Claude Code 提供动力,并成为 Pro 与 Team 层账户的默认模型,更高层级则默认为 Opus 4.6。若想了解可用它构建哪些内容,建议查看我们关于 Claude Code hooks 与 为 Claude Code 构建插件 的教程。
此外,Sonnet 4.6 也可搭配 IDE 与其他编码助手使用,如 Cursor 或 Roo Code。
Claude Sonnet 4.6 与 Opus 4.6 对比
在诸多领域,Sonnet 4.6 与 Opus 4.6 的差距微乎其微,几乎可视为平手。对许多 Agent 任务尤为如此,例如 Agent 编程、Agent 计算机操作与 Agent 工具使用。在 Agent 金融分析、办公任务与规模化工具使用上,Sonnet 4.6 甚至超越了 Opus 4.6。
不出意料,在重度推理或创意相关任务中,Opus 4.6 表现更佳,例如新颖问题求解与多学科推理。在 Agent 领域,Opus 4.6 在终端编程与搜索方面更胜一筹。
如何选择合适的 Claude 模型
对于大多数编程与 Agent 任务,尤其是指令遵循至关重要的场景,Claude Sonnet 4.6 更合适,因为它以显著更低的成本提供几乎相同的性能,且在速度上更具优势。
需要专家级推理或多 Agent 工作流的团队则应选择 Claude Opus 4.6。尤其在研究、复杂迁移或高风险专家工作中,Opus 4.6 表现卓越。
总结
伴随 Claude Sonnet 4.5,Anthropic 继续强调代码、Agent 与计算机操作。在相对前代实现巨大性能提升的同时,它也将连接器与自适应思考等功能带给所有用户,甚至包括免费层。
首批体验与基准成绩相当亮眼,且因在不大幅涨价的情况下提供(接近)Opus 级性能而颇具颠覆性。对于许多日常工作流而言,选择 Anthropic 的旗舰模型反而不太容易自洽。话虽如此,在涉及重度推理的任务上,Claude Opus 4.6 仍是更好的选择。
接下来值得关注的是,Claude Sonnet 4.6 能在各大基准榜首维持多久,以及 Anthropic 的竞争对手将如何应对此次发布。
本文中我们多次提到 Agent 任务。若您想进一步了解如何在此类工作流中使用像 Claude Sonnet 4.6 这样的模型,建议学习我们的 AI Agent Fundamentals 技能路径。
Claude Sonnet 4.6 常见问答
What is Claude Sonnet 4.6?
Claude Sonnet 4.6 是 Anthropic 最新的中阶 AI 模型,于 2026 年 2 月 15 日发布。它在编程、计算机操作、长上下文推理、Agent 规划、知识型工作与设计方面均有升级。其核心优势是在更低成本下逼近 Opus 4.6 的表现,适合日常使用、生产级工作流与复杂任务。
What are the key new features of Claude Sonnet 4.6?
Claude Sonnet 4.6 包含 100 万 Token 上下文窗口、自适应思考以实现动态推理,以及上下文压缩以延长有效上下文长度。它支持增强的计算机操作,可在无需 API 的情况下完成如浏览电子表格或网页表单等任务,并改进了工具集成,例如结合代码执行的网页搜索。
How does Claude Sonnet 4.6 perform in coding and benchmarks?
在 Claude Code 中,用户有 70% 的时间更偏好 Sonnet 4.6 而非 Sonnet 4.5,对比 Opus 4.5 的偏好为 59%。原因在于更好的指令遵循、更少的幻觉,以及对多步任务更稳定的表现。它在诸多 Agent 相关基准上表现出色,如 OSWorld(72.5%)与 SWE-bench Verified(79.6%),并在办公类 Agent 任务中位列第一。
How can I access Claude Sonnet 4.6?
Claude Sonnet 4.6 现已在所有 Claude 方案上线(免费层为默认),可于 Claude.ai、Claude Cowork、Claude Code 使用,也可通过 Anthropic API(模型 ID:claude-sonnet-4-6)与 Amazon Bedrock、GitHub Copilot 等平台使用。定价与 Sonnet 4.5 相同:每百万输入 Token 收费 $3、每百万输出 Token 收费 $15。
When should I use Claude Sonnet 4.6 vs Opus 4.6?
在大多数日常编程与自动化工作流中请优先选择 Claude Sonnet 4.6。它几乎与 Claude Opus 4.6 同等强大,但更快且便宜得多。当您需要高风险的专家级推理(GPQA 91.3%)、长上下文检索或复杂多 Agent 工作、且深度足以支撑更高成本时,再选择 Opus 4.6。
数周以来,人们都在等待 Claude Sonnet 5 的到来。相反,Anthropic 先发布了 Claude Opus 4.6,如今又带来了 Sonnet 系列模型的更新。
Claude Sonnet 4.6 将连接器、技能与上下文压缩带给所有用户,在 GDPval-AA 基准中名列前茅,并以亲民价格提供旗舰级性能。
尽管研发似乎侧重于 Agent 能力,但其承诺“对模型各项技能进行全面升级”,几乎覆盖所有相关领域。
该模型能否不负所望?在本教程中,我将展示 Anthropic 新模型的关键功能,并对其进行测试。
也别忘了阅读我们针对 Muse Spark 和 Qwen3.5 的指南,它们分别是 Meta 与阿里巴巴的新旗舰模型。