Last chance! 50% off DataCamp Premium
Sale ends in
想象您在给朋友讲一个很长的故事,但当说到笑点时才发现他们已经忘了开头。这种挫败感,正是当 AI 的“短期记忆”耗尽、不得不丢弃关键信息以腾出空间时会发生的事情。
在大型语言模型(LLM)的世界里,这种注意力跨度由上下文窗口来定义。
随着模型变得更强、上下文更大,理解这些窗口如何工作,便成为构建可靠、可扩展 AI 系统的关键。在本指南中,我们将介绍上下文窗口的基础知识、扩展它们的权衡,以及有效使用它们的策略。
若想走出理论,学习如何在真实的 Python 应用中管理上下文限制,请查看我们的课程 Developing LLM Applications with LangChain。
AI 模型的上下文窗口决定了它在生成回答时,工作记忆中可容纳的文本量。它限制了在不遗忘早期交互细节的情况下,一次对话能持续多长。
您可以将其视为人类的短期记忆。它会暂时存储先前对话中的信息,用于当前任务。
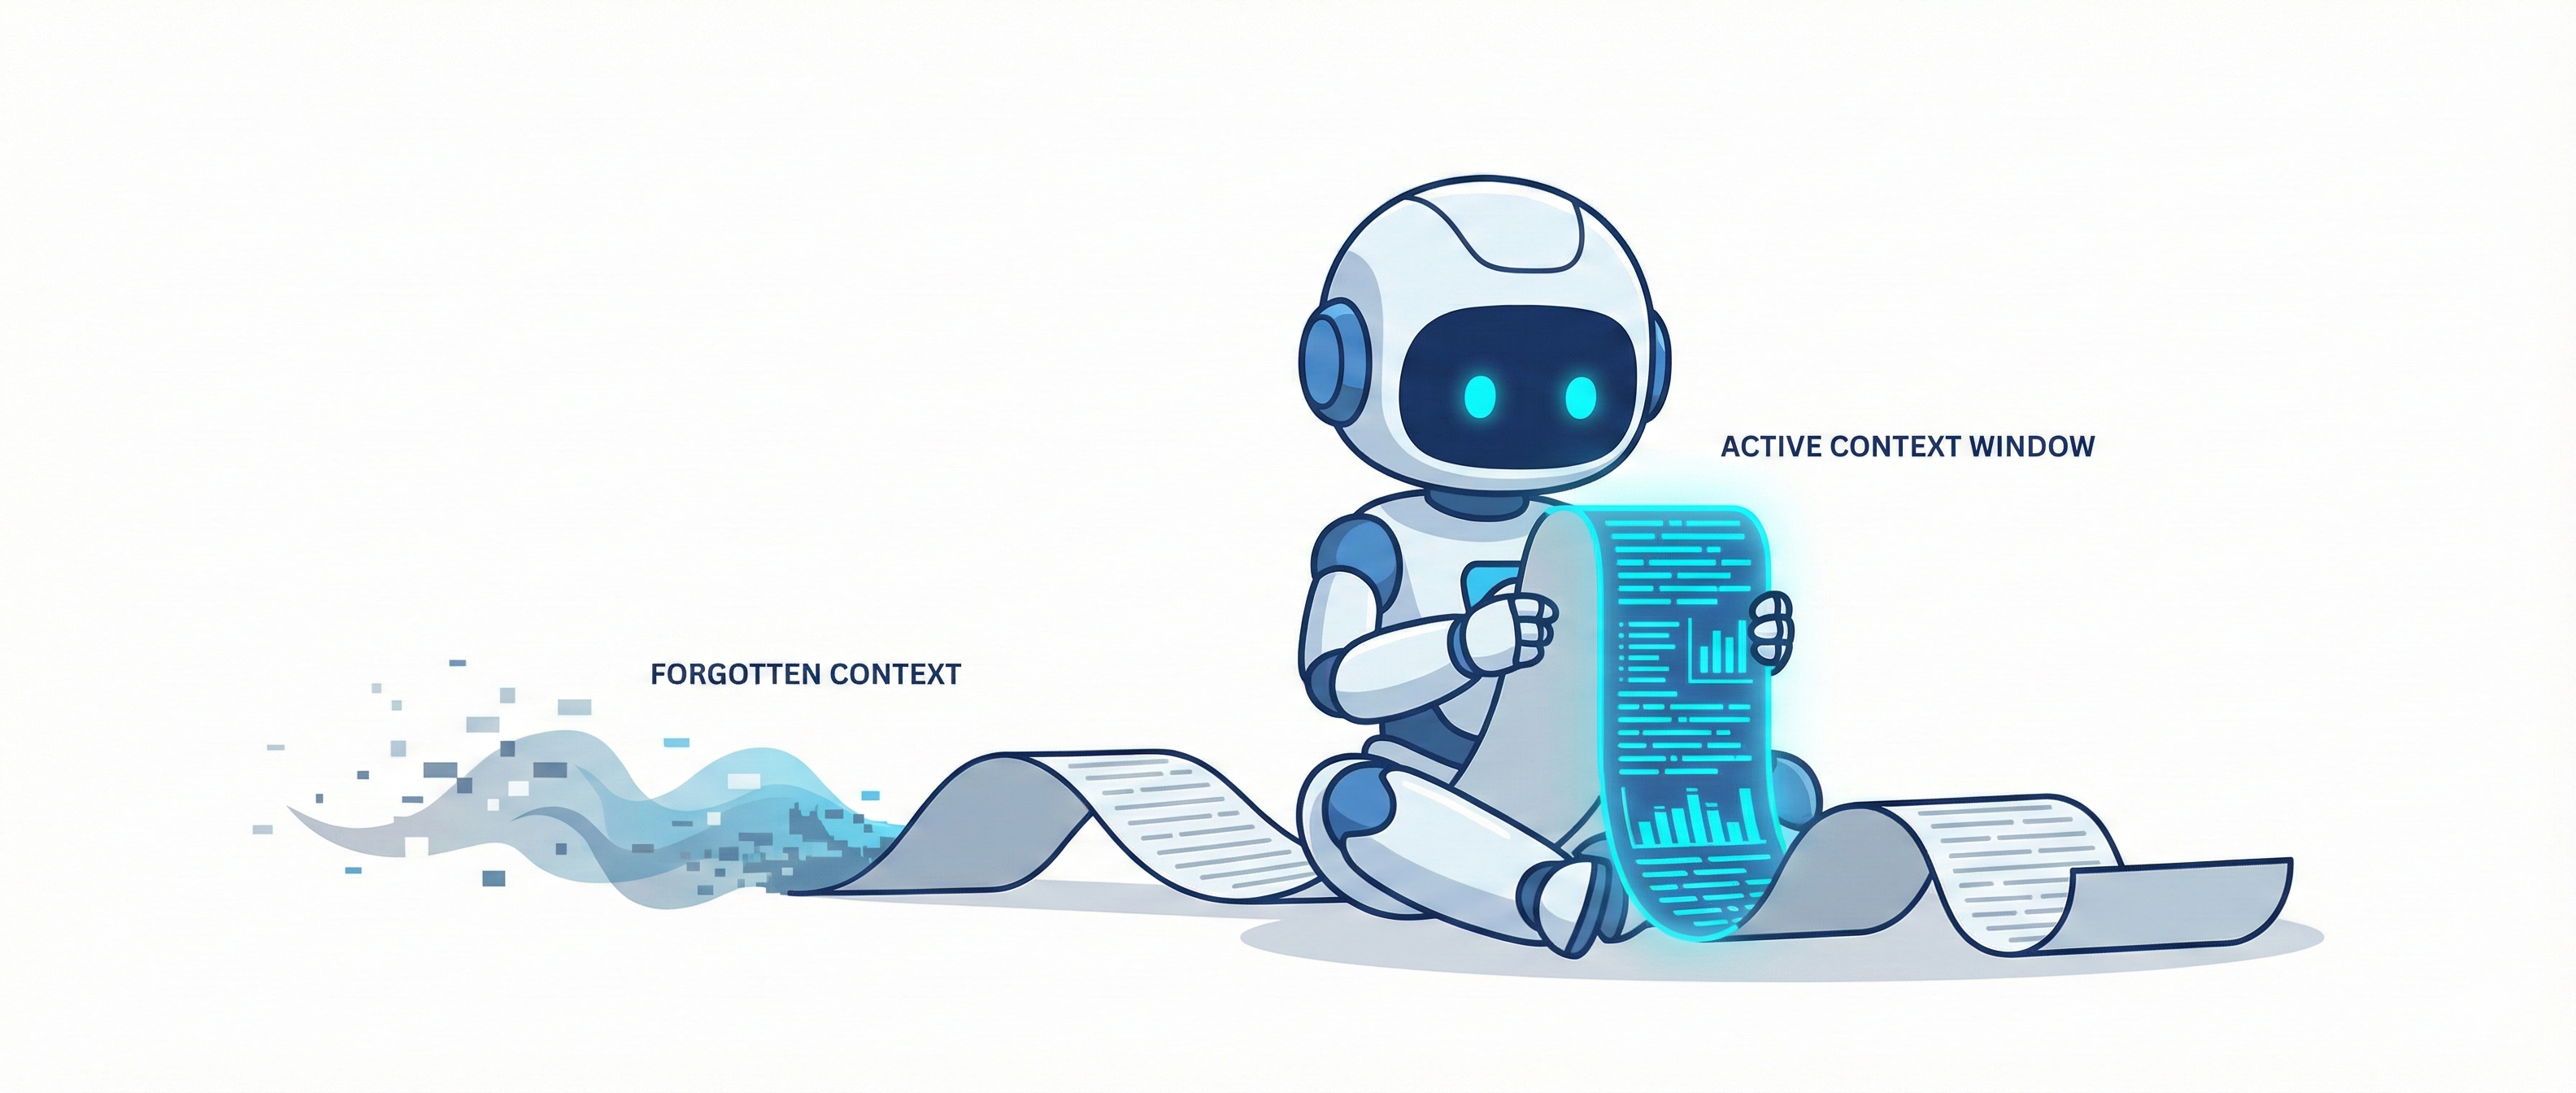
上下文窗口会影响诸多方面,包括推理质量、对话深度,以及模型有效个性化回复的能力。它还决定了模型一次能处理的最大输入规模。当提示或对话上下文超出该上限时,模型会截断(切掉)最早的文本部分以腾出空间。
为了更清楚地理解其含义,我们来看看 AI 模型和上下文窗口背后的几个基本概念。
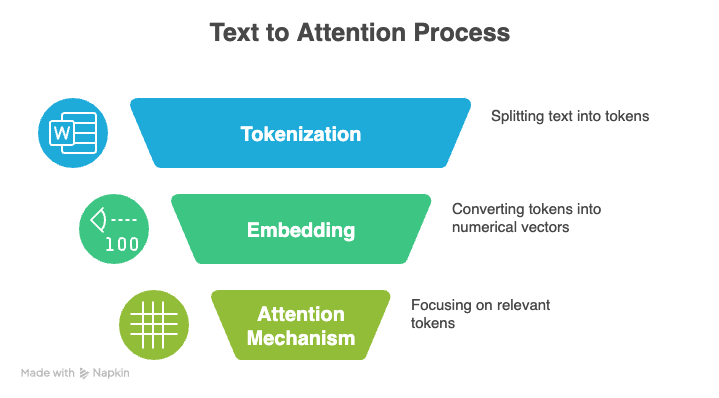
LLM 的三大核心概念是:分词(tokenization)、注意力机制(attention mechanism)和位置编码(positional encoding)。
分词是将原始文本转换为一系列更小单元(令牌,token)的过程,以便 LLM 进行处理。这些令牌可以表示完整单词、单个字符,甚至是部分音节。模型能够识别的全部唯一令牌统称为其词表(vocabulary)。
例如,句子“Hello, world”可能会被分词为 [“Hello”, “,”, “ world”]。
在训练或推理过程中,每个令牌会被映射为一个唯一整数,模型读取的是这些数字而非原始文本。它会分析这一数值序列,学习令牌之间的关系,并通过预测下一个最可能的令牌来生成新文本。
高效的分词对能装进模型上下文窗口的信息量影响很大。当分词器能用更少的令牌表示文本时,更多内容就能装进同一个窗口。
能将常见词或短语表示为单个令牌的分词器尤其有效,因为它们能减少令牌数量,使模型在上下文限制内处理更长的文档。
所谓的注意力机制是现代 LLM 的另一基础。它帮助模型在生成输出时聚焦输入中最相关的部分。
模型并不会一视同仁地看待每个令牌,而是将当前表示与序列中的所有其他令牌表示进行比较,并为每次比较分配一个得分。这种选择性加权让模型能够处理长序列,更有效地理解上下文。
注意力由三个组件构成:查询(Query)、键(Key)和值(Value)。
查询(Queries):当前令牌向序列其余部分发出的“搜索”信号,以查找相关信息。
键(Keys):序列中每个令牌的标识符,用于确定其与搜索信号的匹配程度。
值(Values):当查询与键匹配时被检索并使用的实际信息内容。
模型会计算查询与键之间的相似度分数,使用Softmax 激活函数将这些分数转换为权重,然后将值按权重求和得到最终输出。
自注意力会将当前令牌与序列中的每个令牌进行比较,这会产生二次方的计算成本:若将上下文窗口加倍,所需的计算与内存便会增加至四倍。
随着上下文窗口扩张,成本会迅速升高,因此模型会依赖稀疏注意力、低秩近似或分块等优化来控制计算量。
Transformer(驱动现代语言模型)并不天然理解令牌顺序,而是依赖位置编码来融入位置信息。
位置编码会为每个令牌添加一个小的信号,帮助模型理解距离与相对位置关系。
具体的位置信息方法也决定了模型在序列中能可靠追踪关系的距离,从而决定上下文窗口的大小和有效性。下面比较几种常见方法:
绝对位置嵌入:模型为序列中的每个位置学习一个独立向量,就像给每个令牌分配一个固定地址。它适用于短序列,但无法处理超出训练范围的位置,因而难以扩展上下文窗口。
正弦位置编码:使用重复的正弦和余弦波来编码位置,使每个令牌根据其位置拥有唯一的模式。与绝对嵌入相比,它对未见长度的泛化更好,但在极长序列中会变得不够稳定。
相对位置编码:不标注精确位置,而是学习令牌之间的距离。这有助于泛化到更长序列,但整体上下文上限仍取决于模型的架构与内存。
旋转位置嵌入(RoPE):RoPE 通过基于绝对位置旋转每个令牌的向量表示,并计算与其他令牌的距离来编码位置。该方法在序列变长时保持稳定,支持更大的上下文窗口。
ALiBi(Attention Linear Biases):在注意力机制中应用基于距离的简单偏置,使更近的令牌自然获得更高权重。它在长序列中具有良好的可扩展性。
建议您查看这篇关于Transformer 工作原理的教程以获取更详细的概览。
如果上下文超过上下文窗口,模型可能会截断或忽略最早的部分,从而丢失重要信息。这就是研究人员不断尝试新技术、推动这些边界并实现更长上下文窗口的原因。
直到 2022 年,OpenAI 的 GPT 模型一直占据主导地位。2018 年发布的首个 GPT 模型支持 512 令牌窗口。接下来在 2019 和 2020 年的两个版本各将该上限翻倍,GPT-3 达到 2,048 令牌。后续模型不断扩展边界,最高达到 100 万令牌(GPT-4.1)。
近来,OpenAI 已被竞争对手追平甚至超越。Google 的 Gemini 2.5 和 3 Pro 版本将窗口大小同样提升至多达一百万令牌,使一次性处理整本书、大型代码库和多文档工作负载成为可能。
Anthropic 的 Claude Sonnet 4.5 系列目前也在测试同样规模的上下文窗口(测试版),从最初的 20 万令牌扩展而来。
Llama、Mistral 等开源模型家族通常处于 10 万至 20 万令牌范围,在保持可本地部署或微调的前提下,提供可观的长上下文性能。
值得注意的例外包括 Llama Maverick,支持 100 万令牌窗口,面向跨长文档的一般性推理。而 Llama Scout 则进一步突破,达到惊人的 1,000 万令牌容量,专为一次性处理整个代码库或法律档案而设计。
然而,就在本周发布的 GPT-5.2 显示出策略上的转变。OpenAI 没有一味追求无限上下文,而是将其最新旗舰限制在 40 万令牌窗口,以“完美回忆”和更强推理能力换取纯粹的规模,避免大型模型常见的分心问题。
上下文窗口大小的差异会影响模型在真实工作流中的表现。扩展的上下文窗口能提升模型的准确性、一致性和长程推理能力,但也需要更多计算,并且更依赖谨慎的上下文选取。
中等规模的模型更高效,仍能处理长文档与较长对话,但面对超大输入时需要合理的结构化处理。
以下用例展示了大上下文窗口模型在真实应用中的优势。
当模型有足够空间一次性容纳完整报告、转录、代码库或论文时,它可以跟踪模式、连接远距细节,并从始至终保持连贯理解。这带来了众多应用领域:
法律:大窗口使模型能够分析完整合同、对比多份文档中的条款,并跟踪隐藏在长文档中的引用。
医疗:团队可以审阅冗长的临床指南、患者病史或多研究数据集,同时保留小窗口会遗漏的重要上下文。
科研:大窗口模型能一次性阅读完整论文与综述,并揭示只有在通篇可见时才会浮现的联系。
更大的上下文窗口让对话式 AI 更自然,因为模型能记住更多对话内容,而不至于遗忘更早的消息。
在客户服务中,这带来了更顺畅、更个性化的互动。模型可以利用过往偏好和先前对话,给出更准确、相关的回复。
扩展上下文窗口通过为文本、音频和视觉提供足够的共同空间,支持跨模态的复杂推理,而非将它们各自独立处理。
当完整转录、视觉帧和相关文字资料都能装入同一窗口时,模型可以跨格式对比细节、跟踪关系,并构建统一的上下文理解。
这消除了在必须分块或摘要时出现的信息缺口,并允许模型一次性对整个输入集合进行推理。
大上下文窗口解锁了强大的模型能力,但随着输入规模增长,也带来了新的性能挑战。即便是先进模型,也难以在极长序列中保持完美的注意力分配,因此并不总能像您期望的那样可靠地使用上下文的每个部分。
长上下文模型的常见问题之一是“中间丢失”效应。模型通常能较好地记住长序列的开头和结尾,但经常会遗漏或忽视埋在中间的重要细节。这可能导致答案变弱,即使完整上下文都在。
针对重要任务,合理地组织输入有助于避免这一问题。这意味着将内容拆分为清晰的部分,或重复关键点,以免模型忽略它们。
随着上下文窗口变大,成本会快速增加。每增加一个令牌,都会扩大注意力计算规模,从而提高推理时间、GPU 内存需求以及整体系统负载。
为此,需要更有效的方式向模型提供信息。诸如选择性检索、分级分块或快速摘要等技术有助于保持输入更小,避免模型超载。
大窗口也带来了安全与隐私方面的担忧。提供更多输入,意味着暴露敏感数据的概率更高。
因此,团队需要完善的数据处理规范、脱敏步骤和访问控制,以确保大上下文窗口不会带来新的风险。
在很多情况下,不必要或关联度低的信息会增加模型的认知负荷,提升幻觉与错误模式的风险。冗长输入也会引入噪声,扭曲模型对任务的理解。
在实践中,高质量表现往往源于精心策划的上下文,确保模型看到的是正确的信息,而非仅仅是更多的信息。
可采用多种方法以最优化地使用上下文窗口,其中包括检索增强生成(RAG)、上下文工程、分块与模型选型。
检索增强生成(RAG)的工作方式是:在需要上下文时,从外部数据库中提取附加信息并提供给模型。
RAG 并不会把整份文档塞进上下文窗口,而是将所有内容分别存储,仅检索与当前问题相关的部分。这既保持上下文精简,又能让模型获取所需信息。
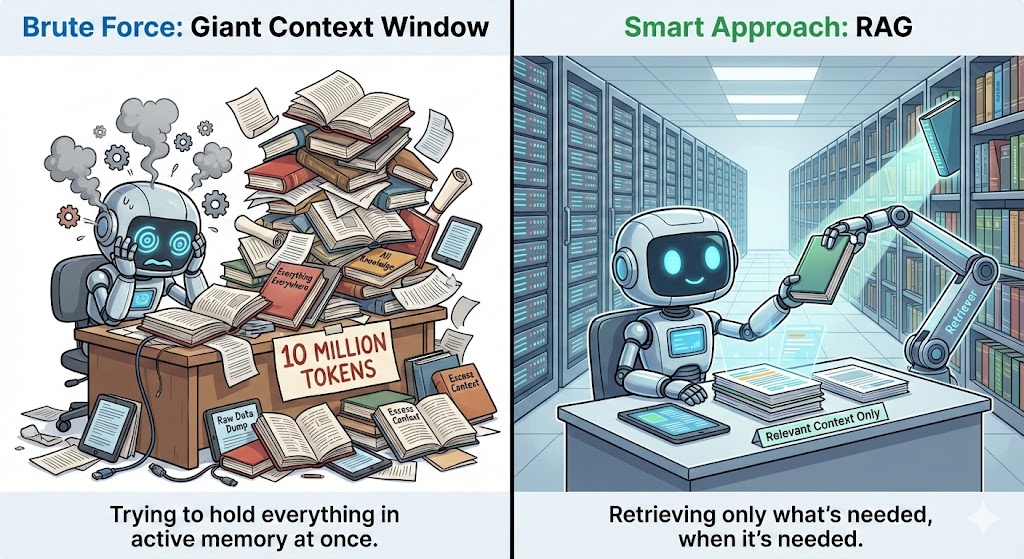
其具体做法是使用嵌入或向量搜索来找到最相关的片段,并以干净、结构化的方式把这些片段发送给模型。这样通过引入训练数据之外的相关信息来提高准确性。
上下文工程的重点是提供相关信息,而不是用不必要的细节压垮模型。有效策略包括对长文档进行分段、总结价值较低的部分,并使用轻量级预处理来突出要点。
语义搜索可帮助识别与当前查询相关的文本。您还可以通过将关键信息移到上下文的开头或结尾来改进结果,因为模型更容易记住这些位置。
分块会将长文档拆分为更小且连贯的部分。其思想是基于主题、结构或所支持的任务来对内容进行归组。
这能保持每个块的连贯性,帮助模型集中注意力,而不是迷失在巨大文本块中。若想了解更多,欢迎查看这篇关于高级分块策略的文章。
语义分块会将具有相似含义的句子归为一组,而不是在任意字符限制处切分。它会在自然的断点(如话题切换、段落过渡或节标题)进行拆分。
基于任务的分块更进一步,会围绕您试图回答的具体问题来组织每个块。这样每一部分仅包含与该任务真正相关的信息。
涉及整篇文档分析、多文件推理或长时对话的任务,适合使用上下文窗口在 20 万至 100 万范围的模型。对于更聚焦的任务,如摘要、代码审查或短问答,10 万至 20 万范围的模型通常在速度、成本与准确性之间提供更佳平衡。
更小的窗口在强大的检索系统加持下仍能有出色表现。优秀的RAG 系统或 Model Context Protocol(MCP) 可以按需拉取正确的信息,使模型无需把一切都装进记忆。
在收尾之前,让我们看看与上下文窗口相关的技术正走向何方。
未来的模型架构正从固定大小窗口转向动态上下文窗口。
研究者正在探索将 Transformer 的优势与新的长程记忆系统相融合的方法,从而让模型在不只依赖注意力机制的情况下,进行存储与回忆。
这些架构通过从静态上下文窗口转向会随任务增长的动态记忆层,来突破当下的限制。
记忆系统也是创新的另一个方向。未来的模型预计会更多依赖超越单次会话、可随时间提供连续性的上下文感知记忆系统。
这些系统不会把每次对话都当作重新开始,而是将关键偏好、过往决策和反复出现的主题存储在结构化的记忆层中,并在相关时予以调用。
这会将个性化从被动转为主动,让模型更全面地理解用户,并以更高的一致性支持长周期目标。
外部检索也在演进。目前,RAG 的工作方式类似搜索引擎,将相关文本拉入提示中。诸如纠错检索增强生成(CRAG)等高级版本已经出现,但这只是开始。
未来,检索将更像内建能力,几乎就像模型拥有自己的外部记忆。它们会在最少用户干预下,自动收集、压缩并再次呈现信息。
持久化记忆也将改变我们与 AI 的交互方式。模型不会在会话结束后把一切都忘掉,而是会在数天、数周甚至数月间记住重要细节。随着它了解您的风格、习惯与优先级,它可以提供更贴合、更有帮助的回应,而无需您反复重述。
工具如 Mem0 已经在开创这一方法,充当应用与 LLM 之间的专用记忆层。不过展望未来,我们预计这些能力会更多地直接内置于模型架构中,而非依赖外部层。
更大的窗口解锁了全新的强大工作流,但当上下文超载时,也会带来注意力分配挑战、更高计算成本与质量风险。因此,战略性地管理上下文至关重要。
诸如检索增强、语义分块与上下文工程等技术,能在能力不断扩展的同时,帮助模型保持专注、高效与可靠。
展望未来,最佳的 LLM 系统将结合智能工具与对上下文如何影响推理的深刻理解。通过应用这些原则,团队既能获得长上下文模型的优势,也能为进一步突破上下文边界的下一代架构做好准备。
将您的 Python 基础更进一步,参加 Developing Large Language Models 技能路径。该路径旨在引导您从基础代码出发,构建并微调您自己的强大 AI 应用。
LLM 课程
{count, plural, other {课程}}
{count, plural, other {学习路径}}
{count, plural, other {课程}}