本周,Anthropic 和 OpenAI 双双带来新版本,但两者发布所处阶段并不相同。
GPT-5.6 已经亮相,但仍处于受限预览中。虽然 GPT-5.6 尚未普遍可用,Claude Sonnet 5 则已于今日发布,并在所有 Claude 套餐中上线——且当前的 API 试运行价甚至低于 GPT-5.6 的中端型号 Terra。
以下是我们已知的各模型信息、它们的对比,以及数据的交叉点。
什么是 Claude Sonnet 5?
Claude Sonnet 5 是 Anthropic 最新的中端模型,被定位为迄今为止最具代理能力的 Sonnet。官方宣称,它在规划与工具使用方面大幅缩小了与 Opus 级模型的差距,同时维持了更具优势的价格。
Anthropic 表示,Sonnet 5 在推理、编码与工具使用上相较 Sonnet 4.6 有显著提升;在多项代理型评测中(包括 BrowseComp〔代理式搜索〕和 OSWorld-Verified〔计算机使用〕),其表现已与 Opus 4.8 相当接近。
Opus 4.8 依然在原始准确率上领先,尤其是在高或最高努力设定下,但 Sonnet 5 为开发者提供了更强的性价比选择。Anthropic 的中端模型一向在新世代发布、而下一版 Opus 尚未追上的窗口期内,展现出“越级”表现。似乎已经是很久以前的事了,但在 2024 年,Claude Sonnet 3.5 实际上在多个基准上超越了较早的 Claude Opus 3。
Sonnet 5 也采用了更新的分词器,这意味着相同输入文本可能会映射为更多的 token(大约为原先的 1.0–1.35 倍,取决于内容)。
什么是 GPT-5.6?
GPT-5.6 不是单一模型,它是一个包含三款模型的家族,并采用了新的命名规则:数字代表代际,名称代表能力层级:
-
Sol 为旗舰款。它是唯一可使用两项新控制的层级:max 推理努力设定,以及可将任务分配给子代理池的 ultra mode。
-
Terra 是日常型、均衡的模型——在整体质量上大致可与 GPT-5.5 相当,但价格约为其一半。
-
Luna 是低成本层级,面向对延迟敏感的工作负载。
随着这一消息,OpenAI 强调了在编码、生物学与网络安全方面的进步。最受关注的是其在多个有趣基准上的表现,特别是 Terminal-Bench 2.1,同时还包括长周期基因组学基准 GeneBench v1,以及两个漏洞利用开发基准(ExploitBench 与 ExploitGym)。
Claude Sonnet 5 与 GPT-5.6 基准对比
从双方的发布来看,Sonnet 5 与 GPT-5.6 并没有一项同时公布了双方数据的共同基准。
尽管 Anthropic 在发布博文与系统卡片中公布了部分 Sonnet 5 的硬性数据,OpenAI 目前仅确认了 GPT-5.6 在一个基准上的分数:Terminal-Bench 2.1。以下是双方各自“公开在案”的数据,统一列示如下:
| 基准 | Claude Sonnet 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna |
|---|
| Terminal-Bench 2.1 | 未公布 | 88.8% | 91.9% | 82.5% | 84.3% |
| SWE-bench Pro | 63.2% | 未公布 | — | 未公布 | 未公布 |
| OSWorld-Verified(计算机使用) | 81.2% | 未公布 | — | 未公布 | 未公布 |
| Humanity's Last Exam(含工具) | 57.4% | 未公布 | — | 未公布 | 未公布 |
Terminal-Bench 2.1 是 GPT-5.6 唯一公布成绩的一行,而 Sonnet 5 在该项上尚无公开分数。也许这是策略性的选择,因为 GPT-5.6 的成绩表现不俗。
在 Sonnet 5 有数据的那些基准上——SWE-bench Pro、OSWorld-Verified、Humanity's Last Exam——GPT-5.6 尚未公布结果,因此暂无可直接对照之处。
坦率地说,完整的 Sonnet 5 对比 GPT-5.6 的基准对比目前尚不存在。两家公司公布的是不同的评测集。
拉远视角:各模型在更广泛赛场中的定位
既然 Sonnet 5 与 GPT-5.6 并未直接重叠,值得退一步,观察它们各自已公布分数与其他模型——Opus 4.8、已停用的 Fable 5、GPT-5.5 与 Gemini 3.1 Pro——之间的对位关系。这并不能直接判定 Sonnet 5 vs. GPT-5.6,但能显示它们相对于同一组竞品所处的位置:
| 基准 | Claude Opus 4.8 | Claude Fable 5(停用前) | GPT-5.5 | Gemini 3.1 Pro | GPT-5.6 Sol Ultra |
|---|
| Terminal-Bench 2.1 | 78.9% | 83.4% | 88.0% | 70.7% | 91.9% |
| SWE-bench Pro | 69.2% | 80.3% | 58.6% | — | 未公布 |
| Humanity's Last Exam(无工具) | 49.8% | 59.0% | — | 44.4% | 未公布 |
几点观察:在 Terminal-Bench 2.1 上,GPT-5.6 Sol Ultra 的 91.9% 高于记录在案的所有 Claude 模型,包括 Opus 4.8 的 78.9%。因此,当 OpenAI 夸耀 GPT-5.6 在 Terminal-Bench 2.1 的分数时,并非言过其实。
即便被停用,Fable 5 在 SWE-bench Pro 与 Humanity's Last Exam 上仍领先于 Opus 4.8 和 GPT-5.5。其成绩至今尚无人超越,包括 GPT-5.6(其尚未公布 SWE-bench 或 HLE 的可比分数)。Sonnet 5 在 SWE-bench Pro 上的 63.2%(见上表)会高于 GPT-5.5 的 58.6%,但低于 Opus 4.8 与 Fable 5——这只是非常粗略的对照,因为跨的是不同代际、且分别来自两家公司的表格。
Claude Sonnet 5 与 GPT-5.6 定价
| 模型 | 输入(每 100 万 token) | 输出(每 100 万 token) |
|---|
| Claude Sonnet 5(试运行价,至 2026 年 8 月 31 日) | $2.00 | $10.00 |
| Claude Sonnet 5(标准价) | $3.00 | $15.00 |
| GPT-5.6 Sol | $5.00 | $30.00 |
| GPT-5.6 Terra | $2.50 | $15.00 |
| GPT-5.6 Luna | $1.00 | $6.00 |
按标价来看,Sonnet 5 的试运行价介于 GPT-5.6 的 Terra 与 Luna 之间,且远低于 Sol。不过更有意思的是这一试运行价本身:在 $2/$10 的价位,Sonnet 5 实际上低于 GPT-5.6 Terra 的 $2.50/$15,至少在夏季之前的涨价生效前如此。
需要说明的是,定价并非简单的“掰指头”算术那么直接。Anthropic 指出,Sonnet 5 的试运行价经过校准,以在新分词器带来更高 token 计数的情况下大体保持成本中性。而 OpenAI 则为 GPT-5.6 及更高版本引入了更可预测的提示缓存:写入缓存按未缓存输入费率的 1.25 倍计费,读取缓存继续享受 90% 的折扣。
为何不从第一天就直接设定标准价,而是以折扣试运行价启动?分词器的解释覆盖了部分原因,但时机也与我们观察到的市场态势相吻合:赛道拥挤且变化迅速。就在过去几周,Sakana AI 发布了 Fugu,这是一款在前沿模型池中编排路由的系统,声称以极低成本接近 Anthropic 自家的 Mythos 级系统。将 Sonnet 5 的价格定在 8 月底前的 $2/$10,使 Anthropic 在 GPT-5.6 仍被预览锁定之际,拥有一款真正廉价、且广泛可用的代理型模型可供用户选择。能以低价真正可用,本身就是不小的竞争优势。
Claude Sonnet 5 与 GPT-5.6 的可用性
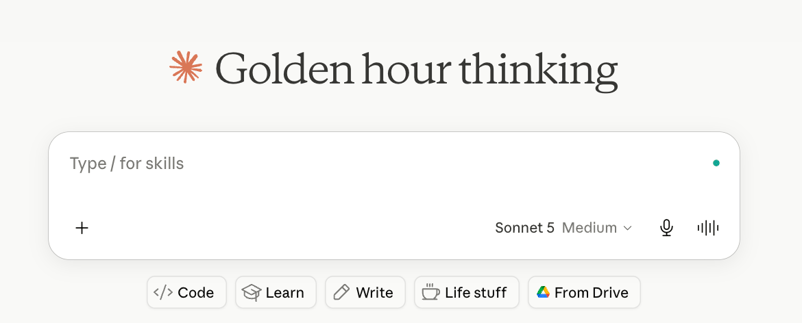
Claude Sonnet 5 今日起即在全球可用。它是免费版与专业版的默认模型,可在 Max、Team 与 Enterprise 计划中访问,并已在 Claude Code 与 Claude Platform 的 API 中上线(模型字符串 claude-sonnet-5)。您可能在看到公告前,就已经在聊天窗口里遇到 Claude Sonnet 5 了。
GPT-5.6 尚未普遍可用。预览期间,仅通过 API 和 Codex 向少数合作伙伴开放。OpenAI 表示更广泛的可用性即将到来,但尚未给出日期。
结语
在唯一重叠的基准上,GPT-5.6 的旗舰层级分数高于 Claude 当前的旗舰 Opus 4.8,这表明一旦 GPT-5.6 广泛发布,OpenAI 可能在能力上拥有真正的领先。但 Sonnet 5 严格来说并非 Sol 或 Terra 的直接能力对手——它是一款以“代理表现/成本”竞争的中端模型;在这方面,它可用、定价激进,而且今天就能用。


本周,Anthropic 和 OpenAI 双双带来新版本,但两者发布所处阶段并不相同。
GPT-5.6 已经亮相,但仍处于受限预览中。虽然 GPT-5.6 尚未普遍可用,Claude Sonnet 5 则已于今日发布,并在所有 Claude 套餐中上线——且当前的 API 试运行价甚至低于 GPT-5.6 的中端型号 Terra。
以下是我们已知的各模型信息、它们的对比,以及数据的交叉点。
什么是 Claude Sonnet 5?
Claude Sonnet 5 是 Anthropic 最新的中端模型,被定位为迄今为止最具代理能力的 Sonnet。官方宣称,它在规划与工具使用方面大幅缩小了与 Opus 级模型的差距,同时维持了更具优势的价格。
Anthropic 表示,Sonnet 5 在推理、编码与工具使用上相较 Sonnet 4.6 有显著提升;在多项代理型评测中(包括 BrowseComp〔代理式搜索〕和 OSWorld-Verified〔计算机使用〕),其表现已与 Opus 4.8 相当接近。
Opus 4.8 依然在原始准确率上领先,尤其是在高或最高努力设定下,但 Sonnet 5 为开发者提供了更强的性价比选择。Anthropic 的中端模型一向在新世代发布、而下一版 Opus 尚未追上的窗口期内,展现出“越级”表现。似乎已经是很久以前的事了,但在 2024 年,Claude Sonnet 3.5 实际上在多个基准上超越了较早的 Claude Opus 3。
Sonnet 5 也采用了更新的分词器,这意味着相同输入文本可能会映射为更多的 token(大约为原先的 1.0–1.35 倍,取决于内容)。
什么是 GPT-5.6?
GPT-5.6 不是单一模型,它是一个包含三款模型的家族,并采用了新的命名规则:数字代表代际,名称代表能力层级:
Sol 为旗舰款。它是唯一可使用两项新控制的层级:
max推理努力设定,以及可将任务分配给子代理池的ultra mode。Terra 是日常型、均衡的模型——在整体质量上大致可与 GPT-5.5 相当,但价格约为其一半。
Luna 是低成本层级,面向对延迟敏感的工作负载。
随着这一消息,OpenAI 强调了在编码、生物学与网络安全方面的进步。最受关注的是其在多个有趣基准上的表现,特别是 Terminal-Bench 2.1,同时还包括长周期基因组学基准 GeneBench v1,以及两个漏洞利用开发基准(ExploitBench 与 ExploitGym)。
Claude Sonnet 5 与 GPT-5.6 基准对比
从双方的发布来看,Sonnet 5 与 GPT-5.6 并没有一项同时公布了双方数据的共同基准。
尽管 Anthropic 在发布博文与系统卡片中公布了部分 Sonnet 5 的硬性数据,OpenAI 目前仅确认了 GPT-5.6 在一个基准上的分数:Terminal-Bench 2.1。以下是双方各自“公开在案”的数据,统一列示如下:
Terminal-Bench 2.1 是 GPT-5.6 唯一公布成绩的一行,而 Sonnet 5 在该项上尚无公开分数。也许这是策略性的选择,因为 GPT-5.6 的成绩表现不俗。
在 Sonnet 5 有数据的那些基准上——SWE-bench Pro、OSWorld-Verified、Humanity's Last Exam——GPT-5.6 尚未公布结果,因此暂无可直接对照之处。
坦率地说,完整的 Sonnet 5 对比 GPT-5.6 的基准对比目前尚不存在。两家公司公布的是不同的评测集。
拉远视角:各模型在更广泛赛场中的定位
既然 Sonnet 5 与 GPT-5.6 并未直接重叠,值得退一步,观察它们各自已公布分数与其他模型——Opus 4.8、已停用的 Fable 5、GPT-5.5 与 Gemini 3.1 Pro——之间的对位关系。这并不能直接判定 Sonnet 5 vs. GPT-5.6,但能显示它们相对于同一组竞品所处的位置:
几点观察:在 Terminal-Bench 2.1 上,GPT-5.6 Sol Ultra 的 91.9% 高于记录在案的所有 Claude 模型,包括 Opus 4.8 的 78.9%。因此,当 OpenAI 夸耀 GPT-5.6 在 Terminal-Bench 2.1 的分数时,并非言过其实。
即便被停用,Fable 5 在 SWE-bench Pro 与 Humanity's Last Exam 上仍领先于 Opus 4.8 和 GPT-5.5。其成绩至今尚无人超越,包括 GPT-5.6(其尚未公布 SWE-bench 或 HLE 的可比分数)。Sonnet 5 在 SWE-bench Pro 上的 63.2%(见上表)会高于 GPT-5.5 的 58.6%,但低于 Opus 4.8 与 Fable 5——这只是非常粗略的对照,因为跨的是不同代际、且分别来自两家公司的表格。
Claude Sonnet 5 与 GPT-5.6 定价
按标价来看,Sonnet 5 的试运行价介于 GPT-5.6 的 Terra 与 Luna 之间,且远低于 Sol。不过更有意思的是这一试运行价本身:在 $2/$10 的价位,Sonnet 5 实际上低于 GPT-5.6 Terra 的 $2.50/$15,至少在夏季之前的涨价生效前如此。
需要说明的是,定价并非简单的“掰指头”算术那么直接。Anthropic 指出,Sonnet 5 的试运行价经过校准,以在新分词器带来更高 token 计数的情况下大体保持成本中性。而 OpenAI 则为 GPT-5.6 及更高版本引入了更可预测的提示缓存:写入缓存按未缓存输入费率的 1.25 倍计费,读取缓存继续享受 90% 的折扣。
为何不从第一天就直接设定标准价,而是以折扣试运行价启动?分词器的解释覆盖了部分原因,但时机也与我们观察到的市场态势相吻合:赛道拥挤且变化迅速。就在过去几周,Sakana AI 发布了 Fugu,这是一款在前沿模型池中编排路由的系统,声称以极低成本接近 Anthropic 自家的 Mythos 级系统。将 Sonnet 5 的价格定在 8 月底前的 $2/$10,使 Anthropic 在 GPT-5.6 仍被预览锁定之际,拥有一款真正廉价、且广泛可用的代理型模型可供用户选择。能以低价真正可用,本身就是不小的竞争优势。
Claude Sonnet 5 与 GPT-5.6 的可用性
Claude Sonnet 5 今日起即在全球可用。它是免费版与专业版的默认模型,可在 Max、Team 与 Enterprise 计划中访问,并已在 Claude Code 与 Claude Platform 的 API 中上线(模型字符串
claude-sonnet-5)。您可能在看到公告前,就已经在聊天窗口里遇到 Claude Sonnet 5 了。GPT-5.6 尚未普遍可用。预览期间,仅通过 API 和 Codex 向少数合作伙伴开放。OpenAI 表示更广泛的可用性即将到来,但尚未给出日期。
结语
在唯一重叠的基准上,GPT-5.6 的旗舰层级分数高于 Claude 当前的旗舰 Opus 4.8,这表明一旦 GPT-5.6 广泛发布,OpenAI 可能在能力上拥有真正的领先。但 Sonnet 5 严格来说并非 Sol 或 Terra 的直接能力对手——它是一款以“代理表现/成本”竞争的中端模型;在这方面,它可用、定价激进,而且今天就能用。