Anthropic và OpenAI đều có bản phát hành mới trong tuần này, nhưng hai lần ra mắt đang ở những giai đoạn khác nhau.
GPT-5.6 đã được công bố, nhưng đang bị giới hạn trong bản xem trước hạn chế. Và trong khi GPT-5.6 chưa sẵn sàng cho số đông, Claude Sonnet 5 đã phát hành hôm nay và hoạt động trên mọi gói Claude — với mức giá API giới thiệu hiện tại thậm chí còn rẻ hơn mẫu tầm trung Terra của GPT-5.6.
Dưới đây là những gì chúng ta biết về từng mẫu, cách chúng so sánh và nơi các con số giao nhau.
Claude Sonnet 5 là gì?
Claude Sonnet 5 là mẫu tầm trung mới nhất của Anthropic, được giới thiệu là mẫu Sonnet có năng lực agentic mạnh nhất từ trước đến nay. Mục tiêu là thu hẹp phần lớn khoảng cách với các mẫu cấp Opus về lập kế hoạch và sử dụng công cụ trong khi vẫn giữ chi phí thấp hơn đáng kể.
Anthropic cho biết Sonnet 5 là bước tiến lớn so với Sonnet 4.6 về suy luận, lập trình và sử dụng công cụ, và hiệu năng của nó hiện ở mức khá gần với Opus 4.8 trong một số bài đánh giá mang tính agentic, bao gồm BrowseComp (tìm kiếm agentic) và OSWorld-Verified (sử dụng máy tính).
Opus 4.8 vẫn dẫn đầu về độ chính xác thuần, đặc biệt ở các mức nỗ lực cao hoặc cao nhất, nhưng Sonnet 5 mang đến cho nhà phát triển lựa chọn có tỷ lệ giá/hiệu năng mạnh hơn. Các mẫu tầm trung của Anthropic có tiền lệ cho thấy hiệu năng vượt tầm khi một thế hệ mới ra mắt trước khi bản làm mới Opus tiếp theo bắt kịp. Có vẻ như đã lâu, nhưng Claude Sonnet 3.5 thực tế từng vượt Claude Opus 3 trên một số điểm chuẩn vào năm 2024.
Sonnet 5 cũng dùng bộ tokenizer cập nhật, đồng nghĩa cùng một văn bản đầu vào có thể ánh xạ thành nhiều token hơn trước (khoảng 1,0–1,35 lần tùy nội dung).
GPT-5.6 là gì?
GPT-5.6 không phải một mẫu đơn lẻ. Đây là một họ ba mẫu, được tổ chức theo cách đặt tên mới: số chỉ thế hệ, tên chỉ bậc năng lực:
-
Sol là mẫu hàng đầu. Đây là bậc duy nhất có quyền truy cập hai điều khiển mới: thiết lập mức nỗ lực suy luận max và ultra mode, chế độ phân rã tác vụ cho một nhóm tiểu tác nhân.
-
Terra là mẫu cân bằng cho nhu cầu hằng ngày — tương đương gần với GPT-5.5 về chất lượng tổng thể với mức giá khoảng một nửa.
-
Luna là bậc chi phí thấp, nhắm vào tác vụ nhạy trễ.
Trong thông báo, OpenAI nhấn mạnh các cải thiện về lập trình, sinh học và an ninh mạng. Điểm nhấn lớn là hiệu năng trên một số điểm chuẩn thú vị, đáng chú ý nhất là Terminal-Bench 2.1, cùng với GeneBench v1 (điểm chuẩn hệ gen tầm xa), và hai điểm chuẩn phát triển khai thác lỗ hổng (ExploitBench và ExploitGym).
So sánh điểm chuẩn Claude Sonnet 5 và GPT-5.6
Theo các thông báo tương ứng, Sonnet 5 và GPT-5.6 không chia sẻ một điểm chuẩn chung nào có số liệu từ cả hai bên.
Dù Anthropic đã công bố một số con số cụ thể cho Sonnet 5 trong bài ra mắt và thẻ hệ thống, OpenAI đến nay mới xác nhận một điểm số duy nhất cho GPT-5.6: Terminal-Bench 2.1. Dưới đây là những gì đã được công bố từ mỗi bên, đặt cạnh nhau:
| Điểm chuẩn | Claude Sonnet 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna |
|---|
| Terminal-Bench 2.1 | Chưa công bố | 88,8% | 91,9% | 82,5% | 84,3% |
| SWE-bench Pro | 63,2% | Chưa công bố | — | Chưa công bố | Chưa công bố |
| OSWorld-Verified (sử dụng máy tính) | 81,2% | Chưa công bố | — | Chưa công bố | Chưa công bố |
| Humanity's Last Exam (có công cụ) | 57,4% | Chưa công bố | — | Chưa công bố | Chưa công bố |
Terminal-Bench 2.1 là hàng mục duy nhất GPT-5.6 đã công bố, trong khi Sonnet 5 chưa có điểm số để đưa vào. Có thể đó là chiến lược vì GPT-5.6 đạt kết quả tốt.
Ở các điểm chuẩn nơi Sonnet 5 có số liệu — SWE-bench Pro, OSWorld-Verified, Humanity's Last Exam — GPT-5.6 vẫn chưa công bố, nên chưa có gì để so sánh.
Kết luận thẳng thắn là một so sánh điểm chuẩn Sonnet 5 vs. GPT-5.6 thực sự vẫn chưa tồn tại đầy đủ. Mỗi công ty đã công bố một bộ đánh giá khác nhau.
Nhìn rộng hơn: vị trí của mỗi mẫu trong bức tranh chung
Vì Sonnet 5 và GPT-5.6 không trùng nhau trực tiếp, đáng để lùi lại và xem điểm số đã công bố của mỗi bên so với phần còn lại — Opus 4.8, Fable 5 (bị tạm dừng), GPT-5.5 và Gemini 3.1 Pro. Điều này sẽ không phân định Sonnet 5 vs. GPT-5.6, nhưng cho thấy vị trí của mỗi mẫu so với cùng một nhóm đối thủ:
| Điểm chuẩn | Claude Opus 4.8 | Claude Fable 5 (trước khi tạm dừng) | GPT-5.5 | Gemini 3.1 Pro | GPT-5.6 Sol Ultra |
|---|
| Terminal-Bench 2.1 | 78,9% | 83,4% | 88,0% | 70,7% | 91,9% |
| SWE-bench Pro | 69,2% | 80,3% | 58,6% | — | Chưa công bố |
| Humanity's Last Exam (không dùng công cụ) | 49,8% | 59,0% | — | 44,4% | Chưa công bố |
Một vài điểm: Trên Terminal-Bench 2.1, mức 91,9% của GPT-5.6 Sol Ultra vượt mọi mẫu Claude đã ghi nhận, bao gồm Opus 4.8 ở mức 78,9%. Vậy nên OpenAI không phóng đại khi tự hào về điểm số Terminal-Bench 2.1 của GPT-5.6.
Fable 5 vẫn dẫn trước Opus 4.8 và GPT-5.5 trên SWE-bench Pro và Humanity's Last Exam, ngay cả khi đang bị tạm dừng. Các con số này đơn giản là chưa bị vượt qua, bởi bất kỳ ai, bao gồm GPT-5.6 (chưa công bố điểm SWE-bench hay HLE để so sánh). Mức 63,2% của Sonnet 5 trên SWE-bench Pro (trong bảng trên) sẽ xếp trên mức 58,6% của GPT-5.5 nhưng dưới Opus 4.8 và Fable 5 — chỉ là một phép so sánh gián tiếp, vì là thế hệ mẫu khác, đọc chéo giữa hai bảng riêng của hai công ty.
Giá của Claude Sonnet 5 và GPT-5.6
| Mẫu | Đầu vào (mỗi 1M token) | Đầu ra (mỗi 1M token) |
|---|
| Claude Sonnet 5 (giới thiệu, đến 31/08/2026) | $2.00 | $10.00 |
| Claude Sonnet 5 (tiêu chuẩn) | $3.00 | $15.00 |
| GPT-5.6 Sol | $5.00 | $30.00 |
| GPT-5.6 Terra | $2.50 | $15.00 |
| GPT-5.6 Luna | $1.00 | $6.00 |
Ở mức niêm yết, giá giới thiệu của Sonnet 5 nằm giữa GPT-5.6 Terra và Luna, và thấp hơn khá nhiều so với Sol. Nhưng điểm thú vị hơn là mức giá giới thiệu: ở $2/$10, Sonnet 5 thực tế rẻ hơn mức $2,50/$15 của GPT-5.6 Terra, ít nhất là trong mùa hè cho đến khi có đợt tăng giá.
Rõ ràng, câu chuyện giá phức tạp hơn phép tính nhanh. Anthropic lưu ý rằng giá giới thiệu của Sonnet 5 được hiệu chỉnh để xấp xỉ bù trừ chi phí so với số lượng token cao hơn của tokenizer mới. Về phía mình, OpenAI giới thiệu cơ chế bộ nhớ đệm prompt dự đoán hơn cho GPT-5.6 và các mẫu sau, với chi phí ghi bộ đệm tính ở mức 1,25 lần giá đầu vào không đệm và đọc bộ đệm giữ mức giảm 90%.
Vì sao lại ra mắt với mức giá giới thiệu chiết khấu, thay vì đặt mức chuẩn ngay từ đầu? Lý do tokenizer giải thích một phần, nhưng thời điểm cũng trùng hợp với bối cảnh chúng ta thấy: một sân chơi đông đúc và biến động nhanh. Chỉ trong vài tuần qua, Sakana AI đã ra mắt Fugu, một bộ điều phối định tuyến qua một nhóm các mẫu hàng đầu và tuyên bố đạt gần tầm các hệ thống hạng Mythos của riêng Anthropic với chi phí thấp hơn nhiều. Vì vậy, định giá Sonnet 5 ở $2/$10 đến hết tháng 8 giúp Anthropic có một mẫu agentic rẻ, sẵn sàng rộng rãi để giới thiệu trong khi GPT-5.6 vẫn khóa ở bản xem trước. Việc là mẫu mà mọi người thực sự có thể dùng, với giá thấp, là một lợi thế cạnh tranh thực sự.
Khả dụng của Claude Sonnet 5 và GPT-5.6
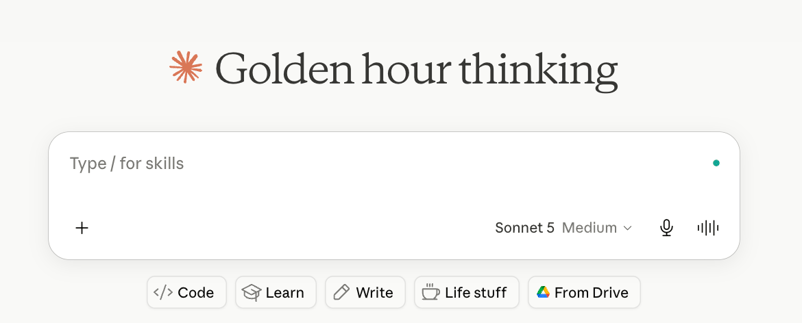
Claude Sonnet 5 hiện đã khả dụng ở mọi nơi. Đây là mẫu mặc định trên các gói Free và Pro, có trên Max, Team và Enterprise, và hoạt động trong Claude Code cũng như trên Claude Platform qua API (chuỗi mẫu claude-sonnet-5). Có thể bạn đã thấy Claude Sonnet 5 trong cửa sổ chat trước cả khi đọc thông báo.
GPT-5.6 chưa sẵn sàng cho số đông. Trong giai đoạn xem trước, chỉ có thể truy cập qua API và Codex đối với một nhóm đối tác được chọn. OpenAI cho biết khả dụng rộng rãi sẽ đến, nhưng chưa đưa ra ngày cụ thể.
Kết luận
Trên điểm chuẩn duy nhất trùng lặp, bậc hàng đầu của GPT-5.6 có điểm cao hơn so với mẫu hàng đầu hiện tại của Claude là Opus 4.8, cho thấy OpenAI có thể thực sự dẫn trước về năng lực khi GPT-5.6 phát hành rộng rãi. Nhưng Sonnet 5 không hẳn là đối thủ trực tiếp của Sol hay Terra về năng lực — đây là mẫu tầm trung cạnh tranh về hiệu năng agentic trên mỗi đô la, và ở phương diện đó, nó sẵn sàng dùng, định giá cạnh tranh và hoạt động ngay hôm nay.


Anthropic và OpenAI đều có bản phát hành mới trong tuần này, nhưng hai lần ra mắt đang ở những giai đoạn khác nhau.
GPT-5.6 đã được công bố, nhưng đang bị giới hạn trong bản xem trước hạn chế. Và trong khi GPT-5.6 chưa sẵn sàng cho số đông, Claude Sonnet 5 đã phát hành hôm nay và hoạt động trên mọi gói Claude — với mức giá API giới thiệu hiện tại thậm chí còn rẻ hơn mẫu tầm trung Terra của GPT-5.6.
Dưới đây là những gì chúng ta biết về từng mẫu, cách chúng so sánh và nơi các con số giao nhau.
Claude Sonnet 5 là gì?
Claude Sonnet 5 là mẫu tầm trung mới nhất của Anthropic, được giới thiệu là mẫu Sonnet có năng lực agentic mạnh nhất từ trước đến nay. Mục tiêu là thu hẹp phần lớn khoảng cách với các mẫu cấp Opus về lập kế hoạch và sử dụng công cụ trong khi vẫn giữ chi phí thấp hơn đáng kể.
Anthropic cho biết Sonnet 5 là bước tiến lớn so với Sonnet 4.6 về suy luận, lập trình và sử dụng công cụ, và hiệu năng của nó hiện ở mức khá gần với Opus 4.8 trong một số bài đánh giá mang tính agentic, bao gồm BrowseComp (tìm kiếm agentic) và OSWorld-Verified (sử dụng máy tính).
Opus 4.8 vẫn dẫn đầu về độ chính xác thuần, đặc biệt ở các mức nỗ lực cao hoặc cao nhất, nhưng Sonnet 5 mang đến cho nhà phát triển lựa chọn có tỷ lệ giá/hiệu năng mạnh hơn. Các mẫu tầm trung của Anthropic có tiền lệ cho thấy hiệu năng vượt tầm khi một thế hệ mới ra mắt trước khi bản làm mới Opus tiếp theo bắt kịp. Có vẻ như đã lâu, nhưng Claude Sonnet 3.5 thực tế từng vượt Claude Opus 3 trên một số điểm chuẩn vào năm 2024.
Sonnet 5 cũng dùng bộ tokenizer cập nhật, đồng nghĩa cùng một văn bản đầu vào có thể ánh xạ thành nhiều token hơn trước (khoảng 1,0–1,35 lần tùy nội dung).
GPT-5.6 là gì?
GPT-5.6 không phải một mẫu đơn lẻ. Đây là một họ ba mẫu, được tổ chức theo cách đặt tên mới: số chỉ thế hệ, tên chỉ bậc năng lực:
Sol là mẫu hàng đầu. Đây là bậc duy nhất có quyền truy cập hai điều khiển mới: thiết lập mức nỗ lực suy luận
maxvàultra mode, chế độ phân rã tác vụ cho một nhóm tiểu tác nhân.Terra là mẫu cân bằng cho nhu cầu hằng ngày — tương đương gần với GPT-5.5 về chất lượng tổng thể với mức giá khoảng một nửa.
Luna là bậc chi phí thấp, nhắm vào tác vụ nhạy trễ.
Trong thông báo, OpenAI nhấn mạnh các cải thiện về lập trình, sinh học và an ninh mạng. Điểm nhấn lớn là hiệu năng trên một số điểm chuẩn thú vị, đáng chú ý nhất là Terminal-Bench 2.1, cùng với GeneBench v1 (điểm chuẩn hệ gen tầm xa), và hai điểm chuẩn phát triển khai thác lỗ hổng (ExploitBench và ExploitGym).
So sánh điểm chuẩn Claude Sonnet 5 và GPT-5.6
Theo các thông báo tương ứng, Sonnet 5 và GPT-5.6 không chia sẻ một điểm chuẩn chung nào có số liệu từ cả hai bên.
Dù Anthropic đã công bố một số con số cụ thể cho Sonnet 5 trong bài ra mắt và thẻ hệ thống, OpenAI đến nay mới xác nhận một điểm số duy nhất cho GPT-5.6: Terminal-Bench 2.1. Dưới đây là những gì đã được công bố từ mỗi bên, đặt cạnh nhau:
Terminal-Bench 2.1 là hàng mục duy nhất GPT-5.6 đã công bố, trong khi Sonnet 5 chưa có điểm số để đưa vào. Có thể đó là chiến lược vì GPT-5.6 đạt kết quả tốt.
Ở các điểm chuẩn nơi Sonnet 5 có số liệu — SWE-bench Pro, OSWorld-Verified, Humanity's Last Exam — GPT-5.6 vẫn chưa công bố, nên chưa có gì để so sánh.
Kết luận thẳng thắn là một so sánh điểm chuẩn Sonnet 5 vs. GPT-5.6 thực sự vẫn chưa tồn tại đầy đủ. Mỗi công ty đã công bố một bộ đánh giá khác nhau.
Nhìn rộng hơn: vị trí của mỗi mẫu trong bức tranh chung
Vì Sonnet 5 và GPT-5.6 không trùng nhau trực tiếp, đáng để lùi lại và xem điểm số đã công bố của mỗi bên so với phần còn lại — Opus 4.8, Fable 5 (bị tạm dừng), GPT-5.5 và Gemini 3.1 Pro. Điều này sẽ không phân định Sonnet 5 vs. GPT-5.6, nhưng cho thấy vị trí của mỗi mẫu so với cùng một nhóm đối thủ:
Một vài điểm: Trên Terminal-Bench 2.1, mức 91,9% của GPT-5.6 Sol Ultra vượt mọi mẫu Claude đã ghi nhận, bao gồm Opus 4.8 ở mức 78,9%. Vậy nên OpenAI không phóng đại khi tự hào về điểm số Terminal-Bench 2.1 của GPT-5.6.
Fable 5 vẫn dẫn trước Opus 4.8 và GPT-5.5 trên SWE-bench Pro và Humanity's Last Exam, ngay cả khi đang bị tạm dừng. Các con số này đơn giản là chưa bị vượt qua, bởi bất kỳ ai, bao gồm GPT-5.6 (chưa công bố điểm SWE-bench hay HLE để so sánh). Mức 63,2% của Sonnet 5 trên SWE-bench Pro (trong bảng trên) sẽ xếp trên mức 58,6% của GPT-5.5 nhưng dưới Opus 4.8 và Fable 5 — chỉ là một phép so sánh gián tiếp, vì là thế hệ mẫu khác, đọc chéo giữa hai bảng riêng của hai công ty.
Giá của Claude Sonnet 5 và GPT-5.6
Ở mức niêm yết, giá giới thiệu của Sonnet 5 nằm giữa GPT-5.6 Terra và Luna, và thấp hơn khá nhiều so với Sol. Nhưng điểm thú vị hơn là mức giá giới thiệu: ở $2/$10, Sonnet 5 thực tế rẻ hơn mức $2,50/$15 của GPT-5.6 Terra, ít nhất là trong mùa hè cho đến khi có đợt tăng giá.
Rõ ràng, câu chuyện giá phức tạp hơn phép tính nhanh. Anthropic lưu ý rằng giá giới thiệu của Sonnet 5 được hiệu chỉnh để xấp xỉ bù trừ chi phí so với số lượng token cao hơn của tokenizer mới. Về phía mình, OpenAI giới thiệu cơ chế bộ nhớ đệm prompt dự đoán hơn cho GPT-5.6 và các mẫu sau, với chi phí ghi bộ đệm tính ở mức 1,25 lần giá đầu vào không đệm và đọc bộ đệm giữ mức giảm 90%.
Vì sao lại ra mắt với mức giá giới thiệu chiết khấu, thay vì đặt mức chuẩn ngay từ đầu? Lý do tokenizer giải thích một phần, nhưng thời điểm cũng trùng hợp với bối cảnh chúng ta thấy: một sân chơi đông đúc và biến động nhanh. Chỉ trong vài tuần qua, Sakana AI đã ra mắt Fugu, một bộ điều phối định tuyến qua một nhóm các mẫu hàng đầu và tuyên bố đạt gần tầm các hệ thống hạng Mythos của riêng Anthropic với chi phí thấp hơn nhiều. Vì vậy, định giá Sonnet 5 ở $2/$10 đến hết tháng 8 giúp Anthropic có một mẫu agentic rẻ, sẵn sàng rộng rãi để giới thiệu trong khi GPT-5.6 vẫn khóa ở bản xem trước. Việc là mẫu mà mọi người thực sự có thể dùng, với giá thấp, là một lợi thế cạnh tranh thực sự.
Khả dụng của Claude Sonnet 5 và GPT-5.6
Claude Sonnet 5 hiện đã khả dụng ở mọi nơi. Đây là mẫu mặc định trên các gói Free và Pro, có trên Max, Team và Enterprise, và hoạt động trong Claude Code cũng như trên Claude Platform qua API (chuỗi mẫu
claude-sonnet-5). Có thể bạn đã thấy Claude Sonnet 5 trong cửa sổ chat trước cả khi đọc thông báo.GPT-5.6 chưa sẵn sàng cho số đông. Trong giai đoạn xem trước, chỉ có thể truy cập qua API và Codex đối với một nhóm đối tác được chọn. OpenAI cho biết khả dụng rộng rãi sẽ đến, nhưng chưa đưa ra ngày cụ thể.
Kết luận
Trên điểm chuẩn duy nhất trùng lặp, bậc hàng đầu của GPT-5.6 có điểm cao hơn so với mẫu hàng đầu hiện tại của Claude là Opus 4.8, cho thấy OpenAI có thể thực sự dẫn trước về năng lực khi GPT-5.6 phát hành rộng rãi. Nhưng Sonnet 5 không hẳn là đối thủ trực tiếp của Sol hay Terra về năng lực — đây là mẫu tầm trung cạnh tranh về hiệu năng agentic trên mỗi đô la, và ở phương diện đó, nó sẵn sàng dùng, định giá cạnh tranh và hoạt động ngay hôm nay.