我最近完成了一份与一家 AI 公司的合同工作。该公司帮助研究人员对大型语言模型(LLM)进行后训练。作为一名数学博士,我编写了能难倒前沿 AI 模型的数学提示。花招式的提示不算,提示必须能暴露出推理错误。
在这项工作中,我多次听到“Humanity’s Last Exam”(人类最后的考试)。我了解到,这是一个用于测试多个学术领域推理能力的 AI 基准。出于好奇,我进一步挖掘了 HLE 的来龙去脉,以及它能告诉我们当下 AI 推理极限的哪些信息。
如果您是 AI 与基准测试的新手,建议先学习AI 基础技能路径。
什么是“Humanity’s Last Exam”?
随着 LLM 的进步,研究人员依赖一组被称为基准的评测问题集合来比较性能并跟踪进展。Humanity's Last Exam(HLE)是一个旨在衡量 LLM推理能力的基准,而不仅仅是其模式匹配能力。它旨在评估模型在众多学术领域处理专家级问题的水平。
为什么需要“最后的考试”?
已有许多基准,为什么还要再做一个?曾经对 LLM 构成挑战的基准,如MMLU,如今已出现“饱和”,模型分数常常超过 90%。此时,这些基准已难以衡量模型之间的有意义差异。
HLE 作为下一代基准,通过汇集专家精心设计的问题来提高难度,这些问题要求多步推理,而非仅仅凭借对表层模式的回忆。
HLE 是如何开发的?
2024 年末,专注于 AI 安全的非营利组织“人工智能安全中心”(Centre for AI Safety)与数据公司 Scale AI 合作,开发了一个更难的 AI 基准。该项目由 Dan Hendrycks 领导。
团队从多个学术学科众包研究生水平的问题,并提供了高额奖励:前 50 名贡献者各获 5000 美元,其后 500 名各获 500 美元。
最终产生了覆盖数学、计算机科学、文学、音乐分析与历史等众多科目的专家级问题大库。
Humanity's Last Exam 包含什么?
HLE 论文将该基准描述为“……面向广泛学术技能的最终封闭式基准”。其题目要求进行多步推理,从而防止模型通过猜测或死记硬背作答。
HLE 由 2500 道公开题目和约 500 道私有保留题目组成。
每道题都必须是原创、只有一个正确答案,且不能通过简单的网页搜索或数据库查询得到。约 76% 的题目采用“完全匹配”答案格式,其余 24% 为多项选择。约 14% 的题目为多模态,涉及文本与图像。
HLE 团队对题目的筛选极为严格。
- 题目必须能难倒前沿 LLM 方可被接受。约有七万道题满足该标准。
- 领域专家的同行评审将总量精炼并筛选至一万三千道。
- 组织者与专家评审对其中六千道题进行人工批准。
- 研究人员将该题库分为 2500 道公开题与约 500 道保留题。
对 Humanity’s Last Exam 的质疑
早期结果显示,前沿模型在这些题目上的初始得分较低,却表现出很高的自信。这一差距表明存在幻觉(hallucinations)。
独立团体也提出了担忧。非营利研究实验室Future House发表博文称:“Humanity’s Last Exam 中约 30% 的化学/生物答案可能是错误的。”
他们的分析聚焦于评审流程。出题者会给出自认正确的答案,但评审被指示仅花五分钟核查答案正确性。其认为,这一流程让过于复杂、牵强或含糊的答案漏网,且常与科学文献相冲突。
HLE 维护方对该文做出回应,委托三位专家对存在争议的子集进行复核。截至 2025 年 9 月 16 日,他们计划为 HLE 启动滚动评审流程。
AI 基准测试版图
HLE 处于更广泛的基准生态之中,这些基准用于测试 LLM 能力的不同侧面。
知识与推理
这些基准评估学术知识与推理能力。
多模态理解
这些基准衡量涉及文本与图像的推理能力。
- 大规模多学科多模态理解与推理(MMMU)。约 1500 道来源于考试、小测与教材的多模态、多学科题目。
- MMMU-Pro基准移除了可被仅文本模型解出的题目,增强了答案选项的稳健性,并引入了“纯视觉”设置,即将整段提示嵌入图像中。
软件工程与工具使用
还有一些基准专注于软件工程与工具使用。
整体性、多指标评估框架
斯坦福基础模型研究中心(CRFM)开发了语言模型的整体评估(HELM),以支持负责任的 AI 评估。
HELM 在一系列标准化场景中评估模型,例如问答、摘要、安全关键查询以及社会/伦理内容。这些场景从多个维度评分,不仅考察准确率,还包括校准度、鲁棒性与毒性。
HELM 现已发展为相关框架的家族。
- HELM Capabilities。通用的语言模型评测排行榜。
- Audio。面向音频与语音相关任务的评测。
- HELM Lite。用于快速对比的更小更快子集。
- HELM Finance。面向金融任务的 HELM 定制版。
- MedHELM。面向医疗相关推理与安全的评测。
安全与危险能力评估
安全框架衡量的是风险,而非智力水平。
当前 AI 模型在各类基准上的得分如何?
许多公开排行榜跟踪 LLM 在各项指标上的表现。
排行榜
以下为截至 2025 年 12 月撰写时的一些分数。
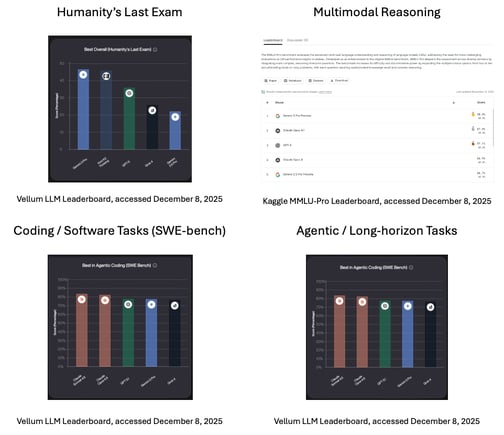
- Humanity's Last Exam。根据 Vellum 排行榜,当前领先者(撰写时)为Gemini 3 Pro,即 Google 的旗舰生成式多模态 AI 模型。
- 多模态推理。据 Kaggle 的 MMLU-Pro 排行榜,旨在将多模态统一于单一系统的 Gemini 3 Pro 在多模态推理上领跑。
- 编程 / 软件任务(SWE-bench)。Anthropic 的Claude Sonnet 4.5主打谨慎推理,据 Vellum 排行榜在编程与真实世界软件任务中位居榜首。
- 具身代理 / 长期任务。据 Vellum 排行榜,Claude Sonnet 4.5 在代理性与长期任务上同样领先。
安全/危险能力
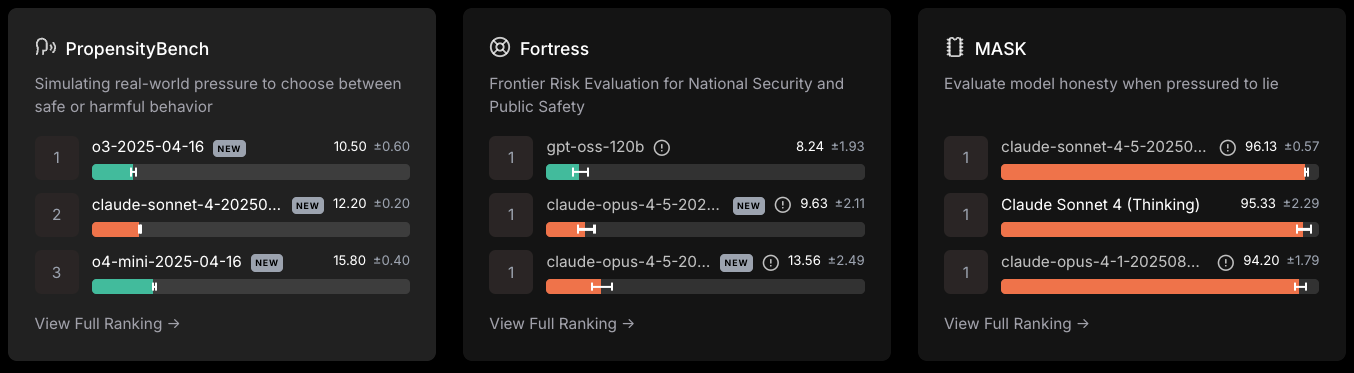
Scale LLM 安全排行榜,访问时间 2025 年 12 月 8 日
Humanity’s Last Exam 的使用方式
前文已概述 HLE 的定义与开发过程。接下来看看该测试在实践中的应用。
面向研究团队
HLE 提供跨领域的标准化评估方法。它能突显模型的优劣势,揭示其与人类专家表现之间的差距。团队可据此模式指导模型开发与定向后训练。
面向政策制定者
HLE 提供面向公众、全球统一的 AI 推理进展指标。它为各国与监管机构构建了共同参照点,可将关于阈值、监督与治理的讨论锚定在现实,而非炒作。
结语
AI 基准塑造了我们衡量 AI 进步的方式。随着早期基准的饱和,新的、聚焦推理而非仅靠回忆或模式匹配的基准需求愈发显著。
Humanity's Last Exam 试图通过向全球专家众包研究生水平的问题来暴露 LLM 的局限,以填补这一空白。它并非最终答案,但确实澄清了当下 AI 与人类专家推理之间的差距。
如需进一步了解 LLM 及其工作原理,推荐以下资源:


我最近完成了一份与一家 AI 公司的合同工作。该公司帮助研究人员对大型语言模型(LLM)进行后训练。作为一名数学博士,我编写了能难倒前沿 AI 模型的数学提示。花招式的提示不算,提示必须能暴露出推理错误。
在这项工作中,我多次听到“Humanity’s Last Exam”(人类最后的考试)。我了解到,这是一个用于测试多个学术领域推理能力的 AI 基准。出于好奇,我进一步挖掘了 HLE 的来龙去脉,以及它能告诉我们当下 AI 推理极限的哪些信息。
如果您是 AI 与基准测试的新手,建议先学习AI 基础技能路径。
什么是“Humanity’s Last Exam”?
随着 LLM 的进步,研究人员依赖一组被称为基准的评测问题集合来比较性能并跟踪进展。Humanity's Last Exam(HLE)是一个旨在衡量 LLM推理能力的基准,而不仅仅是其模式匹配能力。它旨在评估模型在众多学术领域处理专家级问题的水平。
为什么需要“最后的考试”?
已有许多基准,为什么还要再做一个?曾经对 LLM 构成挑战的基准,如MMLU,如今已出现“饱和”,模型分数常常超过 90%。此时,这些基准已难以衡量模型之间的有意义差异。
HLE 作为下一代基准,通过汇集专家精心设计的问题来提高难度,这些问题要求多步推理,而非仅仅凭借对表层模式的回忆。
HLE 是如何开发的?
2024 年末,专注于 AI 安全的非营利组织“人工智能安全中心”(Centre for AI Safety)与数据公司 Scale AI 合作,开发了一个更难的 AI 基准。该项目由 Dan Hendrycks 领导。
团队从多个学术学科众包研究生水平的问题,并提供了高额奖励:前 50 名贡献者各获 5000 美元,其后 500 名各获 500 美元。
最终产生了覆盖数学、计算机科学、文学、音乐分析与历史等众多科目的专家级问题大库。
Humanity's Last Exam 包含什么?
HLE 论文将该基准描述为“……面向广泛学术技能的最终封闭式基准”。其题目要求进行多步推理,从而防止模型通过猜测或死记硬背作答。
HLE 由 2500 道公开题目和约 500 道私有保留题目组成。
每道题都必须是原创、只有一个正确答案,且不能通过简单的网页搜索或数据库查询得到。约 76% 的题目采用“完全匹配”答案格式,其余 24% 为多项选择。约 14% 的题目为多模态,涉及文本与图像。
HLE 团队对题目的筛选极为严格。
对 Humanity’s Last Exam 的质疑
早期结果显示,前沿模型在这些题目上的初始得分较低,却表现出很高的自信。这一差距表明存在幻觉(hallucinations)。
独立团体也提出了担忧。非营利研究实验室Future House发表博文称:“Humanity’s Last Exam 中约 30% 的化学/生物答案可能是错误的。”
他们的分析聚焦于评审流程。出题者会给出自认正确的答案,但评审被指示仅花五分钟核查答案正确性。其认为,这一流程让过于复杂、牵强或含糊的答案漏网,且常与科学文献相冲突。
HLE 维护方对该文做出回应,委托三位专家对存在争议的子集进行复核。截至 2025 年 9 月 16 日,他们计划为 HLE 启动滚动评审流程。
AI 基准测试版图
HLE 处于更广泛的基准生态之中,这些基准用于测试 LLM 能力的不同侧面。
知识与推理
这些基准评估学术知识与推理能力。
多模态理解
这些基准衡量涉及文本与图像的推理能力。
软件工程与工具使用
还有一些基准专注于软件工程与工具使用。
整体性、多指标评估框架
斯坦福基础模型研究中心(CRFM)开发了语言模型的整体评估(HELM),以支持负责任的 AI 评估。
HELM 在一系列标准化场景中评估模型,例如问答、摘要、安全关键查询以及社会/伦理内容。这些场景从多个维度评分,不仅考察准确率,还包括校准度、鲁棒性与毒性。
HELM 现已发展为相关框架的家族。
安全与危险能力评估
安全框架衡量的是风险,而非智力水平。
当前 AI 模型在各类基准上的得分如何?
许多公开排行榜跟踪 LLM 在各项指标上的表现。
排行榜
以下为截至 2025 年 12 月撰写时的一些分数。
安全/危险能力
Scale LLM 安全排行榜,访问时间 2025 年 12 月 8 日
Humanity’s Last Exam 的使用方式
前文已概述 HLE 的定义与开发过程。接下来看看该测试在实践中的应用。
面向研究团队
HLE 提供跨领域的标准化评估方法。它能突显模型的优劣势,揭示其与人类专家表现之间的差距。团队可据此模式指导模型开发与定向后训练。
面向政策制定者
HLE 提供面向公众、全球统一的 AI 推理进展指标。它为各国与监管机构构建了共同参照点,可将关于阈值、监督与治理的讨论锚定在现实,而非炒作。
结语
AI 基准塑造了我们衡量 AI 进步的方式。随着早期基准的饱和,新的、聚焦推理而非仅靠回忆或模式匹配的基准需求愈发显著。
Humanity's Last Exam 试图通过向全球专家众包研究生水平的问题来暴露 LLM 的局限,以填补这一空白。它并非最终答案,但确实澄清了当下 AI 与人类专家推理之间的差距。
如需进一步了解 LLM 及其工作原理,推荐以下资源: