到 2026 年年中,AI 领域已被一批在原始基准分数上竞争的单体前沿模型所占据。Sakana AI 则押注于另一条路径:不训练更大的基础模型,而是推出了 Fugu——一个在单一、兼容 OpenAI 的 API 背后编排现有前沿模型池的系统。
其核心主张是:Sakana Fugu Ultra 在工程、科学与推理基准上可与 Anthropic 的 Fable 5 和 Mythos Preview 相匹敌,而无需接入这些受出口管制的模型。
Sakana Fugu 于 2026 年 6 月 22 日发布,分为两个版本:用于日常、对延迟敏感工作的 Fugu,以及用于复杂多步任务的 Fugu Ultra。在 SWE-Bench Pro 上,Fugu Ultra 得分 73.7%,领先于 Claude Opus 4.8(69.2%)、GPT-5.5(58.6%)和 Gemini 3.1 Pro(54.2%)。
所有基准分数均由 Sakana 报告,尚未被第三方实验室独立复现,这一点在阅读时值得留意。
本文将介绍 Fugu 的真实面貌,梳理其关键功能,查看完整基准测试表,并探讨一些用例。您也可以参考我们对 GPT-5.5 与 Gemini 3.1 Pro 的对比,以了解 Fugu 所面临的竞品背景。
What is Sakana Fugu?
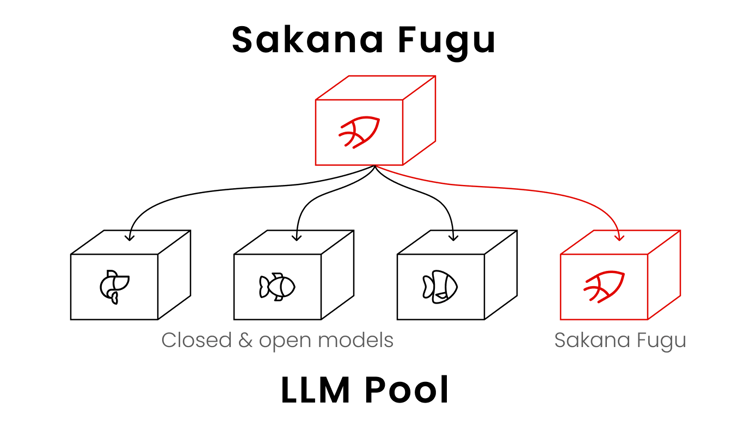
Sakana Fugu 是一个被训练为“编排器”的语言模型:它接收请求,决定是直接处理还是委派给其代理池中的专业模型,负责验证与综合,并返回单一响应。从外部看,您只调用一个端点;在内部,则是一组模型协同完成工作。
Sakana AI 自创立以来便在朝这一架构推进。该实验室由 Llion Jones(“Attention Is All You Need” 原始论文的合著者)与 David Ha 创立,长期主张在困难、长周期任务上,协调的模型生态系统优于孤立的单体模型。
Fugu 将这一论断产品化,落地于两篇 ICLR 2026 论文:TRINITY(演进的 LLM 协调器)与 Conductor(学习用自然语言编排代理)。
在撰写本文时,Anthropic 的 Fable 5 与 Mythos Preview 因出口管制未向公众开放,因而无法纳入 Fugu 的代理池。
Sakana 的论点是:在可互换的模型池间进行路由,能切实对冲这类访问中断风险。至于这是否构成真正的“AI 主权”,尚有争议,但其运营逻辑是合理的:若某家供应商限制访问,Fugu 会绕过它进行路由。
来源
What's New With Sakana Fugu?
Fugu 引入了多项理念,使其区别于传统前沿模型与经典多代理框架。下文概述几个关键点。
通过学习的编排,而非固定流水线
大多数多代理系统要求开发者预先定义由哪个模型处理哪类任务。Fugu 则将此“学会”。编排器模型经过训练,能决定何时委派、代理间应如何通信,以及如何将它们的输出合成为单一答案。这正是上文提到的 TRINITY 与 Conductor 研究的核心贡献。
在实践中,这意味着多代理系统的复杂性不会渗透到您的代码中。您向一个端点发送请求,Fugu 在内部完成模型选择、委派、验证与综合。对于尝试自建编排层的团队,其吸引力显而易见:无需维护“马具”,也能获得协调带来的收益。
需要提醒的一点:路由决策属于专有机制,且不会向用户公开。您无法看到具体由哪个底层模型处理了某次请求。对于需要审计推理链的合规敏感型工作,这种不透明性是个实质限制。
可更换的代理池
Fugu 的模型池并非固定。当新的前沿模型公开可用时,Sakana 预计将花约两周时间训练与评估更新版 Fugu,随后推送上线。也就是说,随着底层生态的演进,Fugu 的性能应随之提升,而用户无需更改集成。
对于标准版 Fugu,用户还可在控制台设置中选择将特定代理排除在池外,这对有数据隐私或合规要求的团队很重要。Fugu Ultra 的代理池是固定的,因为其基准性能依赖于完整的代理集合。
双层模型设计
Fugu 与 Fugu Ultra 面向不同负载。Fugu 在质量与低延迟间取得平衡,适合作为编码、代码审查与交互式服务的默认选择。Fugu Ultra 则协调更深的专家代理池,针对复杂多步问题追求极致答案质量。
早期用户倾向在论文复现、网络安全分析、Kaggle 风格的数据科学与专利检索等任务上使用 Fugu Ultra。
一位参与内测的软件工程师反馈称,Fugu Ultra 提出了二十多条代码审查问题,而其他工具仅标注约三条。
一位网络安全工程师反馈称,一条范围明确的指令即可驱动端到端的完整安全评估,包括带证据与复测步骤的规范报告。
我认为需要指出,延迟上的权衡是真实存在的。多代理路由与综合会带来额外开销。对于简单查询或严格延迟要求,直接调用单个前沿模型往往更快且更便宜。
兼容 OpenAI 的 API
Fugu 与 Fugu Ultra 都可通过单一、兼容 OpenAI 的 API 访问。无需迁移 SDK。
您只需将现有客户端指向 Fugu 的端点,携带您的 API 密钥开始发起请求。此设计有意降低切换成本,方便已通过 OpenAI 客户端库使用 GPT-5.5 或 Claude Opus 4.8 的团队。
Sakana Fugu Benchmarks
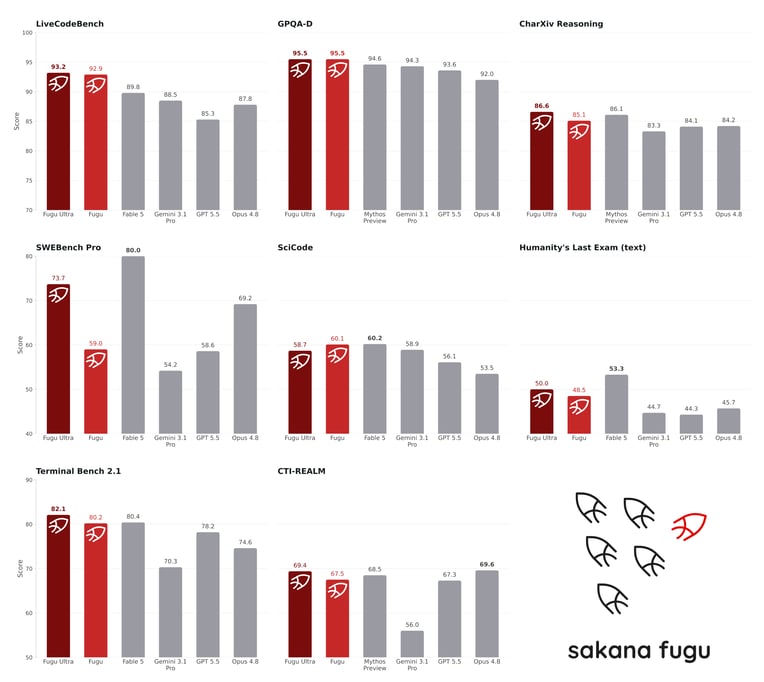
据 Sakana 的对照表,Fugu Ultra 在 11 个基准中的 10 个位居首位,GPT-5.5 仅在 MRCRv2 领先。除 Fugu 外的所有分数均为各供应商报告。Fable 5 与 Mythos Preview 因未公开可用而被排除,亦因此无法纳入 Fugu 的代理池进行对比。
截至撰写本文时,我尚未在第三方榜单上看到这些分数的独立复现。
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
SWE-Bench Pro
Fugu Ultra 在 SWE-Bench Pro 上得分 73.7%,领先于 Claude Opus 4.8 的 69.2%、GPT-5.5 的 58.6% 与 Gemini 3.1 Pro 的 54.2%。在我们关于 GPT-5.5 的报道中也提到,它在该基准的得分为 58.6%,而 Fugu Ultra 领先 15 分。
SWE-Bench Pro 测试模型是否能在软件仓库中解决真实的 GitHub 问题,是更贴近实际的编码基准之一。Fugu Ultra 与下一个可公开访问模型之间的差距,足以对严肃开展代码审查或修复工作的团队产生影响。
LiveCodeBench 与 LiveCodeBench Pro
Fugu Ultra 在 LiveCodeBench 上得分 93.2%,在 LiveCodeBench Pro 上得分 90.8%。其次是 Gemini 3.1 Pro 在标准版上取得 88.5%,Claude Opus 4.8 为 87.8%。
LiveCodeBench 测试来自近期竞赛的竞技编程题,相较更早期的编码基准,训练数据污染风险更低。Pro 版本的题目更难。Fugu 在此的领先与内测阶段关于强代码审查表现的反馈一致。
Humanity's Last Exam
Fugu Ultra 在 Humanity's Last Exam 上得分 50.0%,对比 Claude Opus 4.8 的 49.8%、Gemini 3.1 Pro 的 44.4% 与 GPT-5.5 的 41.4%。
该基准测试跨科学与学术领域的专家级知识,题目即便对领域专家也较为困难。在该基准上拿到 50% 颇为亮眼,尤其考虑到 GPT-5.5 为 41.4%。Fugu Ultra 与 GPT-5.5 之间的差距,是表中各基准中最大的。
GPQA Diamond
Fugu 与 Fugu Ultra 在 GPQA Diamond 上均得分 95.5%,Gemini 3.1 Pro 为 94.3%,GPT-5.5 为 93.6%,Claude Opus 4.8 为 92.0%。
GPQA Diamond 测试生物、化学与物理中的博士级科学问题,由领域专家编写并验证其对非专业人士的难度。标准版 Fugu 与 Fugu Ultra 在此持平,表明在该基准上编排开销并未带来额外收益,这也符合问答型、无需多步规划任务的直觉。
TerminalBench 2.1
Fugu Ultra 在 TerminalBench 2.1 上得分 82.1%,领先于 GPT-5.5 的 78.2%、Claude Opus 4.8 的 74.6% 与 Gemini 3.1 Pro 的 70.3%。TerminalBench 测试需要与终端环境交互的“代理式”编码任务,包括文件操作、shell 命令与多步执行。
这是与真实开发者工作流最相关的基准之一,Fugu Ultra 在此领先 GPT-5.5 的表现,与内测中关于网络安全评估用例的报告一致。
MRCRv2
GPT-5.5 以 94.8% 在 MRCRv2 上领先,Fugu Ultra 为 93.6%,Claude Opus 4.8 为 87.9%。MRCRv2 测试长上下文回忆能力,具体而言是模型能否从超长文档中检索特定信息。
这是唯一一个 Fugu Ultra 未居首的基准,值得那些以从大型文档中检索具体事实为主要用例的团队关注,而非多步推理或代码生成。
来源
Sakana Fugu Pricing and Availability
Fugu 现已可通过 Sakana 的控制台 console.sakana.ai 使用,并提供兼容 OpenAI 的 API。所有套餐均包含 Fugu 与 Fugu Ultra。订阅层级如下:
- Standard:每月 20 美元,基线用量,适合偶发 API 调用与个人试验
- Pro:每月 100 美元,为 Standard 的 10 倍用量,适合常规编码与研究会话
- Max:每月 200 美元,为 Standard 的 30 倍用量,适合重负载、长时运行工作流
按量计费计划按 token 用量计费,而非月度配额。对于 Fugu Ultra(模型 ID:fugu-ultra-20260615),标准上下文长度下的价格为:输入每百万 token 5 美元、输出每百万 token 30 美元。
当上下文超过 272K token 时,费率提升为输入 10 美元、输出 45 美元。缓存输入为每百万 token 0.50 美元,超过 272K 时为 1.00 美元。Fugu 的标准定价与当前所用底层模型的费率一致,且在多代理并行时,Sakana 不会叠加收费。
需要提示的一项区域限制:在 Sakana 推进 GDPR 合规期间,Fugu 目前在欧盟或欧洲经济区成员国不可用。对欧洲团队而言,这暂时是个阻碍。Sakana 尚未公布进入欧盟的时间表。
Final Thoughts
与 OpenAI、Anthropic 与 Google 的路径不同,Fugu 的确是在做一笔“不同的赌注”。Sakana 并未在基础模型规模上硬碰硬,而是主张:在可互换的前沿模型池上进行“学习型编排”,能在真正耗时的任务上匹敌或超越单一系统——如长时代码审查、多步研究、安全评估与论文复现。
若这些基准分数经得起独立验证,它们在多数对开发者重要的指标上为这一主张提供了支持。当然,在我们重新获得 Fable 5 与 Mythos 的访问之前,无法直接与之比较。
话虽如此,确实也存在一些注意事项。
所有基准分均为 Sakana 报告。路由层不透明,会给合规敏感型工作带来阻力。对欧盟/欧洲经济区的排除限制了全球开发者社区中相当一部分人的采用。而在简单任务上的延迟权衡也确实存在:如果您只进行快速的单轮 API 调用,Fugu Ultra 的编排开销就是纯成本,毫无收益。
我认为 Fugu 真正契合的是那些运行长周期“代理式”工作流、且已在自行管理多模型复杂性的团队。如果您正维护基于 Claude 与 GPT 的自有编排“马具”,Fugu Ultra 值得认真评估。
“主权”这一叙事或许有些被高估,但能通过单一端点绕开供应商中断的务实价值却毋庸置疑。
若您希望快速了解 Fugu 所处的代理式 AI 版图,建议从 DataCamp 的 AI Agent Fundamentals 技能路径入手,涵盖大语言模型、代理与多模型系统的基础。


到 2026 年年中,AI 领域已被一批在原始基准分数上竞争的单体前沿模型所占据。Sakana AI 则押注于另一条路径:不训练更大的基础模型,而是推出了 Fugu——一个在单一、兼容 OpenAI 的 API 背后编排现有前沿模型池的系统。
其核心主张是:Sakana Fugu Ultra 在工程、科学与推理基准上可与 Anthropic 的 Fable 5 和 Mythos Preview 相匹敌,而无需接入这些受出口管制的模型。
Sakana Fugu 于 2026 年 6 月 22 日发布,分为两个版本:用于日常、对延迟敏感工作的 Fugu,以及用于复杂多步任务的 Fugu Ultra。在 SWE-Bench Pro 上,Fugu Ultra 得分 73.7%,领先于 Claude Opus 4.8(69.2%)、GPT-5.5(58.6%)和 Gemini 3.1 Pro(54.2%)。
所有基准分数均由 Sakana 报告,尚未被第三方实验室独立复现,这一点在阅读时值得留意。
本文将介绍 Fugu 的真实面貌,梳理其关键功能,查看完整基准测试表,并探讨一些用例。您也可以参考我们对 GPT-5.5 与 Gemini 3.1 Pro 的对比,以了解 Fugu 所面临的竞品背景。
What is Sakana Fugu?
Sakana Fugu 是一个被训练为“编排器”的语言模型:它接收请求,决定是直接处理还是委派给其代理池中的专业模型,负责验证与综合,并返回单一响应。从外部看,您只调用一个端点;在内部,则是一组模型协同完成工作。
Sakana AI 自创立以来便在朝这一架构推进。该实验室由 Llion Jones(“Attention Is All You Need” 原始论文的合著者)与 David Ha 创立,长期主张在困难、长周期任务上,协调的模型生态系统优于孤立的单体模型。
Fugu 将这一论断产品化,落地于两篇 ICLR 2026 论文:TRINITY(演进的 LLM 协调器)与 Conductor(学习用自然语言编排代理)。
在撰写本文时,Anthropic 的 Fable 5 与 Mythos Preview 因出口管制未向公众开放,因而无法纳入 Fugu 的代理池。
Sakana 的论点是:在可互换的模型池间进行路由,能切实对冲这类访问中断风险。至于这是否构成真正的“AI 主权”,尚有争议,但其运营逻辑是合理的:若某家供应商限制访问,Fugu 会绕过它进行路由。
来源
What's New With Sakana Fugu?
Fugu 引入了多项理念,使其区别于传统前沿模型与经典多代理框架。下文概述几个关键点。
通过学习的编排,而非固定流水线
大多数多代理系统要求开发者预先定义由哪个模型处理哪类任务。Fugu 则将此“学会”。编排器模型经过训练,能决定何时委派、代理间应如何通信,以及如何将它们的输出合成为单一答案。这正是上文提到的 TRINITY 与 Conductor 研究的核心贡献。
在实践中,这意味着多代理系统的复杂性不会渗透到您的代码中。您向一个端点发送请求,Fugu 在内部完成模型选择、委派、验证与综合。对于尝试自建编排层的团队,其吸引力显而易见:无需维护“马具”,也能获得协调带来的收益。
需要提醒的一点:路由决策属于专有机制,且不会向用户公开。您无法看到具体由哪个底层模型处理了某次请求。对于需要审计推理链的合规敏感型工作,这种不透明性是个实质限制。
可更换的代理池
Fugu 的模型池并非固定。当新的前沿模型公开可用时,Sakana 预计将花约两周时间训练与评估更新版 Fugu,随后推送上线。也就是说,随着底层生态的演进,Fugu 的性能应随之提升,而用户无需更改集成。
对于标准版 Fugu,用户还可在控制台设置中选择将特定代理排除在池外,这对有数据隐私或合规要求的团队很重要。Fugu Ultra 的代理池是固定的,因为其基准性能依赖于完整的代理集合。
双层模型设计
Fugu 与 Fugu Ultra 面向不同负载。Fugu 在质量与低延迟间取得平衡,适合作为编码、代码审查与交互式服务的默认选择。Fugu Ultra 则协调更深的专家代理池,针对复杂多步问题追求极致答案质量。
早期用户倾向在论文复现、网络安全分析、Kaggle 风格的数据科学与专利检索等任务上使用 Fugu Ultra。
一位参与内测的软件工程师反馈称,Fugu Ultra 提出了二十多条代码审查问题,而其他工具仅标注约三条。
一位网络安全工程师反馈称,一条范围明确的指令即可驱动端到端的完整安全评估,包括带证据与复测步骤的规范报告。
我认为需要指出,延迟上的权衡是真实存在的。多代理路由与综合会带来额外开销。对于简单查询或严格延迟要求,直接调用单个前沿模型往往更快且更便宜。
兼容 OpenAI 的 API
Fugu 与 Fugu Ultra 都可通过单一、兼容 OpenAI 的 API 访问。无需迁移 SDK。
您只需将现有客户端指向 Fugu 的端点,携带您的 API 密钥开始发起请求。此设计有意降低切换成本,方便已通过 OpenAI 客户端库使用 GPT-5.5 或 Claude Opus 4.8 的团队。
Sakana Fugu Benchmarks
据 Sakana 的对照表,Fugu Ultra 在 11 个基准中的 10 个位居首位,GPT-5.5 仅在 MRCRv2 领先。除 Fugu 外的所有分数均为各供应商报告。Fable 5 与 Mythos Preview 因未公开可用而被排除,亦因此无法纳入 Fugu 的代理池进行对比。
截至撰写本文时,我尚未在第三方榜单上看到这些分数的独立复现。
SWE-Bench Pro
Fugu Ultra 在 SWE-Bench Pro 上得分 73.7%,领先于 Claude Opus 4.8 的 69.2%、GPT-5.5 的 58.6% 与 Gemini 3.1 Pro 的 54.2%。在我们关于 GPT-5.5 的报道中也提到,它在该基准的得分为 58.6%,而 Fugu Ultra 领先 15 分。
SWE-Bench Pro 测试模型是否能在软件仓库中解决真实的 GitHub 问题,是更贴近实际的编码基准之一。Fugu Ultra 与下一个可公开访问模型之间的差距,足以对严肃开展代码审查或修复工作的团队产生影响。
LiveCodeBench 与 LiveCodeBench Pro
Fugu Ultra 在 LiveCodeBench 上得分 93.2%,在 LiveCodeBench Pro 上得分 90.8%。其次是 Gemini 3.1 Pro 在标准版上取得 88.5%,Claude Opus 4.8 为 87.8%。
LiveCodeBench 测试来自近期竞赛的竞技编程题,相较更早期的编码基准,训练数据污染风险更低。Pro 版本的题目更难。Fugu 在此的领先与内测阶段关于强代码审查表现的反馈一致。
Humanity's Last Exam
Fugu Ultra 在 Humanity's Last Exam 上得分 50.0%,对比 Claude Opus 4.8 的 49.8%、Gemini 3.1 Pro 的 44.4% 与 GPT-5.5 的 41.4%。
该基准测试跨科学与学术领域的专家级知识,题目即便对领域专家也较为困难。在该基准上拿到 50% 颇为亮眼,尤其考虑到 GPT-5.5 为 41.4%。Fugu Ultra 与 GPT-5.5 之间的差距,是表中各基准中最大的。
GPQA Diamond
Fugu 与 Fugu Ultra 在 GPQA Diamond 上均得分 95.5%,Gemini 3.1 Pro 为 94.3%,GPT-5.5 为 93.6%,Claude Opus 4.8 为 92.0%。
GPQA Diamond 测试生物、化学与物理中的博士级科学问题,由领域专家编写并验证其对非专业人士的难度。标准版 Fugu 与 Fugu Ultra 在此持平,表明在该基准上编排开销并未带来额外收益,这也符合问答型、无需多步规划任务的直觉。
TerminalBench 2.1
Fugu Ultra 在 TerminalBench 2.1 上得分 82.1%,领先于 GPT-5.5 的 78.2%、Claude Opus 4.8 的 74.6% 与 Gemini 3.1 Pro 的 70.3%。TerminalBench 测试需要与终端环境交互的“代理式”编码任务,包括文件操作、shell 命令与多步执行。
这是与真实开发者工作流最相关的基准之一,Fugu Ultra 在此领先 GPT-5.5 的表现,与内测中关于网络安全评估用例的报告一致。
MRCRv2
GPT-5.5 以 94.8% 在 MRCRv2 上领先,Fugu Ultra 为 93.6%,Claude Opus 4.8 为 87.9%。MRCRv2 测试长上下文回忆能力,具体而言是模型能否从超长文档中检索特定信息。
这是唯一一个 Fugu Ultra 未居首的基准,值得那些以从大型文档中检索具体事实为主要用例的团队关注,而非多步推理或代码生成。
来源
Sakana Fugu Pricing and Availability
Fugu 现已可通过 Sakana 的控制台 console.sakana.ai 使用,并提供兼容 OpenAI 的 API。所有套餐均包含 Fugu 与 Fugu Ultra。订阅层级如下:
按量计费计划按 token 用量计费,而非月度配额。对于 Fugu Ultra(模型 ID:fugu-ultra-20260615),标准上下文长度下的价格为:输入每百万 token 5 美元、输出每百万 token 30 美元。
当上下文超过 272K token 时,费率提升为输入 10 美元、输出 45 美元。缓存输入为每百万 token 0.50 美元,超过 272K 时为 1.00 美元。Fugu 的标准定价与当前所用底层模型的费率一致,且在多代理并行时,Sakana 不会叠加收费。
需要提示的一项区域限制:在 Sakana 推进 GDPR 合规期间,Fugu 目前在欧盟或欧洲经济区成员国不可用。对欧洲团队而言,这暂时是个阻碍。Sakana 尚未公布进入欧盟的时间表。
Final Thoughts
与 OpenAI、Anthropic 与 Google 的路径不同,Fugu 的确是在做一笔“不同的赌注”。Sakana 并未在基础模型规模上硬碰硬,而是主张:在可互换的前沿模型池上进行“学习型编排”,能在真正耗时的任务上匹敌或超越单一系统——如长时代码审查、多步研究、安全评估与论文复现。
若这些基准分数经得起独立验证,它们在多数对开发者重要的指标上为这一主张提供了支持。当然,在我们重新获得 Fable 5 与 Mythos 的访问之前,无法直接与之比较。
话虽如此,确实也存在一些注意事项。
所有基准分均为 Sakana 报告。路由层不透明,会给合规敏感型工作带来阻力。对欧盟/欧洲经济区的排除限制了全球开发者社区中相当一部分人的采用。而在简单任务上的延迟权衡也确实存在:如果您只进行快速的单轮 API 调用,Fugu Ultra 的编排开销就是纯成本,毫无收益。
我认为 Fugu 真正契合的是那些运行长周期“代理式”工作流、且已在自行管理多模型复杂性的团队。如果您正维护基于 Claude 与 GPT 的自有编排“马具”,Fugu Ultra 值得认真评估。
“主权”这一叙事或许有些被高估,但能通过单一端点绕开供应商中断的务实价值却毋庸置疑。
若您希望快速了解 Fugu 所处的代理式 AI 版图,建议从 DataCamp 的 AI Agent Fundamentals 技能路径入手,涵盖大语言模型、代理与多模型系统的基础。