2020 年,《南方公园》创作者 Trey Parker 和 Matt Stone 创作了另一部引人注目的深度伪造作品:系列剧“Sassy Justice”的试播集,剧中虚构角色由包括唐纳德·特朗普、马克·扎克伯格在内的深度伪造人物“出演”。
深度伪造如何运作?
谈到深度伪造,我们往往只关注最终成品。让我们更深入一点,了解它们是如何被创建的——即使您没有技术背景,我也会确保您能看懂其工作原理。
判别式与生成式模型
判别式模型用于区分事物——例如图像是真实还是伪造。它们查看数据并尝试预测正确标签(如“真实”或“深度伪造”)。常见模型包括逻辑回归、决策树、神经网络和支持向量机。这些模型非常适合用于检测深度伪造,因为它们经过训练来捕捉被更改或被操纵的迹象。
另一方面,生成式模型尝试理解真实数据的分布,从而能创建新的、相似的数据。它们从大量真实样本中学习——例如真实人脸的图片或真实声音的片段——然后利用这些知识生成虚假但看起来很真实的媒体。深度伪造正是这样被制作出来的。
二者的主要区别在于用途:判别式模型用于检测,而生成式模型用于创建。在深度伪造技术中,两者都很重要——一个用于构建逼真的伪造内容,另一个用于识别它们。
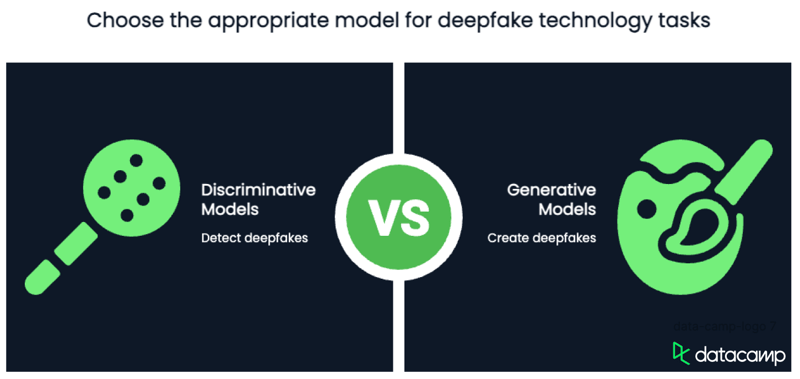
想进一步了解两者差异,请查看这篇关于生成式与判别式模型的博客。
生成对抗网络
GAN是一类生成式 AI,同时训练生成器与判别器。两者的关系可谓“良性竞争”:生成器负责生成合成内容,判别器则致力于区分真实媒体与伪造品。这种对抗促使生成器不断改进,直到其输出几乎与真实媒体难以区分。
在深度伪造中,生成式模型好比伪造名画的“艺术造假者”,而判别式模型则如同“艺术评论家”,对每件作品严格把关、找出破绽。随着接触的数据越来越多,造假者与评论家都在积累经验、精进技艺,最终带来更以假乱真的复制品与更精确的鉴别。
这一过程需要在大规模数据集上训练模型,以捕捉主体独特特征,如音色与面部特征。通过对这些数据进行分析,系统逐步建立对目标的准确表征,并据此进行逼真的模仿。
深度伪造技术
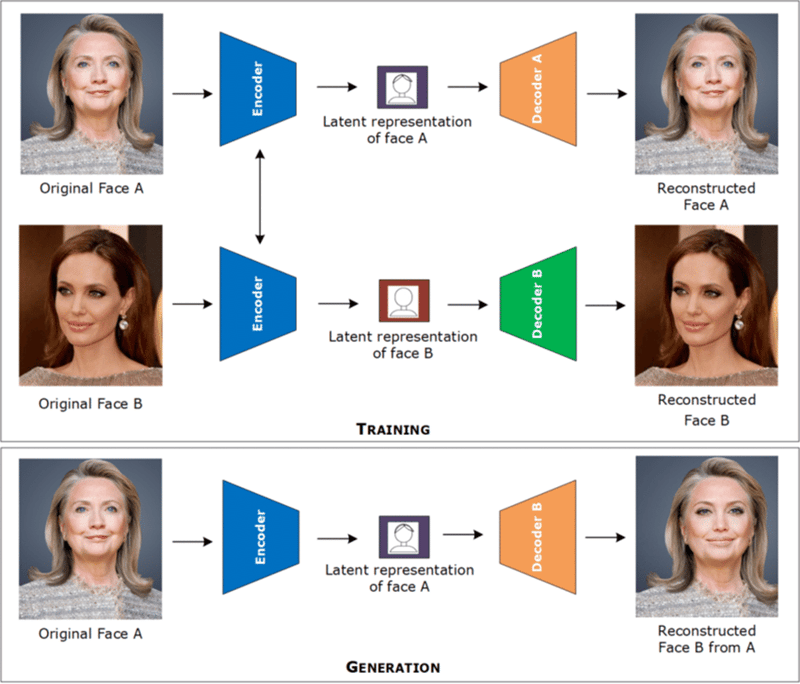
常见的人脸替换技术通常使用自编码器与卷积神经网络。这些工具在大量人物图像或视频帧上进行训练,以学习面部外观——包括形状、表情与关键特征。AI 会将这些信息转化为它能理解的形式,有点类似于对某人面部的“数字摘要”。
随后,它利用该摘要将一个人的面部表情复制并应用到另一个人身上,使换脸效果更逼真。
在唇形同步方面,神经网络不仅分析口部运动,还会分析音频输入,以使视频输出与口型精确对齐。
训练时使用带标签的数据集,将每一视频帧与对应的音频标签(指示确切的语音音素)配对,使模型学习声音与口型之间的精确对应关系。
通过同时分析这些数据与标签对,网络便能生成口型与所学关系相匹配的视频输出。
最后,语音克隆可以通过在大规模音频数据集与相应文本转录上训练语音合成模型实现。这些数据集以结构化形式捕捉个人声音的独特特征(如音高、音色与语速),供模型分析。
通过学习这些数据与标签对,模型可生成与目标人物自然嗓音高度相似的合成语音,从而逼真地模仿其声音。
深度伪造的应用
我几乎可以肯定,大多数人都见过用名演员或公众人物制作的合成搞笑视频。但深度伪造还可服务于许多其他目的,包括教育用途或提升无障碍体验。
娱乐
深度伪造为电影制作人提供了创新工具,使他们能让演员看起来更年轻,或制作与原始表演高度匹配的配音版本。
前者的一个著名例子是马丁·斯科塞斯的《爱尔兰人》(2019),其中罗伯特·德尼罗、阿尔·帕西诺和乔·佩西在闪回场景中显得年轻了数十年。由此,叙事得以自然推进,无需由多名演员分别饰演他们的年轻版本。相关过程的讲解可见此视频。
深度伪造也在革新数字角色的创作,可为电子游戏和虚拟现实生成逼真的虚拟形象。在沉浸式数字环境中打造能与用户自然交互的栩栩如生角色,为更具互动性与个性化的娱乐体验铺平道路。例如,Epic Games 的 MetaHuman Creator 让开发者能够构建在实时中动作自然、反应逼真的照片级虚拟人。
深度伪造在讽刺内容的制作上也大有可为。虽然传统模仿早已是喜剧演员的拿手戏,深度伪造为模仿增添了前所未有的细节与真实感。像 Snicklink 和 Kyle Dunnigan 等艺术家已在探索这种创新方式,推动数字讽刺的边界。
教育与无障碍
近期一个应用来自 BBC Maestro,他们推出了一门写作课程,呈现了“复现”的阿加莎·克里斯蒂(她逝世近 50 年)。
课程利用基于她书信、访谈与手稿训练的 AI 生成画面与语音建模,让“克里斯蒂”以她自己的话来授课。这清楚地展示了生成式媒体如何将历史人物带入当代教学场景。
深度伪造也有望提升无障碍体验,尤其是对言语障碍者。通过从录音中提取个人声学特征来开发合成声音,可以实现更自然的交流。
值得一提的例子是“Project Revoice”,该项目帮助运动神经元病(常导致失语)患者通过尽早采集语音录音,保存并重现其自然嗓音。
深度伪造的伦理与社会挑战
任何关于深度伪造的讨论,若不涉及其带来的挑战都是不完整的。其中最紧迫的关注点包括:
- 信任流失
- 欺诈活动
- 隐私侵犯
深度伪造可能侵蚀公众信任,使人们越来越难以分辨真实内容与被操纵内容。当虚假信息传播开来,可能影响公众舆论、损害名誉,或在关键情境中制造混乱。
在最糟糕的情况下,恶意行为者可能将深度伪造武器化,通过散播捏造的言论或行为、并归因于公众人物,来加剧政治撕裂,甚至影响选举,从而破坏社会稳定。
借助深度伪造技术逼真地冒充他人的能力,为金融诈骗或身份盗用等欺诈活动打开了大门。网络犯罪分子可以利用克隆声音诱骗他人转账或获取敏感数据的访问权限。这对银行业与网络安全等行业提出了更高要求,传统验证方法可能已不再足够。
最令人不安的应用之一是制作非自愿内容,常被用来剥削或恐吓个人。受害者可能发现自己被“置入”到伪造媒体中,从而损害名誉或侵犯隐私。这凸显了重大伦理问题:未经同意滥用个人肖像,可能给当事人的心理与职业生涯带来长期影响。
尽管风险日益增长,许多国家对深度伪造的制作与传播相关法律法规仍不明晰。虽然部分司法辖区已出台有针对性的立法,但由于技术发展迅速,执法仍然困难。缺乏明确的法律框架,使追责变得具有挑战,也引发了如何在言论自由与防止伤害之间取得平衡的问题。
如何检测深度伪造
正如我们所见,在 AI 时代,区分原始内容与被操纵内容正变得至关重要。让我们看看几种不同的方法来加以辨别。
人眼观察
尽管越来越难以识别,但仍有一些操纵的蛛丝马迹可被人眼或多或少地察觉。大多数人可能都听说过 AI 生成的人像会突然出现四个或六个手指,但其他迹象则更为微妙。
在图片中,一个信号是人脸或物体边缘处的不自然模糊或像素不一致。这意味着模型未能准确区分哪些像素属于脸部、哪些属于背景,从而留下或多或少明显的“接缝”。
另一线索是光照或阴影与周围环境不匹配,使图像看起来像是后期拼接。
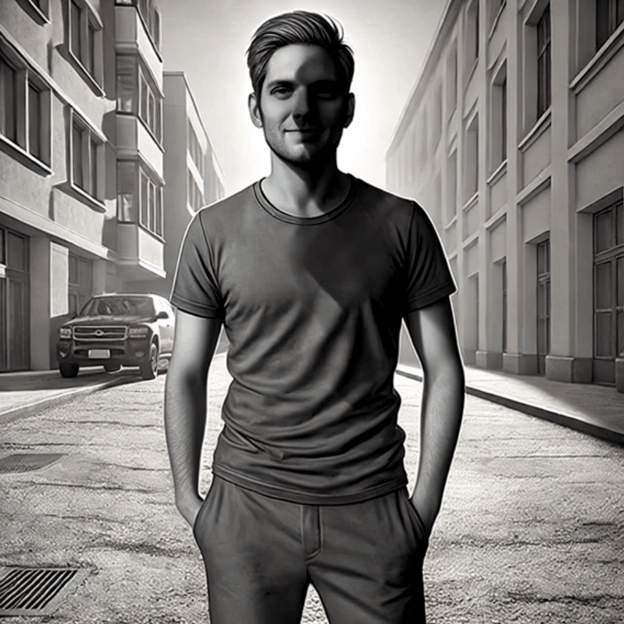
AI 生成的图片展示了光源与阴影的不匹配。
在视频中,如果光源方向在帧与帧之间突然变化,光照问题会更容易引起注意。我们还可能注意到不寻常的眨眼模式或僵硬的面部表情,与上下文不匹配,从而带来微妙的“诡异感”。在某些情况下,头部或头发周围的边缘会闪烁,暴露出视频可能被篡改。
技术方法
检测深度伪造通常需要结合多种 AI 驱动的检测方法,分析面部特征、运动及其他伪影中的不一致之处。以下是一些专门用于检测被操纵媒体内容的软件示例:
- GoogleSynthID
- Truepic
- DuckDuckGoose
- Intel FakeCatcher
- Reality Defender
- Sensity AI
- Deepware Scanner
每种工具都有其独特方法,面向各自的主要用例。与其他侧重于验证已生成内容的工具不同,Google SynthID 与 Truepic 可被视为识别 AI 生成内容的预防性措施。
Google SynthID 将不可察觉的数字水印直接嵌入 AI 生成图像中以标记其来源;而 Truepic 则在拍摄瞬间通过加密哈希与基于区块链的验证对媒体进行认证。
DuckDuckGoose 主要分析面部不一致性;Intel FakeCatcher 则擅长检测诸如血流模式等生理信号,这两者皆以取证与研究应用为目标。
Reality Defender、Sensity AI 与 Deepware Scanner 均使用深度学习模型区分真假内容,但目标用户不同:前两者可与企业安全工具集成,适用于大规模企业级检测任务;而 Deepware Scanner 则更轻量,面向普通用户的日常使用。
结语
深度伪造既代表着技术进步,也带来重大的伦理挑战。它在娱乐、教育与无障碍领域开启了令人兴奋的可能性,但被滥用时也可能导致虚假信息、欺诈与隐私侵犯。
未来,深度伪造将愈发逼真,尤其在虚拟现实应用中;与此同时,检测工具也将努力跟上日益复杂的操纵技术。
如果您想进一步了解深度伪造的理论与技术层面,DataCamp 提供了以下资源:
- 课程:生成式 AI 概念
- 文章:如何学习深度学习:完整指南
- 教程:解密生成对抗网络(GAN)
- 文章:生成式 vs 判别式模型:差异与用例
我相信大多数人已经见过深度伪造,无论是以病毒式传播的表情包,还是被巧妙篡改的新闻片段。不管我们是否愿意,它们已经成为线上世界中的常见一部分。
深度伪造是指通过人工智能创建或修改的合成媒体,如视频、图像或音频,用以以假乱真地模仿真实人物或事件。随着 AI 不断进步,区分事实与虚构将越来越难,令深度伪造既成为一种创意工具,也对真相与隐私构成威胁。
在本文中,我将介绍:
什么是深度伪造?
深度伪造是使用深度学习模型人工生成或操纵的媒体,能够产生高度逼真的但为合成的人物、物体或事件的表现形式。
尽管它们常用于模仿人脸、声音或动作,深度伪造技术也可以在视频和图像中生成或更改物体、场景、动物,甚至整个环境,从而在广泛的情境中模糊现实与虚构的界限,制造出逼真却虚假的内容。
深度伪造的起源可追溯到重要的学术突破。2014 年,Ian Goodfellow 及其同事发表了一篇关键论文,提出了生成对抗网络(GAN)。GAN(我们将在下一节探讨)为生成合成内容奠定了基础。
2016 年,Justus Thies 及其团队发表了Face2Face 论文,这是另一个里程碑,重点研究实时人脸捕捉与再现技术。其应用示例如下图所示,将某人的面部表情转移到著名演员兼政治家阿诺德·施瓦辛格的脸上。
结合源与目标图片以使用 Face2Face 转移面部表情的示例。来源: Face2Face 论文
这一现象在 2017 年底引起广泛公众关注——被篡改的视频(常见为名人换脸,尤其在成人内容中)开始在 Reddit 上流传,最终促使社交媒体平台禁止有害的深度伪造用法。
2018 年出现了最知名的案例之一:BuzzFeed 与 Jordan Peele 合作制作的一段病毒视频,将美国前总统巴拉克·奥巴马进行数字篡改,凸显了该技术重塑公共话语的潜力。