

在 Scikit-learn 中构建模型
让我们使用逻辑回归分类器来构建一个糖尿病预测模型。
首先使用 pandas 的 CSV 读取函数加载所需的 Pima 印第安人糖尿病数据集。您可以从以下链接下载数据:https://www.kaggle.com/uciml/pima-indians-diabetes-database,或从 DataCamp 选择数据集:https://www.datacamp.com/datalab/datasets。该即用型数据集支持您在 DataLab(DataCamp 的云端免费 Jupyter 笔记本)上训练模型。
加载数据
我们将通过为 pandas 的 read_csv() 函数提供 col_names 来简化列名。
#import pandas
import pandas as pd
col_names = ['pregnant', 'glucose', 'bp', 'skin', 'insulin', 'bmi', 'pedigree', 'age', 'label']
# load dataset
pima = pd.read_csv("pima-indians-diabetes.csv", header=None, names=col_names)pima.head()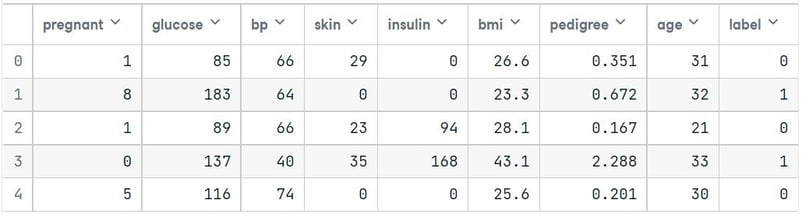
选择特征
此处需要将给定列分为两类变量:因变量(或目标变量)与自变量(或特征变量)。
#split dataset in features and target variable
feature_cols = ['pregnant', 'insulin', 'bmi', 'age','glucose','bp','pedigree']
X = pima[feature_cols] # Features
y = pima.label # Target variable切分数据
为理解模型表现,将数据集划分为训练集与测试集是一个好策略。
我们使用 train_test_split() 函数来分割数据集。您需要传入 3 个参数:features、target 和 test_set 的大小。此外,您可以使用 random_state 随机选择记录。
# split X and y into training and testing sets
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=16)此处数据集按 75:25 的比例被拆分。这意味着 75% 的数据用于模型训练,25% 用于模型测试。
模型开发与预测
首先导入 LogisticRegression 模块,并使用 LogisticRegression() 函数创建一个逻辑回归分类器对象,同时设置 random_state 以保证可复现性。
然后在训练集上使用 fit() 拟合模型,并在测试集上使用 predict() 进行预测。
# import the class
from sklearn.linear_model import LogisticRegression
# instantiate the model (using the default parameters)
logreg = LogisticRegression(random_state=16)
# fit the model with data
logreg.fit(X_train, y_train)
y_pred = logreg.predict(X_test)使用混淆矩阵进行模型评估
混淆矩阵是一张用于评估分类模型性能的表。您也可以借此可视化算法的表现。混淆矩阵的核心在于按类别汇总的正确与错误预测数量。
# import the metrics class
from sklearn import metrics
cnf_matrix = metrics.confusion_matrix(y_test, y_pred)
cnf_matrixarray([[115, 8],
[ 30, 39]])此处您可以看到以数组对象形式呈现的混淆矩阵。该矩阵维度为 2×2,因为这是一个二分类模型。您有两个类别 0 和 1。对角线上的值表示预测正确,非对角线元素表示预测错误。在输出中,115 和 39 是正确预测,30 和 8 是错误预测。
使用热力图可视化混淆矩阵
让我们使用 matplotlib 和 seaborn 以混淆矩阵的形式可视化模型结果。
这里您将使用热力图来可视化混淆矩阵。
# import required modules
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
class_names=[0,1] # name of classes
fig, ax = plt.subplots()
tick_marks = np.arange(len(class_names))
plt.xticks(tick_marks, class_names)
plt.yticks(tick_marks, class_names)
# create heatmap
sns.heatmap(pd.DataFrame(cnf_matrix), annot=True, cmap="YlGnBu" ,fmt='g')
ax.xaxis.set_label_position("top")
plt.tight_layout()
plt.title('Confusion matrix', y=1.1)
plt.ylabel('Actual label')
plt.xlabel('Predicted label')
Text(0.5,257.44,'Predicted label');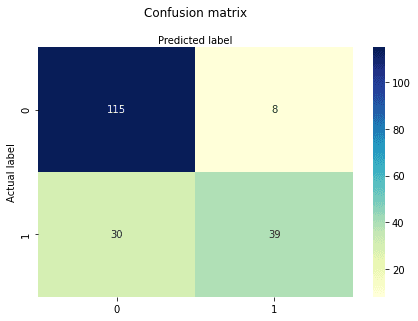
混淆矩阵评估指标
让我们使用 classification_report 来评估准确率(accuracy)、精确率(precision)和召回率(recall)。
from sklearn.metrics import classification_report
target_names = ['without diabetes', 'with diabetes']
print(classification_report(y_test, y_pred, target_names=target_names)) precision recall f1-score support
without diabetes 0.79 0.93 0.86 123
with diabetes 0.83 0.57 0.67 69
accuracy 0.80 192
macro avg 0.81 0.75 0.77 192
weighted avg 0.81 0.80 0.79 192模型的分类准确率为80%,可视为不错的精度。
精确率(Precision):强调“精确”,即模型有多准确。换言之,当模型做出正类预测时,它有多大概率是对的。在您的预测中,当逻辑回归模型预测患者将患糖尿病时,该预测有 73% 的时间是正确的。
召回率(Recall):若测试集中确有患糖尿病的患者,您的逻辑回归模型能有 57% 的概率将其识别出来。
ROC 曲线
ROC(受试者工作特征)曲线是以真正率对假正率作图,展示灵敏度与特异性的权衡。
y_pred_proba = logreg.predict_proba(X_test)[::,1]
fpr, tpr, _ = metrics.roc_curve(y_test, y_pred_proba)
auc = metrics.roc_auc_score(y_test, y_pred_proba)
plt.plot(fpr,tpr,label="data 1, auc="+str(auc))
plt.legend(loc=4)
plt.show()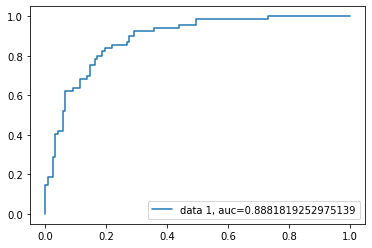
本例的 AUC 得分为 0.88。AUC 为 1 表示完美分类器,0.5 表示无效分类器。
代码源可在 DataLab 获取:Understanding Logistic Regression in Python。
优势
由于其高效而简洁,它不需要高计算能力,易于实现、易于解释,被数据分析师和科学家广泛采用。同时,它不需要对特征进行缩放。逻辑回归还能为观测提供概率分数。
劣势
逻辑回归难以处理大量的分类特征/变量,容易过拟合;它也无法解决非线性问题,因此需要对非线性特征进行变换。当自变量与目标变量不相关,或彼此高度相似/相关时,逻辑回归表现也会较差。
总结
在本教程中,您学习了关于逻辑回归的诸多内容。您了解了什么是逻辑回归、如何构建相应模型、如何可视化结果,以及一些理论背景知识。同时还回顾了 Sigmoid 函数、极大似然、混淆矩阵、ROC 曲线等基础概念。
希望您现在可以将逻辑回归技术应用于您自己的数据集。感谢阅读本教程!
如果您想继续学习逻辑回归,请学习 DataCamp 的 Machine Learning with scikit-learn 课程。您也可以通过报名 Machine Learning Scientist with Python 职业路径,开启成为机器学习工程师的旅程。
分类技术是机器学习和数据挖掘应用中不可或缺的一部分。大约 70% 的数据科学问题属于分类问题。分类问题很多,但逻辑回归较为常见,并且是解决二元分类问题的一种有用回归方法。另一类分类是多项式分类(Multinomial classification),用于处理目标变量包含多个类别的情况。例如,IRIS 数据集就是著名的多类分类示例。其他示例还包括对文章/博客/文档类别进行分类。
逻辑回归可用于多种分类问题,例如垃圾邮件检测。其他示例包括:糖尿病预测、某位客户是否会购买特定产品、客户是否会流失、用户是否会点击某个广告链接,等等。
逻辑回归是最简单、最常用的二分类机器学习算法之一。它易于实现,可作为任何二元分类问题的基线模型。其基本概念在深度学习中也很有启发性。逻辑回归用于描述并估计一个二元因变量与自变量之间的关系。
若要轻松亲自运行本教程中的所有示例代码,您可以免费创建一个 DataLab 工作簿,其中已预装 Python,并包含全部代码示例。若想进一步练习逻辑回归,请查看我们课程 Credit Risk Modeling in R 中的练习,该课程提供大量真实案例。
什么是逻辑回归?
逻辑回归是一种用于预测二元类别的统计方法。结果或目标变量具有二分性质。二分意味着只有两种可能的类别。例如,它可用于癌症检测问题。该方法计算事件发生的概率。
它是线性回归的一种特例,其中目标变量的性质为分类变量。它使用对数几率作为因变量。逻辑回归利用 logit 函数来预测二元事件发生的概率。
线性回归方程:
其中 y 为因变量,x1、x2 …… Xn 为自变量(解释变量)。
Sigmoid 函数:
在线性回归上应用 Sigmoid 函数:
逻辑回归的性质:
线性回归 vs. 逻辑回归
线性回归给出连续型输出,而逻辑回归给出离散型输出。连续输出的例子有房价和股价。离散输出的例子包括预测患者是否患癌、预测客户是否会流失。逻辑回归通常采用极大似然估计(MLE)方法估计参数,而线性回归通常采用普通最小二乘(OLS)估计;当模型误差服从正态分布时,OLS 也可视为 MLE 的特殊情形。
极大似然估计 vs. 最小二乘法
MLE 是一种“似然”最大化方法,而 OLS 是一种距离最小化的逼近方法。通过最大化似然函数,可以确定最有可能产生观测数据的参数。从统计角度看,MLE 将均值与方差作为参数,用于确定给定模型的具体参数取值。该参数集合可用于预测正态分布情形下所需的数据。
普通最小二乘法通过在给定数据点上拟合一条使平方偏差和最小(最小二乘误差)的回归直线来计算估计。二者都用于估计线性回归模型的参数。MLE 假设存在联合概率质量函数,而 OLS 在最小化距离时不需要随机性假设。
Sigmoid 函数
Sigmoid 函数(也称逻辑函数)产生一条“S”形曲线,可将任意实数映射到 0 与 1 之间的值。当曲线趋于正无穷时,预测的 y 将接近 1;当曲线趋于负无穷时,预测的 y 将接近 0。若 Sigmoid 函数的输出大于 0.5,我们可将结果分类为 1 或 YES;若小于 0.5,则可分类为 0 或 NO。比如,若输出为 0.75,我们可以用概率表述为:患者患癌的可能性为 75%。
逻辑回归的类型
逻辑回归的类型: