In 2020 maakten de South Park-bedenkers Trey Parker en Matt Stone een ander opvallend stuk deepfake-kunst: de pilot van de serie "Sassy Justice", met fictieve personages die werden “gespeeld” door deepfakes van onder meer Donald Trump en Mark Zuckerberg.
Hoe werken deepfakes?
Als we het over deepfakes hebben, focussen we vaak op het eindproduct. Laten we wat dieper graven en bekijken hoe ze worden gemaakt—ik zorg ervoor dat je dit begrijpt, ook zonder technische achtergrond.
Discriminatieve en generatieve modellen
Discriminatieve modellen worden gebruikt om dingen van elkaar te onderscheiden—bijvoorbeeld of een afbeelding echt of nep is. Ze bekijken de data en proberen het juiste label te voorspellen (zoals “echt” of “deepfake”). Veelvoorkomende modelvoorbeelden zijn logistische regressie, beslissingsbomen, neurale netwerken en support vector machines. Deze modellen zijn uitstekend voor taken als het detecteren van deepfakes, omdat ze getraind zijn om signalen te herkennen dat er iets is veranderd of gemanipuleerd.
Generatieve modellen proberen daarentegen te begrijpen hoe echte data werkt, zodat ze nieuwe, vergelijkbare data kunnen creëren. Ze leren van heel veel echte voorbeelden—zoals foto’s van echte gezichten of fragmenten van echte stemmen—en gebruiken die kennis vervolgens om nep maar realistisch ogende media te genereren. Zo worden deepfakes gemaakt.
Het belangrijkste verschil is waar ze voor worden gebruikt: discriminatieve modellen detecteren, en generatieve modellen creëren. In deepfake-technologie zijn beide belangrijk—de een om overtuigende fakes te bouwen, de ander om ze te ontmaskeren.
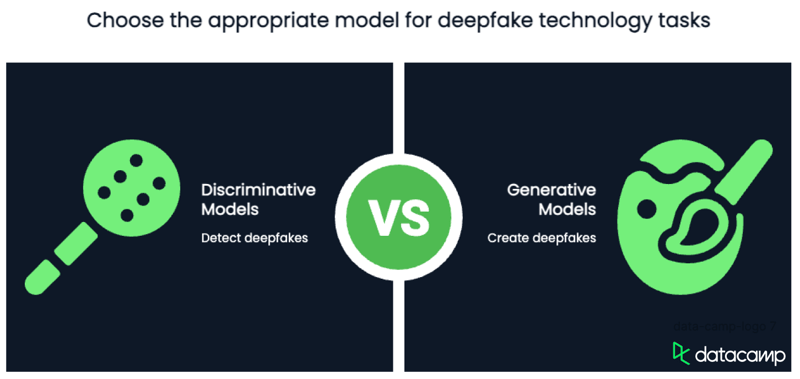
Wil je meer weten over het verschil, bekijk dan deze blog over generatieve versus discriminatieve modellen.
Generative adversarial networks
GAN’s zijn een type generatieve AI waarbij een generatief en een discriminatief model samen worden getraind. De relatie tussen beide modellen laat zich het best omschrijven als een vriendelijke competitie: terwijl de generator synthetische content creëert, probeert de discriminator echt materiaal van fakes te onderscheiden. Deze rivaliteit dwingt de generator om zijn werk te verbeteren totdat de outputs vrijwel niet meer te onderscheiden zijn van authentieke media.
Bij deepfakes speelt het generatieve model de rol van een kunstvervalser die vervalste kunstwerken schildert, terwijl het discriminatieve model een kunstcriticus belichaamt die elk stuk nauwkeurig bekijkt om de fakes te ontmaskeren. Naarmate ze meer ervaring opdoen door aan steeds meer data te worden blootgesteld, worden zowel de vervalser als de criticus beter in hun werk, wat leidt tot steeds overtuigender reproducties en nauwkeurigere beoordelingen.
Het proces omvat het trainen van modellen op uitgebreide datasets om de unieke kenmerken van een onderwerp vast te leggen, zoals stemkleur en gelaatstrekken. Door deze data te analyseren bouwt het systeem geleidelijk een nauwkeurige representatie van het doel op, die het gebruikt om die persoon overtuigend na te bootsen.
Deepfake-technieken
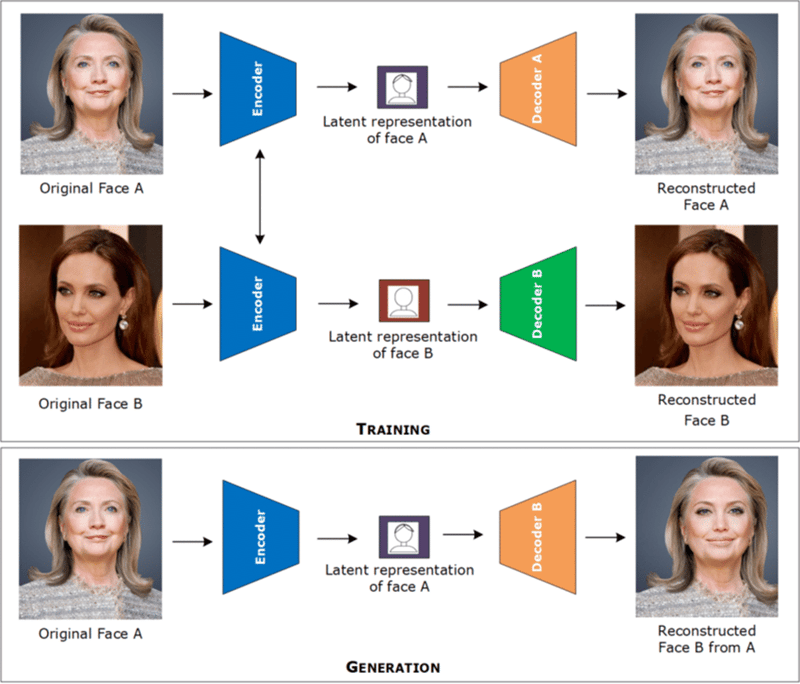
Veelgebruikte technieken voor face-swapping maken vaak gebruik van auto-encoders en convolutionele neurale netwerken. Deze tools worden getraind op veel afbeeldingen of videoframes van een persoon om te leren hoe diens gezicht eruitziet—de vorm, uitdrukkingen en belangrijkste kenmerken. De AI zet deze informatie om in een formaat dat hij begrijpt, een soort digitale samenvatting van iemands gezicht.
Vervolgens gebruikt hij die samenvatting om gezichtsuitdrukkingen van de ene persoon te kopiëren en toe te passen op een andere, zodat de face-swap er realistisch uitziet.
Voor lipsynchronisatie analyseren neurale netwerken niet alleen mondbewegingen maar ook audio-invoer om de video-uitvoer nauwkeurig op de gesproken woorden af te stemmen.
Ze worden getraind met gelabelde datasets, waarbij elk videoframe is gekoppeld aan een audiolabel dat het exact uitgesproken foneem aangeeft, zodat het model de precieze relatie tussen geluid en visuele articulatie leert.
Door deze data- en labelparen gelijktijdig te analyseren, leert het netwerk video-uitvoer te genereren waarbij de mondbewegingen overeenkomen met de geleerde relatie.
Tot slot kan stemklonen worden bereikt door spraaksynthesemodellen te trainen met uitgebreide audiodatasets gekoppeld aan bijbehorende transcripties. Deze datasets leggen de unieke kenmerken van iemands stem vast (zoals toonhoogte, klankkleur en cadans) in een gestructureerd formaat dat de modellen kunnen analyseren.
Door van deze data- en labelparen te leren, genereren de modellen synthetische spraak die de natuurlijke stemkwaliteiten van het doel nauwkeurig nabootst en diens stem overtuigend imiteert.
Toepassingen van deepfakes
Ik durf te wedden dat de meesten van ons synthetische video’s hebben gezien met beroemde acteurs of publieke figuren in humoristische situaties. Maar deepfakes kunnen nog veel andere doelen dienen, waaronder educatieve doeleinden of het vergroten van toegankelijkheid.
Amusement
Deepfakes bieden filmmakers innovatieve tools waarmee ze acteurs jonger kunnen laten lijken of nagesynchroniseerde versies van films kunnen maken die nauw aansluiten bij de oorspronkelijke acteerprestaties.
Een opvallend voorbeeld van het eerste is Martin Scorsese’s “The Irishman” (2019), waarin Robert De Niro, Al Pacino en Joe Pesci decennia jonger lijken in flashbackscènes. Zo kon het verhaal natuurlijk doorlopen zonder dat meerdere acteurs de jongere versies hoefden te spelen. Zie een uitleg van dit proces in deze video.
Deepfakes veranderen ook de creatie van digitale personages door realistische avatars te genereren voor videogames en virtual reality. Het kunnen ontwerpen van levensechte personages die op een natuurlijke manier met gebruikers interacteren in meeslepende digitale omgevingen, effent het pad voor meer interactieve en gepersonaliseerde entertainmentervaringen. Zo stelt MetaHuman Creator van Epic Games ontwikkelaars in staat fotorealistische avatars te bouwen die zich overtuigend in realtime bewegen en reageren.
Het potentieel van deepfakes voor satirische content is eveneens enorm. Terwijl traditionele imitaties al lang deel uitmaken van het repertoire van komieken, brengen deepfakes een nieuw niveau van detail en realisme in nabootsingen. Artiesten als Snicklink en Kyle Dunnigan verkennen deze innovatieve aanpak nu al en verleggen de grenzen van digitale satire.
Educatie en toegankelijkheid
Een recent gebruik van deepfake-technologie komt van BBC Maestro, dat een schrijfcursus lanceerde met een gerecreëerde Agatha Christie (bijna 50 jaar na haar overlijden).
Met AI-gegenereerde visuals en stemmodellering op basis van haar brieven, interviews en manuscripten biedt de cursus een versie van Christie die lessen geeft in haar eigen woorden. Het is een duidelijk voorbeeld van hoe generatieve media historische figuren naar hedendaagse onderwijsomgevingen kunnen brengen.
Deepfakes beloven ook de toegankelijkheid te verbeteren, vooral voor mensen met spraakbeperkingen. Het ontwikkelen van synthetische stemmen die iemands vocale kenmerken uit opnames vastleggen, kan natuurlijkere communicatie mogelijk maken.
Een vermeldenswaardig voorbeeld is “Project Revoice”, dat mensen met motorneuronziekte (wat vaak leidt tot verlies van spraak) helpt hun natuurlijke stem te bewaren en te reconstrueren door vroegtijdig stemopnames vast te leggen.
Ethische en sociale uitdagingen van deepfakes
Een discussie over deepfakes is niet compleet zonder de uitdagingen te benoemen die ze met zich meebrengen. De meest prangende zorgen zijn onder meer:
- Uitholling van vertrouwen
- Frauduleuze activiteiten
- Privacy-schendingen
Deepfakes kunnen het publieke vertrouwen uithollen doordat het steeds moeilijker wordt om echt en gemanipuleerd materiaal te onderscheiden. Wanneer valse informatie zich verspreidt, kan dit de publieke opinie vormen, reputaties schaden of verwarring veroorzaken in kritieke situaties.
In het slechtste geval kunnen deepfakes door kwaadwillenden worden ingezet om samenlevingen te destabiliseren, politieke verdeeldheid aan te wakkeren of zelfs verkiezingen te beïnvloeden door verzonnen uitspraken of handelingen toe te schrijven aan publieke figuren.
De mogelijkheid om iemand overtuigend te imiteren met deepfake-technologie opent deuren voor fraude, zoals financiële oplichting of identiteitsdiefstal. Cybercriminelen kunnen gekloonde stemmen gebruiken om mensen te misleiden tot het overmaken van geld of het verlenen van toegang tot gevoelige data. Dit baart zorgen in sectoren als bankwezen en cybersecurity, waar traditionele verificatiemethoden mogelijk niet langer volstaan.
Een van de meest verontrustende toepassingen van deepfakes is het creëren van non-consensuele content, vaak bedoeld om individuen uit te buiten of te intimideren. Slachtoffers kunnen zichzelf terugvinden in gefabriceerde media die hun reputatie schaden of hun privacy schenden. Dit benadrukt een groot ethisch probleem, aangezien misbruik van iemands gelijkenis zonder toestemming langdurige psychologische en professionele gevolgen kan hebben voor de betrokkenen.
Ondanks de toenemende risico’s blijven wetten en regelgeving rond het maken en verspreiden van deepfakes in veel landen onduidelijk. Hoewel sommige rechtsgebieden gerichte wetgeving hebben ingevoerd, blijft handhaving moeilijk door de snelle technologische vooruitgang. Het gebrek aan een duidelijke juridische structuur maakt het lastig daders ter verantwoording te roepen en roept vragen op over hoe vrijheid van meningsuiting te balanceren met de noodzaak om schade te voorkomen.
Hoe detecteer je deepfakes
Zoals we hebben gezien, wordt het onderscheiden van origineel en gemanipuleerd materiaal een cruciale vaardigheid in het AI-tijdperk. Laten we kijken naar verschillende benaderingen om ze uit elkaar te houden.
Menselijke observatie
Hoewel het steeds moeilijker wordt om ze te herkennen, zijn er aanwijzingen voor manipulatie die het menselijk oog min of meer gemakkelijk kan oppikken. De meesten van ons hebben waarschijnlijk gehoord van AI-gegenereerde afbeeldingen waarin mensen ineens vier of zes vingers hadden, maar andere signalen zijn subtieler.
Bij foto’s is een hint op manipulatie onnatuurlijke vervaging of inconsistente pixelvorming langs de randen van gezichten of objecten. Dit impliceert dat het model niet nauwkeurig wist welk pixel bij het gezicht hoort en welk bij de achtergrond, waardoor een min of meer zichtbare naad achterblijft.
Een andere aanwijzing kan verlichting of schaduwen zijn die niet overeenkomen met de omgeving, waardoor de compositie kunstmatig oogt.
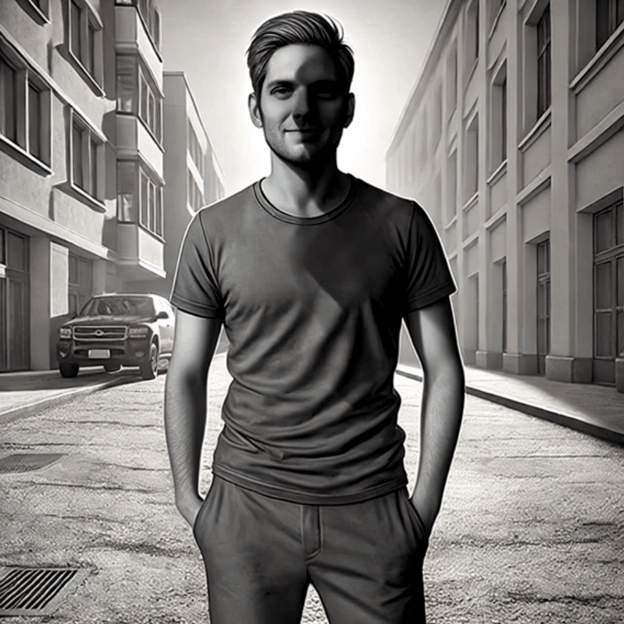
AI-gegenereerde afbeelding die een mismatch tussen de lichtbron en schaduwen illustreert.
In video’s kunnen verlichtingseffecten nog sneller opvallen als de richting van de lichtbron abrupt tussen frames verandert. We kunnen ook ongebruikelijke knipperpatronen of stijve gezichtsuitdrukkingen zien die niet passen bij de context, wat een subtiel “onheilspellend” gevoel kan geven. In sommige gevallen flikkeren de randen rond het hoofd of haar, wat verraadt dat de video mogelijk is gemanipuleerd.
Technische methoden
Het detecteren van deepfakes vereist vaak een combinatie van AI-gedreven detectiemethoden die inconsistenties in gelaatskenmerken, beweging en andere artefacten analyseren. Enkele voorbeelden van software die zich specialiseert in het detecteren van gemanipuleerde media-inhoud zijn:
- GoogleSynthID
- Truepic
- DuckDuckGoose
- Intel FakeCatcher
- Reality Defender
- Sensity AI
- Deepware Scanner
Elk hulpmiddel heeft een eigen aanpak gericht op de primaire usecase. Terwijl alle andere genoemde tools zich richten op het valideren van al gecreëerde content, kunnen Google SynthID en Truepic worden gezien als preventieve maatregelen om AI-gegenereerde content te identificeren.
Google SynthID voegt onmerkbare digitale watermerken direct toe aan AI-gegenereerde afbeeldingen om hun herkomst te markeren, terwijl Truepic cryptografische hashing en blockchain-gebaseerde verificatie gebruikt om media op het moment van opname te authenticeren.
DuckDuckGoose, dat voornamelijk gezichts-inconsistenties analyseert, en Intel FakeCatcher, dat sterk is in het detecteren van biologische signalen zoals bloedstroompatronen, richten zich beide op forensische en onderzoeks-toepassingen.
Het verschil tussen Reality Defender, Sensity AI en Deepware Scanner, die alle drie deep learning-modellen gebruiken om echt en nep te onderscheiden, zit in de doelgroep: de eerste twee bieden integratie met enterprise-beveiligingstools en zijn geschikt voor grootschalige detectiemissies bij bedrijven, terwijl Deepware Scanner een lichtere, consumentgerichte tool is voor casual gebruikers.
Conclusie
Deepfakes vormen zowel een technologische vooruitgang als een aanzienlijke ethische uitdaging. Ze bieden spannende mogelijkheden in entertainment, educatie en toegankelijkheid, maar misbruik kan leiden tot desinformatie, fraude en privacy-schendingen.
In de toekomst kunnen we verwachten dat deepfakes nog realistischer worden, vooral in toepassingen voor virtual reality, terwijl detectietools proberen gelijke tred te houden met steeds geavanceerdere manipulatie-technieken.
Wil je meer leren over de theoretische en technologische aspecten van deepfakes, dan heeft DataCamp de volgende bronnen voor je:


Ik weet zeker dat de meesten van ons al deepfakes zijn tegengekomen, of het nu gaat om virale memes of slim bewerkte nieuwsclips. Of we het nu leuk vinden of niet, ze zijn een vast onderdeel van ons online landschap geworden.
Deepfakes zijn synthetische media, zoals video, afbeeldingen of audio, die met kunstmatige intelligentie worden gemaakt of aangepast om echte mensen of gebeurtenissen overtuigend na te bootsen. Naarmate AI vooruitgaat, wordt het steeds lastiger feit en fictie te onderscheiden, waardoor deepfakes zowel een creatief hulpmiddel als een bedreiging voor waarheid en privacy zijn.
In dit artikel behandel ik:
Wat zijn deepfakes?
Deepfakes zijn kunstmatig gegenereerde of gemanipuleerde media die met deep learning-modellen worden gemaakt om zeer realistische maar synthetische representaties van mensen, objecten of gebeurtenissen te produceren.
Hoewel ze vaak worden gebruikt om menselijke gezichten, stemmen of acties na te bootsen, kunnen deepfake-technieken ook objecten, scènes, dieren of zelfs volledige omgevingen in video’s en afbeeldingen genereren of aanpassen om realistisch maar nepcontent te creëren, waardoor in uiteenlopende contexten de grens tussen werkelijkheid en fabricage vervaagt.
De oorsprong van deepfakes is terug te voeren op grote academische doorbraken. In 2014 publiceerden Ian Goodfellow en zijn collega’s een baanbrekend artikel waarin Generative Adversarial Networks (GAN’s) werden geïntroduceerd. GAN’s, die we in de volgende sectie bekijken, vormen de basis voor het genereren van synthetische content.
Een volgende mijlpaal kwam met het Face2Face-artikel uit 2016 van Justus Thies en zijn team, dat zich richtte op technieken voor realtime gezichtsregistratie en -reenactment. Een voorbeeld van het gebruik is te zien op de afbeelding hieronder, waar een gezichtsuitdrukking wordt overgezet op de beroemde acteur en politicus Arnold Schwarzenegger.
Voorbeeld van de combinatie van bron- en doelafbeeldingen om gezichtsuitdrukkingen over te zetten met Face2Face. Bron: Face2Face-artikel
Het fenomeen kreeg eind 2017 brede publieke aandacht toen gemanipuleerde video’s—vaak met gezichtsverwisselingen van beroemdheden, vooral in adult content—op Reddit begonnen te circuleren, wat er uiteindelijk toe leidde dat sociale mediaplatforms schadelijk gebruik van deepfake-technieken gingen verbieden.
Een van de bekendste voorbeelden verscheen in 2018: een virale video met een digitaal aangepaste president Barack Obama, gemaakt door BuzzFeed in samenwerking met Jordan Peele, die het potentieel van de technologie om het publieke debat te beïnvloeden onderstreepte.