课程
理解机器学习
2 小时
313.8K
实践并学习路径你的进步。
使用 Google 继续机器学习(ML)模型是统计与概率方法的计算机化实现。它们通常采用两种方法之一:生成式建模或判别式建模。
本文概述生成式与判别式模型,介绍各自常见模型,解释两种方法背后的数学原理,并结合实例讨论各类问题的适用模型。
给定一组示例数据点D及其对应标签L,生成式模型 学习其 联合概率分布P(D, L)。随后利用该分布生成与训练样本相似的新数据,或用于解决分类问题。
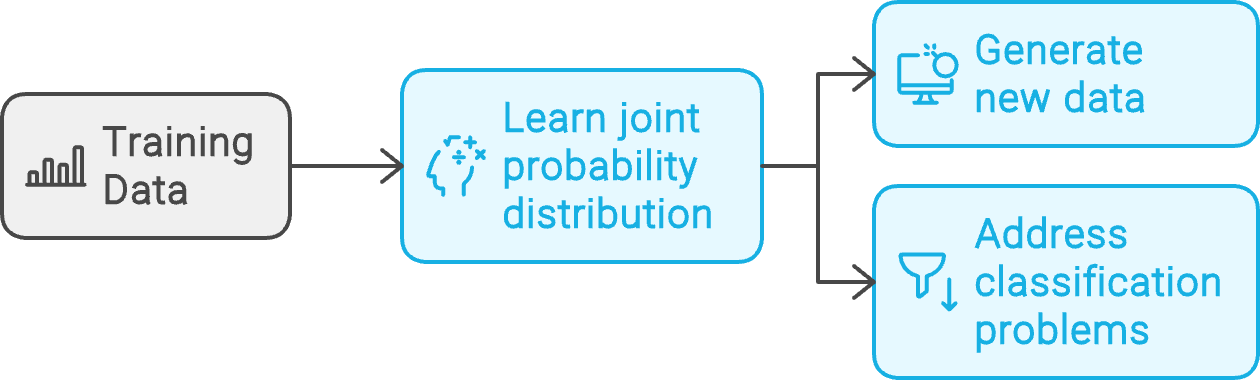
生成式模型工作流程。使用 napkin.ai 制作
以下内容将结合示例介绍生成式模型的基本原理。
朴素贝叶斯模型基于贝叶斯定理。该定理给出在事件B已知为真时事件A发生的条件概率P(A | B)。这被称为在给定B时A的后验概率。
单独来看,事件A的概率P(A)称为先验概率。朴素贝叶斯模型假设A与B相互独立——因此称为“朴素”。若A与B存在依赖关系,则传统贝叶斯定理不再适用,此时朴素贝叶斯模型并非合适选择。
贝叶斯模型是生成式模型,因为它们对联合概率分布建模。训练过程学习联合概率——P(A, B)。训练完成后,可用于预测具有最高概率P(A)的A取值。此外,贝叶斯模型还能用于分类,因为它们可以(利用贝叶斯法则)计算条件概率。
若想学习如何在实践中使用朴素贝叶斯模型,请参考关于使用 scikit-learn 与 Python 构建朴素贝叶斯模型的教程。
高斯混合模型(GMM)属于混合模型的一类。其独特前提是:底层数据由多个统计分布组合而成,而非单一分布。
在 GMM 中,整体总体被视为不同子总体的组合,每个子总体服从一个高斯分布。实质上,数据分布被分析为若干个高斯分布的加权平均。
GMM 能捕捉数据集的概率分布,因此常用于离群点分析和无监督分类。这类任务将训练数据集视为随机样本,对总体构建统计模型。
关于 GMM 的实践细节,可参考课程R 语言中的混合模型。
生成对抗网络(GAN)是一类基于神经网络的模型。它由两部分组成:生成器与判别器。生成器网络被训练以生成与训练样本相似的向量,判别器被训练以区分原始样本与生成器产生的样本。
本质上,生成器与判别器的训练目标相反,因而相互对抗,名称中“对抗”由此而来。
生成器与判别器在同一训练循环中共同训练。随着生成器愈发擅长生成逼真样本,判别器则学习区分原始样本与生成样本。训练持续进行,直至生成器生成的样本与训练数据高度相似,使判别器无法区分。
训练完成后,使用生成器生成与原始样本相似的高保真合成数据。
隐马尔可夫模型(HMM)适用于序列数据。马尔可夫过程(或马尔可夫链)用于对序列数据建模。其前提是,序列中的下一个元素xn+1仅依赖其前一个元素xn,而不依赖之前的任意元素{x1、x2、…、xn-1}。马尔可夫模型假设序列数据可由具有隐藏状态的马尔可夫过程表示。
这些状态生成序列中的下一个元素:
马尔可夫模型通过转移概率(从一个状态到另一个状态)与发射概率(在给定状态下生成某个序列元素)来表示。
HMM 将训练数据集建模为马尔可夫过程。训练目标是确定能最大化生成示例序列概率的转移与发射概率。因此,给定一个序列,训练好的马尔可夫模型可以生成其后续元素。
若想了解其实际实现,请参阅关于Python 中的马尔可夫链教程。
给定由数据点D及其对应标签L组成的训练数据集,判别式模型学习条件概率分布P(D | L)。随后利用该条件概率分布预测新数据点的类别。
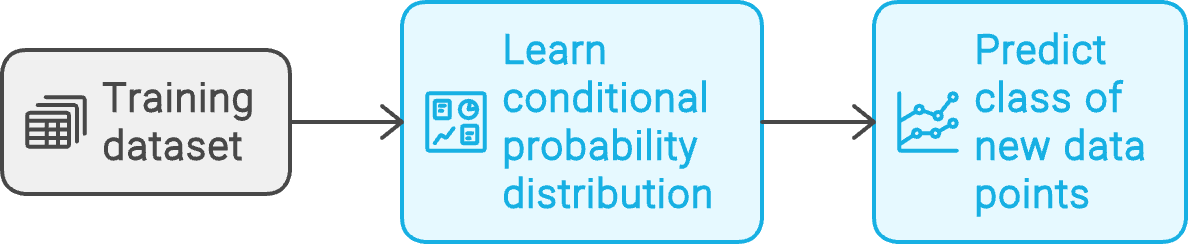
判别式模型工作流程。使用 napkin.ai 制作
判别式模型通常用于解决分类问题。以下示例展示其典型应用。
K 近邻(KNN)是较早的机器学习模型之一。其基于这样的前提:在给定的数据点分布中,相似的样本彼此相近。
KNN 模型为非参数模型,不包含诸如回归系数之类的参数。它既可用于分类,也可用于回归问题。
输入数据点的类别与其k个最近邻的类别相同。数据点的预测值为其k个最近邻的平均值。k(所考虑的最近邻数量)可视为模型的超参数,用于调节模型行为,但不会直接决定模型输出。
逻辑回归与线性回归类似,尝试基于一个或多个自变量预测因变量的取值。在线性回归中,因变量为连续值;而在逻辑回归中,因变量为离散值,例如:
线性回归预测数值;逻辑回归中,预测量为胜算比的对数。
对事件A,其概率为P(A),则胜算比为P(A) / (1 - P(A))。使用(胜算比的)对数可使训练过程更平滑、收敛更快。鉴于其能将输入划分到各类别,逻辑模型用于判别式场景。
如需更多实践入门,请参阅Python 中的逻辑回归指南。
您也可以使用偏重统计的编程语言 R 来实现逻辑回归,详见使用 R 进行逻辑回归教程。
支持向量机用于确定最优分隔不同类别数据点的直线。在二维平面中,给定两类数据点的集合,SVM 会预测一条(理想情况下)能将两类点清晰分开的直线。
该直线称为决策边界。在三维或更高维数据中,它成为超平面。位于该虚拟直线(或超平面)最近处的(任一类别的)数据点称为模型的支持向量。这些点最难分类,因为它们数值接近。
分隔直线与支持向量之间的距离称为间隔。SVM 训练旨在找到能最大化该间隔的决策边界。实际中,数据往往具备高维度,分隔直线即为高维超平面。
SVM 也用于多分类问题。
想了解更多 SVM 内容,请参阅使用 Python 的 scikit-learn 构建 SVM 的指南。除了 Python,您也可以使用 R 实现 SVM,详见R 中的 SVM 指南。
决策树由若干决策节点构成,呈树状结构。
最上方的节点为根节点。通向最终输出的节点称为叶节点或终端节点。中间的非叶节点称为内部节点。根节点输出传递至中间节点,每个节点的结果要么为最终输出,要么继续(分支)到下一个节点。
树的每个节点会沿某一特征划分数据集。例如,审批贷款申请的决策树可能包含按净收入划分申请的节点。
训练过程会确定每个决策的合适阈值。例如,净收入低于某一数额的申请会被直接拒绝,其余申请在随后的节点中进一步处理,这些节点将考虑净资产等其他特征。
有关决策树的实践指南,请参阅使用 Python 构建决策树教程,或完整课程基于树模型的 Python 机器学习。
决策树的主要缺点是过拟合,导致样本外表现欠佳。决策森林尝试解决该问题。决策森林由多棵树组成。与单棵决策树必须考虑完整特征集不同,森林中的每棵树仅使用特征集的随机子集。这种随机性有助于应对噪声数据集的方差。
森林的输出通过组合(如取平均)各棵树的输出获得。
若想了解如何实现随机森林,请参阅使用 scikit-learn 构建随机森林分类器指南。
神经网络由若干神经元组构成。每个神经元实现一个线性函数,将神经元的权重与输入向量相乘。
在线性函数之后是一个非线性激活函数。激活函数基于线性函数的输出决定每个神经元的输出。因此,简单神经网络在概念上可视为由一系列线性方程与非线性激活共同构成。
神经网络的输入层将输入(表示为向量)与一组权重和激活函数相乘,该输出传递至下一层,后者执行类似运算。
隐藏层位于输入层与输出层之间。 最后一个隐藏层连接输出层。复杂问题通常需要包含多个隐藏层的神经网络,称为深度神经网络(DNN)。
在分类问题中,常见做法是将输出神经元的数量设置为类别数,预测类别对应于取值最高的神经元。在回归问题中,单个输出神经元给出预测输出。神经元之间的线性关系可表示线性回归方程。
想更深入了解该主题,请查看关于神经网络的博文。
某些任务(如分类)可由两类模型解决。但总体而言,由于数学方法不同,判别式与生成式模型常对应不同的应用场景。理解这些差异及其对不同问题适用性的影响至关重要。
生成式模型可预测序列中的下一个值,或在给定文本时生成图像(反之亦然)。为完成此类任务,模型必须学习在不同输入下该生成何种输出。模型使用输入与输出的联合概率分布。
为理解底层数学,我们从一个简单示例开始。单个随机变量的行为由其概率密度函数(PDF)描述。
随机变量X的 PDF 可用于确定X在不同取值处的概率。例如,若X的 PDF 为f(x),则X位于A与B之间的概率为:

在整个取值范围内,X的总概率为 1,表示为:

上述表达式也可写为:
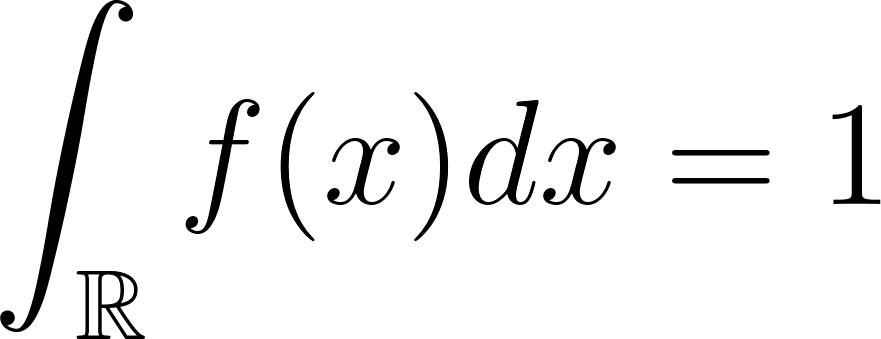
对于两个变量X与Y的联合 PDF,其在整个范围上的积分为 1:

联合概率分布映射X与Y的整个概率空间。要评估联合概率P(X, Y)落在区域G内的概率,将联合 PDF 在G上积分:

相对地,判别式模型只关注条件概率分布。必要时,生成式模型会通过边缘概率来估计条件概率。
给定联合概率分布fXY(x,y),随机变量Y在取值y处(对所有 X取值)对应的边缘概率为:
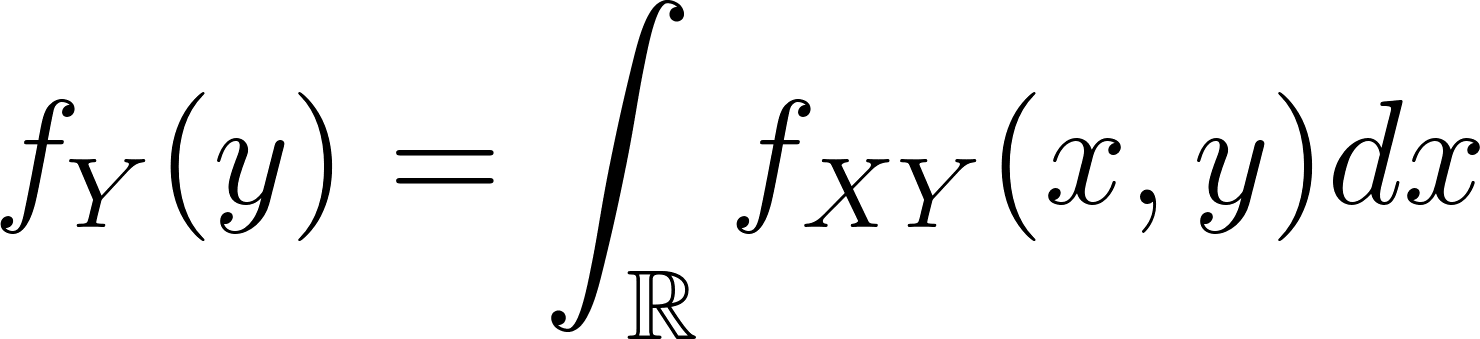
类似于贝叶斯法则,X的条件 PDF 可表示为:
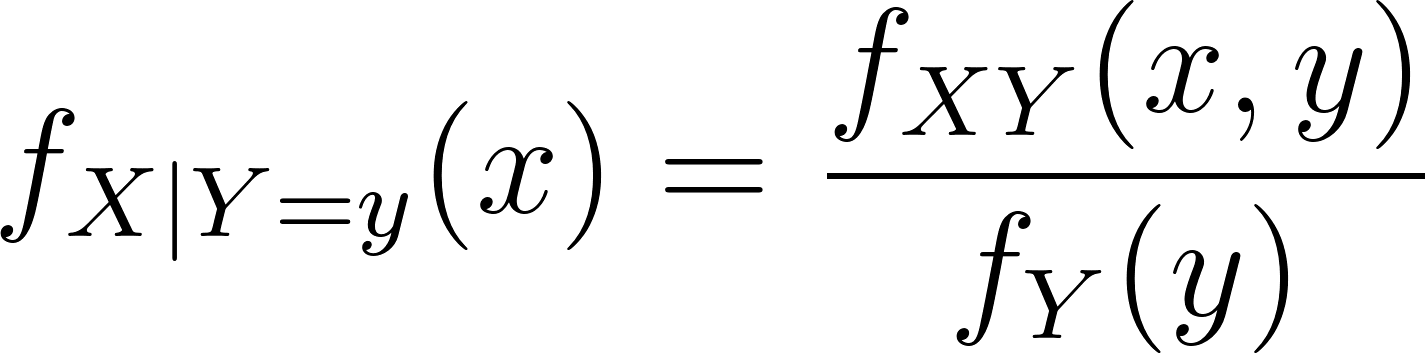
上述表达式是条件概率的积分形式,更常见的写法是:
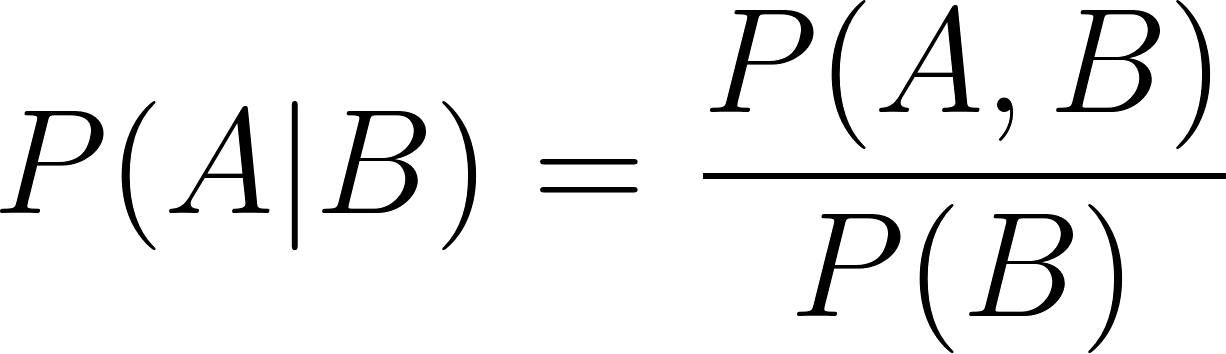
同理,
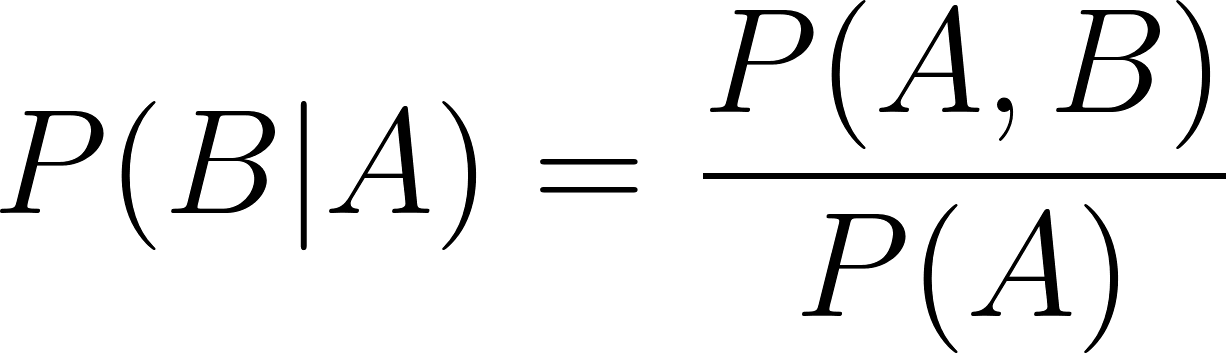
在上述两个条件概率公式中:
为计算条件概率,生成式模型遵循两步:
而判别式模型只需一步(更为简单):
生成式模型拥有边缘概率P(A)与P(B),以及联合 PDFP(A, B)。据此,它能同样方便地计算P(A | B)或P(B | A)。这是朴素贝叶斯分类器的基本思想。因此,生成式模型可以完成如下任务:
这使生成式模型更灵活、用途更广。另一方面,它们在训练中固有更高复杂性,因为:
相反,判别式模型只关注条件概率。基于训练数据,可以直接估计条件概率,而无需估计联合或边缘概率。
因此,判别式模型更易训练。然而,若某个判别式模型已学习了条件概率P(A | B),它只能执行涉及该特定条件概率的任务,除此之外无能为力。
生成式模型足够灵活,可同时用于生成式与判别式任务。训练期间,模型学习联合 PDF 与边缘分布;推理期间,模型需基于联合分布与相应边缘概率计算条件概率。因此,在判别式任务上的推理更慢。
相反,判别式模型直接(以数值方式)学习条件概率。在推理时,它们基于输入数据一步估计条件概率。
此外,由于判别式模型仅专注于估计单一量(条件概率),通常表现出更高准确性。联合 PDF 相比单纯条件概率蕴含更多不确定性,这种额外不确定性会体现在生成式模型在分类任务中的相对较低准确率上。
基于前文讨论,下表总结了生成式与判别式模型的差异。
|
生成式模型 |
判别式模型 |
|
|
目标 |
捕捉联合概率与边缘概率。使用贝叶斯法则计算条件概率。 |
仅捕捉条件概率。对联合或边缘概率无信息。 |
|
数据生成 |
可基于训练数据集生成新数据点。例如,训练于手写数字的数据集可生成新的“伪造”数字。 |
无法生成新数据点。主要侧重区分不同类别的数据。 |
|
主要用例 |
既可用于生成式任务(如数据合成),也可用于判别式任务(如分类)。 |
仅可用于判别式任务,如分类或回归。 |
|
推理性能 |
由于需要复杂计算,推理更慢。即便是简单任务也需计算边缘与联合概率并应用贝叶斯法则。 |
推理更快,因为可直接计算条件概率,无需涉及贝叶斯法则。 |
|
缺失数据处理 |
通过建模底层概率分布,更擅长处理缺失数据,便于“填补空缺”。过拟合风险较低。 |
处理缺失数据的效果较差。过拟合风险更高,因为模型专注于寻找类别之间的分隔超平面。 |
|
收敛 |
往往用更少的训练样本更快收敛,但通常误差更大,尤其在分类任务中,因为条件概率需通过对联合分布建模间接计算。 |
通常需要更多数据训练,可能收敛更慢。但误差更低,尤其在分类任务中,因为其直接建模条件概率,无需估计联合分布。 |
|
模型复杂度 |
通常更复杂,因为要对整个数据分布建模,包括特征与标签之间的相互作用。 |
通常更简洁,因为只需建模类别之间的决策边界或分隔超平面。 |
|
模型示例 |
朴素贝叶斯、隐马尔可夫模型(HMM)、生成对抗网络(GAN)、变分自编码器(VAE)。 |
逻辑回归、支持向量机(SVM)、神经网络、决策树。 |
|
模型灵活性 |
应用更灵活(可同时处理生成式与判别式任务)。 |
灵活性较低(局限于判别式任务)。 |
|
错误率 |
在分类任务中错误率更高,因为采用间接估计方法。 |
在分类任务中错误率更低,因为直接围绕条件概率进行训练。 |
顾名思义,生成式模型尤其适用于需要生成符合训练数据模式的新数据的任务。
常见用例如下:
对许多计算机视觉模型而言,大规模训练图像数据集至关重要。这些模型需要在同一图像或特征的多种变体上进行训练。
从不同角度、背景或色调拍摄同一物体并不总是现实可行。许多特定任务的图像数据集规模也往往受限,因为构建它们需要领域专业技能。例如,若要创建特定肺部疾病的 X 光片数据集,您需要获得肺科医生、影像科实验室以及患者与医院的同意。
此类情形下,最务实的做法是先创建一个规模较小但高度精选、相关性强的数据集,然后合成生成与原始数据集相似的新数据点。
根据文本描述生成新图像,或在给定输入文本时生成新文本。能够处理此类任务的唯有生成式模型。
图像生成模型如DALL-E、MidJourney 与 Stable Diffusion 常用于生成符合特定描述且不侵犯现有版权的图像。
同样,大型语言模型(LLM)常用于生成虚构故事情节、营销标语与口号、文档摘要等内容。
生成式模型用于基于底层数据的联合概率分布的任务。在金融与风险管理中,建模资产收益的联合分布以预测投资组合的预期风险与回报特征是常见做法。
例如,投资经理可能希望了解两只不同股票价格同时上涨或下跌的概率——联合 PDF 能回答此类问题。
在“生成式模型”这一术语被广泛采用之前,金融服务业早已长期使用这些统计方法。
无监督分类等问题尤其适合高斯混合模型。在此类问题中,您拥有大量数据点,但并不清楚它们属于多少或哪些类别。合理的预期是数据来自多种分布的组合,GMM 正可对此建模。
若类别的数量与列表事先已知,则判别式方法更合适。
GMM 也适用于离群点分析(异常检测、欺诈检测等),其中“常见”的数据(如不同客户群体的行为)可建模为不同分布的组合。显著偏离任一模式的数据点即为异常。
涉及序列的问题通常用隐马尔可夫模型求解。常见用例如基因组序列建模与重测序。
HMM 也用于语音识别,帮助在给定前序音节时预测下一个音节。序列建模同样常见于物流应用,如包裹投递计划。类似地,传染病的传播常用马尔可夫链进行建模。
从数学上看,当只关心条件概率而非联合概率时使用判别式模型。因此,判别式模型通常用于分类与预测问题。
例如:
监督分类问题的类别(分类)事先已知。这是 KNN 与 SVM 的典型用例。
您拥有一大批数据点,例如客户行为数据,包括消费模式、购买金额、购买频率、退货记录等;您需要据此将客户分为高消费、价格敏感、常客、非活跃等不同类别。与之相对的无监督分类问题,如前文所述,通常使用 GMM。
在分类与回归等预测任务中,速度与准确性往往是首要考虑。原则上,生成式模型也能解决这类问题。
尤其在存在缺失数据点、可用于训练的数据集有限或预计会经常新增类别的情况下,更倾向使用生成式模型。
然而,在大多数标准用例中,由于涉及联合概率分布的计算,生成式模型在预测任务上错误率更高、推理更慢。因此,在具备充足健康训练数据的标准分类与回归问题中,判别式模型因其更佳的性能而更受青睐。
对于仅关注分类结果而不关心底层数据建模的任务,优先选择判别式模型。
例如,若要将音频录音按语言进行分类,并不需要理解语言与语法的模型。对分类问题而言,使用语音识别模型反而过度。只需用判别式模型关注决策边界即可。因此,您可以用简单的神经网络,而无需LLM;或使用逻辑回归,而非贝叶斯模型。
当各步骤的选择明确无歧义时,多步决策适合使用决策树。决策树常作为初筛工具,用于筛选需要深入分析的数据点。
例如,欺诈检测常用 GMM 等复杂模型来求解。但无论使用何种模型,高风险交易几乎都会由人工复核。因此,另一种做法是使用决策树标记一批潜在可疑交易以供进一步人工调查。
决策树也广泛用于业务运营中,目标是基于预设条件决定正确行动方案。这类任务既不需要生成式模型,也不需要更复杂的判别式模型(如神经网络)。
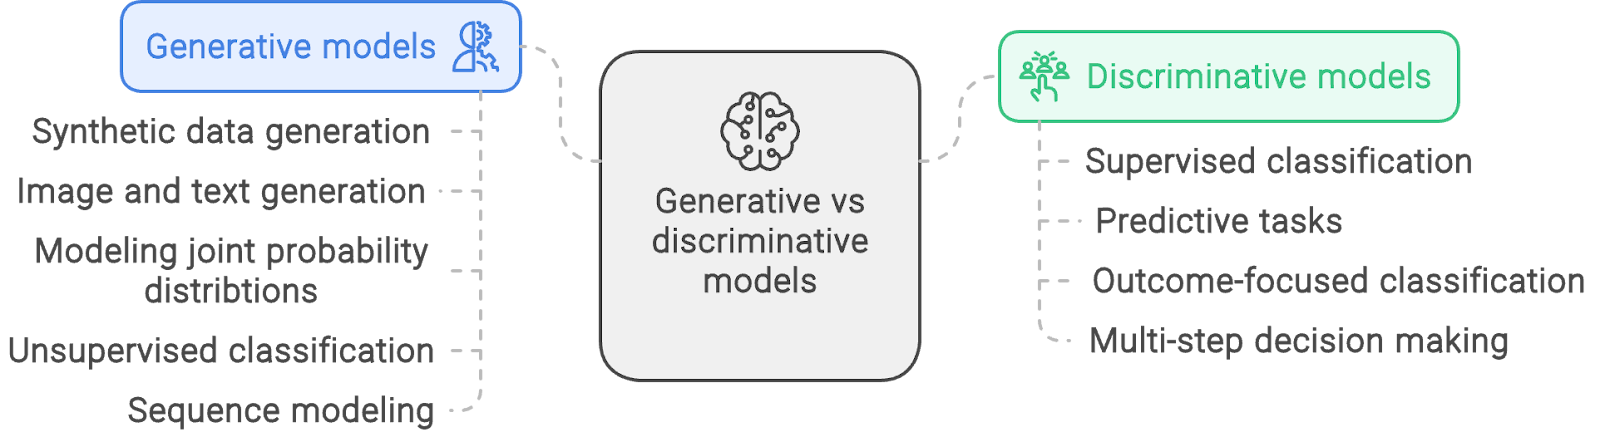
生成式与判别式模型的示例应用。使用 napkin.ai 制作
本文阐释了机器学习两大方法——生成式与判别式模型的基本原理与主要差异。
尽管大多数机器学习基于概率方法,生成式模型基于联合概率分布,而判别式模型仅使用条件概率。因此,两类模型在应用与性能特征上各不相同。在模型选择繁多的背景下,为任务选择合适工具尤为重要。
在理解模型类型及其差异的概念之外,更重要的是亲自动手构建模型。从探讨监督学习方法与构建简单逻辑回归模型的博文开始吧。