

在那次试验之后,我想做点更经典的东西。具体来说,我想到的是在没有网络时打开浏览器会出现的 Chrome 恐龙小游戏。
Make me a simple side-scrolling game like the Chrome dinosaur that jumps over cactuses when the internet is down.
于是,Gemini Runner 登场:
一些小细节也让我会心一笑。Gemini Runner 有同样的繁星夜空,这甚至不在提示里。输掉时它还会显示“Extinct”。
多模态能力
为了测试多模态能力,我上传了一张六岁小孩画的图片。
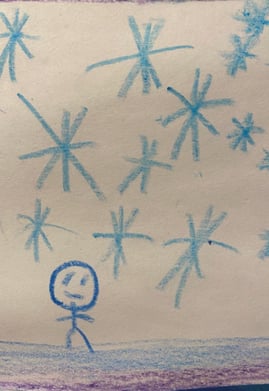
随后我让它把这幅场景做成一个简单的游戏。我的提示如下:
Generate a simple browser game using the elements in this image. Base the game on what’s shown.
在这个提示中,我刻意没有描述图片里的任何具体元素,因为我想看看它能否解读视觉内容,并围绕所见生成游戏。
结果是一个名为Snowy’s Day的小游戏,您可以移动火柴人去接住飘落的雪。
如您所见,游戏元素直接取自我分享的图片。我对其在精神内核上的忠实度印象深刻,但它肯定算不上世界上最好玩的游戏。不过,也许对六岁小孩来说会很好玩。
顺带一提:Gemini 的确识别出图里的是雪。我还为此有点内疚,因为我以为他画的是星星!
Gemini 3 基准测试
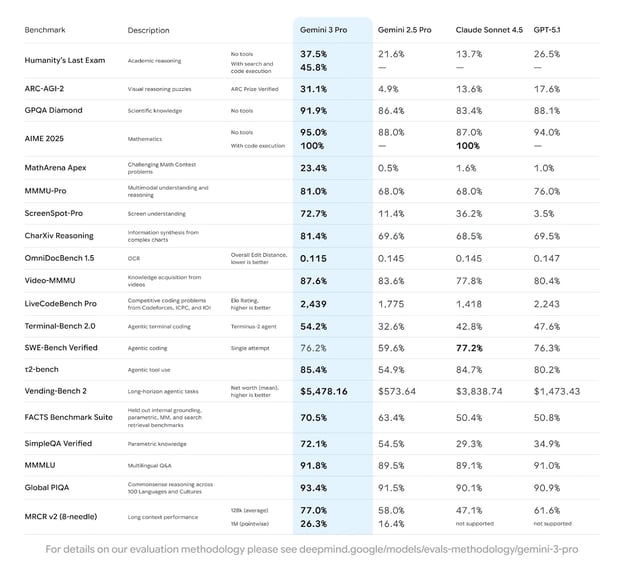
Google 为 Gemini 3 Pro 与 Gemini Deep Think 提供了详尽的基准数据,整体结果相当亮眼。
Gemini 3 Pro 基准
就纯粹的推理能力而言,Gemini 3 Pro 展示了 Google 所谓的“博士级推理”。亮点如下:
视觉推理
视觉推理实现了巨大飞跃。
- 在 ARC-AGI-2 上,Gemini 3 Pro 取得 31.1% 的得分。这相比 Gemini 2.5 Pro 的 4.9% 有了巨大提升,且大幅领先 Claude Sonnet 4.5 与 GPT-5.1。
- 同样地,在测试屏幕理解的 ScreenSpot-Pro 上,Gemini 3 Pro 达到 72.7%,远超 Claude Sonnet 4.5(36.2%)与 GPT-5.1(3.5%)。
这两项都标志着模型对视觉信息的理解与推理能力实现了巨大跨越。
数学
在 MathArena Apex 中以 23.4% 的得分,Gemini 3 Pro 压倒性领先。横向对比:Gemini 2.5 Pro 为 0.5%,Claude Sonnet 4.5 为 1.6%,GPT-5.1 仅为 1.0%。这为数学推理的前沿模型树立了新标杆。
长时程规划
为衡量长时程规划,有一个名为 Vending-Bench 2 的基准,会模拟运营一台售货机长达一整年。模型需持续就库存、定价等做出决策。它测试的是 AI 能否在数以千计的连续选择中,始终保持与目标一致的理性决策,而不出现失控。
在该基准上,Gemini 3 Pro 的平均净资产为 5,478.16 美元。对比 Claude Sonnet 4.5(3,838.74 美元)与 GPT-5.1(1,473.43 美元)。这听起来像个冷门基准,但对于需要跨越数天或数周管理任务的真实世界 AI 智能体而言,这类稳定性非常关键。
其他基准
Gemini 3 Pro 在多项其他基准上也表现强劲。它在多模态理解(MMMU-Pro)、视频理解(Video-MMMU)、图表推理(CharXiv)与竞赛编程(LiveCodeBench Pro)上领跑。
一个值得注意的例外是:在软件工程基准 SWE-Bench Verified 上,Claude Sonnet 4.5 以微弱优势领先 Gemini 3 Pro。
Gemini 3 Deep Think 模式基准
现在来看 Gemini Deep Think 的基准。这是当前由安全测试人员评估的增强推理模式,预计将在未来数周内向 Google AI Ultra 订阅用户开放。
您可能会问:既然 Gemini 3 Pro 已经登顶排行榜,Deep Think 模式还有何意义?答案是有些问题将受益于延长推理时间。Deep Think 通过并行与延展推理,在尤其困难的任务上投入更多算力。它设计为花更久时间,但对于最难的推理问题,这段额外处理时间会带来实实在在的提升,正如下列基准所反映:
新颖问题求解
对我而言,ARC-AGI-2 的成绩最为亮眼。启用 Deep Think 模式的 Gemini 3 在 ARC-AGI-2 上取得 45.1%。(这是与 ARC Prize 竞赛相关的官方验证版本。)该测试允许模型编写并运行代码作为推理工具,实质上用编程来辅助思考。
为何重要?ARC-AGI-2 专门测试模型解决新颖且不熟悉挑战的能力。这些问题模型从未见过,无法仅凭训练数据的模式匹配来应对。历史上,这一直是 AI 系统最难的能力之一,因此高分意味着我们看到的是真正的推理能力,而非记忆背诵。
极其困难的问题
在 Humanity's Last Exam 上,未使用任何工具的 Deep Think 模式取得 37.5%。启用 Deep Think 后,这一成绩跃升至 41.0%。作为参考,GPT-5.1 的得分为 26.5%。
这个基准很有意思,因为它旨在测试人类理解极限处的知识与推理。可以把它看作需要深厚专业知识才能解决的极难问题。Gemini 3 借助 Deep Think 能正确回答三分之一以上的问题,说明它不仅在复述信息,而是在对极其复杂与模糊的问题进行真正的推理。
研究生水平的科学
Deep Think 模式在 GPQA Diamond(研究生水平的科学问答基准)上取得 A 的成绩——91.9%。启用 Deep Think 后进一步提升至 93.8%。尽管 91.9% 已相当出色,更有意思的是这表明 Deep Think 还能在此基线上继续改进。
如何访问 Gemini 3?
Gemini 3 Pro 现已在多平台上线。您可以立即在 Gemini 应用中使用它。它也为搜索中的 AI 模式提供支持,因此您可能在不知不觉中已经与 Gemini 3 交互。
如果您是开发者,您可以通过 Google AI Studio、Vertex AI 与 Gemini CLI 的 Gemini API 访问 Gemini 3 Pro。它也已登陆新发布的 Google Antigravity 平台,以及 Cursor、GitHub、JetBrains、Manus 与 Replit 等多款第三方工具。
Google AI Ultra 订阅用户可访问 Gemini 3 Pro 以及用于构建多步智能体的实验功能 Gemini Agent。Deep Think 目前正由安全测试人员评估,待完成更多安全评估后,将在未来数周内向 Ultra 订阅用户开放。
对于学生,Google 推出了一年期免费计划,提供对 Gemini 3 Pro 的访问权限、无限图片上传、2 TB 存储空间,以及 NotebookLM 等附加工具。
Google 如何使用 Gemini 3
Gemini 3 Pro 已经在实际环境中投入使用,Google 已在两项关键功能中启用它:
Google 搜索的 AI 概览
Google 对这一新模型信心十足,罕见地将其直接整合进 Google 搜索。尽管自四月以来 AI 概览已在越来越多页面中上线,但自发布日起,Gemini 3 Pro 将为这些概览提供支持。
Gemini 3 与 Google Antigravity
本次发布的另一大亮点是全新的具身智能体开发平台——Google Antigravity。
这一新工具由 Gemini 3 的推理、工具使用与智能体编码能力驱动。Google 承诺它将带来类似 AI IDE 的熟悉体验,但智能体将能直接访问编辑器、终端与浏览器,自主帮助您规划、编写与检查复杂项目。
Antigravity 将与 Gemini 3 Pro、用于浏览器控制的Gemini 2.5 Computer Use 模型,以及用于图像编辑的Nano Banana(Gemini 2.5 Image)对接。
结语
通过此次发布,Google 明确传达了一个信号:他们重回“最强 AI 模型”之争,并以极快速度在整个产品生态中大规模落地。就规格而言,很难不同意这一点;在多模态理解方面,Gemini 3 Pro 的确像是当下全球最强的 AI 模型。
一如既往,Google 具备得天独厚的优势。其云基础设施、定制芯片与垂直整合的 AI 栈相互加持,带来少有对手能匹敌的性能。由于提升覆盖推理、编程、多模态理解与长时程规划等方方面面,这强烈暗示 Google 在 Gemini 3 Pro 上对核心架构进行了基础性改进。更重要的是,Google 似乎正围绕具体的商业用例进行构建,我们使用 AI 的方式正迅速变得更加多样与有趣。
如果您需要系统入门 AI 相关内容,建议从AI Fundamentals 技能路径开始。
Gemini 3 常见问题
Gemini 3 Pro 与 Gemini 3 Deep Think 有何区别?
Gemini 3 Pro 是在 Google 各类应用与开发者平台上提供的主力模型,针对日常使用进行了优化。Deep Think 是可选模式,面向高级用户提供更慢但更先进的多步推理,待 Google 完成安全测试后开放。
百万 Token 的上下文窗口有何用处?
它能让 Gemini 3 处理超大规模输入,如完整研究论文、整个代码库或冗长的视频转录,而无需切分,从而在大型数据集上实现更深入且连贯的推理。
如何免费试用 Gemini 3 Pro?
Gemini 3 Pro 面向所有用户在 Gemini 应用中提供,同时也面向 Google AI Pro 与 Ultra 订阅用户开放,并为搜索中的 AI 模式提供支持。开发者可在 AI Studio 通过 API 访问,也可在全新的具身智能体开发平台 Google Antigravity 上使用。学生可获得为期一年的免费 Gemini Pro 计划,包含 Gemini 3 Pro 访问权限、2 TB 的 Google Drive 存储,以及无限图片上传。
什么是 Google Antigravity?它与 AI Studio 或 Vertex AI 有何不同?
Antigravity 是 Google 的新型智能体驱动开发平台,类似一款由 AI 加持的 IDE,智能体可直接编写、测试并使用工具。AI Studio 与 Vertex AI 是用于部署模型的 API 与平台;Antigravity 则把这些能力带入一个可实践、可协作的工作空间。
为何 Gemini 3 Pro 的基准分数很重要?
基准测试为模型的推理、编程与多模态性能提供可量化的证据。它们有助于用户评估哪款模型最契合需求。不过,基准无法覆盖所有场景,真实环境的测试仍然必不可少。

专注于人工智能与教育科技领域的高级编辑,致力于探寻数据与 AI 趋势。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
在xAI 发布 Grok 4.1仅仅数小时后,Google 更进一步,宣布上线 Gemini 3。这一最新 Gemini 模型是迄今为止 Google 最智能的版本,现已可在 Gemini 应用、AI Studio 与 Vertex AI 中即时使用。
Gemini 3 也将立即为搜索中的 AI 模式提供支持,同时 Google 还宣布了 Gemini 3 Deep Think 模式与 Google Antigravity——一个全新的智能体开发平台。
本文将涵盖 Google 公布的全部信息、其对大语言模型领域的意义,并上手体验全新的 Gemini 3 模型以检验其能力。您还可以查看我们的Gemini 3 API 实操指南,通过项目上手;阅读我们的Google Antigravity 教程;以及创建 Gemini 3 Flash 项目的指南。
什么是 Gemini 3 Pro?
Gemini 3 Pro 是 Google 最新、最先进的大语言 AI 模型。它现已可通过 Gemini 应用、AI Studio 与 Vertex AI 使用。官方称其为迄今最智能的模型,在推理、编程与多模态任务方面的性能均有提升。
这一新模型延续并提升了仅在七个月前发布的Gemini 2.5 Pro的成功。Gemini 3 登顶LMArena 排行榜,仅在数小时内便取代了 Grok 4.1。
Google 声称 Gemini 3 Pro 具备博士级推理能力,并在多项 AI 基准排行榜上取得高分,包括 Humanity’s Last Exam、GPQA Diamond 与 MathArena Apex。这组令人印象深刻的成绩意味着它的表现超越了 OpenAI 的新GPT-5.1与 Anthropic 的Claude Sonnet 4.5 等模型。
Gemini 3 的新功能
那么,与前代以及其他一众新模型相比,Gemini 3 带来了什么?除了性能的大幅跃升,Google 还宣称您可以用 Gemini 3 “学习、构建和规划一切”。的确是雄心勃勃。让我们看看这些新功能意味着什么:
性能提升
全新 Gemini 3 模型的一大亮点是其位居榜首的性能。即便不启用 Deep Think 模式,该版本在Humanity’s Last Exam 基准排行榜上也以 37.2% 的无工具得分(启用 Deep Think 为 41%)领跑,对比之下,GPT-5.1 为 26.5%。
Gemini 3 不仅在文本方面表现突出。在 MathArena Apex 基准中以 23.4% 的得分成为数学领域表现最好的前沿模型。类似地,在Video-MMMU(一个评估大多模态模型从教育视频中获取知识能力的多模态、跨学科视频基准)上,它取得了 87.6% 的成绩,再次登顶排行榜。
我知道人们有时容易被基准分数带偏,或许真正的考验应更关注可用性,但 Gemini 3 Pro 无疑在大语言模型性能上迈出了令人瞩目的一步。
什么是 Gemini 3 Deep Think 模式?
正如我们在 Gemini 2.5 Pro 中看到的,Gemini 3 Deep Think 模式通过并行思考与强化学习显著提升回应质量(代价是响应更慢)。Deep Think 让 Gemini 的回答更细致、更有创意,也更“深思熟虑”。
借助 Gemini 3 Deep Think,我们可以看到相较于不启用思维扩展的 Gemini 3 Pro,在推理、科学知识与视觉推理谜题等方面都有所提升。这意味着 Deep Think 更有能力解决全新且不熟悉的挑战。
Deep Think 目前处于评估阶段,意味着测试人员正在对其进行评估,随后将在“未来数周内”面向 Google AI Ultra 订阅用户开放。
真正的多模态
Gemini 3 引入了新的多模态架构,在单一的 Transformer 堆栈中处理文本、图像、音频、视频与代码,而非通过独立编码器。
这种统一使真正的跨模态推理成为可能。Gemini 3 可以解读草图并生成可运行的代码,或分析视频并解释其中的科学概念。其在 Video-MMMU 与 MMMU-Pro 上的基准成绩验证了其空间与视觉理解上的大幅跃升。与 Gemini 2.5 Pro 一样,它还拥有百万 Token 的上下文窗口,能够在海量且多样的输入中串联起想法。
具身创造力(Agentic creativity)
Gemini 3 从被动生成迈向了具身创造,由工具使用、规划与“vibe coding”的新进展驱动。其架构支持长时程推理循环,让它可以规划、执行并校验多步工作流,例如从单个提示开始就能编写一款可玩的游戏或构建交互式界面。
这些能力也已通过刚刚发布的 Google Antigravity 得到部署——一个开发平台,智能体可直接访问编辑器、终端与浏览器。这是首个以协同开发者为定位的 Gemini 发布版本,通过结构化自治与实时工具集成,将创意转化为可用系统。
学习、构建与规划一切?
Google 给出了多个示例,展示这一最新模型如何帮助您学习、构建与规划。
重点在于多模态能力的改进:Gemini 能够在文本、图像、视频、音频与代码等多种介质间理解与创作信息。
随着“vibe coding”成为许多人关注的焦点,Gemini 3 应能让开发者更轻松地将想法变为现实。Google 声称它擅长“一次出手”式生成,意味着您可以通过一个提示就获得高质量结果。它也能处理复杂指令,这对于让您的项目真正“鲜活且有反馈”至关重要。
开发者现已可在 Google AI Studio、Vertex AI、Gemini CLI,以及刚刚发布的 Google Antigravity(稍后详述)中,开始构建具身智能体项目。
还有一项颇为亮眼的声明:Gemini 3 Pro 能在模拟的一年运行期内保持工具使用与决策的一致性。对于拥有 Google AI Ultra 订阅的用户,您将立即能够使用全新的 Gemini Agent 实验功能,以帮助您构建能利用这些能力的多步智能体。
Gemini 3 Pro 示例
得益于百万 Token 的上下文窗口,Gemini 2.5 Pro 长期以来一直是我的心头好,因此我很期待看看在相同上下文窗口下,Gemini 3 借助更强的多模态性能能做到什么。为一探究竟,这里有几个测试:
简单的《半衰期 3》灵感小游戏
正如我们在 Gemini 2.5 上的测试,只用大约 10 个词的提示,我让 Gemini 3 Pro 创建了一个受《半衰期 3》启发的横版卷轴游戏。提示如下:Make me a simple side-scrolling Half-Life 3-inspired game
在不多的思考时间与差不多的编码时间内,Gemini 3 Pro(通过 AI Studio)就基于这一简短提示为我完成了一个相当不错的雏形。它能运行,是横版卷轴,也能看出对原作致敬。
下面是实际效果的视频: