
课程
使用 Google ADK 构建 AI Agent
1 小时
7.6K
尽管图像生成模型近来变得非常强大,但它们一直在一个方面有所欠缺:图像编辑。对文字进行精确修改、更换颜色、改变风格、使用不同机位、或在多次生成中保持角色一致性;这些都是高度渴望的应用,但没有哪个图像模型能在所有方面都一以贯之地表现出色。直到 Google 发布 Gemini 2.5 Flash Image 模型,并以其对话式编辑方式改变了游戏规则。
在本教程中,您将学习如何通过 Python 设置并使用 Gemini 2.5 Flash Image,掌握针对不同视觉风格的提示工程技巧,并使用多图合成与角色一致性等高级功能。到最后,您将拥有面向专业图像生成工作流的实用工具。
更新:其间,Google 已发布该模型的更新版本。强烈建议查看我们的 Nano Banana 2 指南,了解有哪些新变化!
如果您也想探索其他 Google 的 AI 图像生成工具,不妨查看我们的 Imagen 3 全面指南,其中涵盖 Google 的另一套图像生成 API,其优势与定价模式不同。您还可以查看我们的 Gemini 2.5 Computer Use 指南,了解该模型如何“看”到您的屏幕并在其中自主操作,以及查看关于 Gemini 3 Pro 的最新动态。
最后,您也可以参考我们的 ChatGPT Images 指南,它是 Nano Banana Pro 的新竞争者。
大多数图像生成模型都能从文本提示中生成优秀的视觉效果,但在编辑方面却显得吃力。比如您想改变照片的光线,通常需要从头开始。再比如您需要同一角色出现在不同场景中,多数模型难以保持其外观一致。这让这些工具在需要微调和修订的真实项目中不太好用。
Gemini 2.5 Flash Image 解决了这些编辑难题。Google 为此模型构建了专门功能,以处理其他模型难以胜任的任务:
这些功能协同工作,构建出更灵活的图像生成系统。以下展示角色一致性功能在实践中的效果:
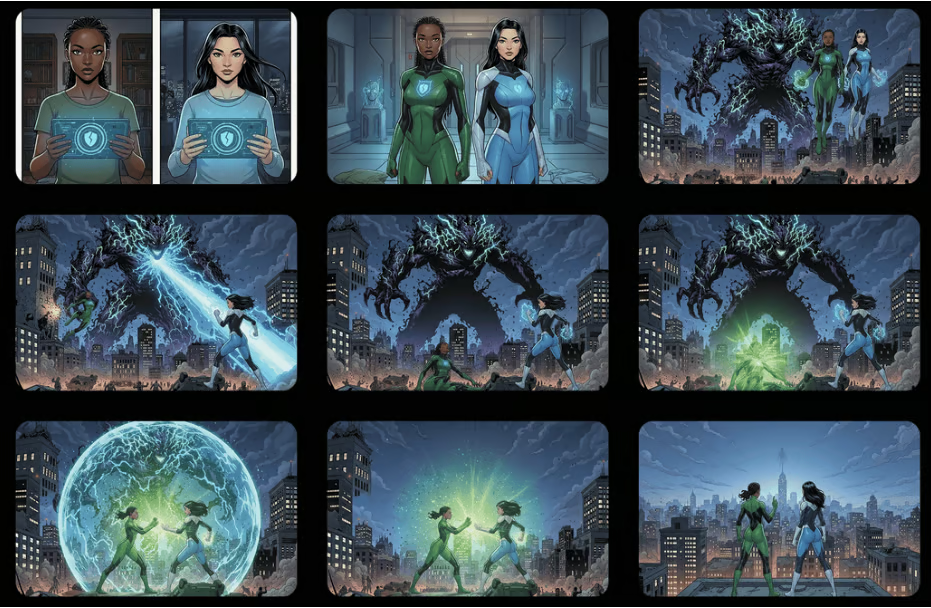
角色一致性功能演示:相同的卡通角色在不同场景中始终保持一致的视觉身份,同时适应新的环境与语境。
Google 在 LMArena 基准上测试了该模型,团队内部称其为“nano banana(纳米香蕉)”。结果显示,它在图像编辑任务上优于其他领先模型。该模型的生成速度也快于大多数竞品。速度会随图像复杂度和编辑内容而变化。
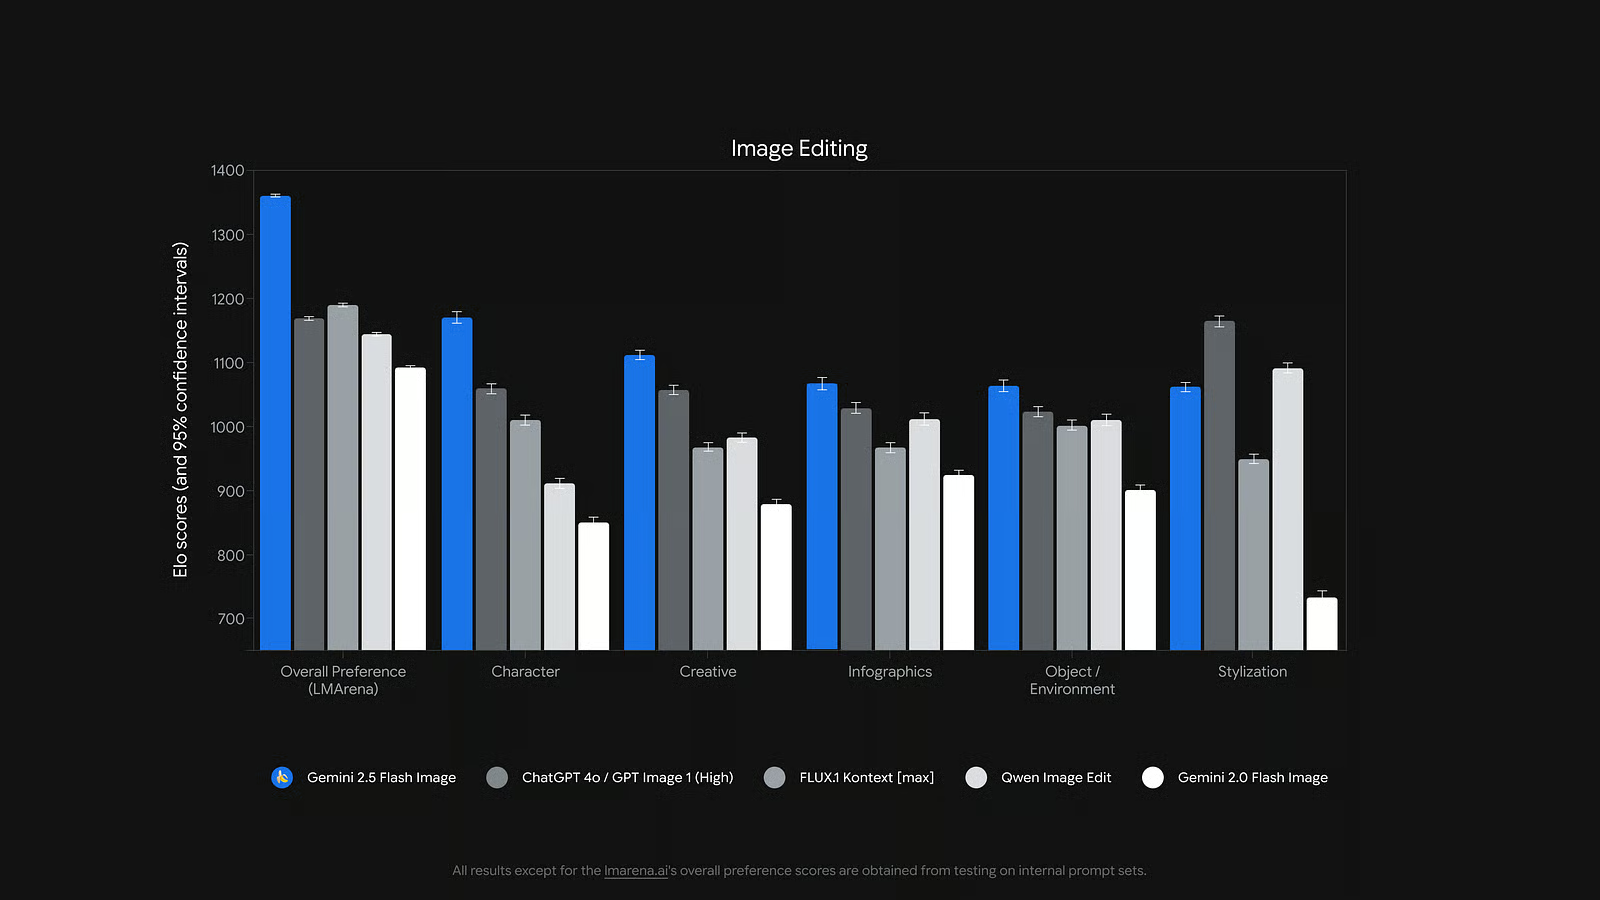
性能基准:与其他领先的 AI 图像生成模型相比,Gemini 2.5 Flash Image 在图像编辑任务上表现更优。
其定价方式不同于其他图像模型。不是按张计费,而是按 token 计费。每张图像大约使用 1,290 个 token,约合 $0.039。完整费率为每百万 token $30。生成新图像与编辑现有图像使用相同 token 数,因此无论是从零生成还是进行修改,成本都可预测。
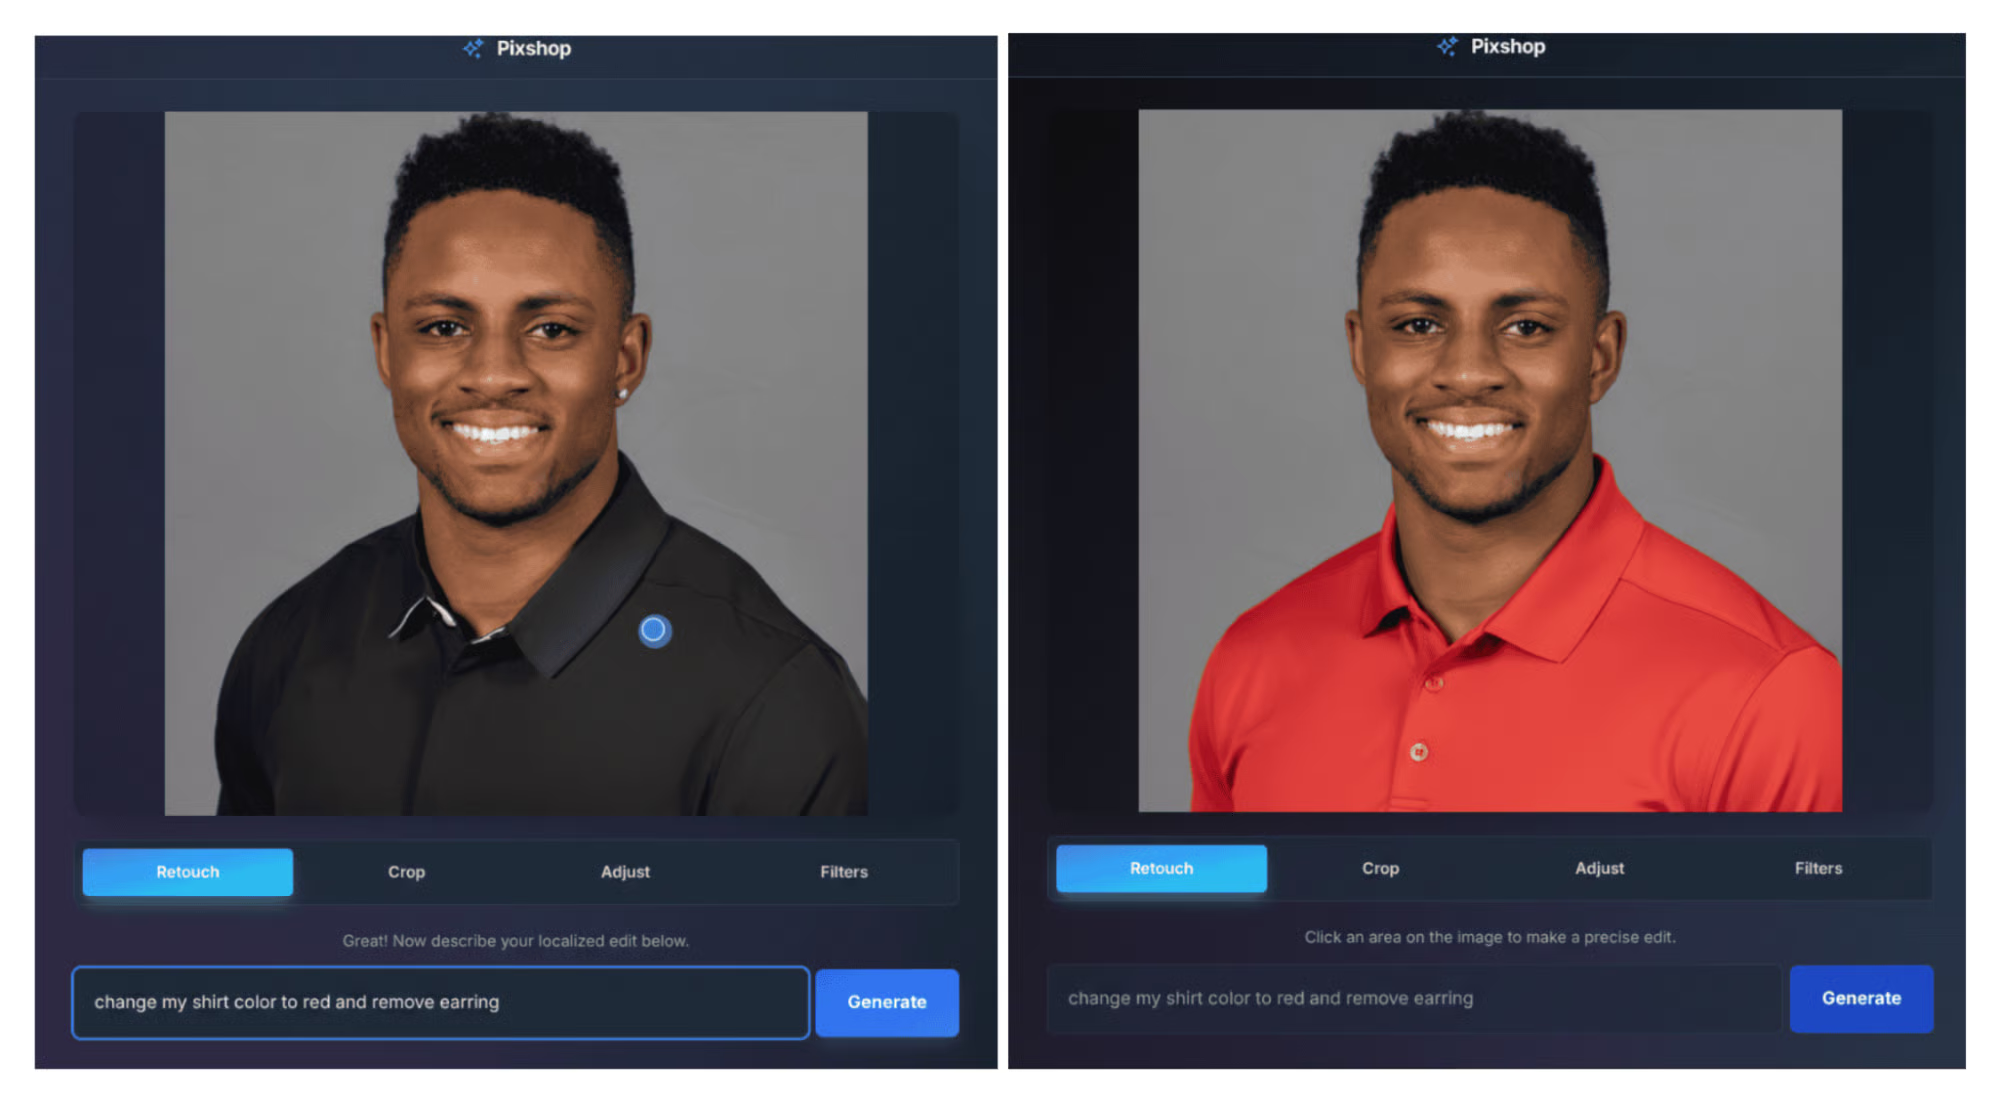
对话式编辑工作流:通过自然语言提示实现精确的图像修改,展示模型在无需整图重生的情况下进行定向变更的能力。
了解了 Gemini 2.5 Flash Image 的与众不同之处后,我们可以开始上手技术。下一步是配置开发环境,以便开始使用。
虽然本指南主要讲解通过 API 访问 Gemini 2.5 Flash Image,但您也可以仅凭 Google 账号直接用该工具生成图像。
登录后,您可以选择通过 Gemini 或在 Google AI Studio 中访问 Nano Banana 模型。不过,通过 Gemini 使用时,您的图像上会有水印。
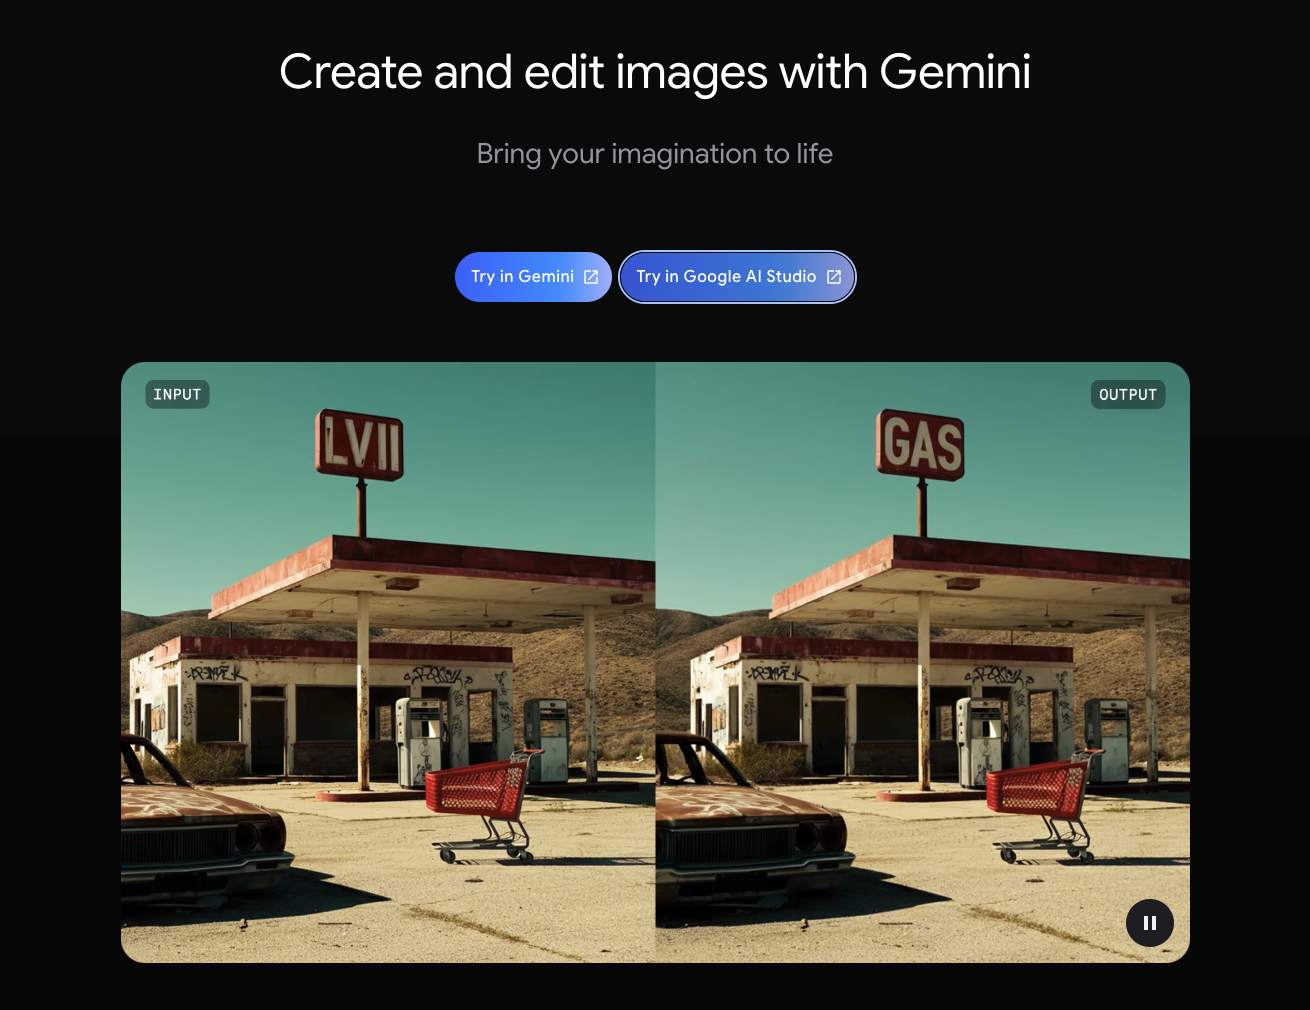
在用 Gemini 2.5 Flash Image 生成图像之前,您需要先配置开发环境。过程很直接,但正确设置身份验证对安全很重要。
开始之前,您需要准备:
python --version 检查版本要使用 Gemini 2.5 Flash Image,您需要从 Google 获取 API 密钥。该密钥相当于访问服务的密码。获取步骤如下:
此时,Google AI Studio 会要求您选择一个项目。项目用于组织 API 用量并跟踪配额。您有两个选项:
大多数人应选择新建项目。点击后,Google 会自动创建项目并生成您的 API 密钥。
4. 立即复制生成的密钥——您之后将无法再次看到完整密钥
5. 妥善保存——接下来的步骤会用到它
安全提示:将 API 密钥视作密码。不要公开分享,也不要保存在他人可见的代码中。
拿到 API 密钥后,开始设置 Python 环境。为本教程创建一个新目录,并安装所需包:
# Create project directory
mkdir gemini-image-tutorial
cd gemini-image-tutorial

# Initialize UV project
uv init

# Add required packages
uv add google-genai python-dotenv pillow
各包的作用如下:
google-genai:用于与 Gemini 通信的官方客户端python-dotenv:保护您的 API 密钥pillow:处理图像文件您需要以既安全又便于代码访问的方式存储 API 密钥。最佳做法是使用环境变量与 .env 文件。
在项目目录中创建 .env 文件:
# Create .env file
touch .env
在任意文本编辑器中打开 .env 文件,并添加您的 API 密钥:
GEMINI_API_KEY=your_api_key_here将 your_api_key_here 替换为您从 Google AI Studio 复制的密钥。
接着创建 .gitignore,以免在使用 Git 时意外泄露 API 密钥:
# Create .gitignore
echo ".env" >> .gitignore
echo "__pycache__/" >> .gitignore
echo "*.pyc" >> .gitignore我们来通过一个简单测试确认一切正常。创建名为 test_setup.py 的文件:
import os
from dotenv import load_dotenv
from google import genai

# Load environment variables
load_dotenv()

# Initialize the client
client = genai.Client(apikey=os.getenv("GEMINIAPI_KEY"))

# Test with a simple text generation
try:
   response = client.models.generate_content(
       model="gemini-2.5-flash",
       contents="Say hello in exactly 3 words"
   )
   print("✅ Setup successful!")
   print(f"Response: {response.text}")
except Exception as e:
   print("❌ Setup failed:")
   print(f"Error: {e}")
现在运行测试脚本,确保一切正常:
uv run python test_setup.py如果配置正确,您会看到成功消息以及模型的简短回复。输出类似于:
✅ Setup successful!
Response: Hello there everyone.
如果出现错误,以下是常见修复方式:
.env 是否包含 GEMINI_API_KEY=your_actual_key您的免费 API 密钥包含以下限制:
这些限制非常适合本教程与小型项目。您可随时返回 Google AI Studio,在用量仪表板查看使用情况。
完成环境配置与测试后,您已准备好开始生成图像。下一节将带您用 Gemini 2.5 Flash Image 创建第一张图像。
既然环境已就绪,我们用 Gemini 2..5 Flash Image 创建第一张图像。我们将从简单开始,逐步加深理解。
首先加载所需库并建立与 Gemini 的连接:
import os
from dotenv import load_dotenv
from google import genai
from PIL import Image
from io import BytesIO

# Load your API key from the .env file
load_dotenv()

# Create a client to talk to Gemini
client = genai.Client(apikey=os.getenv("GEMINIAPI_KEY"))
逐一说明各 import 的作用:
os:用于处理环境变量load_dotenv():从.env 文件读取 API 密钥genai:与 Gemini 通信的主库PIL Image 与 BytesIO:用于保存返回的图像文件client 对象负责向 Gemini 发送请求。可以将其视作您与 Google 服务器的连接。
我们用清晰、具描述性的提示创建一张简单图像:
# Write a prompt describing what you want
prompt = "A cozy coffee shop with wooden furniture and warm lighting"

# Ask Gemini to create the image
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[prompt]
)
generate_content() 是与 Gemini 交互的主要方式。各参数含义如下:
model="gemini-2.5-flash-image-preview":指定用于图像生成的模型contents=[prompt]:放置您的文本描述当 Gemini 返回响应时,图像以原始数据形式出现,我们需要将其转换为合规的图像文件。以下是提取并保存的方法:
# Look through the response to find the image
for part in response.candidates[0].content.parts:
   if part.inline_data is not None:
       # Convert the raw data into an image
       image = Image.open(BytesIO(part.inline_data.data))
       # Save it as a PNG file
       image.save("myfirstimage.png")
       print("Image saved!")
这段代码完成了几件要事:
response.candidates[0]:获取 Gemini 的第一个(通常也是唯一)候选响应content.parts:Gemini 可返回多种内容——文本、图像等part.inline_data:实际图像数据所在BytesIO():将原始字节转换为 PIL 可读取的对象image.save():将最终图像保存到本地将以上步骤整合并依次执行,您应看到类似如下输出:
✅ Image saved as https://cdn-images-1.medium.com/proxy/1*Hhy7vMKOurXDOPVQ6Ps0gQ.png
📏 Image size: (1024, 1024)
🎨 Image mode: RGB
以下是我们“咖啡店”提示生成的真实图像:
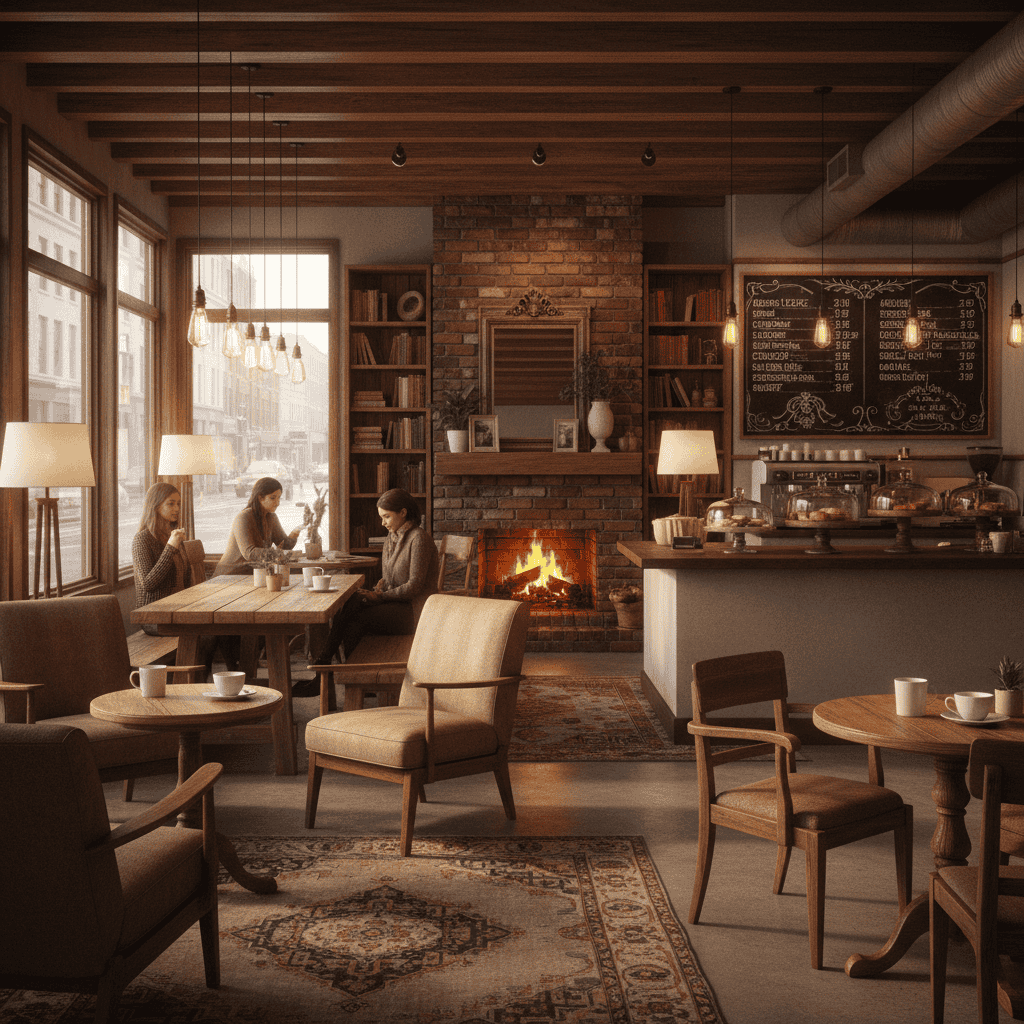
一间温馨的咖啡馆室内:木梁、暖光、舒适座位以及与提示完全一致的欢迎氛围。
每次生成图像,Gemini 会返回:
如有需要,响应中还可能包含文本,用于解释其生成图像的相关信息。
既然已了解基本流程,让我们试试不同提示,看看模型如何响应各种描述:
# Simple object descriptions work great
"A red bicycle in a sunny park"

# You can add details about style and mood
"A modern kitchen with clean white cabinets and natural light"

# Describe the setting and atmosphere
"A peaceful lake surrounded by mountains at sunset"
我们看看运行这些提示会生成什么:
阳光公园里的红色自行车:
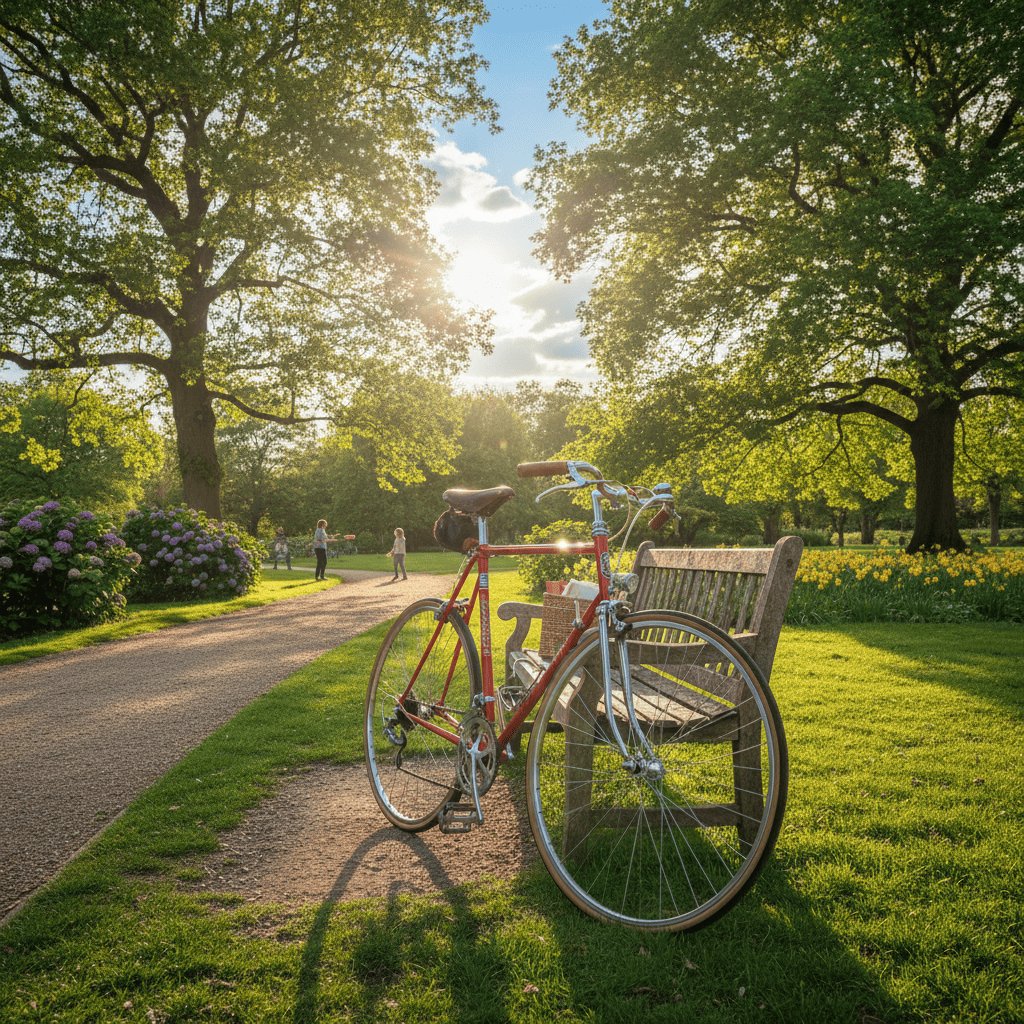
一辆红色自行车恰到好处地停在美丽的公园里:金色阳光、苍翠草木、宁静长椅。注意阴影——如同真实影像,当表面从地面过渡到草地时,阴影会发生形变。
干净白色橱柜的现代厨房:
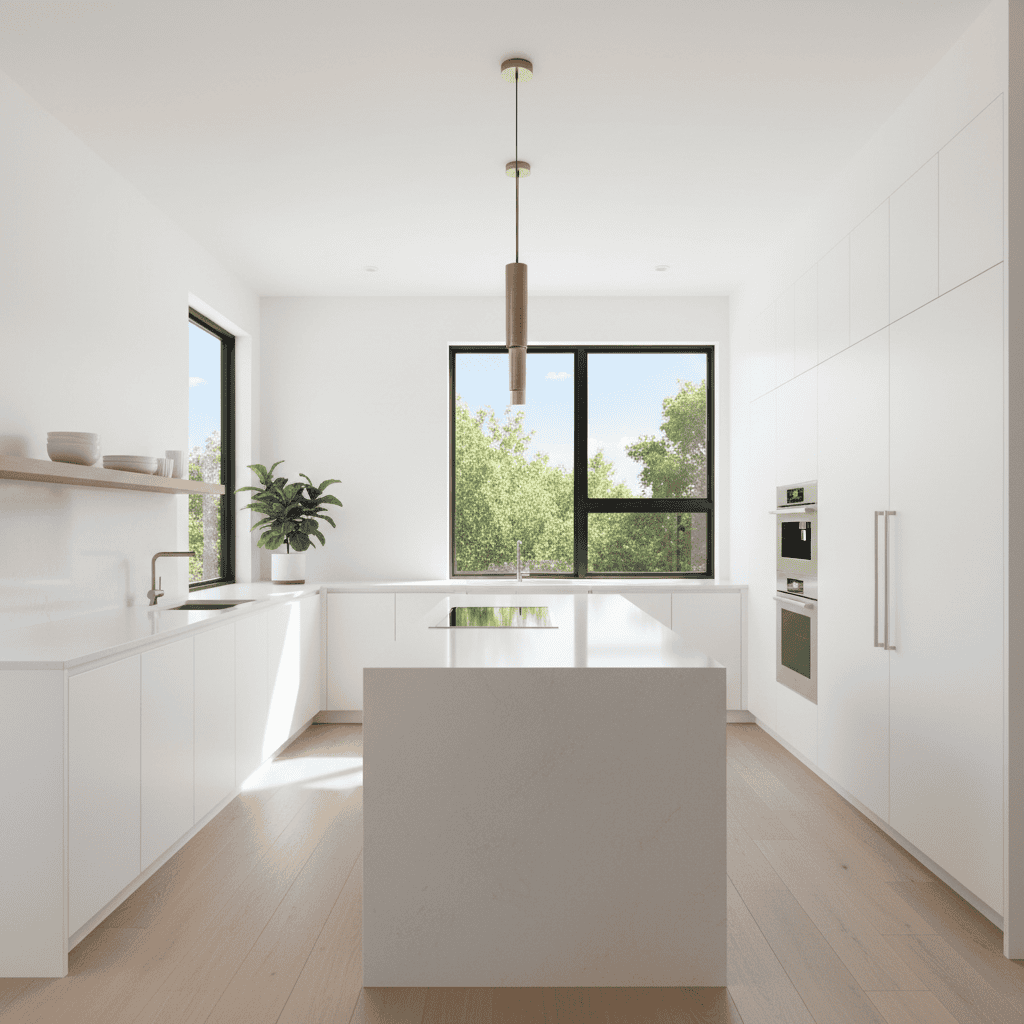
简洁现代的厨房设计:洁白橱柜、现代装置、大窗洒入的自然光。注意中央桌面上清晰可见的窗户反射。
群山环绕的宁静湖泊:
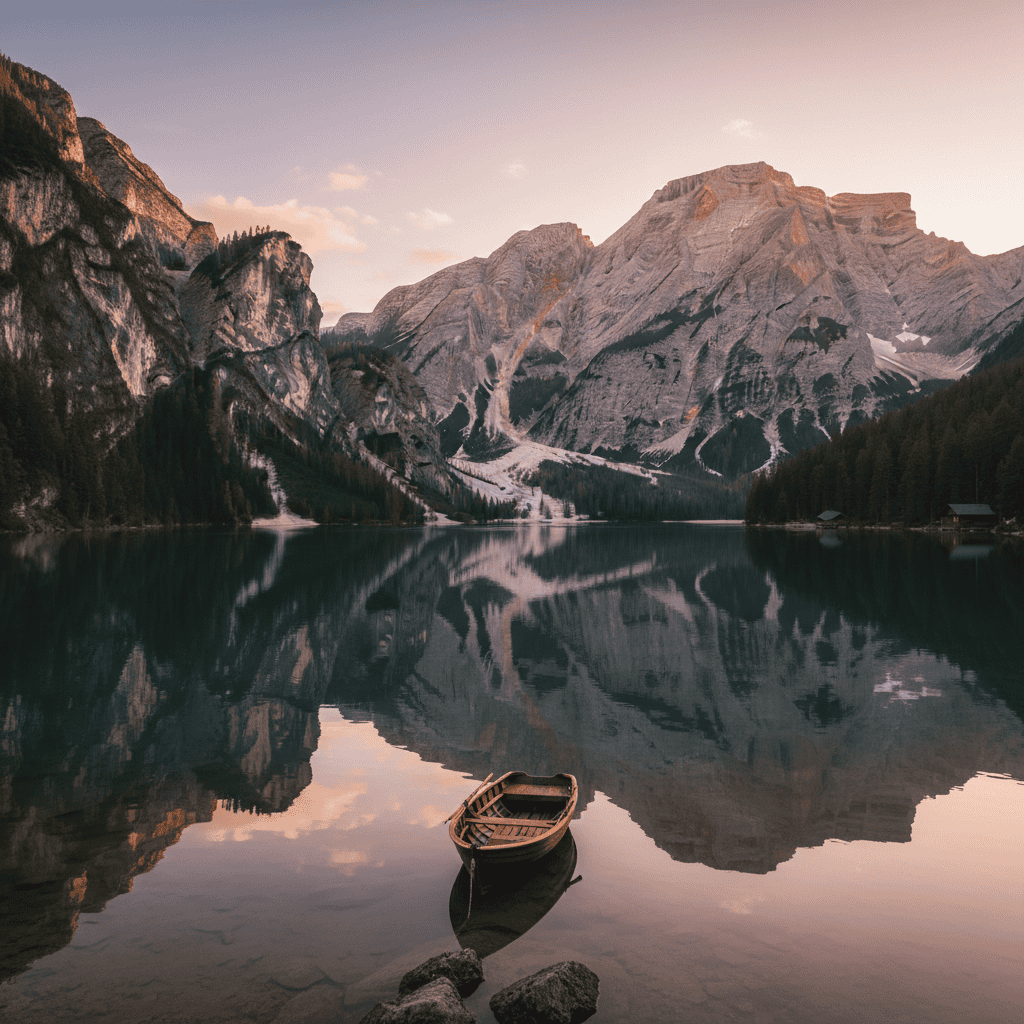
日落时分的宁静高山湖泊,水面倒影完美,四周巍峨山峰,前景是一条别致的木船。再次留意水面反射的精细表现。
从清晰、简单的描述开始。随着对模型习性的熟悉,您可逐步添加细节。
以上示例展示了典型工作流,但过程中也可能遇到问题。以下是处理常见问题的方法:
下一节将教您如何编写更优提示,以便更好掌控结果。
既然已能生成基础图像,让我们学习如何编写能更好掌控结果的提示。关键在于明确具体需求,并理解不同技巧如何影响最终图像。
若想深入了解跨各类 AI 模型的提示工程基础,我们的 2025 提示工程全指南涵盖适用于文本与视觉 AI 的最新技术与策略。
上一节的手动流程适合入门,但每次都重复写相同代码会很繁琐。开始技巧前,我们先写个辅助函数简化流程:
def generateandsave_image(prompt, filename):
   """
   Generate an image and save it to the images folder

   Args:
       prompt (str): Description of what you want to create
       filename (str): Name for the saved image file

   Returns:
       bool: True if successful, False otherwise
   """
   try:
       response = client.models.generate_content(
           model="gemini-2.5-flash-image-preview",
           contents=[prompt]
       )

       # Find and save the image
       for part in response.candidates[0].content.parts:
           if part.inline_data is not None:
               image = Image.open(BytesIO(part.inline_data.data))
               image.save(f"images/{filename}")
               print(f"✅ Image saved as images/{filename}")
               return True

   except Exception as e:
       print(f"❌ Error: {e}")
       return False

   return False
该函数帮我们处理图像生成与保存流程。现在我们可以把精力放在编写更好的提示上,而不是反复写样板代码。
使用方式如下:
# Simple function call
generateandsave_image("A cozy reading nook", "readingnook.png")
比每次都写完整代码简洁太多!
提升提示质量的最大改进是加入具体细节。我们来看泛化与细化提示的差别。
这是一个泛化提示:
generateandsave_image("A kitchen", "generickitchen.png")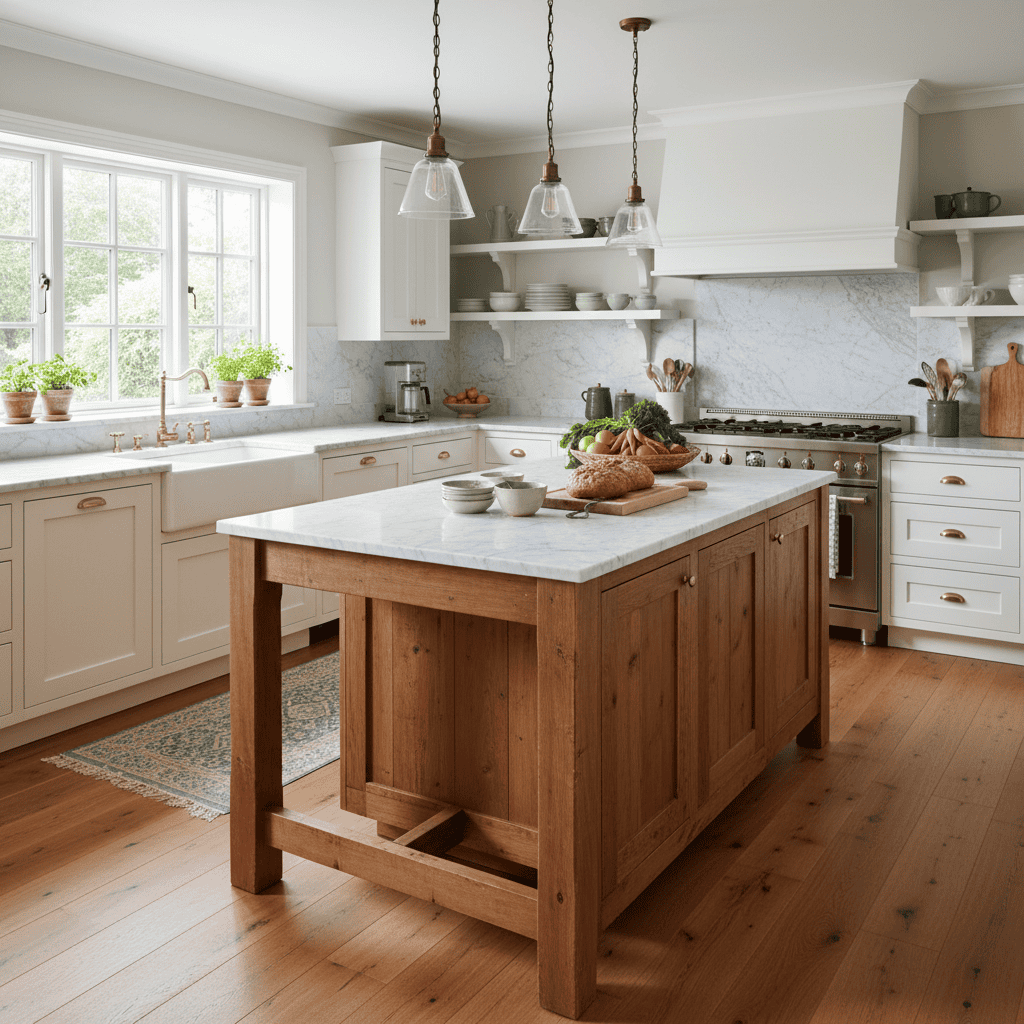
泛化提示结果:一间随处可见的基础厨房,配置标准但缺少辨识度。
我们用具体细节重试同一概念:
generateandsave_image(
   "Modern minimalist kitchen, white quartz countertops, stainless steel appliances, pendant lights, natural oak floors",
   "specific_kitchen.png"
)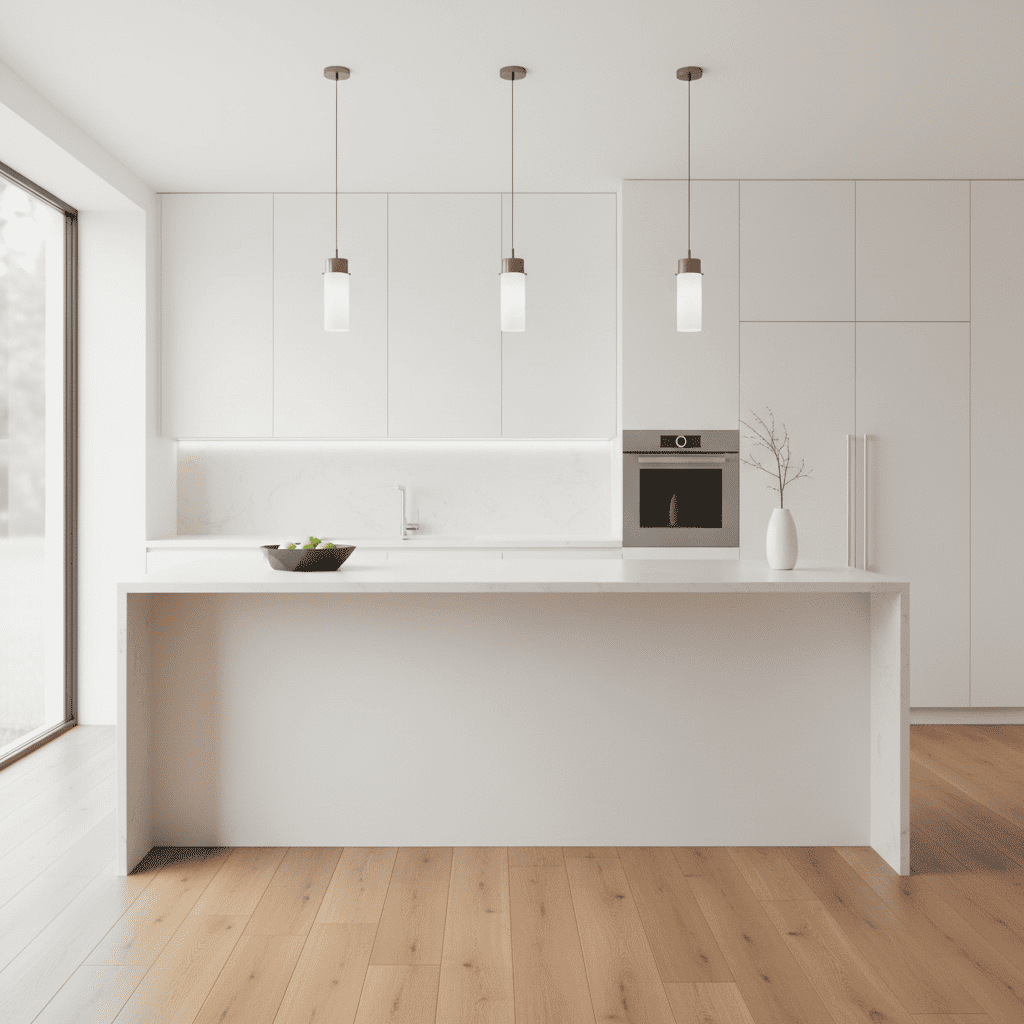
具体提示结果:一间与我们要求元素完全契合的厨房,呈现协调统一的现代美学。
差异显著。具体提示带来与描述严丝合缝的专业外观,而泛化提示虽可用,却更难预测。
如果您也在使用其他图像生成模型,我们的 Stable Diffusion 技巧指南涵盖互补的提示策略,可提升在不同 AI 平台上的效果。
您可以使用摄影术语控制画面取景,从而精确掌控构图与视角。
广角镜头可涵盖更多场景:
generateandsave_image(
   "Wide angle shot of modern living room, leather sofa, glass coffee table, floor to ceiling windows",
   "wideangleroom.png"
)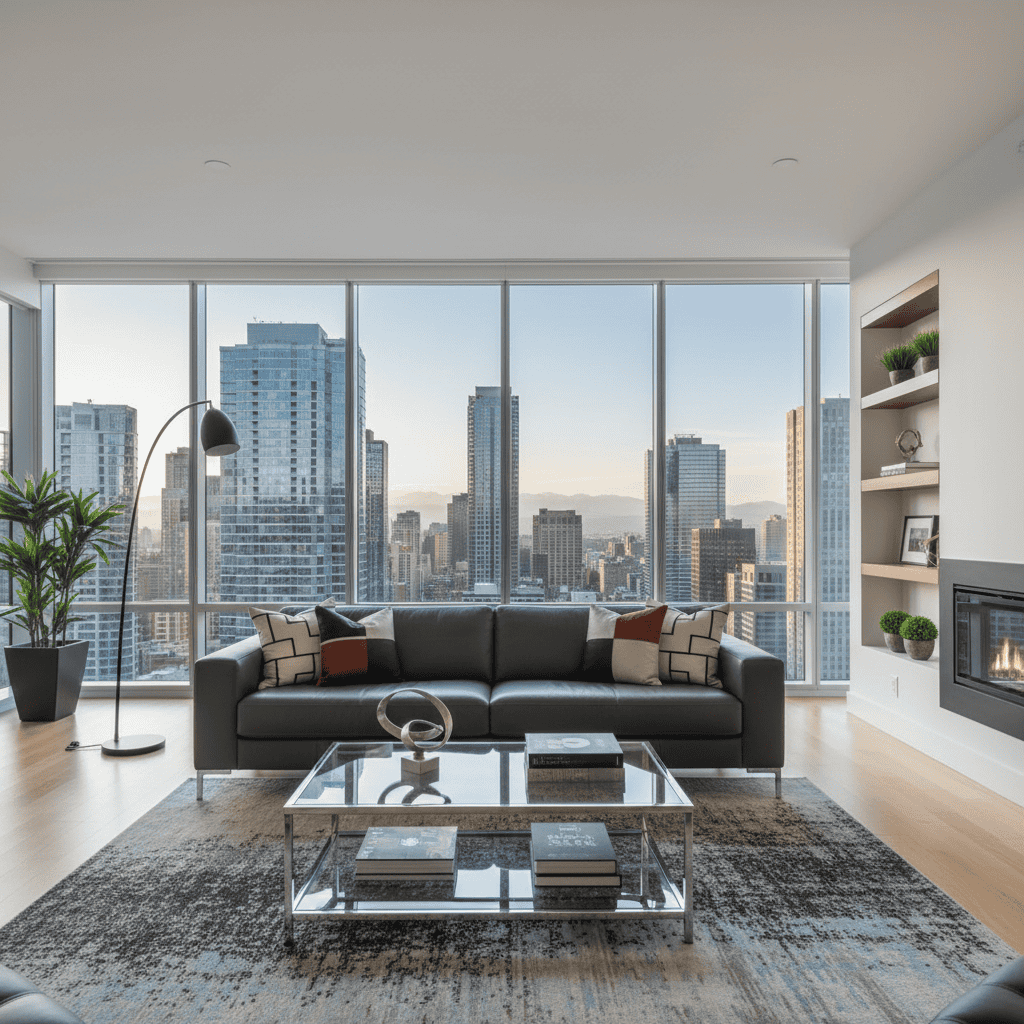
广角视角既展现房间的宽敞与城市景致,也让空间更显开阔与戏剧性。
微距镜头聚焦细节:
generateandsave_image(
   "Macro shot of vintage pocket watch on mahogany desk, brass details, Roman numerals, soft lighting",
   "macro_watch.png"
)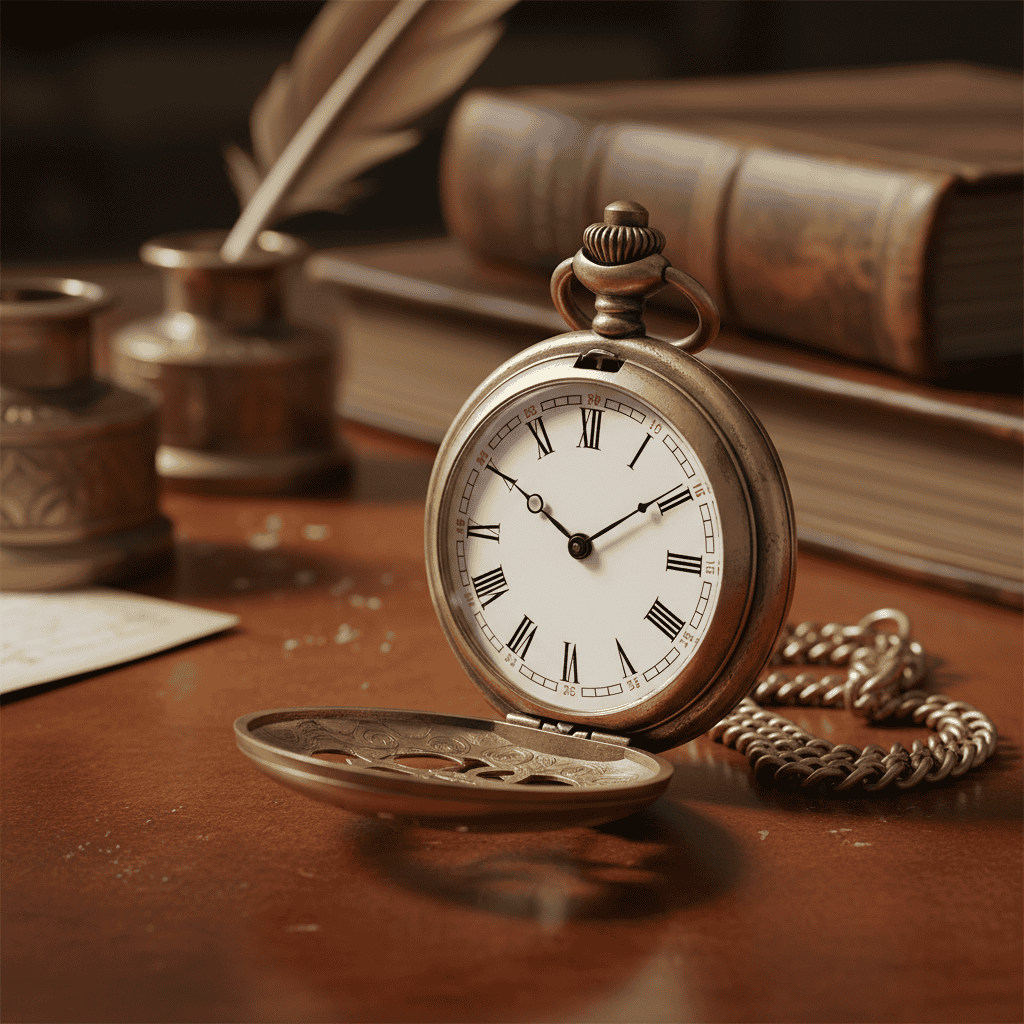
微距摄影揭示表盘、表链与周围老书的精细质感,营造亲密而细腻的构图。
其他有用的摄影术语:
"Low angle shot"——仰拍"Bird's eye view"——俯瞰"85mm portrait lens"——营造浅景深"Dutch angle"——倾斜视角,增强戏剧性对光线的描述能彻底改变图像氛围。以下演示如何用光线营造特定情绪。
黄金时刻营造温暖:
generateandsave_image(
   "Empty park bench at golden hour, warm sunlight, long shadows, autumn leaves scattered, peaceful atmosphere",
   "goldenhourbench.png"
)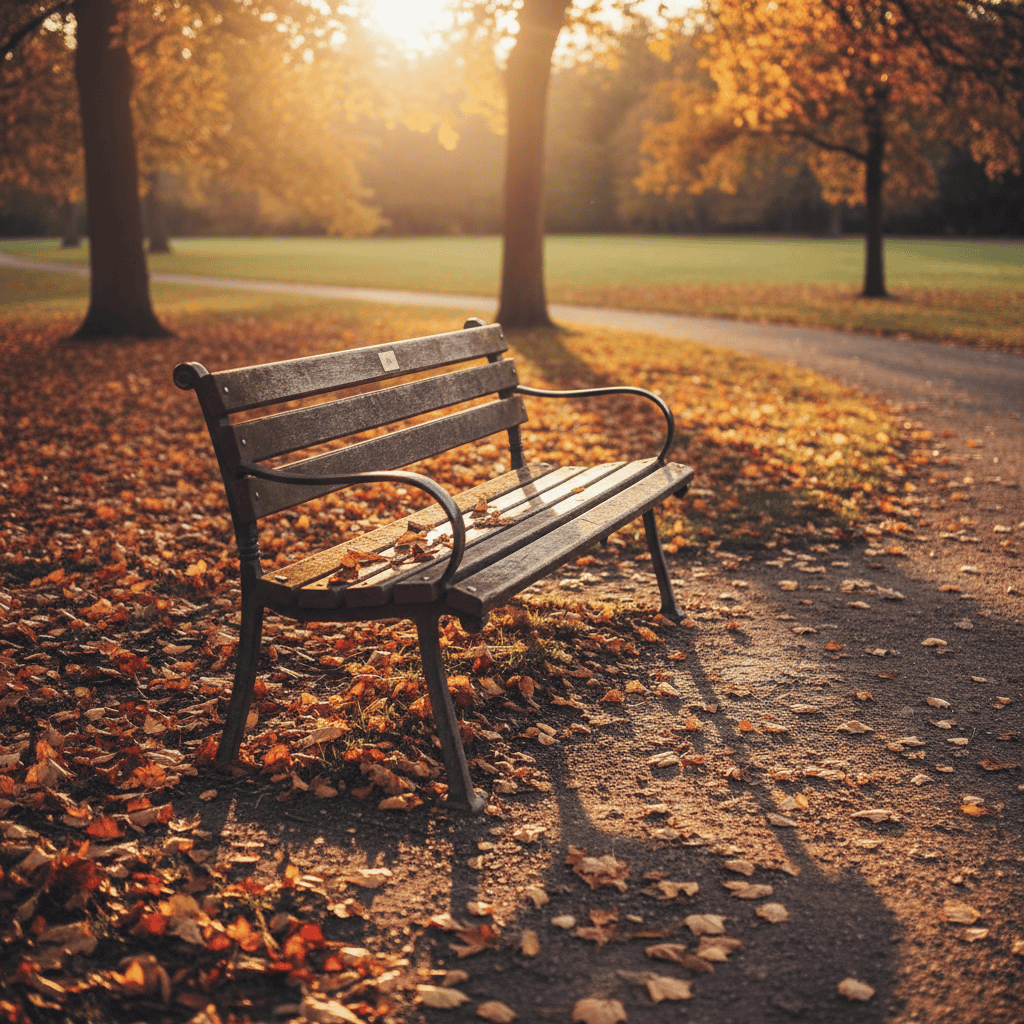
黄金时刻的光线让一张简单的公园长椅变得温暖而宜人,适合沉思小憩。
戏剧化光线增加张力:
generateandsave_image(
   "Dark stormy sky over empty lighthouse, dramatic lighting, waves crashing on rocks, moody atmosphere",
   "dramatic_lighthouse.png"
)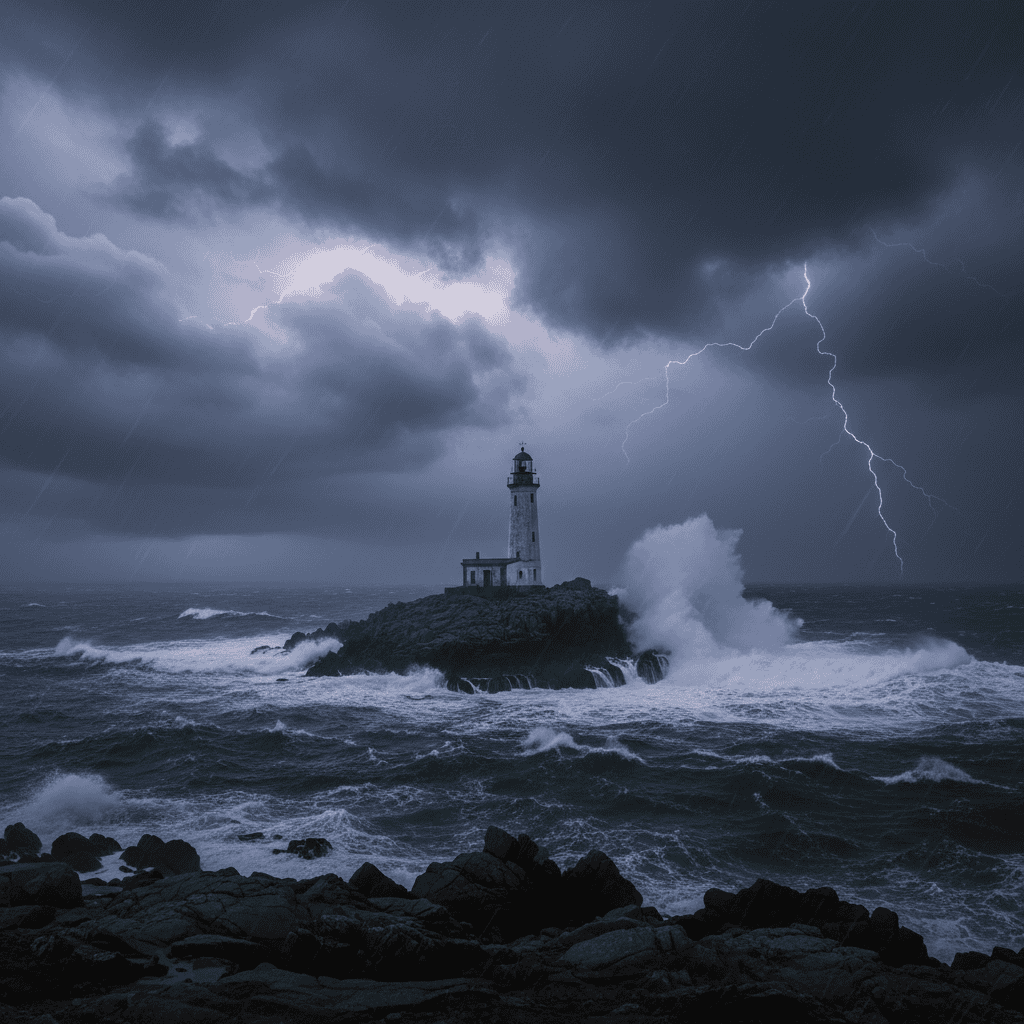
戏剧化光线与风暴天气营造出强烈、孤寂的氛围,力量感十足。
实用光线术语:
"Soft natural light"——柔和、均匀的自然光"Harsh shadows"——强烈对比与戏剧性"Backlit"——逆光"Studio lighting"——干净、专业的棚拍布光在提示中加入具体的美学描述,可以引导艺术风格。
极简风格:
generateandsave_image(
   "Minimalist bedroom design, white walls, simple wooden bed frame, single potted plant, clean lines, natural light",
   "minimalist_bedroom.png"
)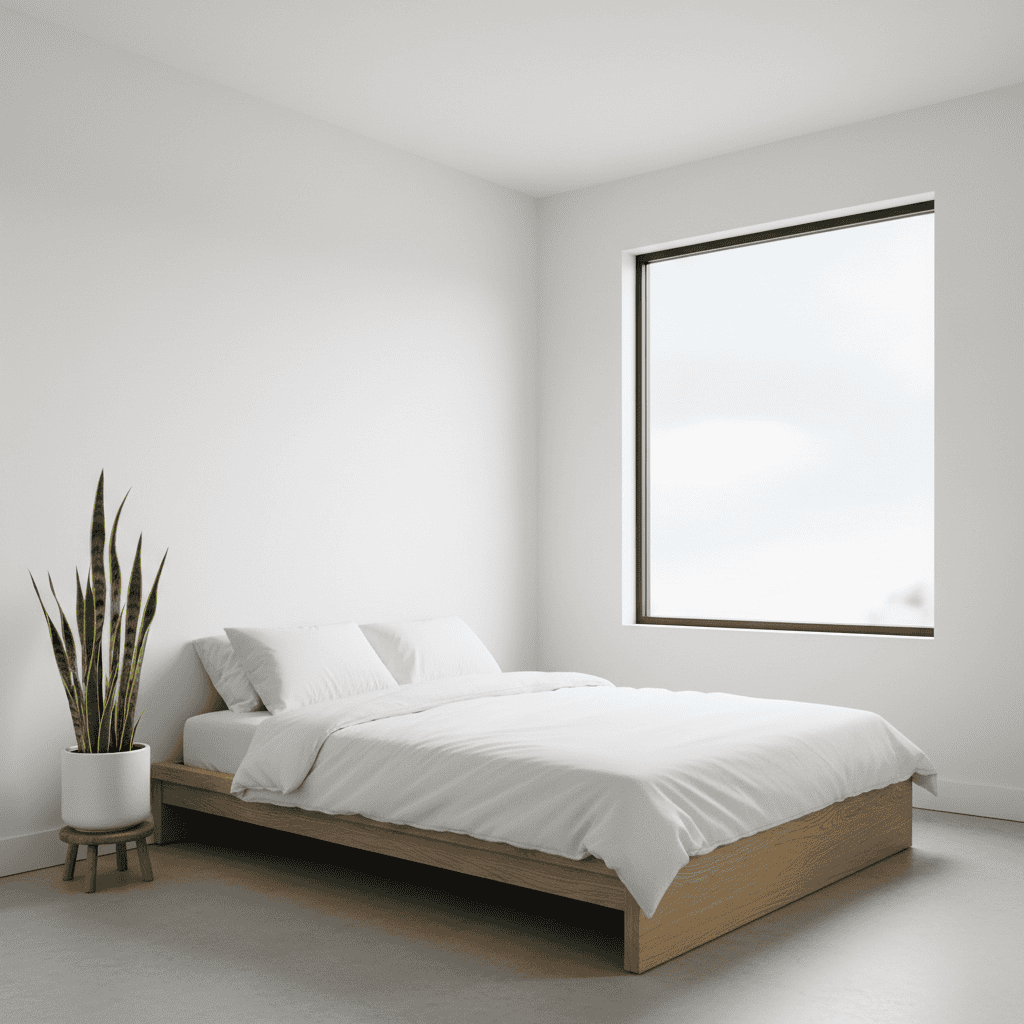
极简主义营造出平静、无杂的空间,既现代又不落时。
复古风格:
generateandsave_image(
   "Vintage coffee shop interior, exposed brick walls, antique furniture, Edison bulb lighting, weathered wood tables, nostalgic atmosphere",
   "vintagecoffeeshop.png"
)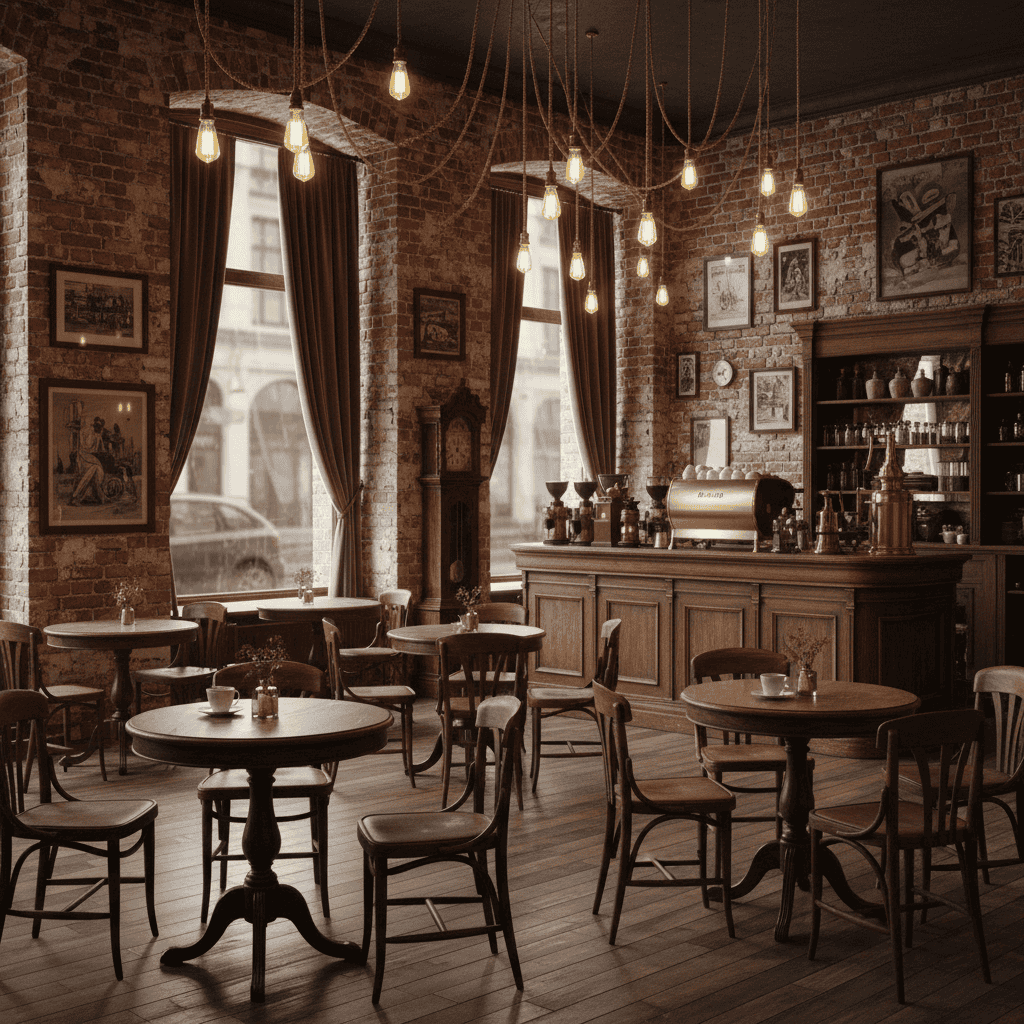
复古元素相互呼应,营造出真实、有人情味的怀旧咖啡馆。
常见风格方向:
"Industrial design"——原始材料、外露结构"Scandinavian style"——浅色木材、简洁线条、舒适质感"Art deco"——几何图案、金属点缀"Rustic charm"——自然材质、岁月质感Gemini 2.5 Flash Image 擅长在图像中直接加入可读文字。为获得干净效果,请尽量简短(25 个字符以内最佳)。
generateandsave_image(
   "Restaurant menu board with 'DAILY SPECIALS' text, chalk lettering on black board, wooden frame, warm lighting",
   "menuboardtext.png"
)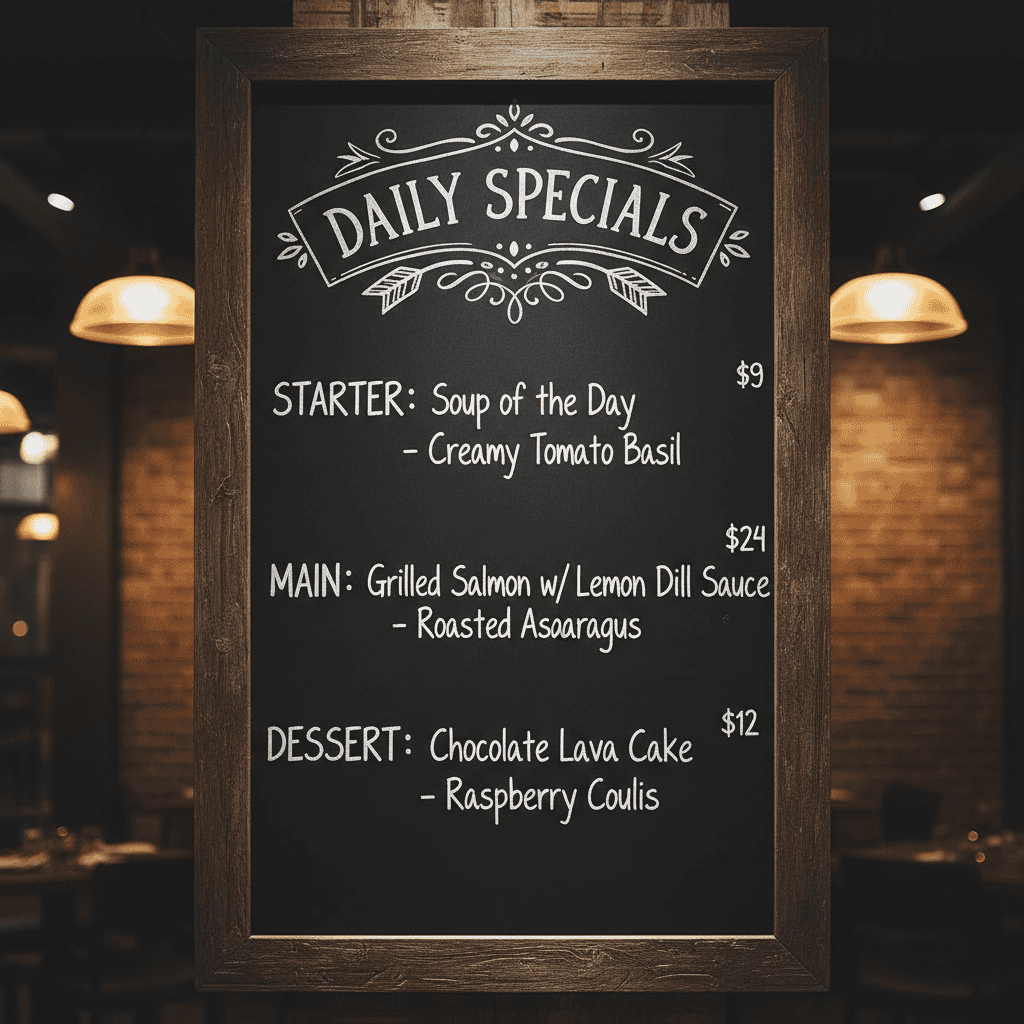
文字与装饰元素、价格自然融合,展示模型对排版和菜单布局的良好把握。
模型会自动补充菜单项与价格,使场景更真实。这体现出 Gemini 对语境的理解与逻辑完备的构图能力。
最强大的提示往往融合多种技巧。以下示例叠加了多种元素:
# Combining camera control + lighting + style + specific details
generateandsave_image(
   "Low angle shot of modern office lobby, dramatic uplighting, marble floors, geometric ceiling, professional atmosphere",
   "professional_lobby.png"
)
以下是这些技巧协同后的结果图像:
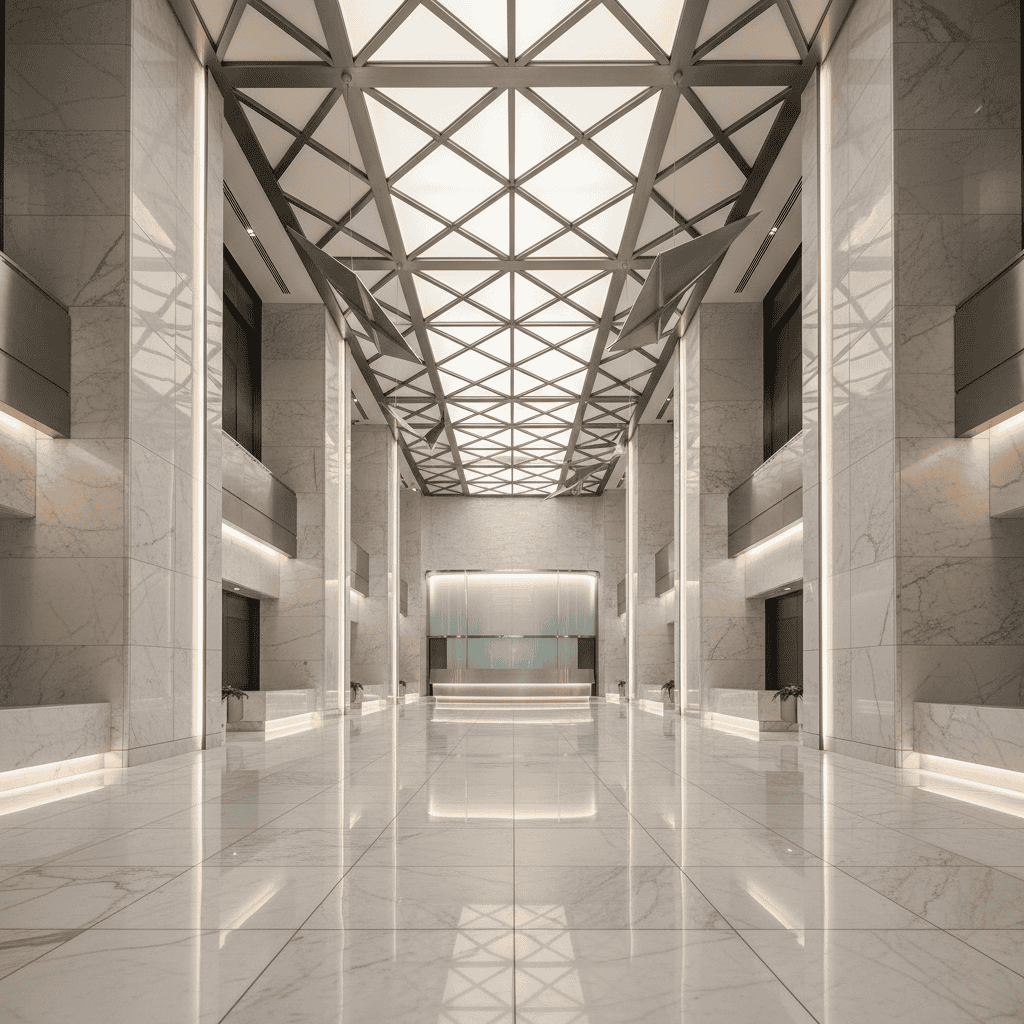
该提示结合了:
请记住,您随时可以通过描述想要的变更来优化图像。Gemini 擅长迭代改进,这也引出本模型的特色高级功能。
若您想了解 Gemini 2.5 Flash Image 与其他 Google AI 工具的对比,我们的 Gemini 2.0 Flash 教程将帮助您了解 Google 最新多模态 AI 的更广能力。
您刚学到的提示工程技巧,是开展更高级操作的基础。现在我们把这些技能应用到令 Gemini 脱颖而出的强大功能上:
最强大的功能之一是将多张图结合为新作品。这不同于简单的图像混合——Gemini 能理解每张图中的对象与语境,并进行智能融合。
在本示例中,我们假设您已用前文技巧生成了基础组件。合成步骤如下:
# Load the base images for composition
gemstone_img = Image.open("https://cdn-images-1.medium.com/proxy/1*zy36GlKisNwsmJ0PwwHODw.png")
setting_img = Image.open("https://cdn-images-1.medium.com/proxy/1*fpNU31VkSznr1NTHbUx-mA.png")

# Compose them with specific instructions
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Mount the rare tanzanite gemstone perfectly into the platinum Art Nouveau setting, creating an exquisite luxury engagement ring, professional jewelry photography with dramatic lighting",
       gemstone_img,
       setting_img
   ]
)
用于合成的基础图像:
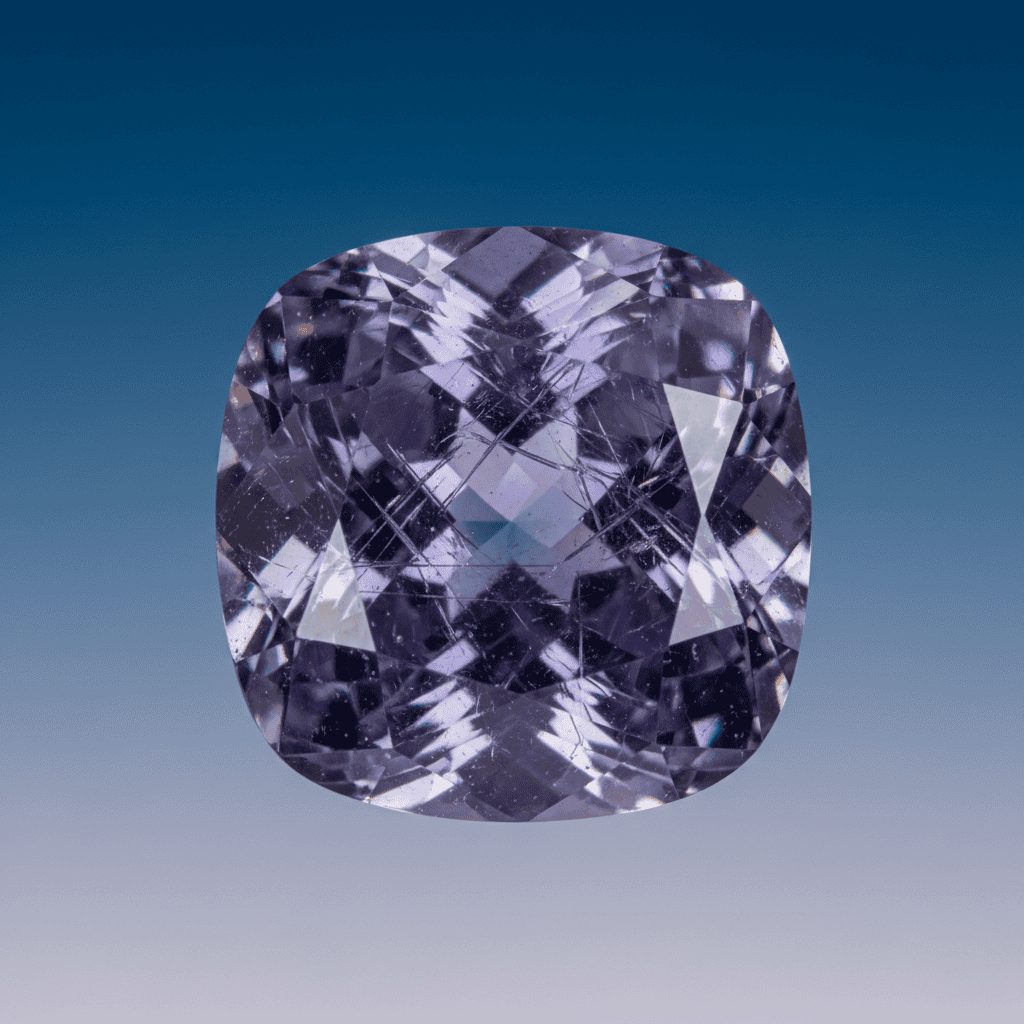
基础组件 1:稀有坦桑石宝石,净度非凡、内部呈棱镜结构。
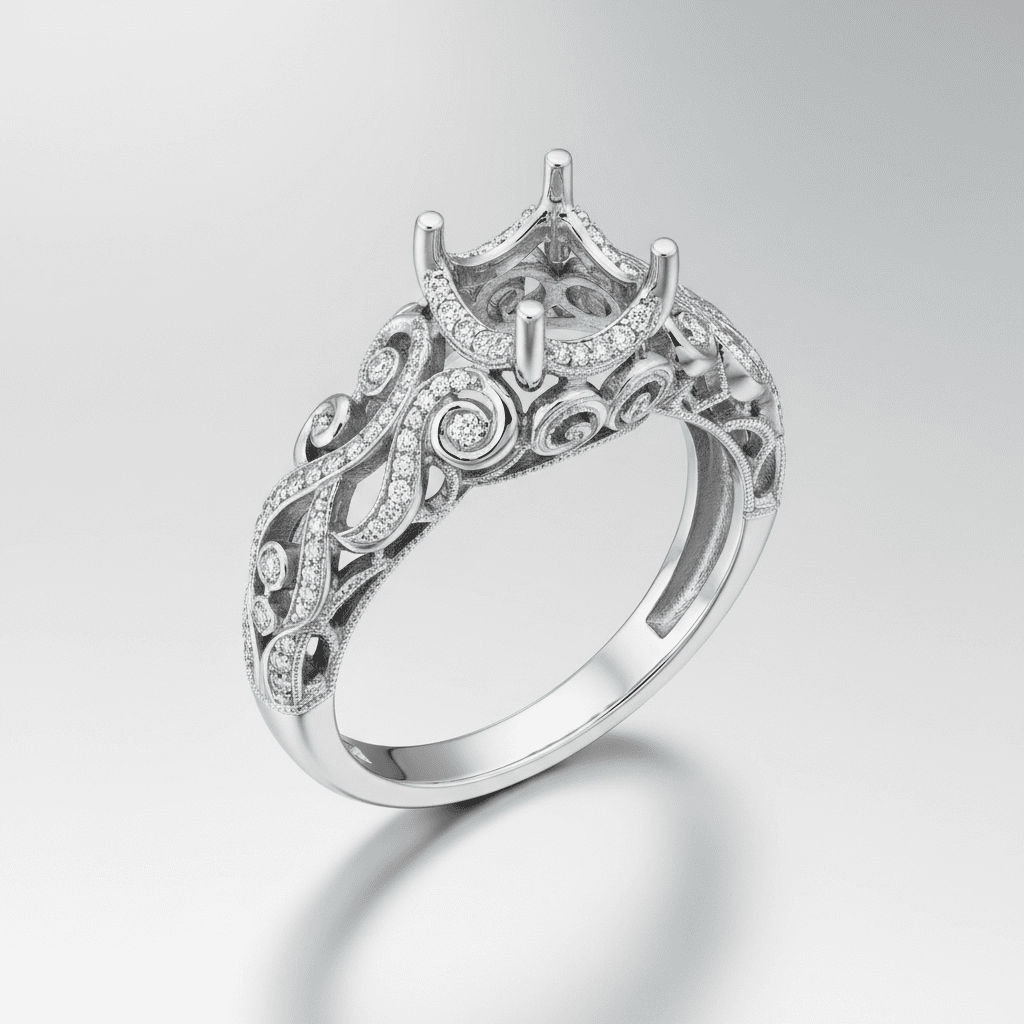
基础组件 2:铂金新艺术风格戒托,镂空工艺精湛。
合成结果:
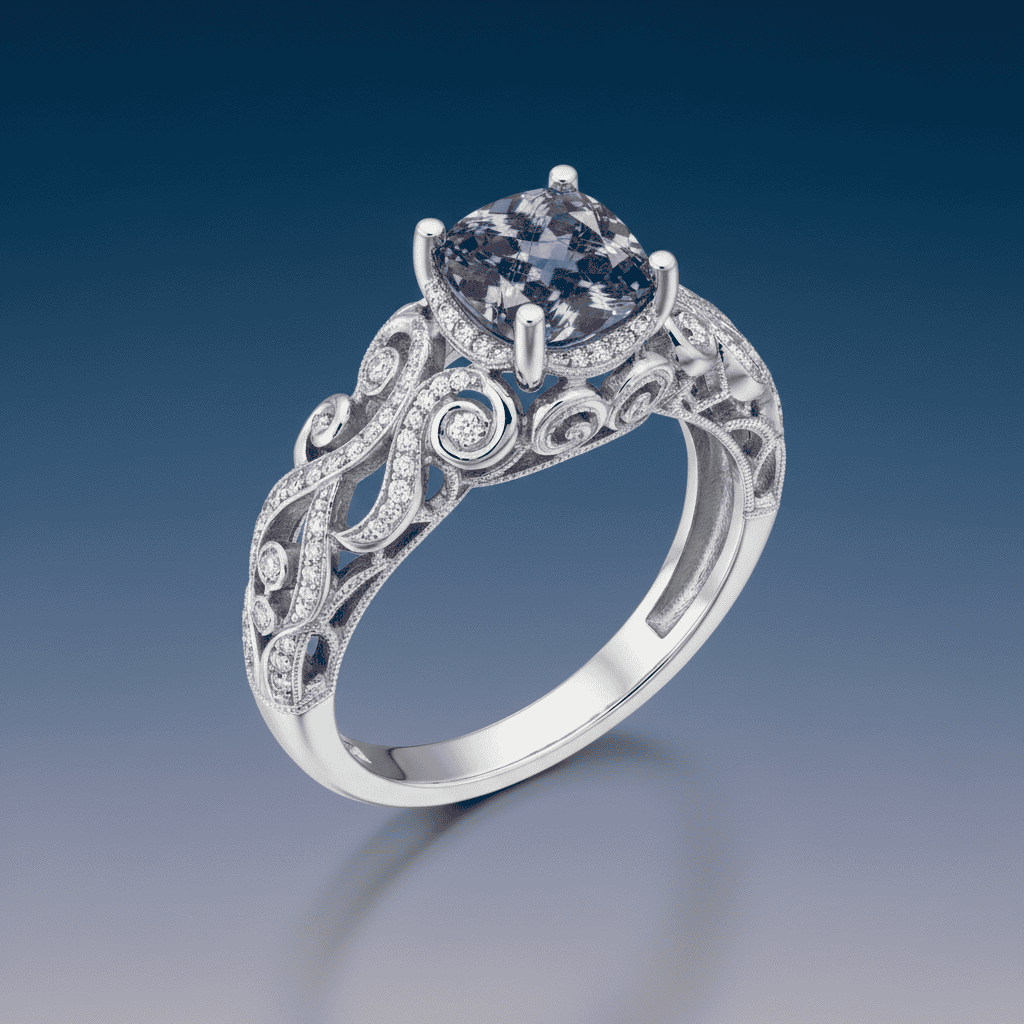
最终合成:宝石与戒托无缝结合,灯光完美突出两者特质,呈现奢华成品。
专业合成的关键在于明确以下方面:
该技巧适用于:
与多数需从头开始修改的图像模型不同,Gemini 2.5 Flash Image 支持通过对话进行逐步改进。这让它非常适合需要不断打磨概念的专业设计工作流。
我们以高端音频设备开发为例:
# Step 1: Start with concept design
concept_img = Image.open("https://cdn-images-1.medium.com/proxy/1*2qw1o9vPjUMHCwYnvHiYbA.png")

# Step 2: First refinement - luxury materials
response1 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Refine this speaker with premium ebony wood veneer finish, hand-polished surfaces, subtle gold accent lines, maintaining same proportions",
       concept_img
   ]
)

# Step 3: Second refinement - high-tech features
luxuryimg = Image.open("https://cdn-images-1.medium.com/proxy/1*kytHi4QRCmbor1e35Nyyw.png")

response2 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Add sophisticated LED indicators, premium fabric grille, wireless connectivity features, maintaining all luxury finishes",
       luxury_img
   ]
)
第 1 步:概念设计
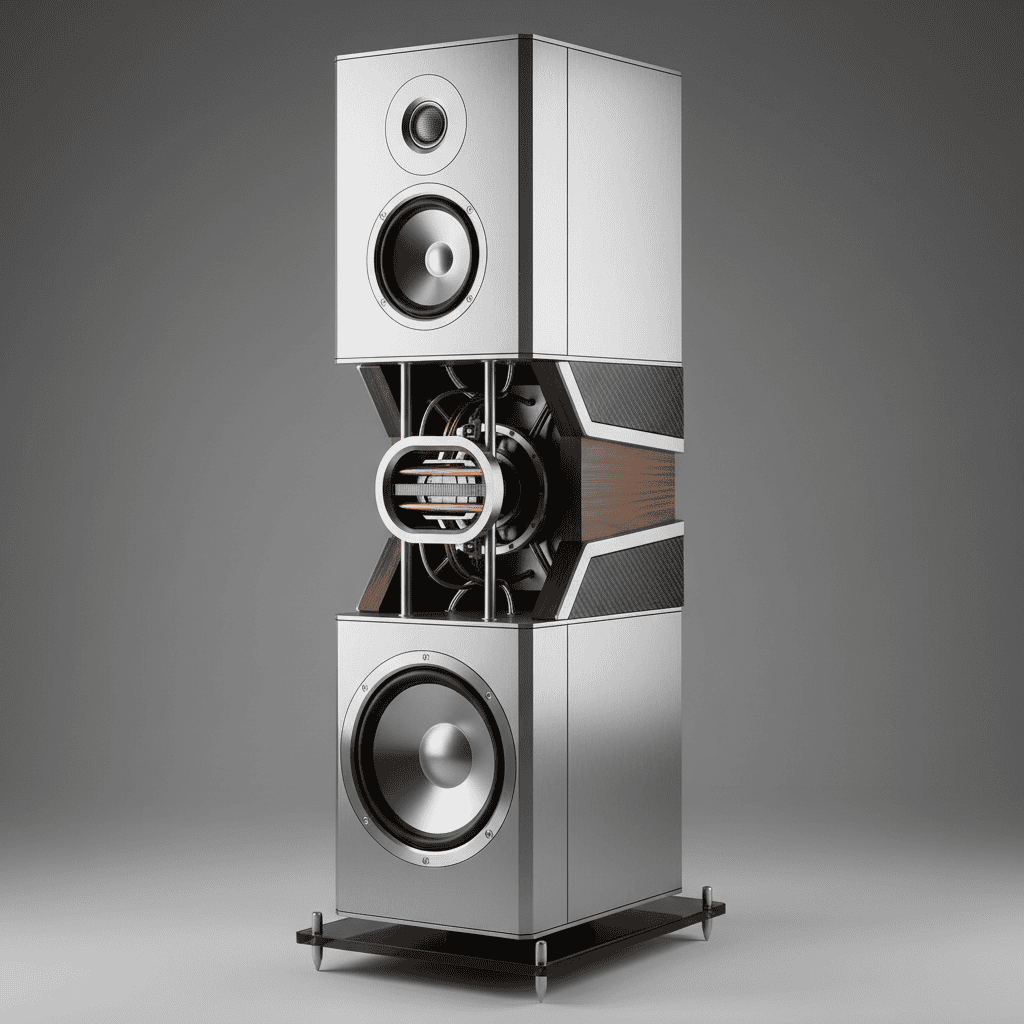
起始概念:简洁的几何设计,体现成熟工程与高端材料基础。
第 2 步:奢华材质优化
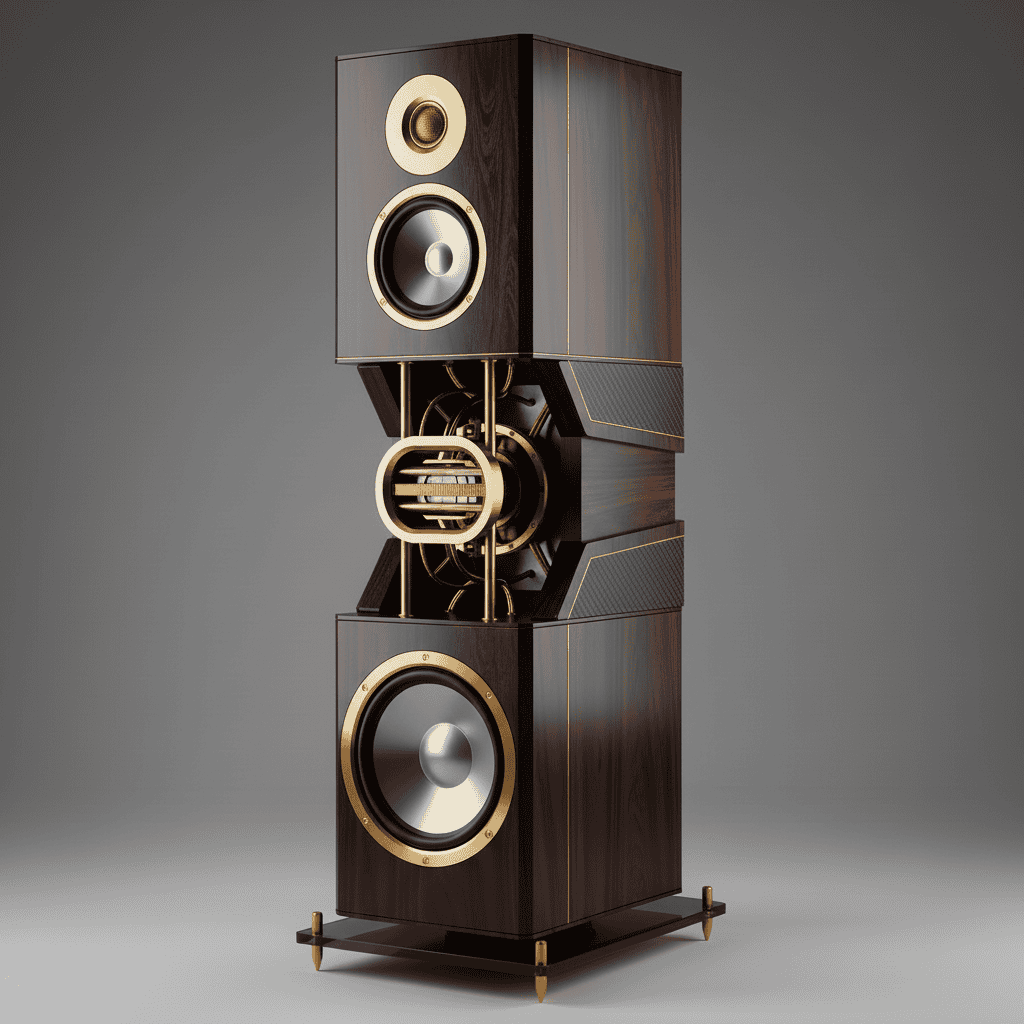
首次迭代:在保持原有比例的前提下,加入黑檀木单板与手工抛光的金色点缀。
第 3 步:高科技集成
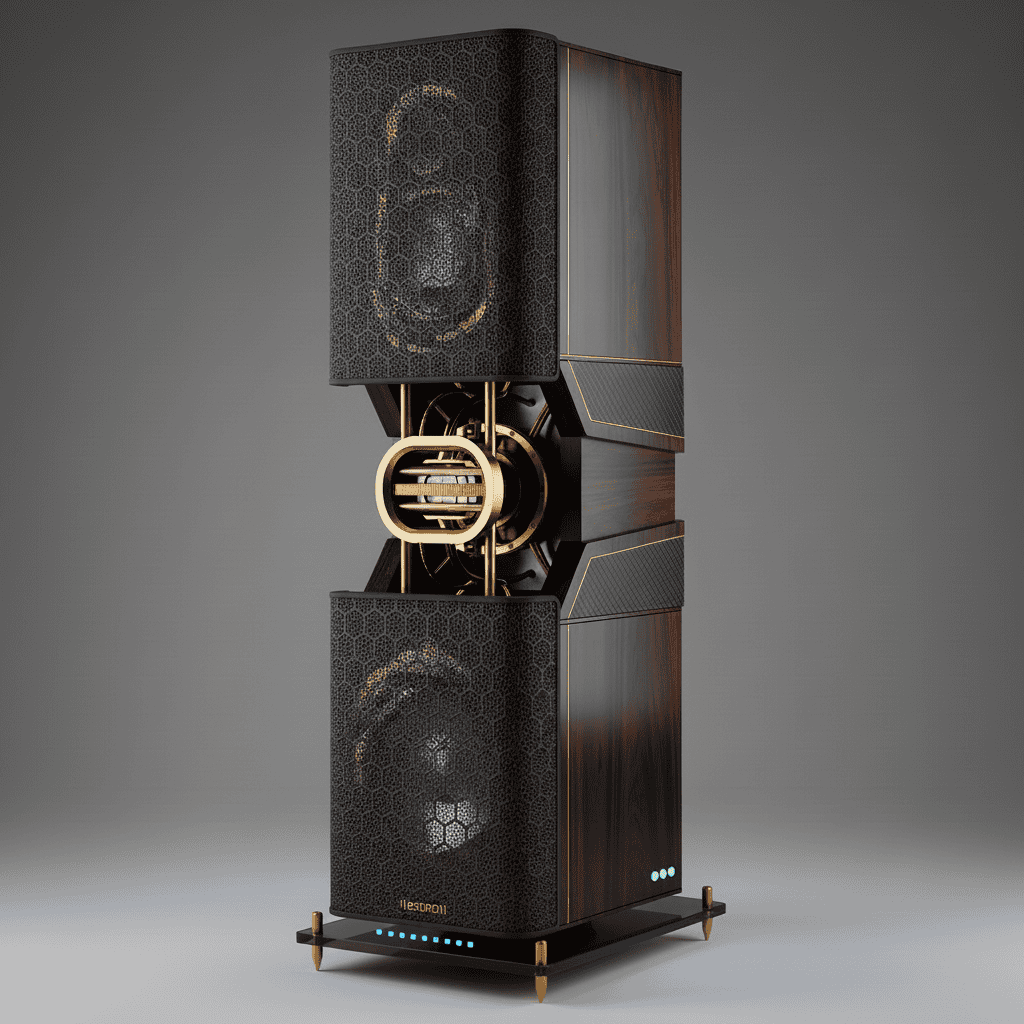
最终迭代:加入精致的 LED 指示灯与高端织物网罩,同时保留所有奢华饰面。
专业迭代优化的最佳实践:
在多个语境中保持角色一致,对于奢侈品牌建设与高级营销活动至关重要。Gemini 能理解角色的“视觉 DNA”,并在不同专业应用中保持其一致性。
以下展示如何打造一个精致的品牌吉祥物:
# After creating your base character
basemascot = Image.open("https://cdn-images-1.medium.com/proxy/1*Szx9SZ9UPl7zsa5NKUDVg.png")

# Generate consistent applications
response1 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Show this exact crystal mascot in an upscale jewelry boutique, maintaining identical facets and rose-gold glow",
       base_mascot
   ]
)

response2 = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Show this exact crystal mascot on luxury packaging design, maintaining identical geometric form and internal glow",
       base_mascot
   ]
)
第 1 步:确立品牌角色
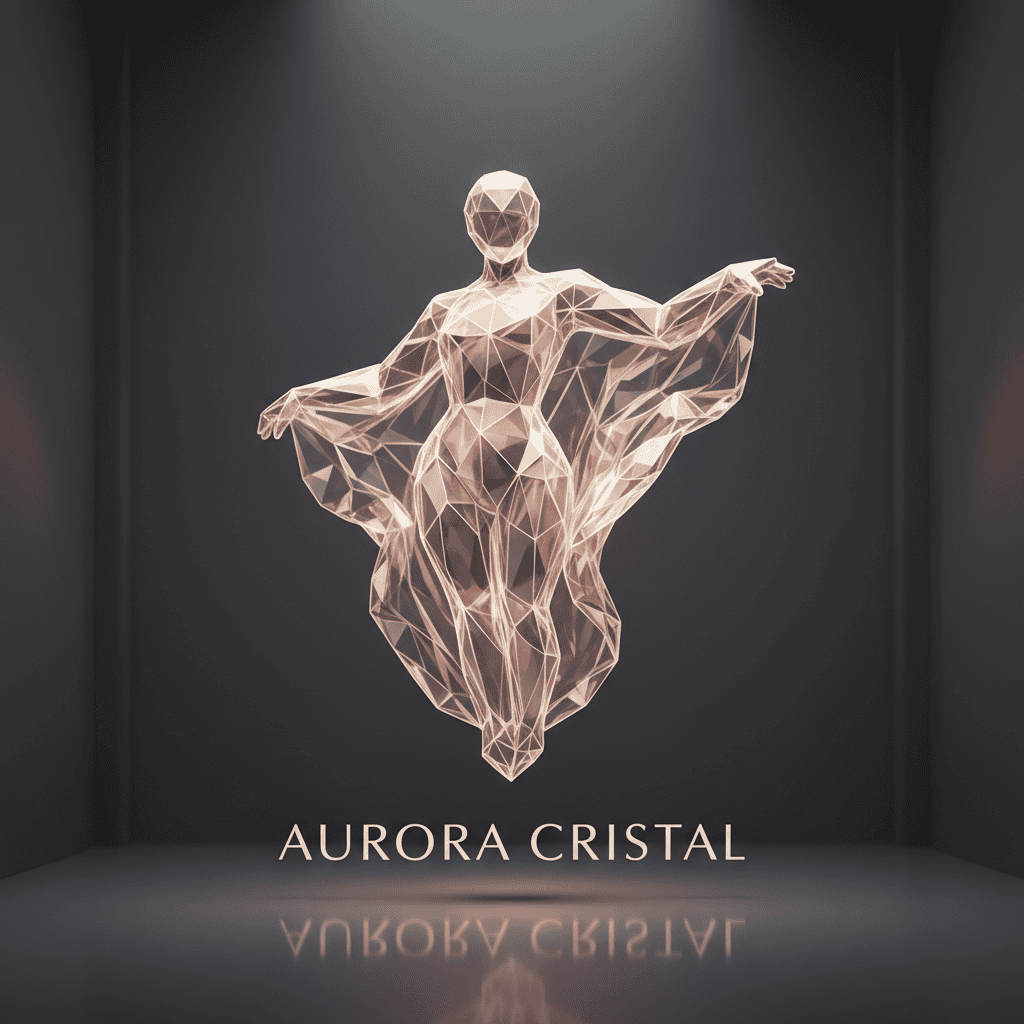
品牌角色基础:精致的几何水晶生命体,具备独特几何切面与玫瑰金色内部荧光。
第 2 步:零售场景应用
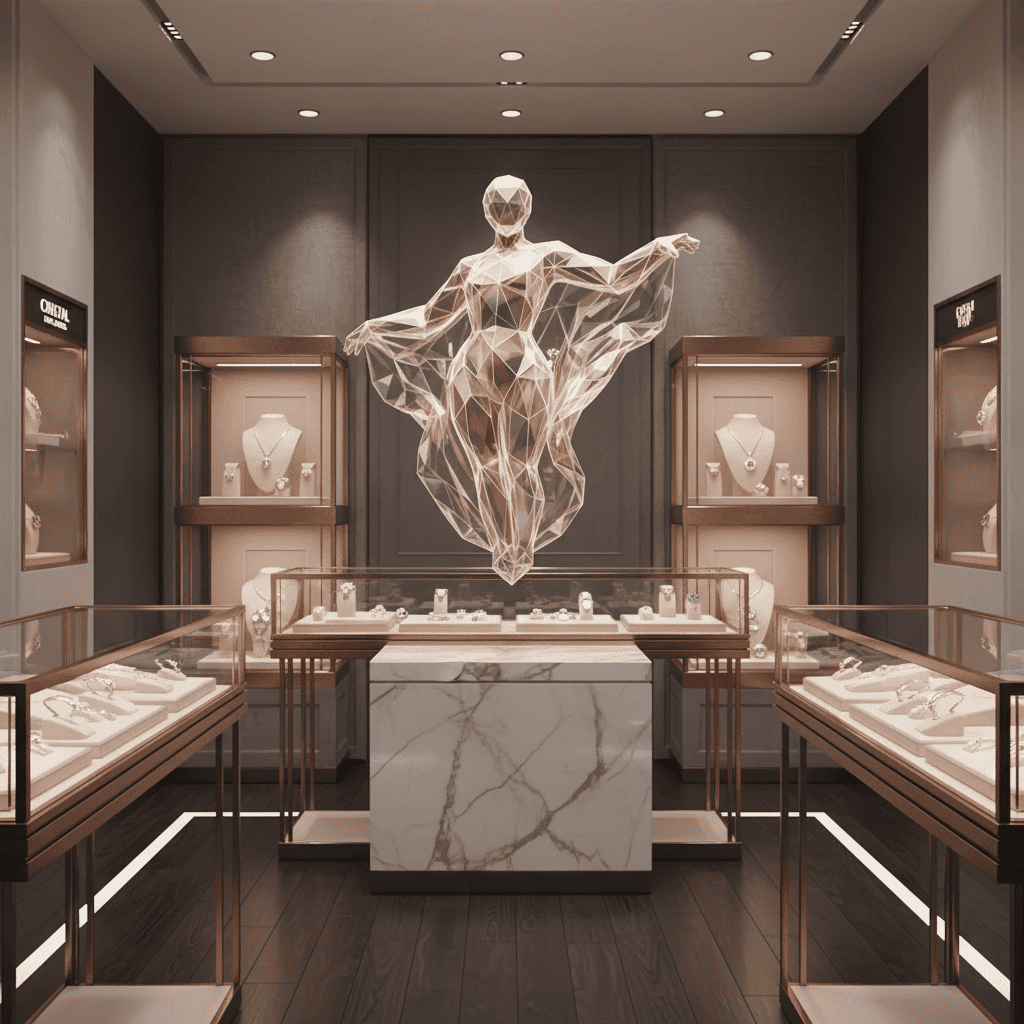
精品店应用:角色在高端零售语境中保持完全一致的几何切面与荧光。
第 3 步:包装设计整合
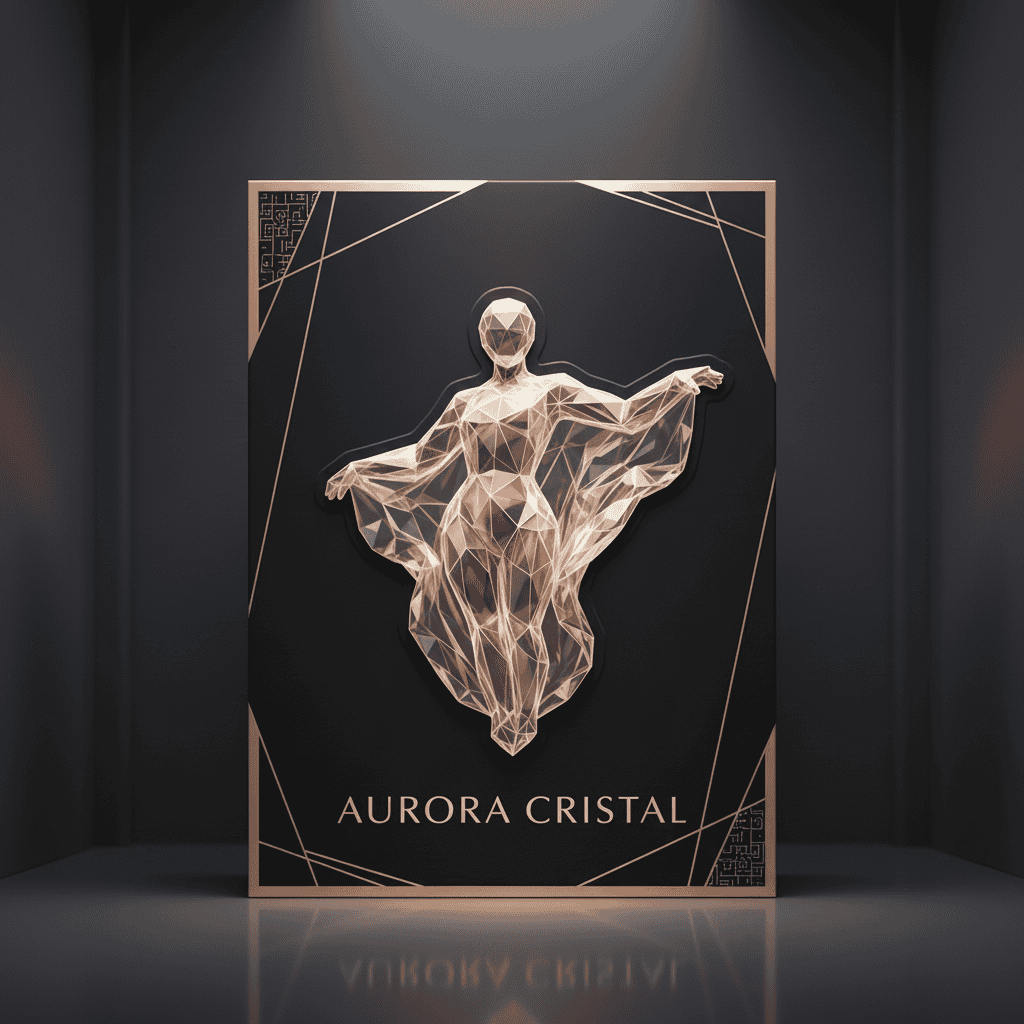
包装整合:在高端包装审美中沿用相同角色,确保视觉身份一致。
第 4 步:数字界面呈现
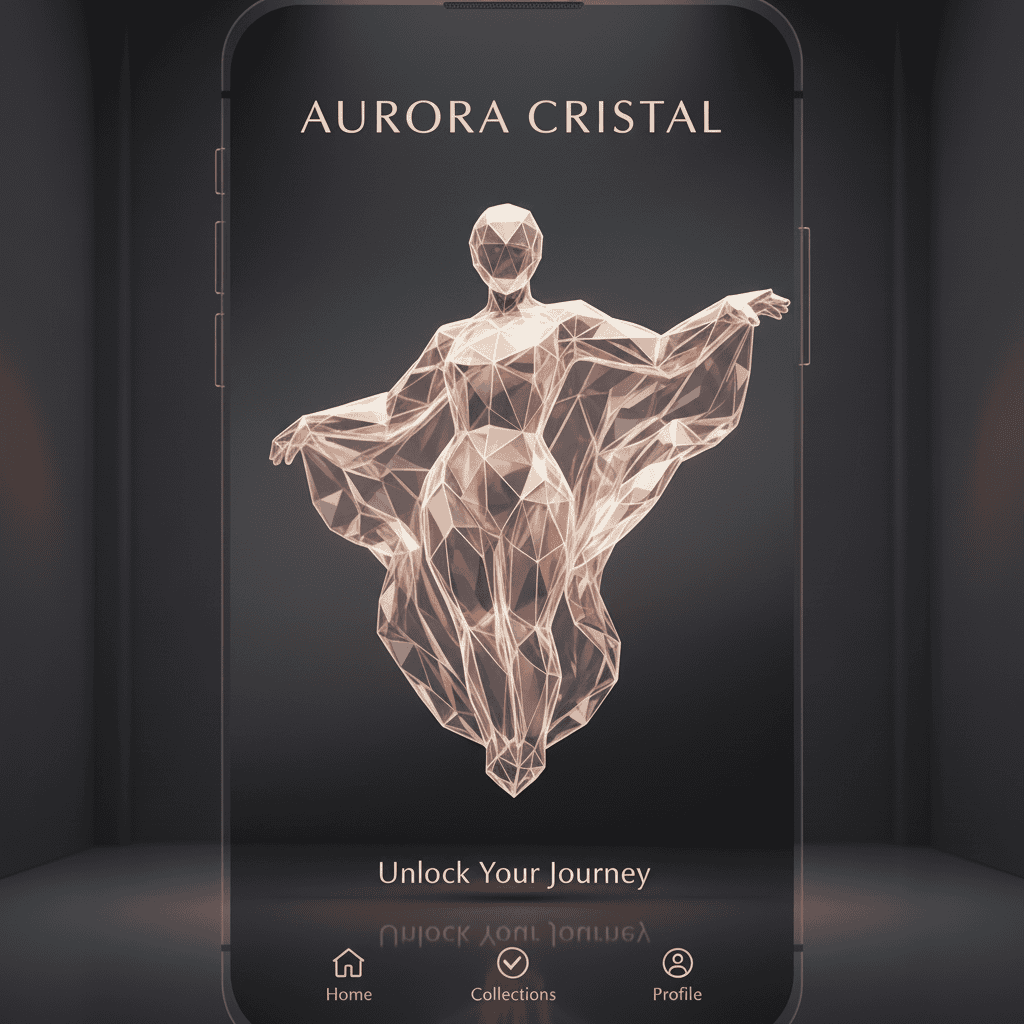
数字应用:在各数字平台保持一致的几何属性与角色形象。
实现专业一致性的表述模式是“this exact [character](就是这个角色)”,并辅以具体特征描述:“maintaining identical facets(保持相同切面)”、“same geometric form(相同几何形态)”、“identical rose-gold glow(相同玫瑰金荧光)”。
专业角色一致性的要点:
该功能适用于:
除了编辑内容,您还可以在保持对象核心结构的同时,改变其整体审美风格。这对于快速测试不同设计方向非常强大。
用于风格测试的基础对象:
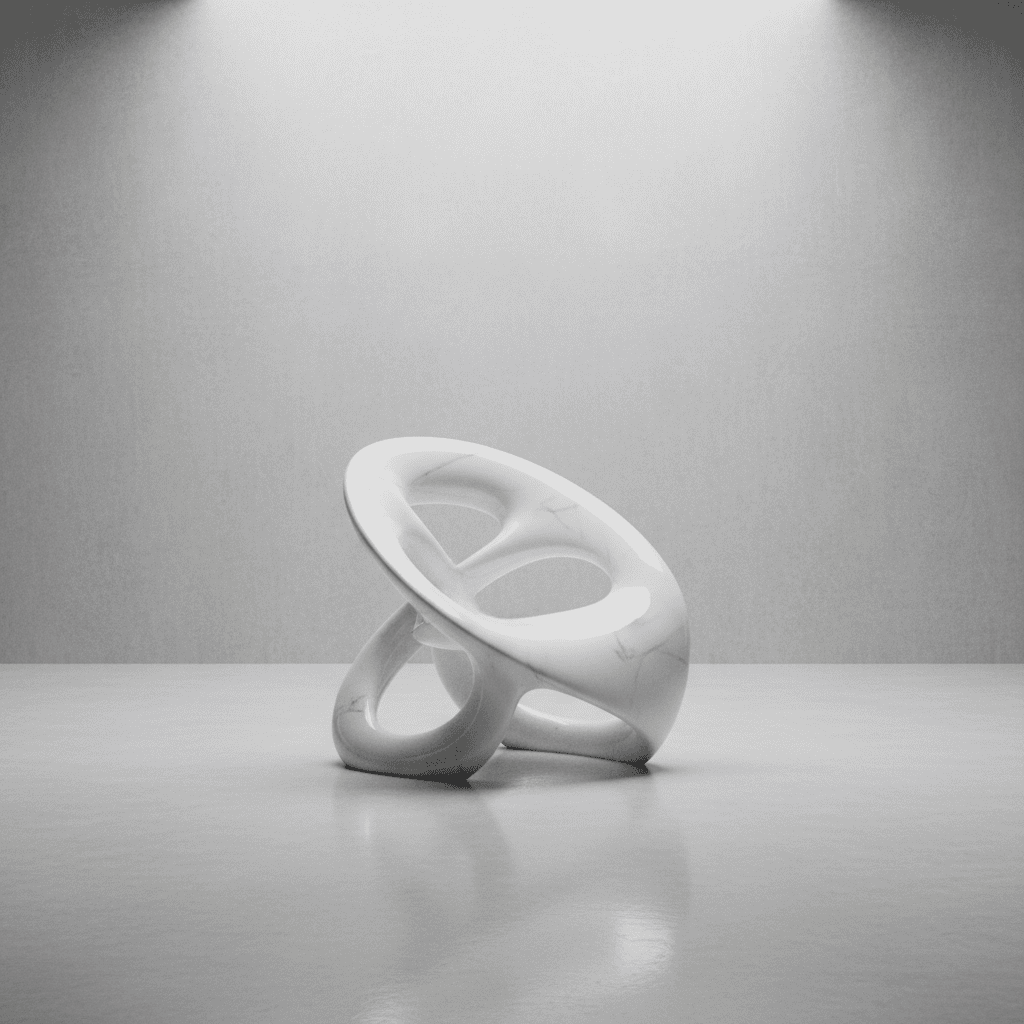
起点:一把设计精巧的雕塑感椅子,我们将把它改造成完全不同的风格。
赛博朋克变换:
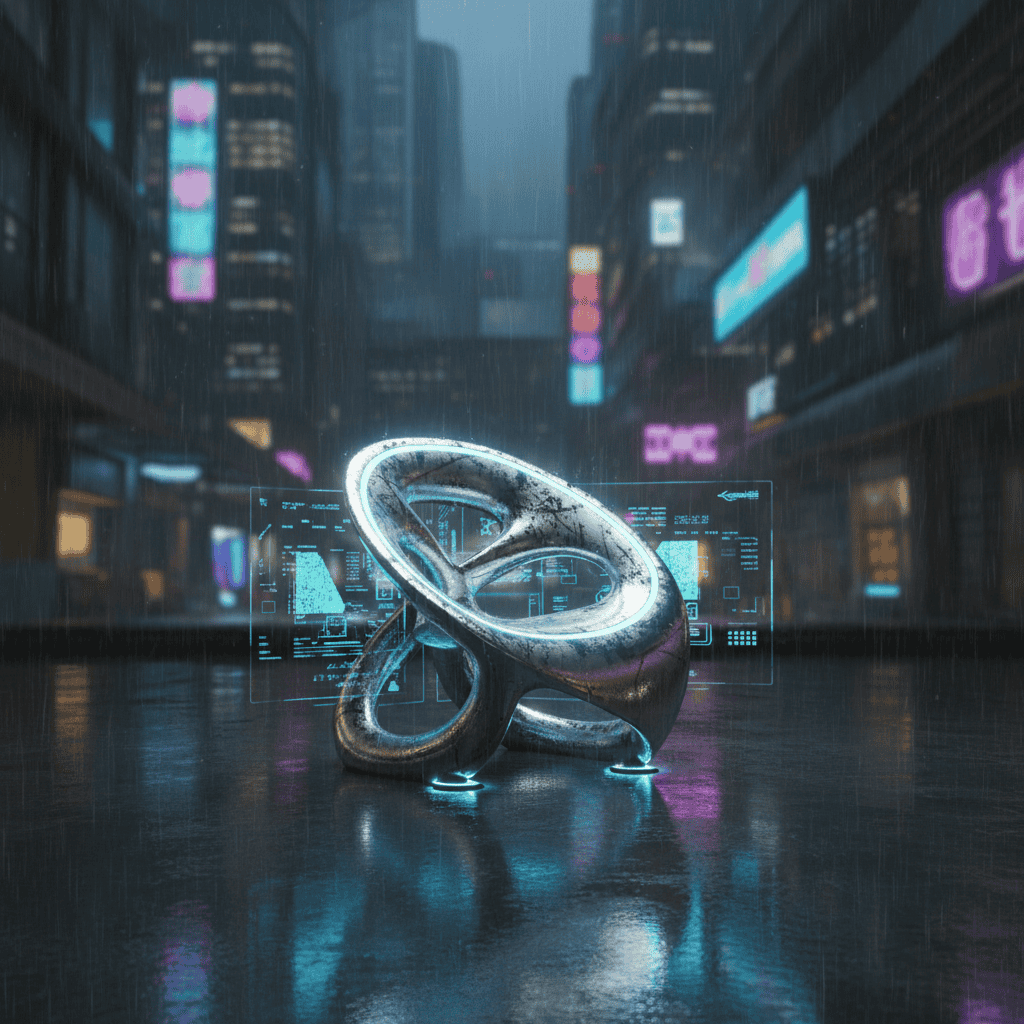
赛博朋克版本:充满未来科技感,带有霓虹点缀与金属质感,同时保留椅子的基本形态。
维多利亚巴洛克变换:
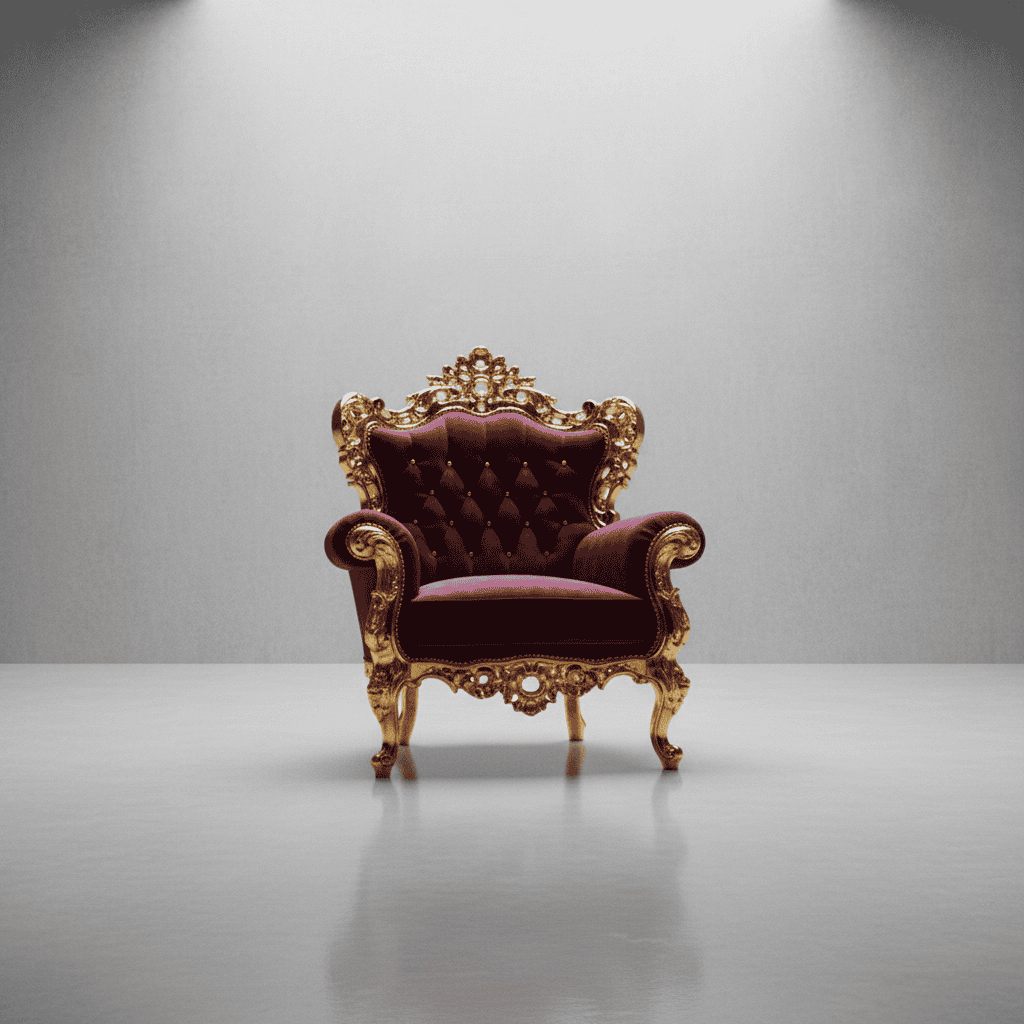
巴洛克风:华丽经典的装饰风格,材质奢华、细节繁复,同时保留相同的底层结构。
风格迁移的提示模式:
# Load your base object
base_object = Image.open("https://cdn-images-1.medium.com/proxy/1*TWO2meqMNnS1-6XSO6yv7Q.png")

# Apply style transformations
response = client.models.generate_content(
   model="gemini-2.5-flash-image-preview",
   contents=[
       "Change this chair into cyberpunk style with neon LED strips, chrome frame, futuristic aesthetic",
       base_object
   ]
)
风格迁移的应用场景:
这些高级功能——多图合成、迭代优化、角色一致性与风格迁移——构成了 Gemini 2.5 Flash Image 在专业工作流中尤为强大的核心优势。
Gemini 2.5 Flash Image 采用了不同于以往的图像生成思路。您可以通过对话直接编辑,而不是每次改动都从头开始。角色一致性功能可在不同场景中保持视觉元素统一,而多图合成让元素结合更自然、不生硬。
基于 token 的计费结构让项目成本可预测。若您准备超越基础用法, 官方文档涵盖更多功能,并持续更新。本文技巧应能为您将对话式图像生成纳入工作流打下扎实基础。
如果您希望在 Gemini 之外扩展 AI 工具箱,我们的 Gemini 图像编辑实用指南探讨更多编辑能力,而我们的 DALL-E 3 教程则介绍 OpenAI 的另一种 AI 图像生成方案。
Top DataCamp Courses
课程
课程
学习路径