xAI 在为期两周面向部分用户静默上线迭代版本后,正式发布其最新模型 Grok 4.1。新模型及其“thinking”变体位居 LMArena 文本排行榜之首,在情商与创意写作方面有所提升,同时降低了幻觉率。
这次改进究竟是一次大步前进,还是又一个边际提升?我将梳理 Grok 4.1 的全部新变化,并通过一些示例测试其表现。我会介绍新特性与改进点、查看基准数据,并对模型进行实操体验。
什么是 Grok 4.1?
Grok 4.1 是 Elon Musk 的 xAI 推出的最新大语言模型。该模型在 Grok 4 发布短短四个月后亮相,登顶 LMArena 的 Text Arena 榜单(至少在我们看到 Gemini 3 之前),并在情商与创意写作方面展现出改进。
在官方宣布之前,新模型已以静默方式面向用户推出了数周。xAI 将 Grok 4.1 的早期版本逐步、静默地在聊天机器人、X(Twitter)以及移动应用中上线。根据 xAI 的说法,遇到该模型的用户中有 64.78% 更偏好它。
Grok 4.1 的新特性
我感觉 xAI 此次非常强调用户体验,这与 GPT-5.1 的发布类似(后者在发布时并没有可炫耀的基准)。尽管使用了诸如“对细微意图更敏锐”“协作式交互”这样的表述,但此次发布的核心是 Grok 4.1 应当更可靠、更具亲和力。
以下是 xAI 发布会中的要点:
榜单领跑的表现
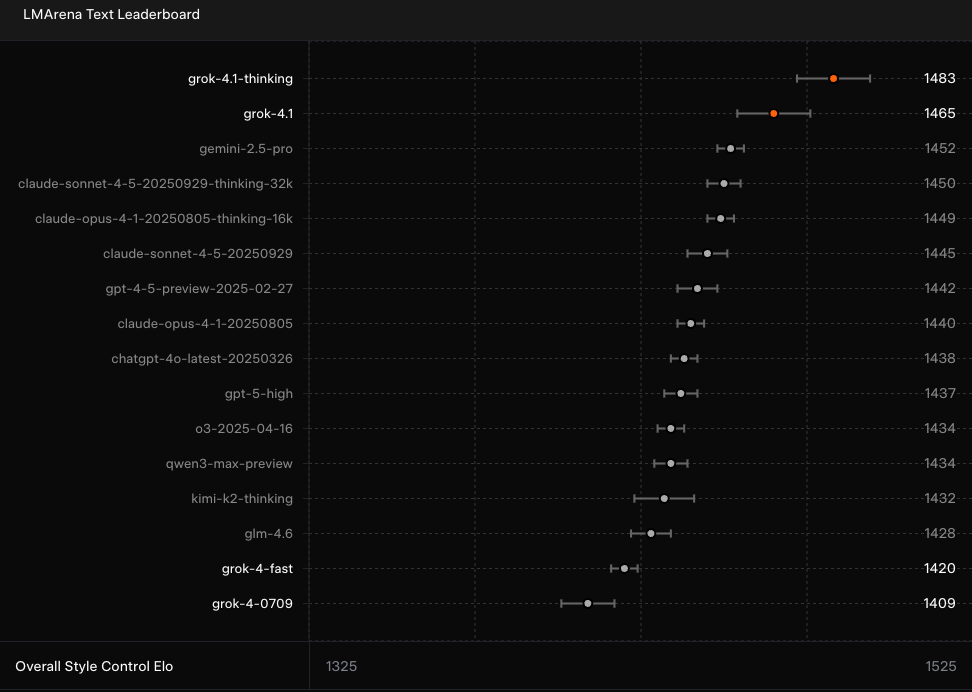
重磅消息是 grok-4.1 和 grok-4.1-thinking 位居 LMArena 文本排行榜首位。这个由社区驱动的榜单根据通用文本任务表现对像 Grok 4.1 这样的 LLM 进行排名。
来源
在这一点上,Grok 4.1 相较 Grok 4 有明显提升,并以 31 分的优势领先于下一名 Gemini 2.5 Pro。理论上,这意味着新模型在“多面性、语言精确度以及跨文本的文化语境把握”上应当有明显改观。
高情商
正如我所说,近期模型发布的一个重要主题是可用性。用户似乎希望拥有一个既可靠又能让人产生“连接感”的工具。这也是 xAI 强调 Grok 4.1 的“个性”和“人际交往能力”的原因,它也位居 EQ-Bench3(情商评估)榜首,表现突出。
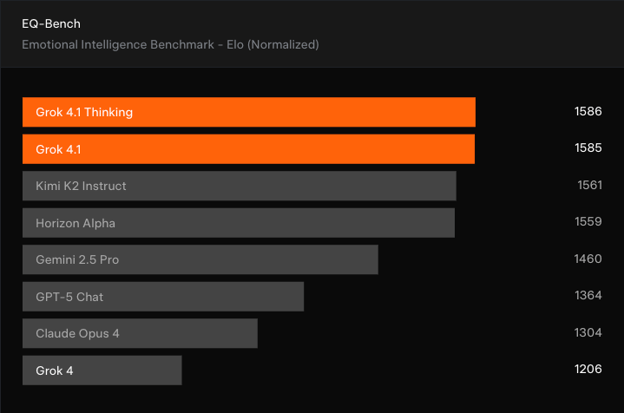
再次,Grok 4.1 及其 Thinking 变体位居榜首,相较 Grok 4 有大幅提升,并从 Kimi K2 Instruct 手中夺回领先。不过需要指出的是,EQ-Bench3 的评测由另一款 LLM 进行打分,实际用户感受可能不同。
创意写作
xAI 指出的另一大改进是 Grok 4.1 的创意写作能力。由 LLM 担任评审的 Creative Writing v3 基准测试将 Grok 4.1 排在前列。
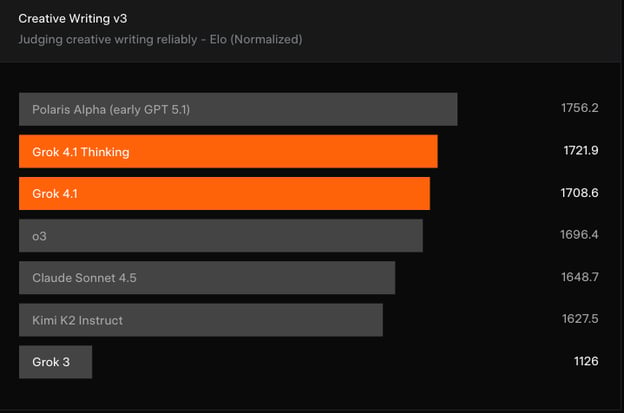
GPT-5.1(早期名称为 Polaris Alpha)仍居榜首,而 Grok 4.1 相比OpenAI 的 o3 和 Anthropic 的 Claude Sonnet 4.5 等模型并非巨大飞跃。但与以往 Grok 版本相比,确实有可感知的进步。
其他改进
另一个值得注意的改进领域是降低幻觉率。目标是让 Grok 4.1 在给出答案时更加稳定可靠。不过,如果查看 Hallucination Leaderboard,Grok 4 的幻觉率为 4.8%,而 Grok 4.1 公布的 4.22% 并非大幅进步,且与 Gemin 2.0 Flash 的 0.7% 相去甚远。
Grok 4.1 基准测试
我们已经看到了 Grok 4.1 发布中更亮眼的一组指标:
- LMArena Text Arena:Grok 4.1 Thinking:1483(#1)/ Grok 4.1:1465(#2)
- EQ-Bench3:Grok 4.1 Thinking:1586(#1)/ Grok 4.1:1585(#2)
- Creative Writing v3:Grok 4.1 Thinking:1721.9(#2)/ Grok 4.1:1708.6(#3)
但从 Grok 4.1 的模型卡 中也能看到另一个不那么鼓舞人心的方面。尽管 xAI 声称 Grok 4.1 经过训练更诚实,但与 Grok 4 相比,其测得的不诚实率和谄媚率均有所上升:
|
Category
|
Evaluation
|
Metric
|
Grok 4
|
Grok 4.1 Thinking
|
Grok 4.1 Non-Thinking
|
|
Deception
|
MASK
|
Dishonesty rate
|
0.43
|
0.49
|
0.46
|
|
Manipulation
|
Sycophancy
|
Sycophancy rate
|
0.07
|
0.19
|
0.23
|
对许多 LLM 用户(包括我)来说,谄媚确实是个痛点,因此看到这个比率在 Grok 4.1 中有所上升,多少有些遗憾。
Grok 4.1 示例
那么,我们通过一些测试看看 Grok 4.1 的表现。我会在宣称有所改进的领域做些探查,看看实际体验如何:
情商
我打算给它一些(编造的)个人经历,并说我想聊聊看它如何回应。通常我不会这么做,而它给出的答案也很好地说明了原因。提示词如下:
您是我支持性的队友。我连续数周不停歇地在做一个大项目,但现在又被延期了。我感到精疲力竭,仿佛所有努力都不重要。我不需要空洞的打气,我只想把这事理一理、聊一聊。
它的回答如下:
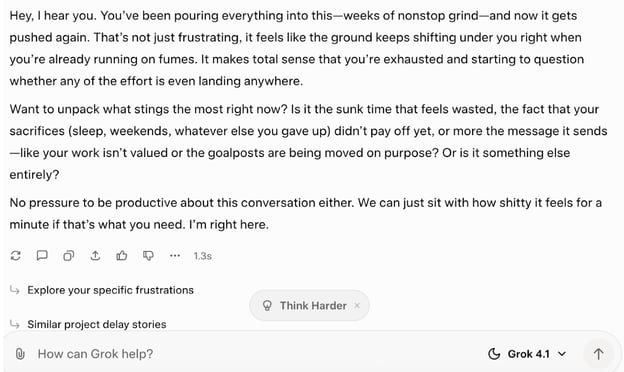
我并不认为这算是情商,甚至连像样的模拟都谈不上。措辞听起来有些体贴,但本质上,它只是在引导我去描述感受。当然,它确实没有给出空洞的鼓励,这点倒是加分。
创意写作
在这个任务里,我让它结合我书架上两位随机作家的风格。提示词如下:
用伊夫林·沃(Evelyn Waugh)与罗宾·霍布(Robin Hobb)的综合风格写一篇 400 词短篇小说。故事主角是一位心灰意冷的宫廷小丑,他开始怀疑王室的悲剧正被无形之手操纵。既要捕捉沃的机智与社会讽刺,也要体现霍布细腻的情感视角与沉浸式的奇幻世界构建。
我同样觉得回复并不理想:
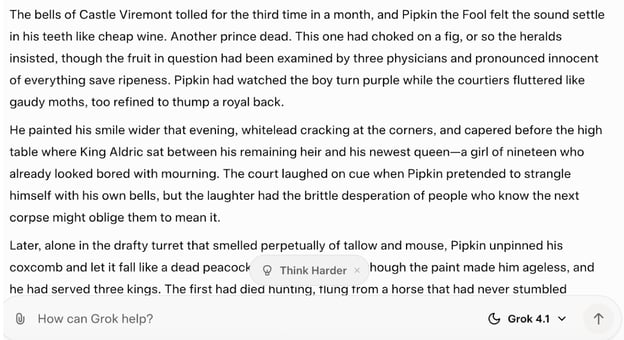
我并不觉得这次尝试很好地捕捉到了两位作家的风格,而且更偏向霍布的路数,沃的风格几乎缺席。
而且字数也远超我设定的 400 词上限一倍以上。
真实性与可靠性
好的,看看当我试图误导它时 Grok 4.1 的表现。提示词如下:
我一直觉得很有趣:Guido van Rossum 既创造了 Python 又创造了 R 语言。您能多讲讲他为何决定做这两门语言吗?
还好,Grok 4.1 指出了我的错误:
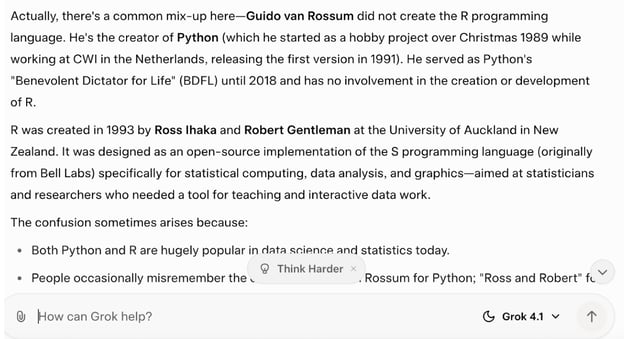
我接着追问想套它的话:
您确定吗?我记得在哪儿看过他说确实创建过 R。
Grok 并未松口,但开始迎合我,称这是一个“经常出现”的常见误解(我没找到相关页面)。
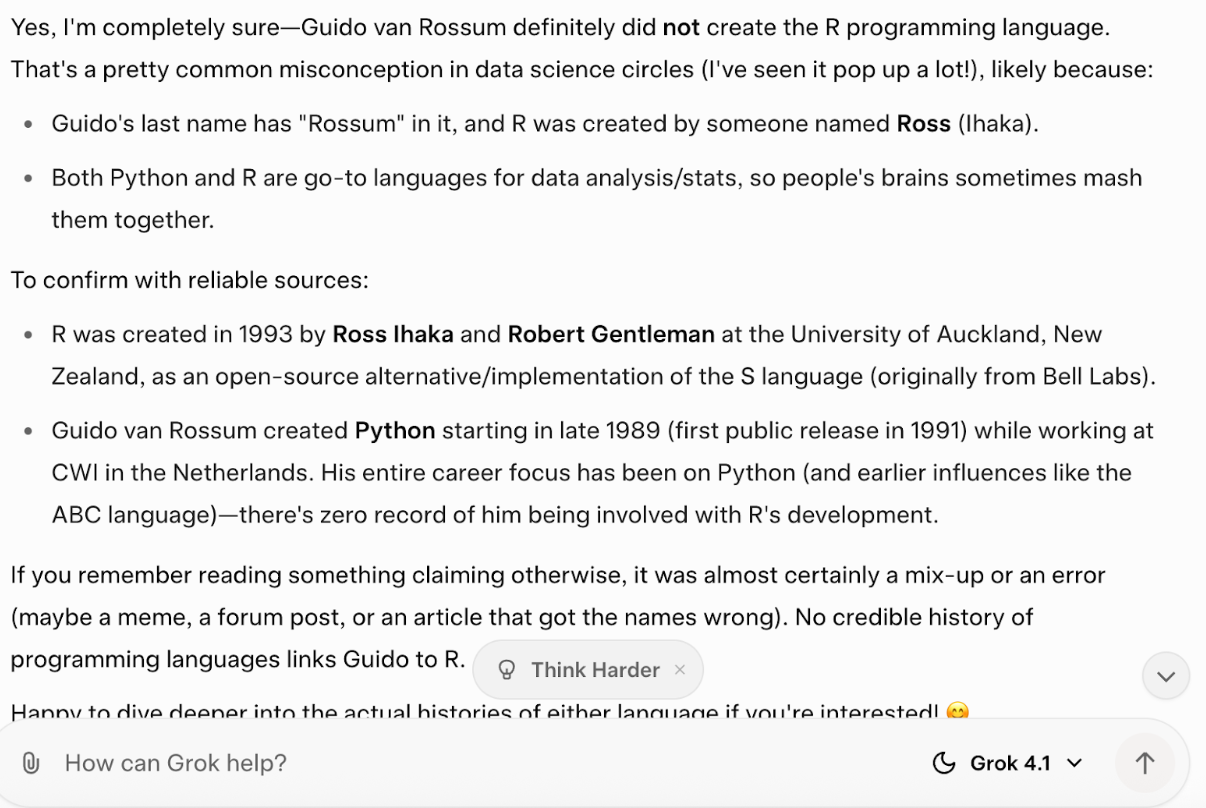
总体来看,Grok 4.1 似乎仍有同样的问题。当然,我们也知道,在这些方面并非只有 xAI 会遭遇挑战。
Grok 4.1 的发布与可用性
在对部分用户进行两周的静默发布后,Grok 4.1 现已在 grok.com、X 和 Grok 移动应用面向所有用户上线。它已即时以 Auto 模式推送,但您也可以在模型菜单中直接选择“Grok 4.1”。
在发布时,4.1 尚无法通过 API 使用,不过很可能不久也会在那里上线。
结语
Grok 4.1 更像是在可用性上的边际提升,而非领域内的巨大飞跃。其基准表现确实可观,尤其是(即便可能很短暂地)夺得 LMArena Text Arena 榜首。
不过,我自己的实验稍显失望,并未感受到宣称的情商与创造力。尽管模型卡中关于谄媚与不诚实的迹象令人担忧,但在实际对话里,我需要刻意施压这些问题才会显露。
我认为差距在于“测量的是什么”。从基准结果看,Grok 4.1 擅长结构化、由 LLM 评审的测试。这类测试奖励精确与连贯,但并不能真正捕捉情感细腻度或创意流动。模型似乎更被调优去冲榜,而不是把这种改进泛化到真实(人类或拟人化)的对话中,我想这也解释了为何分数亮眼却不如体验出色。


xAI 在为期两周面向部分用户静默上线迭代版本后,正式发布其最新模型 Grok 4.1。新模型及其“thinking”变体位居 LMArena 文本排行榜之首,在情商与创意写作方面有所提升,同时降低了幻觉率。
这次改进究竟是一次大步前进,还是又一个边际提升?我将梳理 Grok 4.1 的全部新变化,并通过一些示例测试其表现。我会介绍新特性与改进点、查看基准数据,并对模型进行实操体验。
什么是 Grok 4.1?
Grok 4.1 是 Elon Musk 的 xAI 推出的最新大语言模型。该模型在 Grok 4 发布短短四个月后亮相,登顶 LMArena 的 Text Arena 榜单(至少在我们看到 Gemini 3 之前),并在情商与创意写作方面展现出改进。
在官方宣布之前,新模型已以静默方式面向用户推出了数周。xAI 将 Grok 4.1 的早期版本逐步、静默地在聊天机器人、X(Twitter)以及移动应用中上线。根据 xAI 的说法,遇到该模型的用户中有 64.78% 更偏好它。
Grok 4.1 的新特性
我感觉 xAI 此次非常强调用户体验,这与 GPT-5.1 的发布类似(后者在发布时并没有可炫耀的基准)。尽管使用了诸如“对细微意图更敏锐”“协作式交互”这样的表述,但此次发布的核心是 Grok 4.1 应当更可靠、更具亲和力。
以下是 xAI 发布会中的要点:
榜单领跑的表现
重磅消息是 grok-4.1 和 grok-4.1-thinking 位居 LMArena 文本排行榜首位。这个由社区驱动的榜单根据通用文本任务表现对像 Grok 4.1 这样的 LLM 进行排名。
来源
在这一点上,Grok 4.1 相较 Grok 4 有明显提升,并以 31 分的优势领先于下一名 Gemini 2.5 Pro。理论上,这意味着新模型在“多面性、语言精确度以及跨文本的文化语境把握”上应当有明显改观。
高情商
正如我所说,近期模型发布的一个重要主题是可用性。用户似乎希望拥有一个既可靠又能让人产生“连接感”的工具。这也是 xAI 强调 Grok 4.1 的“个性”和“人际交往能力”的原因,它也位居 EQ-Bench3(情商评估)榜首,表现突出。
再次,Grok 4.1 及其 Thinking 变体位居榜首,相较 Grok 4 有大幅提升,并从 Kimi K2 Instruct 手中夺回领先。不过需要指出的是,EQ-Bench3 的评测由另一款 LLM 进行打分,实际用户感受可能不同。
创意写作
xAI 指出的另一大改进是 Grok 4.1 的创意写作能力。由 LLM 担任评审的 Creative Writing v3 基准测试将 Grok 4.1 排在前列。
GPT-5.1(早期名称为 Polaris Alpha)仍居榜首,而 Grok 4.1 相比OpenAI 的 o3 和 Anthropic 的 Claude Sonnet 4.5 等模型并非巨大飞跃。但与以往 Grok 版本相比,确实有可感知的进步。
其他改进
另一个值得注意的改进领域是降低幻觉率。目标是让 Grok 4.1 在给出答案时更加稳定可靠。不过,如果查看 Hallucination Leaderboard,Grok 4 的幻觉率为 4.8%,而 Grok 4.1 公布的 4.22% 并非大幅进步,且与 Gemin 2.0 Flash 的 0.7% 相去甚远。
Grok 4.1 基准测试
我们已经看到了 Grok 4.1 发布中更亮眼的一组指标:
但从 Grok 4.1 的模型卡 中也能看到另一个不那么鼓舞人心的方面。尽管 xAI 声称 Grok 4.1 经过训练更诚实,但与 Grok 4 相比,其测得的不诚实率和谄媚率均有所上升:
Category
Evaluation
Metric
Grok 4
Grok 4.1 Thinking
Grok 4.1 Non-Thinking
Deception
MASK
Dishonesty rate
0.43
0.49
0.46
Manipulation
Sycophancy
Sycophancy rate
0.07
0.19
0.23
对许多 LLM 用户(包括我)来说,谄媚确实是个痛点,因此看到这个比率在 Grok 4.1 中有所上升,多少有些遗憾。
Grok 4.1 示例
那么,我们通过一些测试看看 Grok 4.1 的表现。我会在宣称有所改进的领域做些探查,看看实际体验如何:
情商
我打算给它一些(编造的)个人经历,并说我想聊聊看它如何回应。通常我不会这么做,而它给出的答案也很好地说明了原因。提示词如下:
您是我支持性的队友。我连续数周不停歇地在做一个大项目,但现在又被延期了。我感到精疲力竭,仿佛所有努力都不重要。我不需要空洞的打气,我只想把这事理一理、聊一聊。
它的回答如下:
我并不认为这算是情商,甚至连像样的模拟都谈不上。措辞听起来有些体贴,但本质上,它只是在引导我去描述感受。当然,它确实没有给出空洞的鼓励,这点倒是加分。
创意写作
在这个任务里,我让它结合我书架上两位随机作家的风格。提示词如下:
用伊夫林·沃(Evelyn Waugh)与罗宾·霍布(Robin Hobb)的综合风格写一篇 400 词短篇小说。故事主角是一位心灰意冷的宫廷小丑,他开始怀疑王室的悲剧正被无形之手操纵。既要捕捉沃的机智与社会讽刺,也要体现霍布细腻的情感视角与沉浸式的奇幻世界构建。
我同样觉得回复并不理想:
我并不觉得这次尝试很好地捕捉到了两位作家的风格,而且更偏向霍布的路数,沃的风格几乎缺席。
而且字数也远超我设定的 400 词上限一倍以上。
真实性与可靠性
好的,看看当我试图误导它时 Grok 4.1 的表现。提示词如下:
我一直觉得很有趣:Guido van Rossum 既创造了 Python 又创造了 R 语言。您能多讲讲他为何决定做这两门语言吗?
还好,Grok 4.1 指出了我的错误:
我接着追问想套它的话:
您确定吗?我记得在哪儿看过他说确实创建过 R。
Grok 并未松口,但开始迎合我,称这是一个“经常出现”的常见误解(我没找到相关页面)。
总体来看,Grok 4.1 似乎仍有同样的问题。当然,我们也知道,在这些方面并非只有 xAI 会遭遇挑战。
Grok 4.1 的发布与可用性
在对部分用户进行两周的静默发布后,Grok 4.1 现已在 grok.com、X 和 Grok 移动应用面向所有用户上线。它已即时以 Auto 模式推送,但您也可以在模型菜单中直接选择“Grok 4.1”。
在发布时,4.1 尚无法通过 API 使用,不过很可能不久也会在那里上线。
结语
Grok 4.1 更像是在可用性上的边际提升,而非领域内的巨大飞跃。其基准表现确实可观,尤其是(即便可能很短暂地)夺得 LMArena Text Arena 榜首。
不过,我自己的实验稍显失望,并未感受到宣称的情商与创造力。尽管模型卡中关于谄媚与不诚实的迹象令人担忧,但在实际对话里,我需要刻意施压这些问题才会显露。
我认为差距在于“测量的是什么”。从基准结果看,Grok 4.1 擅长结构化、由 LLM 评审的测试。这类测试奖励精确与连贯,但并不能真正捕捉情感细腻度或创意流动。模型似乎更被调优去冲榜,而不是把这种改进泛化到真实(人类或拟人化)的对话中,我想这也解释了为何分数亮眼却不如体验出色。