
课程
Practical AI with Google Gemini and NotebookLM
2 小时
10K
提示:Google 近期又宣布了Gemini 3.8 Flash 和 3.8 Flash Cyber。在我们的Gemini 3.8 Flash API 教程中查看其实际效果。
Google 今日发布了三款 Gemini 模型,目标一致:用更少的 tokens 完成更多工作:
3.6 Flash 是通用型升级。Flash-Lite 以速度与价格换取质量。Cyber 是面向安全的窄域工具,大多数人无法获得访问权限。
下文将介绍各模型的实际用途、基准数据表现,以及 Gemini 3.5 Pro 在其中的定位。
三者分别处于不同的性价比位置。如果您打算根据基准结果来选,请继续往下看;基准数据在后文。
Gemini 3.6 Flash 是此次发布的核心。Google 希望您在编程、知识工作,以及任何多模态任务上默认选用它。
根据 Artificial Analysis 指数,与3.5 Flash相比,3.6 Flash 将输出 token 用量减少了 17%,而 Google 报告称在 DeepSWE 等单项评测上降幅可高达 65%。部分来源于更聪明的模型“少说话”。其余得益于用更少的推理步骤与工具调用就能得出结论,这是一种不同类型的增益,也更难“作假”。
3.6 Flash 接受文本、图像、视频、音频与 PDF 作为输入,提供 100 万 token 的上下文窗口与 64k 的输出上限。计算机使用能力如今已内置于 Gemini API 与 Gemini Enterprise,同时支持函数调用、结构化输出与“搜索即工具”。(不过这可能已不再是 3.6 Flash 独有;多数前沿实验室如今都已提供某种形式的计算机使用能力。)
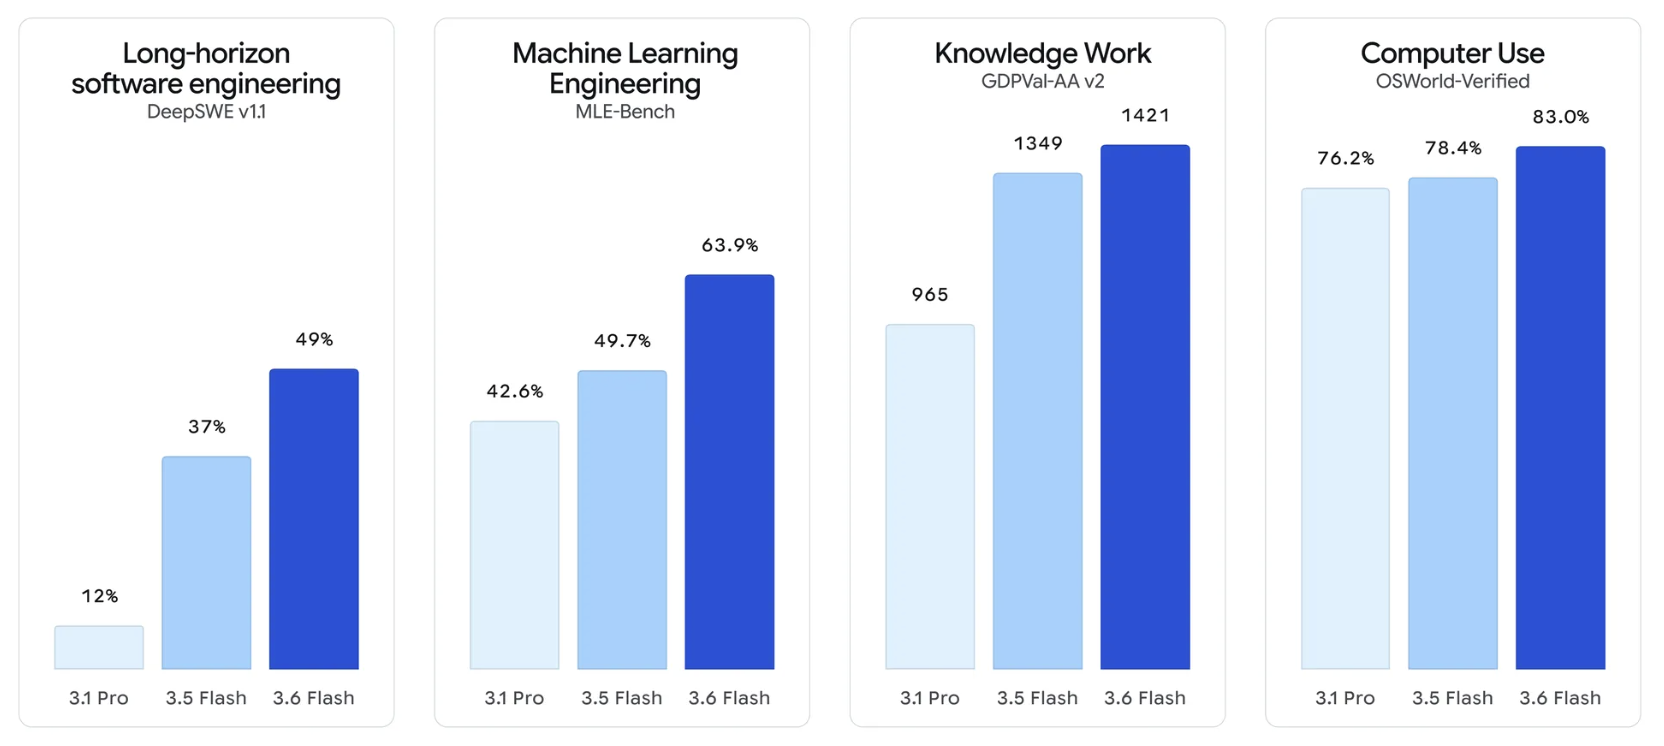
与其前代相比,几乎全面跃升:DeepSWE 几近翻倍,MLE-Bench 从 49.7% 升至 63.9%,GDM-MRCR v2 的长上下文表现提升达两位数。
3.5 Flash-Lite 并不追求成为此系列中最聪明的模型。它是最快的,每秒 350 个输出 token;它也是最便宜的,输入 $0.30/百万 token,输出 $2.50/百万 token。
如果您的工作负载是高并发、对延迟敏感——比如代理式搜索、批量文档处理、任何每天运行数千次的任务——那么为追求更高质量而付出的成本很可能得不偿失。这正是 Flash-Lite 的押注。
开发者可按任务调节“思考层级”:最小或较低,用于廉价、快速的高吞吐执行;更高,用于确实需要多步推理的子代理工作。
对比其前代 3.1 Flash-Lite,差距显著:Terminal-Bench 2.1 从 31% 升至 54%,GDM-MRCR v2 从 60.1% 到 72.2%,GDPVal-AA v2(Elo)从 642 到 1140。
| 基准 | Gemini 3.5 Flash-Lite | Gemini 3.1 Flash-Lite |
|---|---|---|
| Terminal-Bench 2.1 | 54% | 31% |
| GDM-MRCR v2(长上下文) | 72.2% | 60.1% |
| GDPVal-AA v2(Elo) | 1140 | 642 |
更有意思的,其实是向上对比。在若干代理式与编程评测中,3.5 Flash-Lite 现已直接超越更老更大的 Gemini 3 Flash——如 SWE-Bench Pro(54.2% vs. 49.6%)、OSWorld-Verified(74.0% vs. 65.1%)。若这在您的工作负载上也成立,就是一次无需质量让步的直接降本。
最后是 Cyber,多数读者大概永远无缘上手。它是在 3.5 Flash 基础上专门微调用于发现与修补安全漏洞,并部署在 Google 的 CodeMender 系统中,多个 Cyber 模型代理协作,最终给出一份合并报告。
Google 称其在广泛使用的网络安全基准 CyberGym 上与前沿规模模型具备竞争力,尽管模型体量更小——如果经得起检验,这或许是整个发布中更耐人寻味的效率故事。
访问权限仅通过 CodeMender 的试点项目向政府与受信任伙伴开放。未公布价格,也无普遍上市日期。
以下是基准结果摘要。文中也包含了定价信息——在做选择时这是关键因素之一。
| 基准 | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro | GPT-5.6 Luna | Grok 4.5 | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| 输入价格($/百万) | $1.50 | $1.50 | $2.00 | $1.00 | $2.00 | $3.00 |
| 输出价格($/百万) | $7.50 | $9.00 | $12.00 | $6.00 | $6.00 | $15.00 |
| SWE-Bench Pro | 58.7% | 55.1% | 54.2% | 62.7% | 64.7% | 63.2% |
| DeepSWE v1.1 | 49% | 37% | 12% | 67% | 54% | 54% |
| Terminal-Bench 2.1 | 78.0% | 76.2% | 73.8% | 84.7% | 83.3% | 80.4% |
| MLE-Bench | 63.9% | 49.7% | 42.6% | 47.6% | 43.2% | 66.9% |
| OSWorld-Verified | 83.0% | 78.4% | 76.2% | 72.6% | — | 81.2% |
| GDPVal-AA v2(Elo) | 1421 | 1349 | 965 | 1584 | 1535 | 1607 |
| CharXiv 推理(无工具) | 85.2% | 84.2% | 83.3% | 82.7% | 81.6% | 77.0% |
| GDM-MRCR v2,128k | 91.8% | 77.3% | 84.9% | 74.8% | 81.4% | 71.6% |
对外部对手而言,结果各擅胜场。GPT-5.6 Luna 与 Grok 4.5 在偏编程的基准——SWE-Bench Pro、DeepSWE——上领先;如果您的工作负载确实是“重编码”而非“贴近编码”,这差距就很实际。
Claude Sonnet 5 在知识型工作与 MLE-Bench 上领先。
3.6 Flash 真正取胜之处在长上下文检索与基于图表的推理,优势显著,同时其输出价格也低于清单上除 GPT-5.6 Luna 与 Grok 4.5 外的所有模型。
3.6 Flash 与 3.5 Flash-Lite 现已上线——Gemini API、Google AI Studio、Android Studio,以及针对 3.6 Flash 的Google Antigravity。企业客户可通过 Gemini Enterprise Agent Platform 使用二者,并在 Gemini Enterprise 应用中使用 3.6 Flash。面向消费者,二者已在 Gemini 应用中,且 Flash-Lite 已开始在 Google 搜索的 AI 模式中出现。
定价摘要如下:
3.6 Flash 随附 Google 所称的增强版“前沿安全”防护,聚焦 CBRN 与网络攻防滥用——本质上是“我们努力让越狱更难、同时不让模型变得难用”的标准表述。每家实验室都声称找到了平衡,但 X 上的评论往往另有说法。
Cyber 的受限发布,实质上是同一思路的另一种实践。与其为漏洞挖掘模型调安全参数后面向大众,不如干脆不做大众化发布。
3.5 Pro 仍在合作伙伴测试中,Google 表示将在准备就绪后开放普遍可用性。
更值得注意的是,Google 确认已开始预训练 Gemini 4,称其为迄今最雄心勃勃的预训练。想获取最新 AI 动态,请订阅我们的通讯 The Median,我们会及时推送此类重要模型发布的信息。
这三款模型都不是要称霸所有榜单——这大概也是明智之举。3.6 Flash 在编程评测上不及 GPT-5.6 Luna 与 Grok 4.5,在知识型工作上不及 Claude Sonnet 5,但换来的是相对前代真正的效率飞跃,以及在长上下文检索上的明显领先。
3.5 Flash-Lite 干脆不在质量上硬碰硬。它押注于:对大量代理式工作而言,质量超过某个阈值后,速度与成本更重要。这很可能是事实。但这种押注常常在智能体做出某个更聪明模型不会犯的错误之前,看起来都显得理所当然。
Cyber 根本不在榜单上。它是为一个任务而生的窄域工具,只向 Google 信任的用户开放——这与上文安全部分相比,同样能说明 Google 对漏洞发现风险的重视程度。
合在一起看,这更像是 Google 在为大规模代理式工作微调整个 Flash 阶梯,而将真正雄心勃勃的模型——3.5 Pro、Gemini 4——留待成熟时机。
与 DataCamp 一起学习
课程
课程
课程