
Curso
IA práctica con Google Gemini y NotebookLM
2 h
10K
Nota: Google ha anunciado recientemente Gemini 3.8 Flash y 3.8 Flash Cyber. Míralo en acción en nuestro tutorial del API de Gemini 3.8 Flash.
Google ha lanzado hoy tres modelos Gemini con la misma idea de fondo: hacer más con menos tokens:
3.6 Flash es la actualización generalista. Flash-Lite sacrifica calidad a cambio de velocidad y precio. Cyber es una herramienta de seguridad muy específica a la que la mayoría no tendrá acceso.
A continuación: qué hace realmente cada modelo, cómo se sostienen los benchmarks y dónde encaja Gemini 3.5 Pro en todo esto.
Cada uno se sitúa en un punto distinto de la curva coste-capacidad. Si vas a decidirte por los resultados de los benchmarks, salta más abajo; los encontrarás más adelante.
Gemini 3.6 Flash es la pieza central de este lanzamiento. Es el modelo al que Google quiere que recurras por defecto para programar, trabajar con conocimiento y cualquier tarea multimodal.
Según el Artificial Analysis Index, 3.6 Flash reduce el uso de tokens de salida un 17% frente a 3.5 Flash, y Google informa de reducciones de hasta el 65% en evaluaciones concretas como DeepSWE. Parte se debe a que el modelo es más inteligente y necesita decir menos. El resto viene de llegar a la conclusión en menos pasos de razonamiento y con menos llamadas a herramientas, que es otro tipo de ganancia y la más difícil de simular.
3.6 Flash admite texto, imagen, vídeo, audio y PDF como entrada, ofrece una ventana de contexto de 1 millón de tokens con un límite de salida de 64k. El uso del ordenador ya está integrado tanto en la API de Gemini como en Gemini Enterprise, junto con llamadas a funciones, salida estructurada y búsqueda como herramienta. (Aunque quizá esto ya no sea exclusivo de 3.6 Flash; a estas alturas casi todos los laboratorios punteros ofrecen alguna forma de computer use).
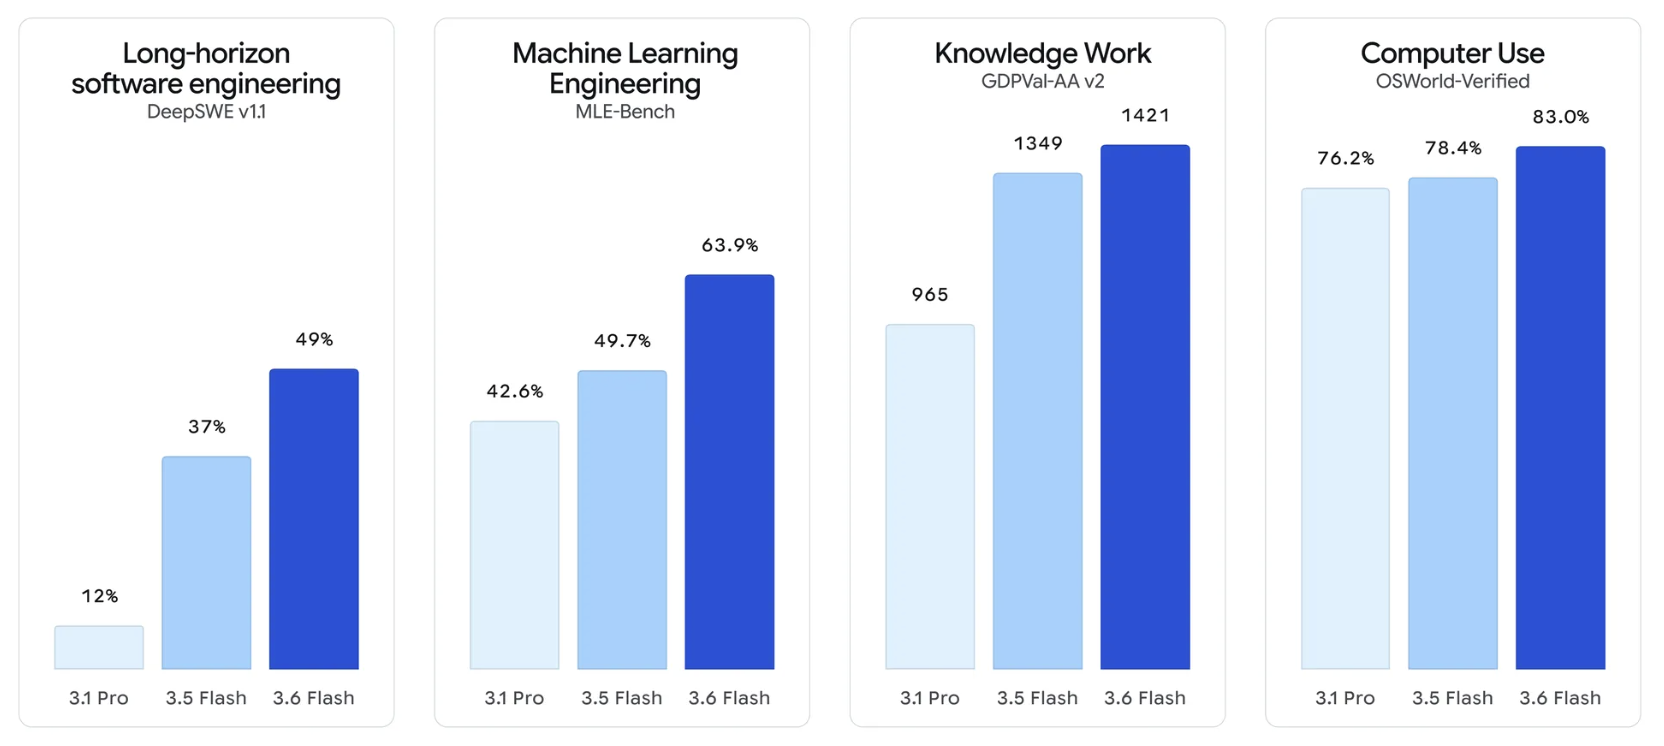
Frente a su predecesor, el salto es real casi en todo: DeepSWE casi se duplica, MLE-Bench sube del 49,7% al 63,9%, y el rendimiento en contexto largo en GDM-MRCR v2 mejora a doble dígito.
3.5 Flash-Lite no aspira a ser el más listo de la gama. Es el más rápido, con 350 tokens de salida por segundo, y el más barato, a $0.30 por millón de tokens de entrada y $2.50 por millón de tokens de salida.
Si tu carga de trabajo es de gran volumen y sensible a la latencia —p. ej., búsqueda agentiva, procesado masivo de documentos, o cualquier cosa que corra miles de veces al día—, la mejora de calidad que ofrecen otros modelos probablemente no compense lo que cuesta alcanzarla. Esa es la apuesta de Flash-Lite.
Las personas desarrolladoras pueden ajustar el nivel de razonamiento según la tarea: mínimo o bajo para ejecuciones baratas, rápidas y de alto volumen, o más alto para trabajo multi-paso con subagentes que realmente necesiten razonar.
La comparación con su propio predecesor, 3.1 Flash-Lite, ni se acerca: Terminal-Bench 2.1 pasa del 31% al 54%, GDM-MRCR v2 del 60,1% al 72,2%, y GDPVal-AA v2 de 642 a 1140.
| Benchmark | Gemini 3.5 Flash-Lite | Gemini 3.1 Flash-Lite |
|---|---|---|
| Terminal-Bench 2.1 | 54% | 31% |
| GDM-MRCR v2 (contexto largo) | 72.2% | 60.1% |
| GDPVal-AA v2 (Elo) | 1140 | 642 |
La comparación más interesante, sinceramente, es hacia arriba. En varias evaluaciones de agentes y de código, 3.5 Flash-Lite ahora supera al anterior y más grande Gemini 3 Flash —SWE-Bench Pro (54,2% vs. 49,6%), OSWorld-Verified (74,0% vs. 65,1%). Si esto se confirma en tu propia carga de trabajo, es una reducción de costes directa sin peaje de calidad.
Por último, está Cyber, que la mayoría de quienes leáis esto nunca llegaréis a probar. Es 3.5 Flash ajustado específicamente para encontrar y parchear vulnerabilidades de seguridad, desplegado dentro del sistema CodeMender de Google, donde varios agentes del modelo Cyber trabajan juntos y devuelven un único informe combinado.
Google afirma que compite con modelos de frontera en CyberGym, un benchmark de ciberseguridad muy utilizado, pese a su menor tamaño, lo cual —si se confirma— es quizá la historia de eficiencia más interesante de todo este lanzamiento.
El acceso está limitado a gobiernos y socios de confianza a través del programa piloto de CodeMender. Sin precios públicos ni fecha de lanzamiento general.
Aquí tienes un resumen de los resultados de los benchmarks. También incluyo la información de precios, que es clave a la hora de elegir.
| Benchmark | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro | GPT-5.6 Luna | Grok 4.5 | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| Precio de entrada ($/1M) | $1.50 | $1.50 | $2.00 | $1.00 | $2.00 | $3.00 |
| Precio de salida ($/1M) | $7.50 | $9.00 | $12.00 | $6.00 | $6.00 | $15.00 |
| SWE-Bench Pro | 58.7% | 55.1% | 54.2% | 62.7% | 64.7% | 63.2% |
| DeepSWE v1.1 | 49% | 37% | 12% | 67% | 54% | 54% |
| Terminal-Bench 2.1 | 78.0% | 76.2% | 73.8% | 84.7% | 83.3% | 80.4% |
| MLE-Bench | 63.9% | 49.7% | 42.6% | 47.6% | 43.2% | 66.9% |
| OSWorld-Verified | 83.0% | 78.4% | 76.2% | 72.6% | — | 81.2% |
| GDPVal-AA v2 (Elo) | 1421 | 1349 | 965 | 1584 | 1535 | 1607 |
| CharXiv Reasoning (sin herramientas) | 85.2% | 84.2% | 83.3% | 82.7% | 81.6% | 77.0% |
| GDM-MRCR v2, 128k | 91.8% | 77.3% | 84.9% | 74.8% | 81.4% | 71.6% |
Frente a la competencia externa, el veredicto está repartido. GPT-5.6 Luna y Grok 4.5 lideran en los benchmarks centrados en código —SWE-Bench Pro, DeepSWE—, y la brecha es real si tu carga de trabajo es realmente de programación y no solo cercana a ella.
Claude Sonnet 5 lidera en trabajo de conocimiento y en MLE-Bench.
Donde 3.6 Flash gana de verdad es en recuperación con contexto largo y razonamiento sobre gráficos, con una ventaja holgada, y además mejora el precio de salida frente a todos los modelos de la lista salvo GPT-5.6 Luna y Grok 4.5.
3.6 Flash y 3.5 Flash-Lite ya están disponibles —en la API de Gemini, Google AI Studio, Android Studio y, en el caso de 3.6 Flash, también en Google Antigravity. Los clientes Enterprise tienen ambos en la Gemini Enterprise Agent Platform, y 3.6 Flash también en la app Gemini Enterprise. En el lado de consumo, ambos están en la app de Gemini, y Flash-Lite empieza a aparecer en el modo IA de la Búsqueda de Google.
Precios, si has venido directo a por ellos:
3.6 Flash llega con lo que Google llama salvaguardas de Frontier Safety mejoradas en torno al uso indebido CBRN y a la ofensiva cibernética —la forma estándar de decir "hemos intentado dificultar los jailbreaks sin que el modelo resulte molesto de usar", un equilibrio que todos los laboratorios afirman haber logrado pero que los comentarios en X suelen desmentir.
El despliegue restringido de Cyber es, en el fondo, el mismo instinto aplicado de otra forma. En vez de afinar la seguridad de un modelo cazavulnerabilidades para su lanzamiento general, Google simplemente no lo ha lanzado de forma general.
3.5 Pro sigue en pruebas con socios, y Google afirma que estará disponible de forma general cuando esté listo.
Más importante aún, Google ha confirmado que ha iniciado el preentrenamiento de Gemini 4, calificándolo como su ejecución de preentrenamiento más ambiciosa hasta la fecha. Para mantenerte al día con las últimas noticias de IA, suscríbete a nuestra newsletter, The Median, y te informaremos de lanzamientos importantes como este.
Ninguno de estos tres modelos pretende encabezar todos los rankings, y probablemente sea lo correcto. 3.6 Flash cede terreno frente a GPT-5.6 Luna y Grok 4.5 en benchmarks de código, y frente a Claude Sonnet 5 en trabajo de conocimiento, a cambio de una mejora real de eficiencia sobre su predecesor y una clara ventaja en recuperación con contexto largo.
3.5 Flash-Lite ni siquiera intenta competir en calidad. Apuesta a que, para una gran parte de las cargas de trabajo agentivas, a partir de cierto nivel la calidad importa menos que la velocidad y el coste. Probablemente sea cierto. También es el tipo de apuesta que parece obviamente correcta hasta que un agente toma una mala decisión que un modelo más listo no habría tomado.
Cyber ni aparece en los rankings. Es una herramienta específica para una tarea concreta, con acceso limitado a quienes Google confía que la usarán responsablemente —lo cual dice tanto sobre cómo se toma Google el riesgo de descubrimiento de vulnerabilidades como cualquier cosa de la sección de seguridad anterior.
En conjunto, esto suena menos a tres lanzamientos separados y más a que Google está afinando toda la gama Flash para cargas de trabajo agentivas a escala, mientras reserva los modelos realmente ambiciosos —3.5 Pro, Gemini 4— para cuando estén listos.
Aprende con DataCamp
Curso
Curso
Curso
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Dimitri Didmanidze
9 min






