
Kursus
AI Praktis dengan Google Gemini dan NotebookLM
2 jam
10.1K
Catatan: Baru-baru ini Google mengumumkan Gemini 3.8 Flash dan 3.8 Flash Cyber. Lihat demonya dalam tutorial API Gemini 3.8 Flash kami.
Google merilis tiga model Gemini hari ini dengan tujuan yang sama: melakukan lebih banyak dengan lebih sedikit token:
3.6 Flash adalah peningkatan serbaguna. Flash-Lite menukar kualitas dengan kecepatan dan harga. Cyber adalah alat keamanan khusus yang sebagian besar orang tidak akan dapat akses.
Di bawah ini: apa yang sebenarnya dilakukan setiap model, bagaimana tolok ukur bertahan, dan di mana posisi Gemini 3.5 Pro dalam semua ini.
Masing-masing berada pada titik berbeda pada kurva biaya vs. kapabilitas. Jika Anda memilih berdasarkan hasil tolok ukur, lewati ke bawah; tolok ukurnya ada lebih jauh di bawah.
Gemini 3.6 Flash adalah pusat dari rilis ini. Ini adalah model yang diinginkan Google sebagai default Anda untuk pengkodean, pekerjaan pengetahuan, dan apa pun yang multimodal.
Menurut Artificial Analysis Index, 3.6 Flash memangkas penggunaan token output sebesar 17% dibanding 3.5 Flash, dan Google melaporkan pengurangan hingga 65% pada evaluasi individual seperti DeepSWE. Sebagian karena model yang lebih cerdas berbicara lebih singkat. Sisanya berasal dari mencapai kesimpulan dalam lebih sedikit langkah penalaran dan panggilan alat, yang merupakan jenis peningkatan berbeda dan lebih sulit dipalsukan.
3.6 Flash menerima input teks, gambar, video, audio, dan PDF, menjalankan jendela konteks 1 juta token dengan batas output 64k. Penggunaan komputer kini terpasang di Gemini API dan Gemini Enterprise, bersama dengan pemanggilan fungsi, output terstruktur, dan pencarian-sebagai-alat. (Meskipun ini mungkin bukan lagi kekhasan 3.6 Flash; sebagian besar laboratorium frontier kini telah meluncurkan beberapa versi penggunaan komputer.)
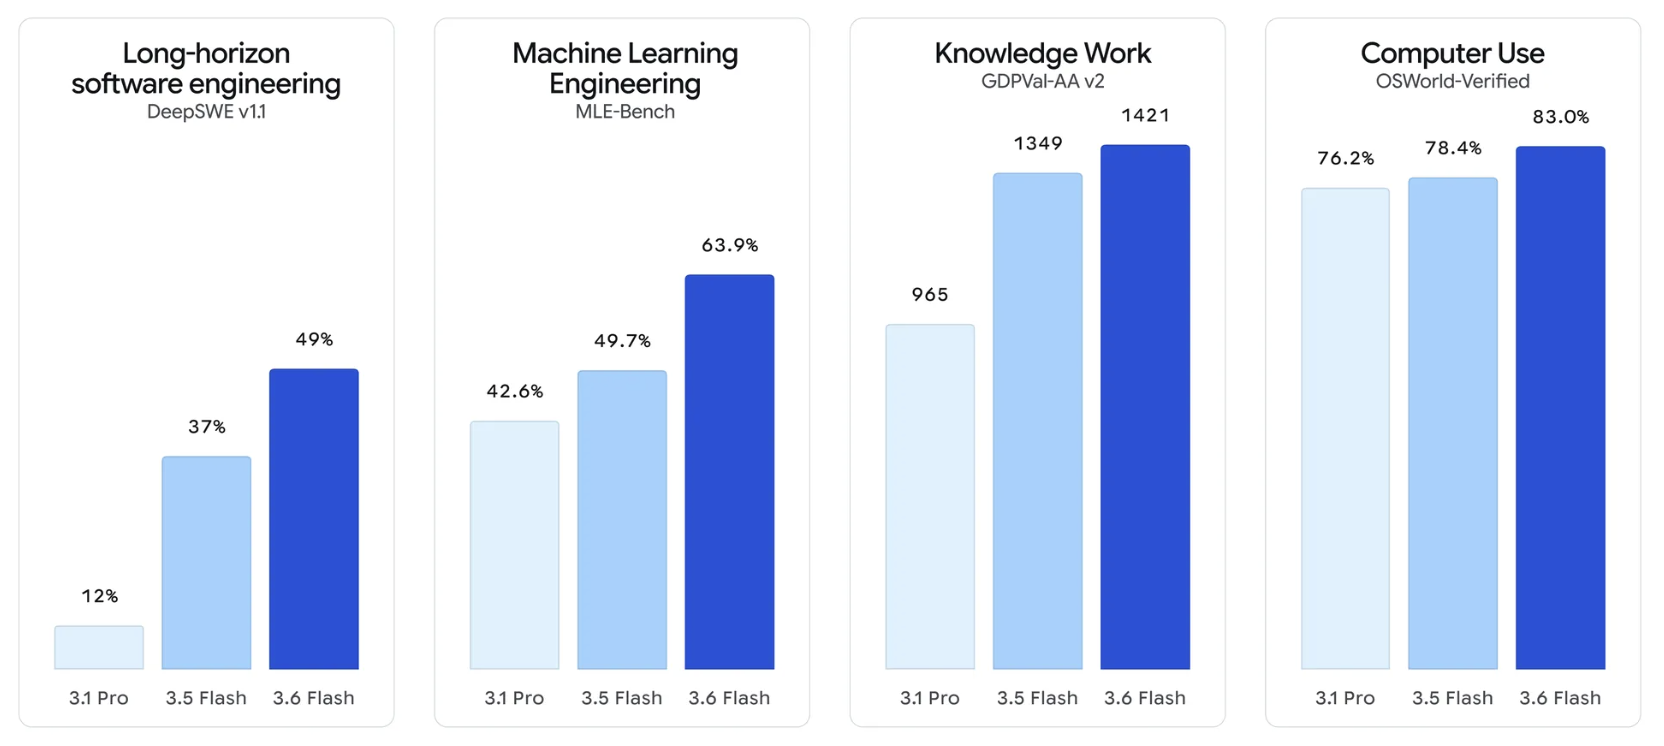
Dibandingkan pendahulunya sendiri, lonjakannya nyata hampir di semua tempat: DeepSWE hampir dua kali lipat, MLE-Bench naik dari 49,7% ke 63,9%, performa konteks panjang pada GDM-MRCR v2 meningkat dua digit.
3.5 Flash-Lite tidak berusaha menjadi model terpintar dalam jajaran. Ini yang tercepat, pada 350 token output per detik, dan termurah, sebesar $0,30 per satu juta token input dan $2,50 per satu juta token output.
Jika beban kerja Anda ber-volume tinggi dan sensitif terhadap latensi — bayangkan pencarian agen, pemrosesan dokumen massal, apa pun yang berjalan ribuan kali sehari — kesenjangan kualitas yang ditawarkan model lain mungkin tidak sepadan dengan biayanya untuk menutup celah itu. Itulah pertaruhan yang diambil Flash-Lite.
Pengembang dapat menaikkan atau menurunkan tingkat pemikiran sesuai tugas: minimal atau rendah untuk eksekusi murah, cepat, dan ber-volume tinggi, atau lebih tinggi untuk pekerjaan subagen multi-langkah yang benar-benar perlu bernalar.
Perbandingan dengan pendahulunya sendiri, 3.1 Flash-Lite, tidak dekat: Terminal-Bench 2.1 naik dari 31% ke 54%, GDM-MRCR v2 dari 60,1% ke 72,2%, GDPVal-AA v2 dari 642 ke 1140.
| Tolok ukur | Gemini 3.5 Flash-Lite | Gemini 3.1 Flash-Lite |
|---|---|---|
| Terminal-Bench 2.1 | 54% | 31% |
| GDM-MRCR v2 (konteks panjang) | 72,2% | 60,1% |
| GDPVal-AA v2 (Elo) | 1140 | 642 |
Perbandingan yang lebih menarik, jujur saja, adalah ke atas. Pada beberapa evaluasi agen dan pengkodean, 3.5 Flash-Lite kini mengungguli Gemini 3 Flash yang lebih lama dan lebih besar — SWE-Bench Pro (54,2% vs. 49,6%), OSWorld-Verified (74,0% vs. 65,1%). Jika itu bertahan pada beban kerja Anda sendiri, ini adalah pemangkasan biaya langsung tanpa pajak kualitas.
Terakhir, ada Cyber, yang kebanyakan pembaca tidak akan pernah bisa coba. Ini adalah 3.5 Flash yang di-fine-tune khusus untuk menemukan dan menambal kerentanan keamanan, digunakan dalam sistem CodeMender Google, di mana beberapa agen model Cyber bekerja bersama dan menyerahkan satu laporan gabungan.
Google mengatakan model ini kompetitif dengan model berskala frontier pada CyberGym, tolok ukur keamanan siber yang banyak digunakan, meskipun jejaknya lebih kecil — yang, jika terbukti, bisa dibilang merupakan kisah efisiensi paling menarik di seluruh rilis ini.
Akses dibatasi untuk pemerintah dan mitra tepercaya melalui program percontohan CodeMender. Tidak ada harga publik, tidak ada tanggal rilis umum.
Berikut ringkasan hasil tolok ukur. Saya sertakan juga informasi harga, yang merupakan bagian penting saat memilih.
| Tolok ukur | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro | GPT-5.6 Luna | Grok 4.5 | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| Harga input ($/1M) | $1,50 | $1,50 | $2,00 | $1,00 | $2,00 | $3,00 |
| Harga output ($/1M) | $7,50 | $9,00 | $12,00 | $6,00 | $6,00 | $15,00 |
| SWE-Bench Pro | 58,7% | 55,1% | 54,2% | 62,7% | 64,7% | 63,2% |
| DeepSWE v1.1 | 49% | 37% | 12% | 67% | 54% | 54% |
| Terminal-Bench 2.1 | 78,0% | 76,2% | 73,8% | 84,7% | 83,3% | 80,4% |
| MLE-Bench | 63,9% | 49,7% | 42,6% | 47,6% | 43,2% | 66,9% |
| OSWorld-Verified | 83,0% | 78,4% | 76,2% | 72,6% | — | 81,2% |
| GDPVal-AA v2 (Elo) | 1421 | 1349 | 965 | 1584 | 1535 | 1607 |
| CharXiv Reasoning (tanpa alat) | 85,2% | 84,2% | 83,3% | 82,7% | 81,6% | 77,0% |
| GDM-MRCR v2, 128k | 91,8% | 77,3% | 84,9% | 74,8% | 81,4% | 71,6% |
Dibanding pesaing luar, hasilnya campuran. GPT-5.6 Luna dan Grok 4.5 unggul pada tolok ukur yang berat di pengkodean — SWE-Bench Pro, DeepSWE — dan itu adalah kesenjangan nyata jika beban kerja Anda benar-benar berat di pengkodean alih-alih sekadar terkait pengkodean.
Claude Sonnet 5 memimpin pada pekerjaan pengetahuan dan MLE-Bench.
Kemenangan 3.6 Flash sebenarnya ada pada pengambilan konteks panjang dan penalaran berbasis grafik, dengan margin yang cukup lebar, dan model ini menekan harga output dibanding semua model di daftar itu kecuali GPT-5.6 Luna dan Grok 4.5.
3.6 Flash dan 3.5 Flash-Lite sudah aktif — Gemini API, Google AI Studio, Android Studio, dan khusus untuk 3.6 Flash, Google Antigravity juga. Pelanggan enterprise mendapatkan keduanya melalui Gemini Enterprise Agent Platform, dengan 3.6 Flash juga ada di aplikasi Gemini Enterprise. Di sisi konsumen, keduanya ada di aplikasi Gemini, dan Flash-Lite mulai muncul di Mode AI Google Search.
Harga, jika Anda langsung ke bagian ini:
3.6 Flash hadir dengan apa yang disebut Google sebagai perlindungan Frontier Safety yang ditingkatkan seputar penyalahgunaan CBRN dan serangan siber — bahasa standar untuk "kami berusaha membuat jailbreak lebih sulit tanpa membuat model menyebalkan untuk digunakan," keseimbangan yang diklaim setiap lab tetapi komentar di X sering menceritakan hal berbeda.
Peluncuran terbatas Cyber pada dasarnya adalah naluri yang sama diterapkan secara berbeda. Alih-alih mencoba menyesuaikan keamanan model pemburu kerentanan untuk rilis umum, Google memilih untuk tidak merilisnya secara umum.
3.5 Pro masih dalam pengujian mitra, dengan Google menyatakan ketersediaan umum akan hadir begitu siap.
Yang lebih penting, Google mengonfirmasi telah memulai pretraining Gemini 4, menyebutnya sebagai pretraining paling ambisius sejauh ini. Untuk tetap mendapat kabar terbaru AI, langganilah buletin kami, The Median, dan kami akan terus memberi tahu Anda tentang rilis model penting seperti ini.
Tak satu pun dari tiga model ini mencoba memuncaki semua papan peringkat, dan itu mungkin keputusan yang tepat. 3.6 Flash mengalah pada tolok ukur pengkodean terhadap GPT-5.6 Luna dan Grok 4.5, serta pada pekerjaan pengetahuan terhadap Claude Sonnet 5, sebagai imbalan atas lompatan efisiensi nyata dibanding pendahulunya sendiri dan keunggulan jelas pada pengambilan konteks panjang.
3.5 Flash-Lite bahkan tidak mencoba bersaing dalam kualitas. Model ini bertaruh bahwa untuk porsi besar beban kerja agen, kualitas di atas titik tertentu menjadi kurang penting dibanding kecepatan dan biaya. Itu mungkin benar. Ini juga jenis pertaruhan yang tampak jelas benar sampai suatu agen membuat keputusan salah yang tidak akan dibuat oleh model yang lebih cerdas.
Cyber sama sekali tidak ada di papan peringkat. Ini adalah alat sempit untuk satu pekerjaan, dibatasi bagi pihak yang dipercaya Google untuk menggunakannya secara bertanggung jawab — yang sama bicaranya tentang betapa seriusnya Google menangani risiko penemuan kerentanan seperti apa pun yang ada di bagian keamanan di atas.
Jika digabungkan, ini terasa kurang seperti tiga peluncuran terpisah dan lebih seperti Google menyetel seluruh tier Flash untuk beban kerja agen dalam skala besar, sementara model yang benar-benar ambisius — 3.5 Pro, Gemini 4 — disimpan untuk saat siap diluncurkan.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



