
Kurs
ChatGPT verstehen
1 Std.
434.8K
Stability AI hat eine frühe Vorschau auf Stable Diffusion 3, sein generatives Text-zu-Bild-KI-Modell, angekündigt. Anders als bei OpenAIs Sora-Ankündigung zur Text-zu-Video-KI in der vergangenen Woche gab es nur wenige Demos der neuen Funktionen, aber einige Details wurden veröffentlicht. Hier schauen wir uns an, was die Ankündigung bedeutet, wie das neue Modell funktioniert und welche Auswirkungen es auf die Weiterentwicklung der Bildgenerierung haben könnte.
Stable Diffusion ist eine Reihe generativer Text-zu-Bild-KI-Modelle. Du gibst also eine Prompt-Beschreibung ein, und das Modell erzeugt ein Bild, das dazu passt. Für den einfachen Zugang zur KI gibt es eine Weboberfläche.
Ein großer Unterschied zum konkurrierenden DALL·E von OpenAI ist, dass Stable Diffusion „open weights“ hat. Das heißt, die Details des neuronalen Netzes, das die Berechnungen des Modells liefert, sind öffentlich zugänglich. Das sorgt für mehr Transparenz darüber, wie das Modell funktioniert, und ermöglicht es Forschenden, die Arbeit von Stability AI anzupassen und darauf aufzubauen.
Stable Diffusion 3 ist nicht ein einzelnes Modell, sondern eine ganze Modellfamilie mit Größen von 800 Millionen bis 8 Milliarden Parametern. Mehr Parameter liefern in der Regel eine höhere Ausgabequalität, führen aber auch dazu, dass Bilder teurer sind und länger dauern. Varianten mit weniger Parametern eignen sich gut für einfache Bilder, Versionen mit mehr Parametern sind besser für hochwertige oder komplexe Motive.
Stable Diffusion 3 nutzt eine Diffusion-Transformer-Architektur, ähnlich wie Sora. Frühere Versionen von Stable Diffusion—und die meisten heutigen Bildgeneratoren—setzen auf reine Diffusionsmodelle. Große Sprachmodelle für Textgenerierung wie GPT verwenden eine Transformer-Architektur. Die Kombination beider Ansätze ist eine neuere Innovation und verspricht, die Stärken beider Welten zu vereinen.
Diffusionsmodelle sind gut darin, feine Details in kleinen Bildbereichen zu erzeugen, haben aber Schwächen beim Gesamt-Layout eines Bildes. Transformer sind wiederum stark im Layout, aber schwächer bei Details. Es ist daher wahrscheinlich, dass Stable Diffusion einen Transformer für die Grobkomposition nutzt und Diffuser für die Detail-Patches.
Damit ist zu erwarten, dass Stable Diffusion 3 komplexe Szenen besser organisiert als seine Vorgänger.
In der Ankündigung wird außerdem erwähnt, dass Stable Diffusion 3 eine Technik namens Flow Matching verwendet. Das ist eine recheneffizientere Methode, Modelle zu trainieren und daraus Bilder zu erzeugen, als der gängige Diffusionspfad. Das bedeutet: Die KI ist günstiger zu entwickeln, und auch die Bildgenerierung wird kostengünstiger—insgesamt sinken also die Nutzungskosten.
Eine aktuelle Schwäche vieler Bildgeneratoren ist das zuverlässige Erzeugen von Text im Bild. Auffällig: Die Ankündigung von Stability AI startete mit einem Bild, das den Modellnamen „Stable Diffusion 3“ enthielt. Die Positionierung der Buchstaben ist gut, aber nicht perfekt: Der Abstand zwischen „B“ und „L“ in Stable ist größer als zwischen „L“ und „E“. Ebenso stehen die beiden „F“ in Diffusion zu dicht beieinander. Insgesamt ist es jedoch eine deutliche Verbesserung gegenüber der vorherigen Generation.
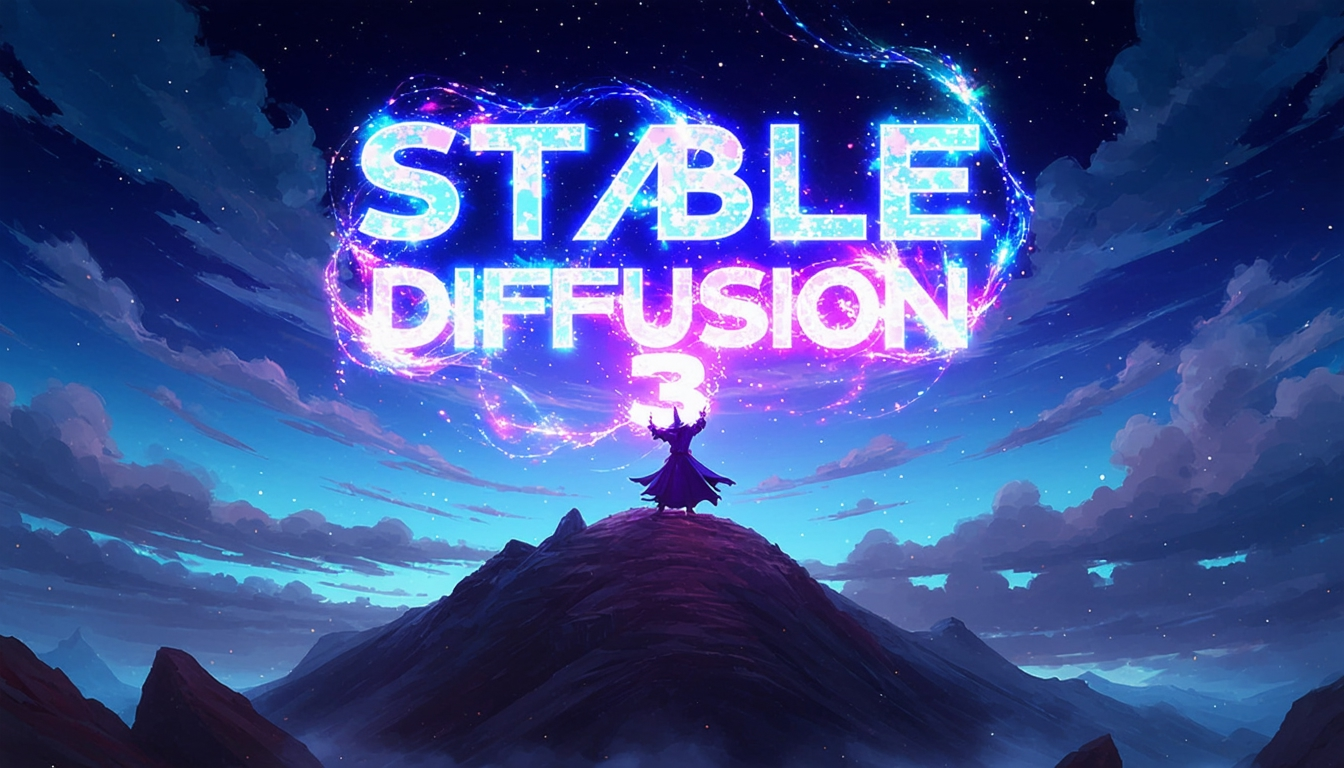
Prompt: Episches Anime-Artwork eines Zauberers auf einem Berg in der Nacht, der einen kosmischen Zauber in den dunklen Himmel wirkt, der „Stable Diffusion 3“ aus farbiger Energie schreibt
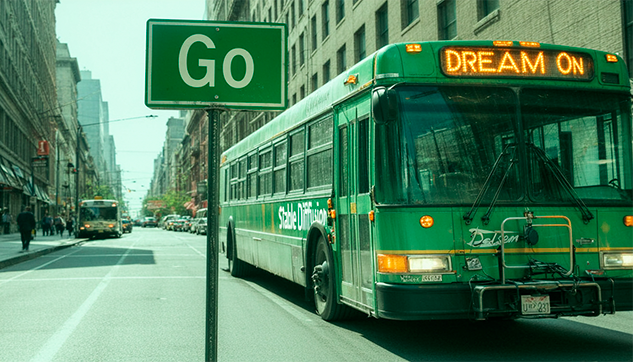
Ein weiteres Problem entsteht dadurch, dass Diffuser Bildbereiche separat erzeugen und dadurch Inkonsistenzen zwischen Regionen auftreten können. Das fällt vor allem bei realistischen Motiven ins Gewicht. In der Ankündigung gab es nur wenige realistische Beispiele, doch ein Bild eines Busses in einer Stadtstraße zeigt einige dieser Punkte: Der Schatten unter dem Bus deutet auf Licht von hinten hin, während der Schatten eines Gebäudes auf der Straße Licht von links nahelegt. Auch die Anordnung der Fenster im Gebäude oben rechts ist in verschiedenen Bereichen leicht uneinheitlich. Außerdem hat der Bus keinen Fahrer—das ließe sich allerdings vermutlich mit einem präziseren Prompt beheben.
Stable Diffusion 3 befindet sich in einer „Early-Preview“-Phase. Das bedeutet, es ist derzeit nur für Forschende zu Testzwecken verfügbar. Diese Vorschauphase soll Stability AI helfen, Feedback zur Leistungsfähigkeit und Sicherheit des Modells zu sammeln, bevor es öffentlich freigegeben wird.
Du kannst dich hier auf die Warteliste setzen lassen.
Bildgeneratoren werden heute vielfältig genutzt—von Illustrationen über Grafikdesign bis hin zu Marketingmaterialien. Stable Diffusion dürfte sich in all diesen Bereichen einsetzen lassen—mit dem zusätzlichen Vorteil, wahrscheinlich komplexere Layouts besser zu erzeugen.
Der Datensatz, auf dem Stable Diffusion trainiert wurde, enthielt auch urheberrechtlich geschützte Bilder, was zu mehreren noch offenen Klagen geführt hat. Unklar ist, wie diese Verfahren ausgehen. Theoretisch ist es möglich, dass auch mit Stable Diffusion erzeugte Bilder als Urheberrechtsverletzung eingestuft werden.
Die vollständigen technischen Details zu Stable Diffusion 3 sind noch nicht veröffentlicht, insbesondere gibt es noch keine Möglichkeit, die Leistung der KI umfassend zu testen. Sobald das Modell öffentlich verfügbar ist und Benchmarks vorliegen, wird sich einschätzen lassen, wie groß der Fortschritt gegenüber früheren Modellen ist. Auch Faktoren wie Zeit- und Kostenaufwand pro Bild werden dann klarer.
Eine technische Neuerung, die OpenAI in seinem DALL·E-3-Paper stark hervorgehoben hat, die in der Ankündigung von Stability AI jedoch nicht erwähnt wurde, ist „Recaptioning“. Dabei handelt es sich um eine Form des automatischen Prompt-Engineerings: Der vom Menschen geschriebene Text wird umstrukturiert und mit zusätzlichen Details versehen, um dem Modell klarere Anweisungen zu geben. Ob Stable Diffusion 3 diese Technik nutzt, ist unbekannt.
Stable Diffusion 3 verspricht den nächsten Schritt in der Entwicklung generativer Text-zu-Bild-KI. Sobald die KI öffentlich verfügbar ist, können wir sie umfassender testen und neue Einsatzszenarien entdecken. Wenn du in die Welt der generativen KI einsteigen möchtest, bringt dich unser AI Fundamentals Skill Track auf Tempo—mit Machine Learning, Deep Learning, NLP, generativen Modellen und mehr.
Weitere Ressourcen zu aktuellen KI-Themen findest du hier:
Starte noch heute mit deiner KI-Reise!
Kurs
Lernpfad
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
9 Min.




