
{count, plural, one {कोर्स} other {कोर्स}}
ChatGPT को समझना
{hours} घंटा
436.8K
Stability AI ने अपने टेक्स्ट-टू-इमेज जनरेटिव AI मॉडल Stable Diffusion 3 का प्रारंभिक प्रीव्यू जारी किया है। OpenAI की पिछले सप्ताह की Sora टेक्स्ट-टू-वीडियो घोषणा के विपरीत, नए फीचर्स के सीमित डेमो दिखाए गए, लेकिन कुछ विवरण साझा किए गए। यहां, हम देखते हैं कि इस घोषणा का क्या मतलब है, नया मॉडल कैसे काम करता है, और इमेज जेनरेशन की प्रगति पर इसके क्या प्रभाव हो सकते हैं।
Stable Diffusion टेक्स्ट-टू-इमेज जनरेटिव AI मॉडलों की एक श्रृंखला है। यानी, आप जो देखना चाहते हैं उसका वर्णन करते हुए एक प्रॉम्प्ट लिखते हैं, और मॉडल आपके विवरण से मेल खाती हुई एक छवि बनाता है। AI तक आसान पहुंच के लिए एक वेब यूज़र इंटरफेस उपलब्ध है।
OpenAI के प्रतिद्वंद्वी DALL·E इमेज जेनरेशन AI से एक बड़ा अंतर यह है कि इसके पास "ओपन वेट्स" हैं। यानी, मॉडल की गणनाएँ करने वाले न्यूरल नेटवर्क का विवरण सार्वजनिक रूप से उपलब्ध है। इसका मतलब है कि मॉडल कैसे काम करता है, इसमें कुछ पारदर्शिता है, और शोधकर्ता Stability AI के कार्य को अनुकूलित कर सकते हैं और उस पर आगे निर्माण कर सकते हैं।
Stable Diffusion 3 एक मॉडल नहीं, बल्कि मॉडलों का एक पूरा परिवार है, जिनका आकार 800 मिलियन पैरामीटर्स से लेकर 8 बिलियन पैरामीटर्स तक है। अधिक पैरामीटर्स आमतौर पर उच्च गुणवत्ता का आउटपुट देते हैं, लेकिन साथ ही छवियों को बनाना अधिक महंगा और समयसाध्य हो जाता है। कम पैरामीटर्स वाले संस्करण सरल छवियां बनाने के लिए बेहतर होते हैं, जबकि अधिक पैरामीटर्स वाले संस्करण उच्च गुणवत्ता या अधिक जटिल छवियां बनाने के लिए उपयुक्त होते हैं।
Stable Diffusion 3 एक डिफ्यूजन ट्रांसफॉर्मर आर्किटेक्चर का उपयोग करता है, जो Sora में उपयोग किए गए आर्किटेक्चर के समान है। Stable Diffusion के पिछले संस्करण—और अधिकांश वर्तमान इमेज जेनरेशन AI—डिफ्यूजन मॉडल उपयोग करते हैं। टेक्स्ट जेनरेशन के बड़े भाषा मॉडल, जैसे GPT, ट्रांसफॉर्मर आर्किटेक्चर का उपयोग करते हैं। इन दोनों मॉडलों को संयोजित करने में हालिया प्रगति हुई है और इससे दोनों आर्किटेक्चर्स के सर्वश्रेष्ठ गुणों का लाभ उठाने की उम्मीद है।
डिफ्यूजन मॉडल छोटे क्षेत्रों में विवरण बनाने में अच्छे होते हैं, लेकिन पूरी छवि के लेआउट को जनरेट करने में कमजोर। इसके विपरीत, ट्रांसफॉर्मर लेआउट में अच्छे होते हैं, लेकिन सूक्ष्म विवरण बनाने में कमज़ोर। इसलिए संभव है कि Stable Diffusion पहले ट्रांसफॉर्मर से समग्र चित्र का लेआउट बनाए और फिर डिफ्यूज़र्स से पैच जनरेट करे।
इसका मतलब है कि जटिल दृश्यों के संगठन में Stable Diffusion 3 अपने पूर्ववर्तियों से बेहतर प्रदर्शन करने की उम्मीद है।
घोषणा में यह भी बताया गया है कि Stable Diffusion 3 फ़्लो मैचिंग नामक तकनीक का उपयोग करता है। यह मौजूदा डिफ्यूजन पाथ तकनीक की तुलना में मॉडलों को प्रशिक्षित करने और उनसे छवियां बनाने का अधिक संगणनात्मक रूप से कुशल तरीका है। यानी, AI को बनाना सस्ता पड़ता है, और AI से बनाई गई छवियां भी सस्ती बनती हैं, जिससे समग्र लागत कम होती है।
इमेज जेनरेशन AI की एक मौजूदा सीमा टेक्स्ट जनरेट करने की क्षमता है। गौरतलब है कि Stability AI की घोषणा एक ऐसी छवि से शुरू हुई जिसमें मॉडल का नाम "Stable Diffusion 3" शामिल था। टेक्स्ट में अक्षरों की स्थिति अच्छी है लेकिन परिपूर्ण नहीं: देखें कि Stable में "B" और "L" के बीच की दूरी "L" और "E" के बीच की दूरी से अधिक है। इसी तरह, Diffusion में दो "F" एक-दूसरे के बहुत क़रीब हैं। हालांकि, कुल मिलाकर, यह पिछले पीढ़ी के मॉडलों की तुलना में एक उल्लेखनीय सुधार है।
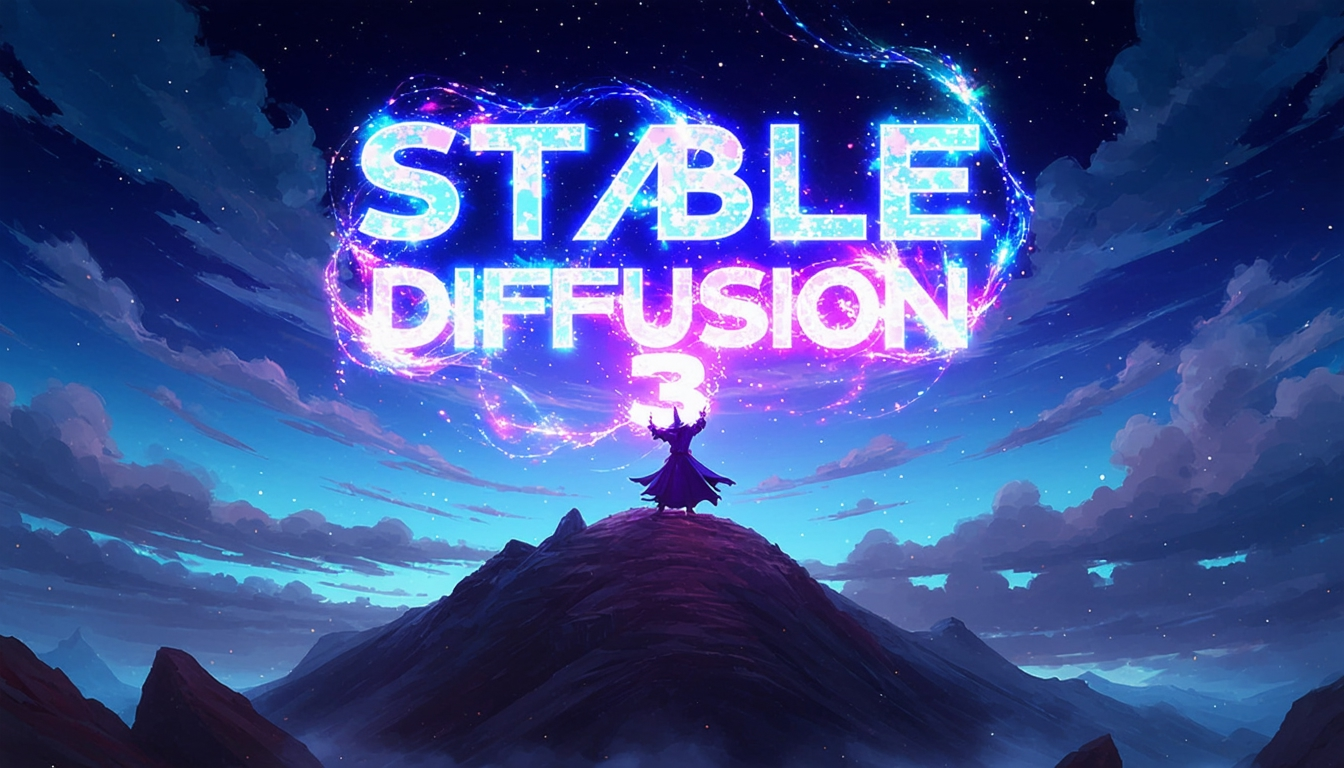
प्रॉम्प्ट: रात में पहाड़ की चोटी पर एक जादूगर का महाकाव्य एनीमे आर्टवर्क, जो काले आकाश में "Stable Diffusion 3" लिखता हुआ एक ब्रह्मांडीय जादू बिखेर रहा है, जो रंग-बिरंगी ऊर्जा से बना है
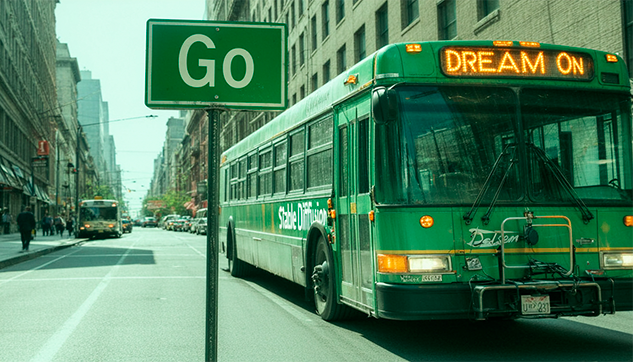
मॉडलों की एक और समस्या यह है कि डिफ्यूज़र्स छवि के पैच अलग-अलग जनरेट करते हैं, जिससे छवि के अलग-अलग क्षेत्रों में असंगतियाँ हो सकती हैं। यह समस्या मुख्यतः यथार्थपरक छवियां बनाते समय आती है। घोषणा पोस्ट में बहुत से यथार्थपरक उदाहरण शामिल नहीं थे, लेकिन शहर की सड़क पर एक बस की छवि में ऐसी कुछ समस्याएं दिखती हैं। ध्यान दें कि बस के नीचे की छाया से लगता है कि प्रकाश बस के पीछे से आ रहा है, लेकिन सड़क पर इमारत की छाया संकेत देती है कि प्रकाश छवि के बाएँ हिस्से से आ रहा है। इसी तरह, छवि के ऊपर दाएँ कोने में इमारत की खिड़कियों की स्थिति इमारत के अलग-अलग हिस्सों में थोड़ी असंगत है। बस में चालक भी नहीं है, हालांकि इसे अधिक सावधानी से प्रॉम्प्टिंग करके सुधारा जा सकता है।
Stable Diffusion 3 "अर्ली प्रीव्यू" अवस्था में है। यानी यह फिलहाल सिर्फ़ शोधकर्ताओं के लिए परीक्षण उद्देश्यों से उपलब्ध है। प्रीव्यू अवस्था का उद्देश्य यह है कि Stability AI सार्वजनिक रिलीज़ से पहले मॉडल के प्रदर्शन और सुरक्षा पर फ़ीडबैक एकत्र कर सके।
आप AI तक पहुंच के लिए वेटिंग लिस्ट में यहाँ शामिल हो सकते हैं।
इमेज जेनरेशन AI पहले से ही चित्रण, ग्राफिक डिज़ाइन और मार्केटिंग सामग्री तक कई उपयोग मामलों में काम आ रहे हैं। Stable Diffusion भी इन्हीं तरीकों से उपयोगी होने का वादा करता है, साथ ही यह संभवतः अधिक जटिल लेआउट वाली छवियां बनाने में भी सक्षम होगा।
Stable Diffusion को जिस डेटा सेट पर प्रशिक्षित किया गया, उसमें कुछ कॉपीराइट वाली छवियां शामिल थीं, जिसके परिणामस्वरूप कई अब तक अनसुलझे मुकदमे दायर हुए हैं। इन मुकदमों का नतीजा क्या होगा, यह स्पष्ट नहीं है, लेकिन सैद्धांतिक रूप से संभव है कि Stable Diffusion से बनाई गई किसी भी छवि को भी कॉपीराइट उल्लंघन माना जाए।
Stable Diffusion 3 के पूरे तकनीकी विवरण अभी जारी नहीं किए गए हैं, और विशेष रूप से, AI के प्रदर्शन का परीक्षण करने का कोई तरीका नहीं है। एक बार मॉडल सार्वजनिक रूप से उपलब्ध हो जाए और बेंचमार्क स्थापित हो जाएँ, तब यह निर्धारित करना संभव होगा कि यह AI पिछले मॉडलों की तुलना में कितना बेहतर है। अन्य कारक जैसे किसी छवि को जनरेट करने में लगने वाला समय और लागत भी स्पष्ट हो जाएगी।
एक तकनीकी विकास जिसे OpenAI ने अपने DALL·E 3 पेपर में ज़ोर देकर पेश किया था, लेकिन Stability AI की घोषणा में जिसका उल्लेख नहीं था, वह है रिकैप्शनिंग। यह स्वचालित प्रॉम्प्ट इंजीनियरिंग का एक रूप है, जिसमें उपयोगकर्ता द्वारा लिखा गया टेक्स्ट पुनर्संरचित कर अधिक विवरण जोड़ा जाता है ताकि मॉडल को स्पष्ट निर्देश मिलें। यह अज्ञात है कि Stable Diffusion 3 इस तकनीक का उपयोग करता है या नहीं।
Stable Diffusion 3 टेक्स्ट-टू-इमेज जनरेटिव AI की प्रगति में एक और कदम साबित होने का वादा करता है। एक बार यह AI सार्वजनिक रूप से जारी हो जाए, तो हम इसे और बेहतर परख सकेंगे और नए उपयोग मामलों की खोज करेंगे। यदि आप जनरेटिव AI की दुनिया में शुरुआत करने के इच्छुक हैं, तो हमारा AI Fundamentals स्किल ट्रैक आपको मशीन लर्निंग, डीप लर्निंग, NLP, जनरेटिव मॉडल्स, और बहुत कुछ के साथ तेज़ी से गति पकड़ने में मदद करेगा।
AI जगत की नवीनतम जानकारी के और संसाधनों के लिए नीचे दी गई सूची देखें:
आज ही अपनी AI यात्रा शुरू करें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}