
Cours
Comprendre ChatGPT
1 h
434.8K
Stability AI a annoncé un aperçu préliminaire de Stable Diffusion 3, son modèle d'IA générative texte‑vers‑image. Contrairement à l'annonce Sora texte‑vers‑vidéo d'OpenAI la semaine dernière, les démonstrations des nouvelles capacités du modèle ont été limitées, mais quelques informations ont été partagées. Nous examinons ici la portée de cette annonce, le fonctionnement du nouveau modèle et ce qu'elle implique pour l'essor de la génération d'images.
Stable Diffusion est une série de modèles d'IA générative texte‑vers‑image. Autrement dit, vous rédigez un prompt décrivant ce que vous souhaitez voir et le modèle crée une image conforme à votre description. Une interface web permet d'y accéder facilement.
Une grande différence par rapport à DALL·E d'OpenAI, l'IA concurrente de génération d'images, est que ses « poids ouverts » sont disponibles. Autrement dit, les détails du réseau de neurones qui réalise les calculs du modèle sont publics. Cela apporte de la transparence sur le fonctionnement du modèle et permet aux chercheurs d'adapter et de prolonger le travail de Stability AI.
Stable Diffusion 3 n'est pas un modèle unique, mais une famille complète de modèles, dont la taille varie de 800 millions à 8 milliards de paramètres. Plus il y a de paramètres, plus la qualité de sortie est élevée, au prix d'images plus coûteuses et plus longues à générer. Les versions avec moins de paramètres conviennent mieux à des images simples, tandis que celles avec davantage de paramètres sont plus adaptées à des images de meilleure qualité ou plus complexes.
Stable Diffusion 3 s'appuie sur une architecture de « diffusion transformer », similaire à celle utilisée par Sora. Les versions précédentes de Stable Diffusion — et la majorité des IA de génération d'images actuelles — reposent sur un modèle de diffusion. Les grands modèles de langage pour la génération de texte, comme GPT, utilisent une architecture de transformeur. La capacité à combiner ces deux approches est récente et promet de tirer parti des atouts de chacune.
Les modèles de diffusion excellent pour créer des détails à petite échelle mais peinent à générer la mise en page globale d'une image. À l'inverse, les transformeurs sont efficaces pour la structure d'ensemble mais moins pour le détail. Il est donc probable que Stable Diffusion utilise un transformeur pour organiser la scène globale puis des diffuseurs pour générer les zones locales.
On peut donc s'attendre à ce que Stable Diffusion 3 s'en sorte mieux que ses prédécesseurs pour organiser des scènes complexes.
L'annonce indique également que Stable Diffusion 3 recourt à une technique appelée flow matching. Il s'agit d'une méthode plus économe en calcul pour entraîner des modèles et générer des images que la technique de trajectoire de diffusion actuelle. Concrètement, l'IA est moins coûteuse à entraîner, et la génération d'images l'est aussi, ce qui réduit les coûts d'utilisation.
L'une des limites actuelles des IA de génération d'images concerne la génération de texte. À noter, l'annonce de Stability AI s'ouvrait sur une image intégrant le nom du modèle, « Stable Diffusion 3 ». L'agencement des lettres est bon mais pas parfait : on remarque par exemple que l'espace entre le « B » et le « L » de Stable est plus grand qu'entre le « L » et le « E ». De même, les deux « F » de Diffusion sont trop rapprochés. Dans l'ensemble, on constate toutefois une nette amélioration par rapport à la génération précédente de modèles.
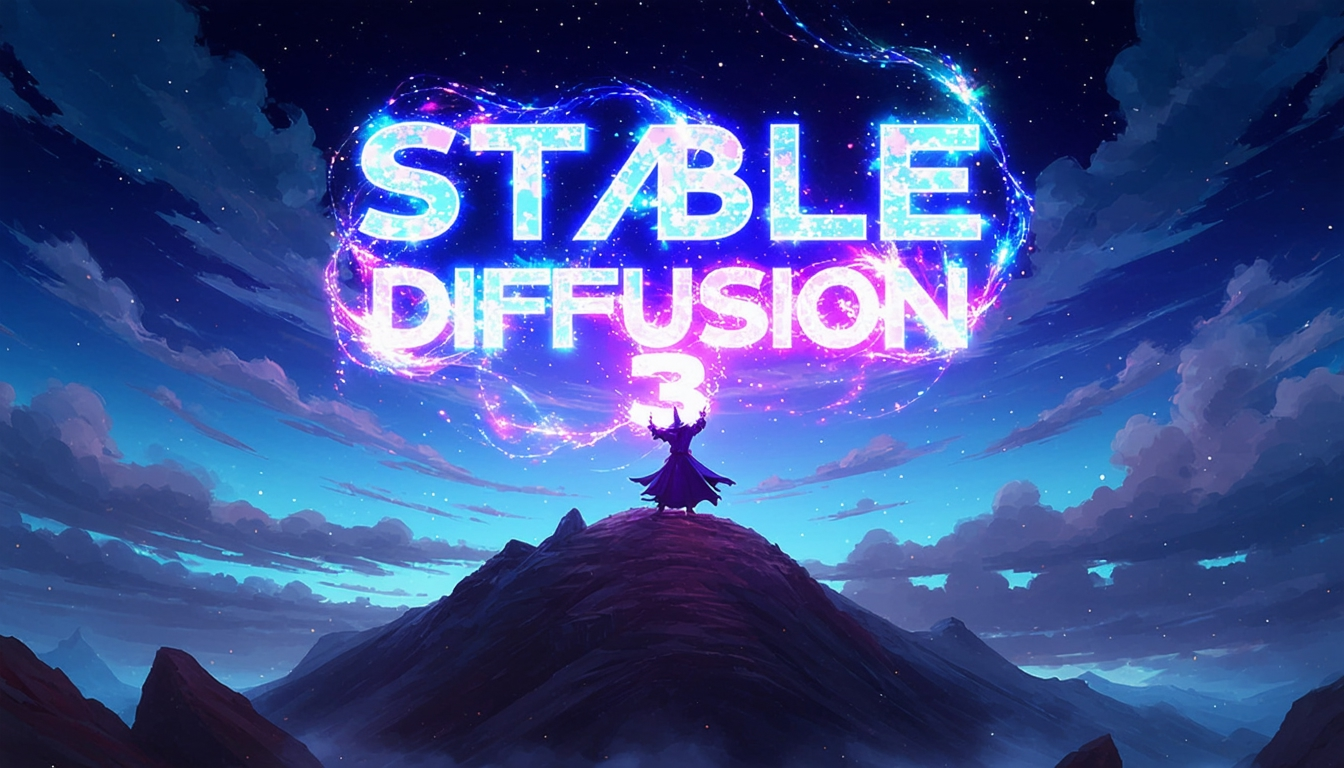
Prompt : illustration d'anime épique d'un sorcier au sommet d'une montagne, de nuit, lançant un sort cosmique dans le ciel noir indiquant « Stable Diffusion 3 », composé d'une énergie colorée
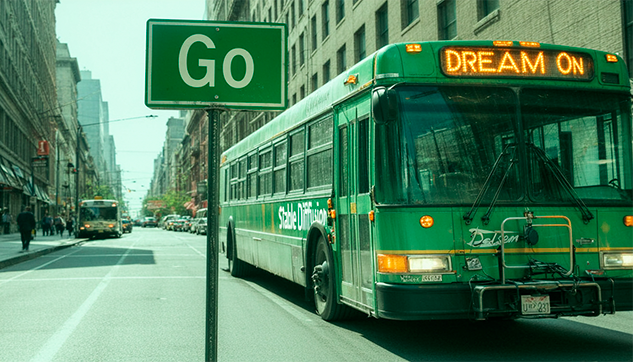
Un autre problème tient au fait que les diffuseurs génèrent des fragments d'image séparément, ce qui peut créer des incohérences entre différentes zones. Cela pose surtout problème lorsque l'on vise des images réalistes. Le billet d'annonce comportait peu d'exemples photoréalistes, mais une image d'autobus dans une rue en ville révèle quelques cas de figure. On note que l'ombre sous le bus laisse penser que la lumière vient de l'arrière, alors que l'ombre d'un immeuble sur la chaussée indique une lumière venant de la gauche. De même, l'alignement des fenêtres de l'immeuble en haut à droite présente de légères incohérences selon les zones. Le bus n'a pas de conducteur non plus, même si un prompt plus précis pourrait corriger ce point.
Stable Diffusion 3 est en phase d'« aperçu préliminaire ». Il n'est donc accessible qu'aux chercheurs à des fins de test. Cette phase permet à Stability AI de recueillir des retours sur les performances et la sécurité du modèle avant un lancement public.
Vous pouvez rejoindre la liste d'attente pour y accéder ici.
Les IA de génération d'images ont déjà de multiples usages, de l'illustration au design graphique en passant par les supports marketing. Stable Diffusion devrait s'utiliser de la même manière, avec l'avantage supplémentaire de mieux gérer des compositions plus complexes.
Le jeu de données ayant servi à l'entraînement de Stable Diffusion comprenait des images protégées par le droit d'auteur, ce qui a entraîné plusieurs actions en justice encore en cours. L'issue reste incertaine, mais il est théoriquement possible que certaines images créées avec Stable Diffusion soient également considérées comme portant atteinte au droit d'auteur.
Les détails techniques complets de Stable Diffusion 3 n'ont pas encore été publiés et, en particulier, il n'est pas possible d'évaluer les performances de l'IA. Une fois le modèle disponible publiquement et des benchmarks établis, on pourra mesurer l'ampleur des progrès par rapport aux versions précédentes. D'autres facteurs, comme le temps et le coût de génération d'une image, deviendront également plus clairs.
Un point technique fortement mis en avant par OpenAI dans son papier DALL·E 3, mais non mentionné par Stability AI, est la « recaptioning ». Il s'agit d'une forme d'orchestration automatique de prompts, où le texte saisi par l'utilisateur est restructuré et enrichi pour fournir des instructions plus claires au modèle. On ignore si Stable Diffusion 3 utilise cette technique.
Stable Diffusion 3 s'annonce comme une nouvelle avancée pour l'IA générative texte‑vers‑image. Une fois l'IA disponible publiquement, nous pourrons la tester plus avant et découvrir de nouveaux cas d'usage. Si vous souhaitez vous lancer dès maintenant dans l'IA générative, notre parcours de compétences AI Fundamentals vous aidera à prendre en main le machine learning, le deep learning, le NLP, les modèles génératifs, et plus encore.
Pour aller plus loin sur l'actualité de l'IA, consultez la sélection ci‑dessous :
Commencez votre parcours IA dès aujourd'hui !
Cours
Cursus
Cours