
Last chance! 50% off DataCamp Premium
Sale ends in
Stability AI heeft een vroege preview van Stable Diffusion 3 aangekondigd, hun tekst-naar-beeld generatieve AI-model. In tegenstelling tot de Sora-tekst-naar-video-aankondiging van OpenAI van vorige week waren er beperkte demo’s van de nieuwe mogelijkheden van het model, maar er zijn wel enkele details gedeeld. In dit artikel bekijken we wat de aankondiging betekent, hoe het nieuwe model werkt en welke implicaties dit heeft voor de vooruitgang van beeldgeneratie.
Stable Diffusion is een reeks generatieve AI-modellen voor tekst-naar-beeld. Je schrijft een prompt waarin je beschrijft wat je wilt zien, en het model maakt een afbeelding die bij je beschrijving past. Er is een webinterface voor gemakkelijke toegang tot de AI.
Een belangrijk verschil met OpenAI’s concurrerende DALL·E-beeldgeneratie-AI is dat het "open weights" heeft. Met andere woorden: de details van het neurale netwerk dat de berekeningen van het model uitvoert, zijn openbaar beschikbaar. Dat zorgt voor enige transparantie in hoe het model werkt, en maakt het mogelijk voor onderzoekers om het werk van Stability AI aan te passen en erop voort te bouwen.
Stable Diffusion 3 is niet één model, maar een hele familie van modellen, met groottes variërend van 800 miljoen parameters tot 8 miljard parameters. Meer parameters leveren een hogere outputkwaliteit op, maar hebben als bijeffect dat afbeeldingen duurder zijn en langer duren om te genereren. Versies met minder parameters zijn beter voor eenvoudige afbeeldingen, terwijl versies met meer parameters geschikter zijn voor hogere kwaliteit of complexere beelden.
Stable Diffusion 3 gebruikt een diffusion transformer-architectuur, vergelijkbaar met die van Sora. Eerdere versies van Stable Diffusion—en de meeste huidige beeldgeneratie-AI’s—gebruiken een diffusionmodel. Grote taalmodellen voor tekstgeneratie, zoals GPT, gebruiken een transformerarchitectuur. Het combineren van beide is een recente innovatie en belooft het beste van beide architecturen te benutten.
Diffusionmodellen zijn goed in het creëren van detail in kleine regio’s, maar minder in het genereren van de algemene lay-out van een afbeelding. Transformers zijn daarentegen goed in lay-out, maar minder in het creëren van detail. Het is dus waarschijnlijk dat Stable Diffusion een transformer gebruikt om de globale compositie te bepalen en vervolgens diffusers inzet om patches te genereren.
Dat betekent dat we kunnen verwachten dat Stable Diffusion 3 beter presteert dan zijn voorgangers bij het organiseren van complexe scènes.
In de aankondiging staat ook dat Stable Diffusion 3 gebruikmaakt van een techniek genaamd flow matching. Dit is een computationeel efficiëntere manier om modellen te trainen en er afbeeldingen mee te genereren dan de huidige diffusion pad-techniek. Dat betekent dat de AI goedkoper is om te ontwikkelen, en dat afbeeldingen die met de AI worden gemaakt ook goedkoper te genereren zijn, wat resulteert in lagere kosten voor de AI.
Een van de huidige beperkingen van beeldgeneratie-AI is de mogelijkheid om tekst te genereren. Opvallend is dat de aankondiging van Stability AI begon met een afbeelding met de naam van het model, "Stable Diffusion 3". De plaatsing van de letters in de tekst is goed, maar niet perfect: let op dat de afstand tussen de "B" en de "L" in Stable groter is dan de afstand tussen de "L" en de "E". Evenzo staan de twee "F"’s in Diffusion te dicht op elkaar. Al met al is dit echter een duidelijke verbetering ten opzichte van de vorige generatie modellen.
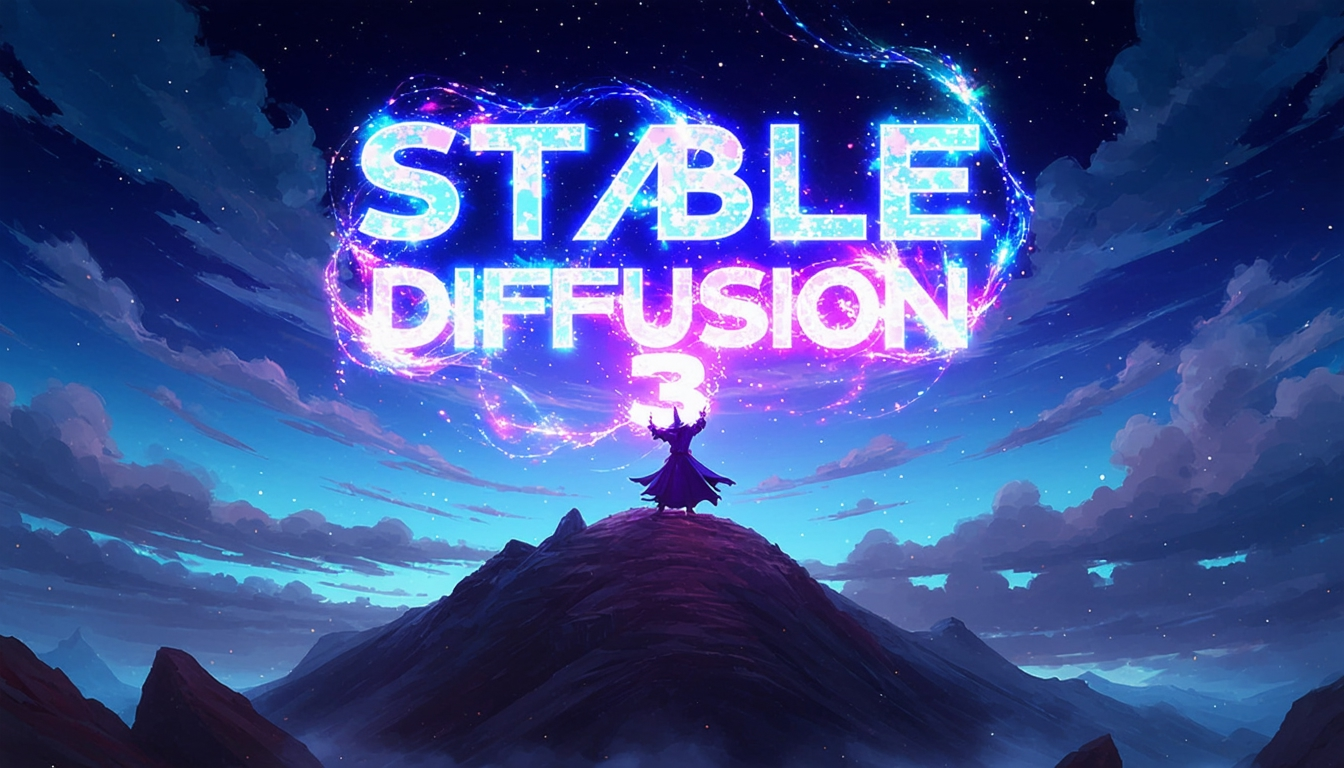
Prompt: Epische anime-illustratie van een tovenaar op een bergtop ’s nachts die een kosmische spreuk de donkere lucht in werpt met de tekst "Stable Diffusion 3" gemaakt van kleurrijke energie
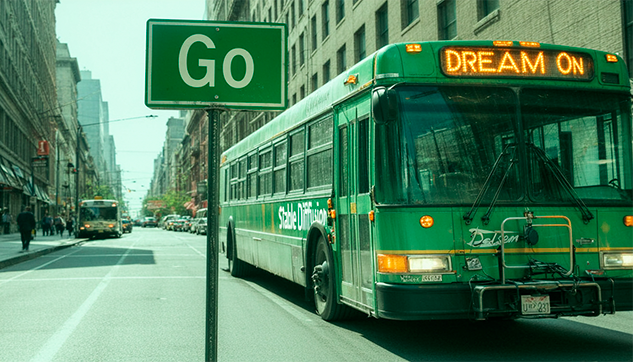
Een ander probleem met de modellen is dat, omdat diffusers patches van de afbeelding afzonderlijk genereren, er inconsistenties kunnen ontstaan tussen verschillende regio’s. Dit is vooral een probleem bij het proberen te genereren van realistische beelden. In de aankondiging stonden niet veel realistische voorbeelden, maar een afbeelding van een bus in een stadsstraat laat een paar van deze problemen zien. Let op dat de schaduw onder de bus wijst op licht van achter de bus, terwijl de schaduw van een gebouw op straat duidt op licht van de linkerkant van de afbeelding. Ook de plaatsing van de ramen in het gebouw rechtsboven is licht inconsistent tussen verschillende delen van het gebouw. De bus heeft bovendien geen chauffeur, al is dat mogelijk te verhelpen met een zorgvuldiger prompt.
Stable Diffusion 3 bevindt zich in een "early preview"-fase. Dat betekent dat het alleen beschikbaar is voor onderzoekers voor testdoeleinden. Deze previewperiode stelt Stability AI in staat feedback te verzamelen over de prestaties en veiligheid van het model voordat het voor het publiek wordt vrijgegeven.
Je kunt je hier inschrijven op de wachtlijst voor toegang tot de AI.
Beeldgeneratie-AI’s kennen al veel toepassingen, van illustraties tot grafisch ontwerp en marketingmateriaal. Stable Diffusion belooft op dezelfde manieren inzetbaar te zijn, met als extra voordeel dat het waarschijnlijk beter beelden met complexere lay-outs kan creëren.
De dataset waarop Stable Diffusion is getraind, bevatte enkele auteursrechtelijk beschermde afbeeldingen, wat heeft geleid tot meerdere nog onopgeloste rechtszaken. Het is onduidelijk wat de uitkomst van deze zaken zal zijn, maar theoretisch is het mogelijk dat afbeeldingen die met Stable Diffusion zijn gemaakt ook als inbreuk op het auteursrecht worden beschouwd.
De volledige technische details van Stable Diffusion 3 zijn nog niet vrijgegeven en er is met name geen manier om de prestaties van de AI te testen. Zodra het model publiek beschikbaar is en er benchmarks zijn, kunnen we bepalen hoeveel beter de AI is dan eerdere modellen. Ook factoren zoals de tijd en kosten om een afbeelding te genereren, zullen dan duidelijk worden.
Een technische ontwikkeling die door OpenAI sterk werd benadrukt in hun DALL·E 3-paper, maar niet werd genoemd in de aankondiging van Stability AI, is recaptioning. Dit is een vorm van automatische prompt engineering, waarbij de tekst die door de gebruiker is geschreven wordt herstructureerd en aangevuld met extra details om het model duidelijkere instructies te geven. Het is onbekend of Stable Diffusion 3 van deze techniek gebruikmaakt.
Stable Diffusion 3 lijkt opnieuw een stap vooruit in de ontwikkeling van generatieve tekst-naar-beeld-AI. Zodra de AI publiek wordt vrijgegeven, kunnen we verder testen en nieuwe toepassingen ontdekken. Als je graag wilt beginnen met generatieve AI, helpt onze AI Fundamentals skill track je op weg met machine learning, deep learning, NLP, generatieve modellen en meer.
Voor meer bronnen over het nieuwste in de AI-wereld, bekijk de lijst hieronder:
Begin vandaag nog met je AI-reis!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min


