Curso
Comprender ChatGPT
1 h
434.9K
Stability AI anunció un acceso anticipado a Stable Diffusion 3, su modelo generativo de IA de texto a imagen. A diferencia del anuncio de Sora de texto a vídeo de OpenAI de la semana pasada, se mostraron pocas demostraciones de las nuevas capacidades del modelo, aunque sí se compartieron algunos detalles. Aquí analizamos qué implica el anuncio, cómo funciona el nuevo modelo y qué consecuencias puede tener para el avance de la generación de imágenes.
Stable Diffusion es una serie de modelos generativos de IA que crean imágenes a partir de texto. Es decir, escribes un prompt describiendo lo que quieres ver y el modelo genera una imagen que se ajusta a tu descripción. Existe una interfaz web para acceder fácilmente a la IA.
Una diferencia importante con DALL·E, el modelo rival de OpenAI para generar imágenes, es que cuenta con "pesos abiertos". Es decir, los detalles de la red neuronal que realiza los cálculos del modelo son públicos. Esto aporta cierta transparencia sobre cómo funciona el modelo y permite que investigadores adapten y construyan sobre el trabajo de Stability AI.
Stable Diffusion 3 no es un único modelo, sino toda una familia, con tamaños que van desde 800 millones de parámetros hasta 8.000 millones. A más parámetros, mayor calidad de salida, aunque con el efecto secundario de que las imágenes son más caras y tardan más en generarse. Las versiones con menos parámetros son mejores para crear imágenes sencillas y las versiones con más parámetros se adaptan mejor a imágenes de mayor calidad o más complejas.
Stable Diffusion 3 utiliza una arquitectura de diffusion transformer, similar a la que emplea Sora. Las versiones anteriores de Stable Diffusion —y la mayoría de IAs actuales de generación de imágenes— usan un modelo de difusión. Los grandes modelos de lenguaje para generación de texto, como GPT, usan una arquitectura transformer. Combinar ambos enfoques es un avance reciente que promete aprovechar lo mejor de las dos arquitecturas.
Los modelos de difusión son muy buenos creando detalle en regiones pequeñas, pero flojean al generar el diseño global de una imagen. Por el contrario, los transformers se manejan bien con el layout, pero les cuesta generar detalles finos. Así que es probable que Stable Diffusion combine un transformer para organizar la composición general de la imagen y después use difusores para generar los parches.
Esto nos permite esperar que Stable Diffusion 3 se desempeñe mejor que sus predecesores al organizar escenas complejas.
El anuncio también señala que Stable Diffusion 3 emplea una técnica llamada flow matching. Es una forma más eficiente computacionalmente de entrenar modelos y de crear imágenes con ellos que la técnica de trayectorias de difusión actual. En la práctica, la IA es más barata de entrenar y las imágenes también son más baratas de generar, reduciendo los costes del sistema.
Una de las limitaciones actuales de la generación de imágenes con IA es la capacidad de generar texto. De hecho, el anuncio de Stability AI comenzaba con una imagen que incluía el nombre del modelo, "Stable Diffusion 3". La colocación de las letras es buena pero no perfecta: fíjate en que la distancia entre la "B" y la "L" de Stable es mayor que entre la "L" y la "E". Del mismo modo, las dos "F" de Diffusion están demasiado juntas. Aun así, en conjunto, supone una mejora notable respecto a la generación anterior de modelos.
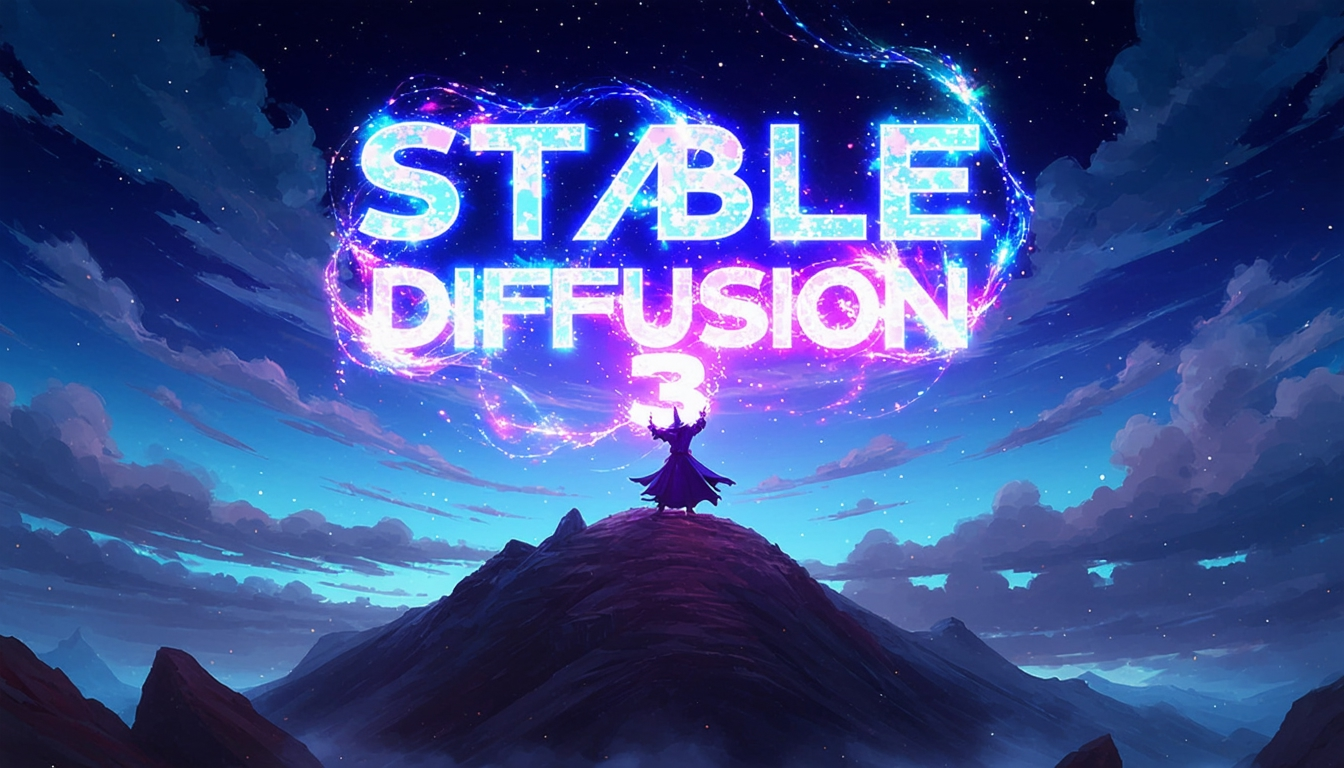
Prompt: ilustración anime épica de un mago en lo alto de una montaña de noche lanzando un hechizo cósmico al cielo oscuro que diga "Stable Diffusion 3" hecho de energía multicolor
Otro problema de estos modelos es que, como los difusores generan parches de la imagen por separado, pueden aparecer inconsistencias entre regiones. Esto se nota sobre todo al intentar generar imágenes realistas. La entrada del anuncio no incluía muchos ejemplos fotorrealistas, pero una imagen de un autobús en una calle de ciudad deja ver algunos de estos fallos. Observa que la sombra bajo el autobús sugiere una luz que viene desde detrás, mientras que la sombra de un edificio en la calzada indica luz desde la izquierda. También la colocación de las ventanas del edificio en la parte superior derecha es algo inconsistente entre distintas zonas. Además, el autobús no tiene conductor, aunque esto podría resolverse con un prompt más cuidadoso.
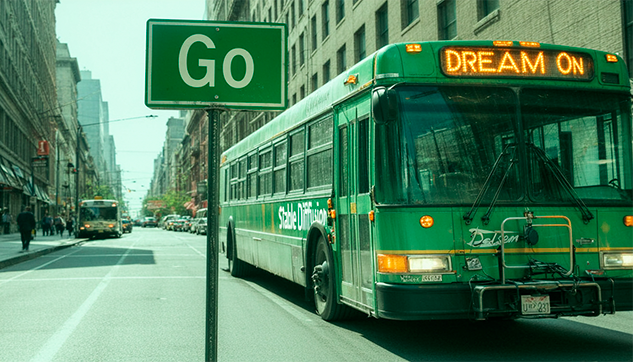
Stable Diffusion 3 está en fase de "acceso anticipado". Esto significa que solo está disponible para investigadores con fines de prueba. Esta fase permite a Stability AI recopilar feedback sobre el rendimiento y la seguridad del modelo antes de lanzarlo al público general.
Puedes unirte a la lista de espera para acceder a la IA aquí.
Las IAs de generación de imágenes ya se utilizan en multitud de casos, desde ilustración y diseño gráfico hasta materiales de marketing. Stable Diffusion apunta a ser útil en los mismos ámbitos, con la ventaja añadida de que probablemente podrá crear imágenes con composiciones más complejas.
El conjunto de datos con el que se entrenó Stable Diffusion incluía algunas imágenes con copyright, lo que ha derivado en varias demandas aún sin resolver. No está claro cuál será su desenlace, pero en teoría podría considerarse que las imágenes creadas con Stable Diffusion también infringen derechos de autor.
Aún no se han publicado todos los detalles técnicos de Stable Diffusion 3 y, en particular, no hay forma de evaluar el rendimiento de la IA. Cuando el modelo esté disponible públicamente y existan benchmarks, podremos determinar cuánto mejora respecto a versiones anteriores. También quedarán claros otros factores como el tiempo y el coste de generar una imagen.
Un avance técnico que OpenAI destacó mucho en su artículo de DALL·E 3, pero que no se mencionó en el anuncio de Stability AI, es el recaptioning. Se trata de una forma de prompt engineering automática, donde el texto del usuario se reestructura y enriquece con más detalle para dar instrucciones más claras al modelo. Se desconoce si Stable Diffusion 3 utiliza esta técnica o no.
Stable Diffusion 3 promete ser otro paso adelante en el progreso de la IA generativa de texto a imagen. Cuando se publique, podremos probarla a fondo y descubrir nuevos casos de uso. Si tienes ganas de adentrarte en el mundo de la IA generativa, nuestro itinerario de aprendizaje AI Fundamentals te ayudará a ponerte al día con machine learning, deep learning, NLP, modelos generativos y mucho más.
Para más recursos sobre lo último en IA, echa un vistazo a esta lista:
¡Empieza hoy tu viaje en IA!
Curso
programa
Curso
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
8 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Adel Nehme
9 min