Stability AI đã giới thiệu bản xem trước sớm của Stable Diffusion 3, mô hình AI sinh ảnh từ văn bản của họ. Khác với thông báo về Sora chuyển văn bản thành video của OpenAI tuần trước, số lượng bản trình diễn các khả năng mới của mô hình còn hạn chế, nhưng một số chi tiết đã được cung cấp. Bài viết này phân tích ý nghĩa của thông báo, cách mô hình mới hoạt động và những tác động đối với sự phát triển của công nghệ tạo ảnh.
Stable Diffusion 3 là gì?
Stable Diffusion là một loạt mô hình AI sinh ảnh từ văn bản. Nghĩa là bạn viết một gợi ý mô tả điều mình muốn thấy và mô hình sẽ tạo ra hình ảnh khớp với mô tả đó. Có giao diện web để truy cập AI một cách dễ dàng.
Một khác biệt lớn so với DALL·E, AI sinh ảnh đối thủ của OpenAI, là mô hình có "trọng số mở". Tức là chi tiết về mạng nơ-ron thực hiện tính toán cho mô hình được công khai. Điều này mang lại mức độ minh bạch nhất định về cách mô hình hoạt động và cho phép các nhà nghiên cứu điều chỉnh, phát triển dựa trên công trình của Stability AI.
Stable Diffusion 3 không phải chỉ một mô hình mà là cả một họ mô hình, với kích thước từ 800 triệu tham số đến 8 tỷ tham số. Nhiều tham số hơn thường cho chất lượng đầu ra cao hơn, nhưng kéo theo hệ quả là hình ảnh tốn kém hơn và mất nhiều thời gian hơn để tạo. Các phiên bản có ít tham số phù hợp để tạo hình ảnh đơn giản, còn các phiên bản có nhiều tham số thích hợp để tạo ảnh chất lượng cao hoặc phức tạp hơn.
Stable Diffusion 3 hoạt động như thế nào?
Stable Diffusion 3 sử dụng kiến trúc diffusion transformer, tương tự như Sora. Các phiên bản trước của Stable Diffusion—và phần lớn các AI sinh ảnh hiện nay—sử dụng mô hình khuếch tán (diffusion). Các mô hình ngôn ngữ lớn cho sinh văn bản, như GPT, dùng kiến trúc transformer. Khả năng kết hợp hai mô hình này là một đổi mới gần đây và hứa hẹn tận dụng ưu điểm của cả hai kiến trúc.
Mô hình khuếch tán tạo chi tiết tốt ở các vùng nhỏ nhưng kém trong việc tạo bố cục tổng thể của hình. Ngược lại, transformer giỏi về bố cục nhưng kém trong việc tạo chi tiết. Vì vậy, nhiều khả năng Stable Diffusion sẽ dùng transformer để sắp đặt bố cục tổng thể rồi dùng diffusers để tạo các mảng chi tiết.
Điều đó có nghĩa là chúng ta có thể kỳ vọng Stable Diffusion 3 sẽ tổ chức các cảnh phức tạp tốt hơn các phiên bản trước.
Thông báo cũng cho biết Stable Diffusion 3 dùng kỹ thuật gọi là flow matching. Đây là cách huấn luyện mô hình và tạo ảnh từ mô hình hiệu quả tính toán hơn so với kỹ thuật đường dẫn khuếch tán hiện tại. Điều này giúp quá trình tạo AI rẻ hơn và ảnh tạo ra bằng AI cũng rẻ hơn, từ đó giảm chi phí vận hành AI.
Những hạn chế của Stable Diffusion 3 là gì?
Một hạn chế hiện tại của AI sinh ảnh là khả năng tạo văn bản trong ảnh. Đáng chú ý, thông báo của Stability AI mở đầu bằng một hình ảnh có chứa tên mô hình "Stable Diffusion 3". Vị trí các chữ cái trong văn bản khá tốt nhưng chưa hoàn hảo: lưu ý khoảng cách giữa "B" và "L" trong từ Stable rộng hơn khoảng cách giữa "L" và "E". Tương tự, hai chữ "F" trong từ Diffusion lại quá sát nhau. Tuy nhiên, nhìn chung đây là cải thiện đáng kể so với thế hệ mô hình trước.
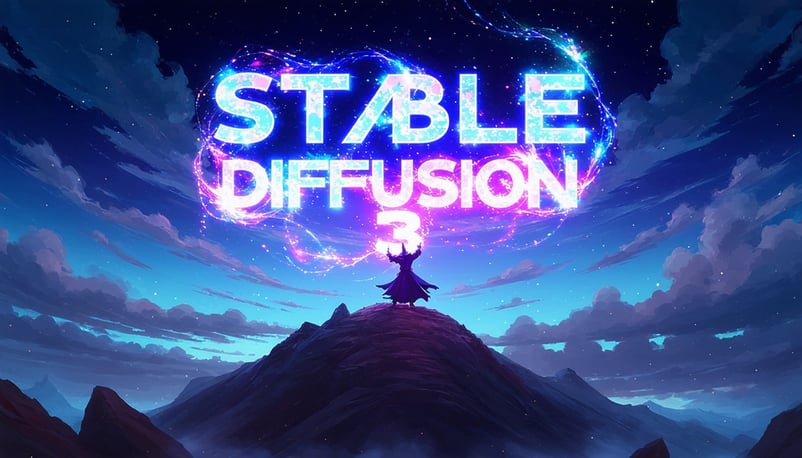
Gợi ý: Tác phẩm anime hoành tráng vẽ một pháp sư trên đỉnh núi trong đêm, niệm phép thuật vũ trụ lên bầu trời đen với dòng chữ "Stable Diffusion 3" tạo thành từ năng lượng nhiều màu
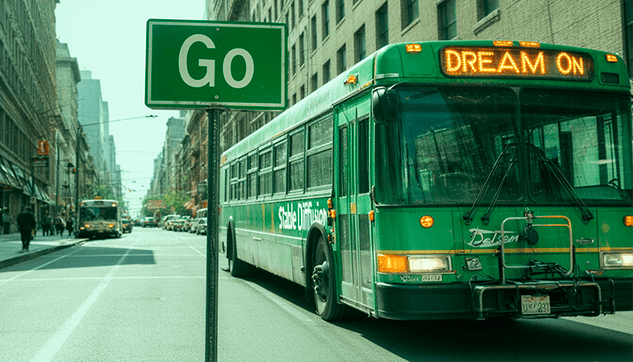
Một vấn đề khác là do diffusers tạo các mảng ảnh riêng lẻ, nên có thể xảy ra không nhất quán giữa các vùng. Điều này chủ yếu gây rắc rối khi cố gắng tạo ảnh hiện thực. Bài thông báo không có nhiều ví dụ ảnh hiện thực, nhưng một bức ảnh xe buýt trên phố cho thấy vài trường hợp như vậy. Hãy để ý bóng dưới gầm xe buýt gợi ý ánh sáng từ phía sau xe, nhưng bóng của tòa nhà trên mặt đường lại cho thấy ánh sáng từ phía bên trái ảnh. Tương tự, vị trí các ô cửa sổ của tòa nhà ở góc trên bên phải hơi thiếu nhất quán giữa các vùng. Xe buýt cũng không có tài xế, dù có thể xử lý bằng gợi ý cẩn thận hơn.
Làm sao để truy cập Stable Diffusion 3?
Stable Diffusion 3 đang trong giai đoạn "xem trước sớm". Điều này có nghĩa chỉ các nhà nghiên cứu mới có thể truy cập để thử nghiệm. Giai đoạn xem trước nhằm giúp Stability AI thu thập phản hồi về hiệu năng và độ an toàn của mô hình trước khi phát hành rộng rãi.
Bạn có thể tham gia danh sách chờ để truy cập AI tại đây.
Stable Diffusion 3 được dùng vào việc gì?
Các AI sinh ảnh đã có nhiều ứng dụng, từ minh họa, thiết kế đồ họa đến tài liệu tiếp thị. Stable Diffusion hứa hẹn tiếp tục hữu dụng theo các cách tương tự, với lợi thế bổ sung là nhiều khả năng tạo được ảnh có bố cục phức tạp hơn.
Rủi ro của Stable Diffusion 3 là gì?
Bộ dữ liệu dùng để huấn luyện Stable Diffusion có bao gồm một số hình ảnh có bản quyền, dẫn đến một số vụ kiện vẫn chưa ngã ngũ. Chưa rõ kết quả sẽ ra sao, nhưng về lý thuyết, bất kỳ hình ảnh nào do Stable Diffusion tạo ra cũng có thể bị coi là vi phạm bản quyền.
Những gì chúng ta chưa biết?
Toàn bộ chi tiết kỹ thuật của Stable Diffusion 3 vẫn chưa được công bố, và đặc biệt là chưa có cách nào kiểm thử hiệu năng của AI. Khi mô hình được phát hành công khai và có các chuẩn đo, chúng ta sẽ có thể xác định mức độ cải thiện so với các mô hình trước. Những yếu tố khác như thời gian và chi phí để tạo ảnh cũng sẽ sáng tỏ.
Một phát triển kỹ thuật được OpenAI nhấn mạnh trong bài báo về DALL·E 3 nhưng không được đề cập trong thông báo của Stability AI là recaptioning. Đây là một dạng kỹ thuật "kỹ sư gợi ý" tự động, trong đó văn bản người dùng viết được cấu trúc lại và bổ sung chi tiết để đưa ra chỉ dẫn rõ ràng hơn cho mô hình. Chưa rõ Stable Diffusion 3 có sử dụng kỹ thuật này hay không.
Lời kết
Stable Diffusion 3 hứa hẹn là một bước tiến nữa trong lĩnh vực AI sinh ảnh từ văn bản. Khi AI được phát hành rộng rãi, chúng ta sẽ có thể thử nghiệm sâu hơn và khám phá các cách dùng mới. Nếu bạn nóng lòng bước vào thế giới AI sinh, lộ trình kỹ năng AI Fundamentals sẽ giúp bạn nhanh chóng nắm bắt học máy, học sâu, NLP, mô hình sinh và hơn thế nữa.
Để tìm hiểu thêm về những cập nhật mới nhất trong thế giới AI, hãy xem danh sách dưới đây:

Stability AI đã giới thiệu bản xem trước sớm của Stable Diffusion 3, mô hình AI sinh ảnh từ văn bản của họ. Khác với thông báo về Sora chuyển văn bản thành video của OpenAI tuần trước, số lượng bản trình diễn các khả năng mới của mô hình còn hạn chế, nhưng một số chi tiết đã được cung cấp. Bài viết này phân tích ý nghĩa của thông báo, cách mô hình mới hoạt động và những tác động đối với sự phát triển của công nghệ tạo ảnh.
Stable Diffusion 3 là gì?
Stable Diffusion là một loạt mô hình AI sinh ảnh từ văn bản. Nghĩa là bạn viết một gợi ý mô tả điều mình muốn thấy và mô hình sẽ tạo ra hình ảnh khớp với mô tả đó. Có giao diện web để truy cập AI một cách dễ dàng.
Một khác biệt lớn so với DALL·E, AI sinh ảnh đối thủ của OpenAI, là mô hình có "trọng số mở". Tức là chi tiết về mạng nơ-ron thực hiện tính toán cho mô hình được công khai. Điều này mang lại mức độ minh bạch nhất định về cách mô hình hoạt động và cho phép các nhà nghiên cứu điều chỉnh, phát triển dựa trên công trình của Stability AI.
Stable Diffusion 3 không phải chỉ một mô hình mà là cả một họ mô hình, với kích thước từ 800 triệu tham số đến 8 tỷ tham số. Nhiều tham số hơn thường cho chất lượng đầu ra cao hơn, nhưng kéo theo hệ quả là hình ảnh tốn kém hơn và mất nhiều thời gian hơn để tạo. Các phiên bản có ít tham số phù hợp để tạo hình ảnh đơn giản, còn các phiên bản có nhiều tham số thích hợp để tạo ảnh chất lượng cao hoặc phức tạp hơn.
Stable Diffusion 3 hoạt động như thế nào?
Stable Diffusion 3 sử dụng kiến trúc diffusion transformer, tương tự như Sora. Các phiên bản trước của Stable Diffusion—và phần lớn các AI sinh ảnh hiện nay—sử dụng mô hình khuếch tán (diffusion). Các mô hình ngôn ngữ lớn cho sinh văn bản, như GPT, dùng kiến trúc transformer. Khả năng kết hợp hai mô hình này là một đổi mới gần đây và hứa hẹn tận dụng ưu điểm của cả hai kiến trúc.
Mô hình khuếch tán tạo chi tiết tốt ở các vùng nhỏ nhưng kém trong việc tạo bố cục tổng thể của hình. Ngược lại, transformer giỏi về bố cục nhưng kém trong việc tạo chi tiết. Vì vậy, nhiều khả năng Stable Diffusion sẽ dùng transformer để sắp đặt bố cục tổng thể rồi dùng diffusers để tạo các mảng chi tiết.
Điều đó có nghĩa là chúng ta có thể kỳ vọng Stable Diffusion 3 sẽ tổ chức các cảnh phức tạp tốt hơn các phiên bản trước.
Thông báo cũng cho biết Stable Diffusion 3 dùng kỹ thuật gọi là flow matching. Đây là cách huấn luyện mô hình và tạo ảnh từ mô hình hiệu quả tính toán hơn so với kỹ thuật đường dẫn khuếch tán hiện tại. Điều này giúp quá trình tạo AI rẻ hơn và ảnh tạo ra bằng AI cũng rẻ hơn, từ đó giảm chi phí vận hành AI.
Những hạn chế của Stable Diffusion 3 là gì?
Một hạn chế hiện tại của AI sinh ảnh là khả năng tạo văn bản trong ảnh. Đáng chú ý, thông báo của Stability AI mở đầu bằng một hình ảnh có chứa tên mô hình "Stable Diffusion 3". Vị trí các chữ cái trong văn bản khá tốt nhưng chưa hoàn hảo: lưu ý khoảng cách giữa "B" và "L" trong từ Stable rộng hơn khoảng cách giữa "L" và "E". Tương tự, hai chữ "F" trong từ Diffusion lại quá sát nhau. Tuy nhiên, nhìn chung đây là cải thiện đáng kể so với thế hệ mô hình trước.
Gợi ý: Tác phẩm anime hoành tráng vẽ một pháp sư trên đỉnh núi trong đêm, niệm phép thuật vũ trụ lên bầu trời đen với dòng chữ "Stable Diffusion 3" tạo thành từ năng lượng nhiều màu
Một vấn đề khác là do diffusers tạo các mảng ảnh riêng lẻ, nên có thể xảy ra không nhất quán giữa các vùng. Điều này chủ yếu gây rắc rối khi cố gắng tạo ảnh hiện thực. Bài thông báo không có nhiều ví dụ ảnh hiện thực, nhưng một bức ảnh xe buýt trên phố cho thấy vài trường hợp như vậy. Hãy để ý bóng dưới gầm xe buýt gợi ý ánh sáng từ phía sau xe, nhưng bóng của tòa nhà trên mặt đường lại cho thấy ánh sáng từ phía bên trái ảnh. Tương tự, vị trí các ô cửa sổ của tòa nhà ở góc trên bên phải hơi thiếu nhất quán giữa các vùng. Xe buýt cũng không có tài xế, dù có thể xử lý bằng gợi ý cẩn thận hơn.
Làm sao để truy cập Stable Diffusion 3?
Stable Diffusion 3 đang trong giai đoạn "xem trước sớm". Điều này có nghĩa chỉ các nhà nghiên cứu mới có thể truy cập để thử nghiệm. Giai đoạn xem trước nhằm giúp Stability AI thu thập phản hồi về hiệu năng và độ an toàn của mô hình trước khi phát hành rộng rãi.
Bạn có thể tham gia danh sách chờ để truy cập AI tại đây.
Stable Diffusion 3 được dùng vào việc gì?
Các AI sinh ảnh đã có nhiều ứng dụng, từ minh họa, thiết kế đồ họa đến tài liệu tiếp thị. Stable Diffusion hứa hẹn tiếp tục hữu dụng theo các cách tương tự, với lợi thế bổ sung là nhiều khả năng tạo được ảnh có bố cục phức tạp hơn.
Rủi ro của Stable Diffusion 3 là gì?
Bộ dữ liệu dùng để huấn luyện Stable Diffusion có bao gồm một số hình ảnh có bản quyền, dẫn đến một số vụ kiện vẫn chưa ngã ngũ. Chưa rõ kết quả sẽ ra sao, nhưng về lý thuyết, bất kỳ hình ảnh nào do Stable Diffusion tạo ra cũng có thể bị coi là vi phạm bản quyền.
Những gì chúng ta chưa biết?
Toàn bộ chi tiết kỹ thuật của Stable Diffusion 3 vẫn chưa được công bố, và đặc biệt là chưa có cách nào kiểm thử hiệu năng của AI. Khi mô hình được phát hành công khai và có các chuẩn đo, chúng ta sẽ có thể xác định mức độ cải thiện so với các mô hình trước. Những yếu tố khác như thời gian và chi phí để tạo ảnh cũng sẽ sáng tỏ.
Một phát triển kỹ thuật được OpenAI nhấn mạnh trong bài báo về DALL·E 3 nhưng không được đề cập trong thông báo của Stability AI là recaptioning. Đây là một dạng kỹ thuật "kỹ sư gợi ý" tự động, trong đó văn bản người dùng viết được cấu trúc lại và bổ sung chi tiết để đưa ra chỉ dẫn rõ ràng hơn cho mô hình. Chưa rõ Stable Diffusion 3 có sử dụng kỹ thuật này hay không.
Lời kết
Stable Diffusion 3 hứa hẹn là một bước tiến nữa trong lĩnh vực AI sinh ảnh từ văn bản. Khi AI được phát hành rộng rãi, chúng ta sẽ có thể thử nghiệm sâu hơn và khám phá các cách dùng mới. Nếu bạn nóng lòng bước vào thế giới AI sinh, lộ trình kỹ năng AI Fundamentals sẽ giúp bạn nhanh chóng nắm bắt học máy, học sâu, NLP, mô hình sinh và hơn thế nữa.
Để tìm hiểu thêm về những cập nhật mới nhất trong thế giới AI, hãy xem danh sách dưới đây: