
什么是图数据库?
图数据库是一种专用的、面向单一用途的平台,用于创建和操作具有关联性与上下文特性的数据信息。图由节点、边和属性组成,三者相互配合,使用户能够以关系型数据库难以胜任的方式来表示和存储数据。
图数据库系统的核心概念是“关系”。关系被定义为一等公民——这意味着您对其他所有元素能做的事,同样也能对关系进行。数据在图中相互关联,以存储节点和边的集合,其中边表示节点之间的关系。
关系使系统中的数据可以被直接连接。由于关系以稳定不变的方式存储,查询图数据库中的关系非常快速。您还可以将其可视化,这非常有利于从高度互联的数据中获取洞见。
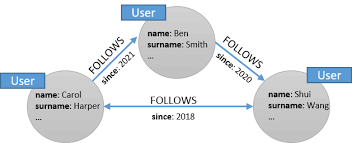
社交网络图数据库中关系的示意图
图数据库与关系型数据库:相似点与差异
您也许还在思考图数据库与关系型数据库有何不同。两者都用于存储信息、表示数据之间的关系,但实现这一目标的方式并不相同。
我们将从五个方面来划分它们之间的差异:
- 数据模型
- 操作方式
- 可扩展性
- 性能
- 易用性
- 应用
下面我们深入看看它们有何不同。
数据模型
关系型数据库使用数据表将信息结构化为行和列。每一列定义数据实体的特定属性,而每一行代表一条独立的数据记录。由于数据表具有固定的模式,用户必须通过主键和外键来定义不同表之间的关系。
相比之下,图数据库使用图结构来组织数据,其中通过节点、边和属性来表示数据。具体来说,节点定义对象,边展示节点之间的关系,属性描述节点和边的特征。后文将进一步介绍。
操作方式
关系型数据库依靠 SQL 的强大功能来操作数据。SQL 使开发者能够执行多种查询,并能高效处理表之间关系明确的结构化数据。它在针对多张表进行筛选、聚合与连接方面尤为擅长。
图数据库使用遍历算法来查询图数据模型。遍历算法可以是深度优先或广度优先,有助于快速发现并检索关联数据。
可扩展性
虽然关系型数据库可以进行水平扩展(例如分片),但这会显著增加数据存储的复杂性,并可能引发一致性等问题。更推荐的扩展方式是垂直扩展,即通过升级硬件(如 CPU、存储、内存等)来提升服务器可承载的工作负载。
另一方面,图数据库非常擅长水平扩展。它们通过分区实现这一点——即将存储的数据库对象拆分到不同服务器的独立部分。分区使多台服务器能够并行处理图查询。
性能
图数据库通常采用“无索引邻接”。这意味着每个节点直接引用其相邻节点。因此,访问关系和相关数据只需进行内存指针查找。本质上,这非常快。
关系型数据库必须扫描不同的表来识别实体之间的关系。比如,当您需要连接多张表时,数据库系统必须扫描整份数据以找到关系。随着数据规模变大,性能会随之下降。
易用性
关系是图数据库的中心。这使其在处理关联数据,尤其是执行多跳查询(即沿多重关系遍历路径的查询)时非常易用。在关系型数据库中,这必须通过 SQL 来完成。用 SQL 编写多跳查询并不直观,容易变得相当复杂,进而导致难以阅读和维护的庞大查询。
应用
对关系的重视使图数据库非常适合经常发生动态变化与调整的任务,例如语义搜索和推荐引擎。相较之下,关系型数据库的刚性结构使其理想用于能很好地装入表格的结构化数据,如客户数据和交易数据。
|
图数据库 |
关系型数据库 | |
|
数据模型 / 模式 |
固定 |
灵活 |
|
操作方式 |
遍历算法 |
SQL |
|
可扩展性 |
通过分区进行水平扩展 |
垂直扩展(也可水平扩展,但会增加复杂性)。 |
|
性能 |
快速(包括大规模数据集) |
数据集变大时变慢 |
|
易用性 |
直观 |
不够自然(但在许多用例中更成熟、更流行)。 |
|
应用 |
经常发生动态变化与调整的任务(如语义搜索、推荐引擎等)。 |
依赖数据完整性的任务(如客户数据、交易等)。 |
图数据库的核心组成
如前所述,图数据库使用户能够以图的形式表示数据。用于按此格式建模数据的三个关键组成部分是节点、边和属性。
节点
对象或实例通过节点来表示。从概念上讲,节点相当于关系型数据库中的一行,并在图中充当顶点。对节点进行分组只需为每个成员应用一个标签。
边
图中的边也被称为关系。关系始终由起始节点、终止节点、类型和方向组成。它们通过描述父子关系、动作、所有权等来形成数据模式。
属性
简单来说,属性就是与节点相关联的信息。
图数据库示例
我们来看看目前一些最流行的图数据库,帮助我们了解其关键特性。
一些流行的图数据库
Neo4j
Neo4j 是全球领先的图数据库之一,能够让用户在数十亿条数据连接中深度、轻松且快速地发现模式与洞见。具体而言,Neo4j 是使用 Java 开发的、具有高度可扩展性的 NoSQL 开源数据库。查看我们的NoSQL 概念课程了解更多。
其关键特性包括:
- 属性图数据模型
- 实现直观而灵活的数据建模,便于在复杂数据关系中轻松导航。
- 原生图处理与存储
- 优化数据检索与图遍历,确保在处理大型数据集与复杂查询时迅捷高效。
- 符合 ACID(原子性、一致性、隔离性、持久性)的事务
- 保证可靠的数据处理,在所有事务中维护数据的准确性与可信度。
- Cypher 图查询语言
- 提供功能强大且易于使用的图数据查询方式,简化从互联数据中提取有意义洞见的过程。
- 高性能原生 API
- 确保与数据库的高效交互,对于需要低延迟与高吞吐数据库交互的应用至关重要。
- Cypher 客户端
- 便于应用程序无缝执行 Cypher 查询,增强动态与交互式用户体验。
- 多种编程语言的驱动
- 通过为多种编程语言提供驱动(包括 C#、Go、Java、JavaScript 和 Python),提供开发灵活性,确保轻松集成到多样化技术栈中。
Amazon Neptune
Amazon Neptune 是一项快速、可靠且全托管的图数据库服务,可快速、轻松地开发与运行处理高密度关联数据的应用。Neptune 的基础是专为图而构建的高性能数据库引擎,旨在在维持数十亿条关系的同时,以毫秒级延迟执行查询。
其关键特性包括:
- 支持开放图 API
- 通过支持多种开放图 API(如用于属性图的 Gremlin 与 openCypher,以及用于 RDF 图的 SPARQL),提升兼容性与灵活性,使开发者能够使用熟悉的查询语言与数据库交互。
- 高安全性
- 通过实施完善的安全功能,确保数据保护与合规性,保障数据库中信息的完整性与机密性。
- 全托管
- 通过代管硬件供应、软件打补丁、安装和配置等数据库任务,简化用户体验,让开发者专注于构建应用而非运维数据库。
- 自动备份
- 通过自动处理备份流程,提高数据持久性并支持灾难恢复,确保数据免于意外丢失并可在需要时恢复。
其他图数据库
另外两个常见选择是 ArangoDB 和 OrientDB。
ArangoDB 是一个免费、开源的 NoSQL 图数据库系统。它支持三种数据模型(图、JSON 文档和键/值),即多模型,拥有单一的数据库内核和统一的查询语言 AQL(ArangoDB Query Language)。该工具以查询语言为主,允许在单个查询中组合多种数据访问模式。
OrientDB 是用 Java 编写的开源 NoSQL 数据库管理系统。与 ArangoDB 类似,OrientDB 也是多模型数据库,支持图、JSON 文档、键/值和对象模型;不过,关系的管理方式与图数据库一致(即记录之间的直接连接)。该工具拥有基于用户与角色的强大安全画像系统,并支持使用 Gremlin 以及为图遍历扩展的 SQL 进行查询。
我们的NoSQL 数据库指南将进一步探讨它们为何对数据科学如此有用。
图数据库的应用场景
社交网络
社交媒体网络天然适合用图数据模型来表示。借助图数据库,捕捉关系的过程更为简单,因为数据无需在图与表之间来回转换。图数据模型可以直接用于表示如用户及其关系等内容。
推荐引擎
诸如社交网络中的好友、客户兴趣和购买历史等信息类别之间的关系可以存储在图数据库中。随后可基于具有相似兴趣或购买历史的其他用户所购买的产品,为某位用户提供产品推荐。在社交好友的场景中,您还可以利用图数据库发现那些拥有共同好友但尚未互相关注的用户,并将他们相互推荐。
欺诈检测
图数据库可用于存储交易、人员及其他相关信息之间的关系,使用户能够发现常见模式,并构建能够检测欺诈活动的应用。例如,它可以轻松发现暗示欺诈的关系模式,如多个个人使用同一电子邮件地址,或多人共用同一 IP 地址但居住在不同的实际地址。
总结
在本指南中,您了解到图数据库是用于创建和操作具有关联性与上下文特性数据的专用单一平台。您也了解到,尽管两者都承担存储数据与表示关系的职责,但关系型数据库与图数据库实现目标的方式截然不同。例如,关系型数据库使用 SQL 进行操作,而图数据库使用遍历算法,这使其即便在处理大规模数据集时也更快,并且更适合高度互联的数据。
通过以下资源进一步学习数据库:

如果您看过真实犯罪题材的电影,就会了解连接关系线索的威力。片中总会有这样一幕:一面墙上贴着主要嫌疑人的照片和各类报纸剪报,它们被线条相互串联。
想象把那块板子接上一个数学引擎,能够快速查询各种关系——这就是图数据库的本质。
在本文中,我们将讨论以下主题: