

Kurs
SQL ile İlişkisel Veritabanlarına Giriş
4 sa
201.4K
Alıştırma and program your progress.
Google Ile Devam EdinGraf veritabanı, ilişkisel ve bağlamsal nitelikteki verileri oluşturmak ve işlemek için kullanılan, uzmanlaşmış ve tek amaçlı bir platformdur. Grafın kendisi, kullanıcıların verileri ilişkisel veritabanlarının yapamadığı bir şekilde temsil etmesine ve saklamasına olanak tanıyan düğümler, kenarlar ve özellikler içerir.
Bir graf veritabanı sisteminin temel kavramı ilişkidir. İlişkiler birinci sınıf öğeler olarak tanımlanır — bu, diğer tüm öğelerle yapabildiğiniz her şeyin bir ilişkiyle de yapılabileceği anlamına gelir. Veriler, düğümler ve aralarındaki ilişkiyi temsil eden kenarların bir koleksiyonunu depolamak için bir graf içinde birbirleriyle ilişkilendirilir.
Sistem içindeki verilerin doğrudan birbirine bağlanmasına ilişkiler olanak tanır. Graf veritabanında ilişkileri sorgulamak hızlıdır çünkü değişmeyen bir şekilde saklanırlar. Ayrıca görselleştirilebilirler; bu da onları yoğun biçimde birbirine bağlı verilerden içgörü çıkarmak için ideal kılar.
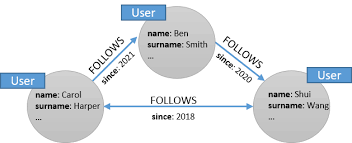
Bir sosyal ağ graf veritabanında ilişkilerin temsili
Graf veritabanının ilişkisel olanlardan nasıl ayrıldığını merak ediyor olabilirsiniz. Her ikisi de bilgiyi saklar ve veriler arası ilişkileri temsil etmek için kullanılır, ancak bu hedefe ulaşma biçimleri farklıdır.
Aralarındaki farkları beş kategoriye ayıracağız:
Nasıl farklılaştıklarına daha yakından bakalım.
İlişkisel veritabanları, bilgileri satır ve sütunlara yapılandırmak için veri tablolarını kullanır. Her sütun, veri varlığının belirli bir niteliğini tanımlar; satırlar ise tekil bir veri kaydını temsil eder. Veri tabloları sabit şemaya sahip olduğundan, kullanıcıların farklı tablolar arasındaki ilişkileri birincil ve yabancı anahtarlarla tanımlaması gerekir.
Buna karşılık, bir graf veritabanı verileri, veriyi temsil etmek için düğümler, kenarlar ve özelliklerden yararlanan bir graf yapısıyla düzenler. Yani düğümler nesneleri tanımlar, kenarlar düğümler arasındaki ilişkileri gösterir ve özellikler düğümlerin ve kenarların niteliklerini açıklar. Aşağıda bununla ilgili daha fazlası var.
İlişkisel veritabanları verileri işlemek için SQL'in gücünden yararlanır. SQL, geliştiricilerin çeşitli sorgular yürütmesini sağlar ve tablolar arasındaki iyi tanımlanmış ilişkilerle yapılandırılmış verileri etkili biçimde işler. Özellikle birden çok tablo üzerinde filtreleme, toplama ve birleştirme işlemlerinde başarılıdır.
Graf veritabanları, graf veri modelini sorgulamak için geçiş (traversal) algoritmalarını kullanır. Geçiş algoritmaları derinlik öncelikli ya da genişlik öncelikli olabilir; bu da bağlı verilerin hızla keşfedilip alınmasına yardımcı olur.
Bir ilişkisel veritabanını yatayda ölçeklemek (ör. parçalama kullanarak) mümkün olsa da, bu durum veri depolamanın karmaşıklığını ciddi ölçüde artırır ve tutarlılık gibi başka sorunlara yol açabilir. İlişkisel bir veritabanını ölçeklemenin önerilen yolu dikeydir. Dikey ölçekleme, bir sunucunun kaldırabileceği iş yükünü artırmak için donanımın (ör. CPU, depolama, bellek vb.) yükseltilmesidir.
Öte yandan, graf veritabanları yatay ölçeklemede oldukça başarılıdır. Bunu, depolanan veritabanı nesnelerini farklı sunuculardaki ayrı parçalara bölen bir teknik olan bölümleme (partitioning) sayesinde başarırlar. Bu bölümler, çok sayıda sunucunun graf sorgularını paralel olarak işlemesine olanak tanır.
Graf veritabanları genellikle indis gerektirmeyen bitişiklik (index-free adjacency) kullanır. Bu, her düğümün komşu düğümlerine doğrudan referans verdiği anlamına gelir. Dolayısıyla ilişkilere ve ilgili verilere erişim, aslında bir bellek işaretçisi aramasından ibarettir. Bu da pratikte hızlı oldukları anlamına gelir.
İlişkisel veritabanları, varlıklar arasındaki ilişkileri belirlemek için farklı tabloları taramak zorundadır. Örneğin birden çok tabloyu birleştirmek istediğinizde, veritabanı sistemi ilişkileri bulmak için tüm veriyi taramak durumunda kalır. Bu da veri büyüdükçe performansın düştüğü anlamına gelir.
İlişkiler, graf veritabanlarının merkezindedir. Bu da özellikle çok adımlı sorgular (birden çok ilişki içeren yol geçişleri) çalıştırırken, bağlı verilerle çalışmayı son derece kolaylaştırır. İlişkisel bir veritabanında bu, SQL ile yapılmak zorundadır. SQL'de çok adımlı bir sorgu yazmak doğallaşmaz; oldukça karmaşık hale gelebilir ve okunması ile bakımı zor yığın sorgulara yol açabilir.
İlişkilere odaklanma, graf veritabanlarını sık sık dinamik değişimler ve uyarlamalar gözlemlenen görevler için uygun kılar. Bu tür görevlere anlamsal arama ve öneri motorları örnek verilebilir. Buna karşılık, ilişkisel veritabanlarının katılığı, tablo yapısına iyi uyan yapılandırılmış veriler için idealdir. Müşteri verileri ve işlemler gibi veriler buna örnektir.
|
Graf veritabanı |
İlişkisel veritabanı |
|
|
Veri modeli / Şema |
Sabit |
Esnek |
|
İşlemler |
Geçiş (traversal) algoritmaları |
SQL |
|
Ölçeklenebilirlik |
Bölümleme kullanarak yatay |
Dikey (yatay da yapılabilir ama karmaşıklık ekler). |
|
Performans |
Hızlı (büyük veri kümeleri dahil) |
Veri kümesi büyüdükçe daha yavaş |
|
Kullanım kolaylığı |
Sezgisel |
Doğal değil (ancak birçok kullanım senaryosunda çok daha olgun ve popülerdir). |
|
Uygulama |
Sıkça dinamik değişimler ve uyarlamalar görülen görevler (ör. anlamsal arama, öneri motorları vb.). |
Veri bütünlüğüne dayanan görevler (ör. müşteri verileri, işlemler vb.). |
Daha önce belirtildiği gibi, graf veritabanları kullanıcıların verileri bir graf olarak temsil etmesini sağlar. Bu formatta verileri modellemek için kullanılan üç temel bileşen düğümler, kenarlar ve özelliklerdir.
Nesneler veya örnekler bir düğüm kullanılarak temsil edilir. Kavramsal olarak düğümler, ilişkisel bir veritabanındaki satıra denktir ve bir graf içinde tepe (vertex) görevi görür. Bir düğümü gruplamak, her üyeye bir etiket uygulayarak yapılır.
Bir grafın kenarlarına bir diğer ad da ilişkilerdir. İlişkiler her zaman bir başlangıç düğümü, bitiş düğümü, tür ve yön içerir. Ebeveyn-çocuk ilişkileri, eylemler, sahiplik gibi kavramları tanımlayarak veri örüntülerini oluştururlar.
Basitçe söylemek gerekirse, özellikler düğümlerle ilişkili bilgilerdir.
Bugün kullanımda olan en popüler graf veritabanlarından bazılarına göz atalım ve temel özelliklerinin neler olduğunu anlayalım.
Bazı popüler graf veritabanları
Neo4j, kullanıcıların milyarlarca veri bağlantısı arasında örüntüleri ve içgörüleri derinlemesine, kolay ve hızlı bir şekilde keşfetmesini sağlayan, dünyanın önde gelen graf veritabanlarından biridir. Neo4j, Java kullanılarak geliştirilen, yüksek ölçekte ölçeklenebilir bir NoSQL açık kaynak veritabanıdır. Daha fazlası için NoSQL kavramları kursumuza göz atın.
Temel özellikler şunlardır:
Yoğun biçimde bağlantılı verilerle çalışan uygulamalar, hızlı, güvenilir ve tamamen yönetilen bir graf veritabanı hizmeti olan Amazon Neptune ile hızlıca ve kolayca geliştirilebilir ve çalıştırılabilir. Neptune'un temelinde, amaç odaklı, yüksek performanslı bir graf veritabanı motoru bulunur. Bu motor, milyarlarca ilişkiyi korurken grafı milisaniye gecikmeyle sorgulayacak şekilde tasarlanmıştır.
Temel özellikler şunlardır:
Diğer iki popüler seçenek ArangoDB ve OrientDB'dir.
ArangoDB, ücretsiz, açık kaynaklı bir NoSQL graf veritabanı sistemidir. Üç veri modelini (graf, JSON belgeleri ve anahtar/değer) destekler; yani tek bir veritabanı çekirdeği ve birleşik bir sorgu dili, ArangoDB Query Language (AQL) ile çoklu modeldir. Araç ağırlıklı olarak bir sorgu dilidir ve tek bir sorguda çeşitli veri erişim örüntülerinin birleştirilmesine olanak tanır.
OrientDB, Java ile yazılmış, açık kaynaklı bir NoSQL veritabanı yönetim sistemidir. ArangoDB'ye benzer şekilde OrientDB de graf, JSON belgeleri, anahtar/değer ve nesne modellerini destekleyen çoklu model bir veritabanıdır; ancak ilişkiler, graf veritabanlarındaki gibi yönetilir (yani kayıtlar arasında doğrudan bağlantılar). Araç, kullanıcılar ve rollere dayalı sağlam bir güvenlik profilleme sistemine sahiptir ve graf geçişi için genişletilmiş SQL'in yanı sıra Gremlin ile sorgulamayı destekler.
NoSQL veritabanlarına ilişkin rehberimiz, veri bilimi için neden bu kadar faydalı olduklarına dair daha fazla nedeni inceler.
Sosyal medya ağları doğası gereği graf veri modeliyle temsil edilir. Bir graf veritabanından yararlanmak, verilerin graf ile tablo arasında dönüştürülmesini gerektirmediğinden, ilişkileri yakalama sürecini basitleştirir. Kullanıcılar ve aralarındaki ilişkiler gibi unsurları doğrudan temsil etmek için graf veri modeli kullanılabilir.
Bir ağdaki arkadaşlar, müşteri ilgisi ve satın alma geçmişi gibi bilgi kategorileri arasındaki ilişkiler bir graf veritabanında saklanabilir. Daha sonra, benzer ilgi alanlarına veya satın alma geçmişlerine sahip diğer kullanıcıların satın aldığı ürünlere dayalı olarak bir kullanıcıya ürün önerileri yapılabilir. Ağdaki arkadaşlar senaryosunda, henüz bağlantısı olmayan ancak ortak arkadaşları bulunan kullanıcıları keşfetmek ve birbirlerine önermek için graf veritabanından yararlanabilirsiniz.
Graf veritabanları, kullanıcıların ortak örüntüleri bulmasını ve sahtecilik faaliyetlerini tespit edebilen uygulamalar geliştirmesini sağlamak için işlemler, kişiler ve diğer ilgili bilgiler arasındaki ilişkileri depolamakta kullanılabilir. Örneğin, tek bir e‑posta adresiyle ilişkilendirilmiş birden çok kişi ya da farklı fiziksel adreslerde yaşayan ancak aynı IP adresini paylaşan birden çok kişi gibi sahteciliğe işaret eden ilişki örüntülerini kolayca keşfetmek için kullanılabilir.
Bu kılavuzda, graf veritabanlarının ilişkisel ve bağlamsal nitelikteki verileri oluşturmak ve işlemek için kullanılan, uzmanlaşmış ve tek amaçlı platformlar olduğunu öğrendiniz. Ayrıca, verileri depolama ve ilişkileri temsil etme gibi bariz ortak görevlerine rağmen, ilişkisel ve graf veritabanlarının amaçlarına ulaşma biçimlerinin oldukça farklı olduğunu gördünüz. Örneğin, ilişkisel veritabanları işlemleri için SQL kullanırken, graf veritabanları geçiş algoritmalarını kullanır; bu da onları büyük veri kümelerinde bile çok daha hızlı ve yoğun biçimde birbirine bağlı veriler için daha uygun kılar.
Veritabanları hakkında daha fazla bilgi için şu kaynaklara göz atın:
Veritabanı Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



