

Khóa học
Nhập môn Cơ sở dữ liệu quan hệ bằng SQL
4 giờ
201.4K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleGraph database là một nền tảng chuyên biệt, đơn mục đích dùng để tạo và thao tác dữ liệu mang tính liên kết và ngữ cảnh. Bản thân đồ thị bao gồm các nút (node), cạnh (edge) và thuộc tính (property) kết hợp với nhau để cho phép người dùng biểu diễn và lưu trữ dữ liệu theo cách mà các cơ sở dữ liệu quan hệ không được trang bị để làm.
Khái niệm chính của hệ thống graph database là mối quan hệ. Mối quan hệ được coi là thực thể hạng nhất — nghĩa là mọi thứ bạn có thể làm với các thành phần khác đều có thể thực hiện với mối quan hệ. Dữ liệu được liên kết với nhau trong một đồ thị để lưu trữ tập hợp các nút và cạnh, trong đó các cạnh thể hiện mối quan hệ giữa các nút.
Các mối quan hệ cho phép dữ liệu trong hệ thống được liên kết trực tiếp với nhau. Truy vấn mối quan hệ trong graph database rất nhanh vì chúng được lưu trữ theo cách không thay đổi. Bạn cũng có thể trực quan hóa chúng, giúp việc rút ra insight từ dữ liệu có mức độ kết nối cao trở nên hiệu quả.
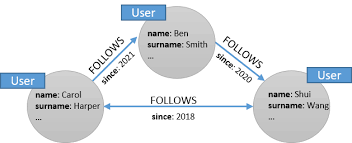
Minh họa các mối quan hệ trong cơ sở dữ liệu đồ thị mạng xã hội
Bạn có thể vẫn thắc mắc graph database khác gì so với cơ sở dữ liệu quan hệ. Cả hai đều lưu trữ thông tin và dùng để biểu diễn mối quan hệ giữa dữ liệu, nhưng cách chúng đạt được mục tiêu này thì khác nhau.
Chúng ta sẽ chia các khác biệt của chúng thành năm nhóm:
Hãy đi sâu hơn vào những điểm khác biệt.
Cơ sở dữ liệu quan hệ sử dụng các bảng dữ liệu để cấu trúc thông tin thành hàng và cột. Mỗi cột xác định một thuộc tính cụ thể của thực thể dữ liệu, còn các hàng biểu diễn một bản ghi dữ liệu riêng lẻ. Do các bảng dữ liệu có lược đồ cố định, người dùng phải xác định mối quan hệ giữa các bảng khác nhau bằng khóa chính và khóa ngoại.
Ngược lại, graph database cấu trúc dữ liệu bằng cấu trúc đồ thị trong đó nút, cạnh và thuộc tính được dùng để biểu diễn dữ liệu. Cụ thể, nút định nghĩa các đối tượng, cạnh minh họa mối quan hệ giữa các nút, và thuộc tính mô tả đặc trưng của các nút và cạnh. Chi tiết hơn ở phần sau.
Cơ sở dữ liệu quan hệ tận dụng sức mạnh của SQL để thao tác dữ liệu. SQL cho phép nhà phát triển thực hiện nhiều truy vấn và xử lý hiệu quả dữ liệu có cấu trúc với các mối quan hệ rõ ràng giữa các bảng. SQL đặc biệt mạnh ở việc lọc, tổng hợp và join dữ liệu giữa nhiều bảng.
Graph database sử dụng các thuật toán duyệt (traversal) để truy vấn mô hình dữ liệu đồ thị. Thuật toán duyệt có thể theo chiều sâu (depth-first) hoặc theo chiều rộng (breadth-first), giúp phát hiện và truy xuất dữ liệu kết nối một cách nhanh chóng.
Mặc dù có thể mở rộng ngang một cơ sở dữ liệu quan hệ (ví dụ, dùng sharding), điều này làm tăng đáng kể độ phức tạp của lưu trữ dữ liệu và có thể phát sinh các vấn đề như tính nhất quán. Cách khuyến nghị để mở rộng cơ sở dữ liệu quan hệ là theo chiều dọc. Mở rộng dọc là nâng cấp phần cứng (ví dụ: CPU, lưu trữ, bộ nhớ, v.v.) để tăng tải công việc máy chủ có thể xử lý.
Ngược lại, graph database làm rất tốt việc mở rộng ngang. Chúng đạt được điều này nhờ phân mảnh (partitioning), kỹ thuật chia các đối tượng dữ liệu được lưu trữ thành các phần riêng trên nhiều máy chủ khác nhau. Các phân vùng này cho phép nhiều máy chủ xử lý truy vấn đồ thị song song.
Graph database thường sử dụng kết cận không chỉ mục (index-free adjacency). Điều này có nghĩa mỗi nút tham chiếu trực tiếp đến các nút lân cận. Vì vậy, truy cập mối quan hệ và dữ liệu liên quan chỉ là thao tác tra cứu địa chỉ trong bộ nhớ. Nói cách khác, rất nhanh.
Cơ sở dữ liệu quan hệ phải quét các bảng khác nhau để xác định mối quan hệ giữa các thực thể. Ví dụ, nếu bạn muốn join nhiều bảng, hệ quản trị phải quét toàn bộ dữ liệu để tìm mối quan hệ. Điều này đồng nghĩa khi dữ liệu càng lớn, hiệu năng càng giảm.
Mối quan hệ là trung tâm của graph database. Điều này khiến chúng cực kỳ dễ làm việc với dữ liệu kết nối, đặc biệt khi thực hiện các truy vấn nhiều bước (multi-hop) — các truy vấn đi qua nhiều quan hệ. Trong cơ sở dữ liệu quan hệ, việc này phải làm bằng SQL. Viết truy vấn multi-hop trong SQL không tự nhiên; chúng có thể trở nên khá phức tạp và dễ dẫn tới các truy vấn cồng kềnh, khó đọc và khó bảo trì.
Sự tập trung vào mối quan hệ khiến graph database rất phù hợp cho các tác vụ thường xuyên có thay đổi và thích ứng động. Những tác vụ như tìm kiếm ngữ nghĩa và hệ thống gợi ý. Ngược lại, tính cứng của cơ sở dữ liệu quan hệ khiến chúng lý tưởng cho dữ liệu có cấu trúc khớp tốt với bảng. Ví dụ như dữ liệu khách hàng và giao dịch.
|
Graph database |
Relational database |
|
|
Mô hình dữ liệu / Lược đồ |
Cố định |
Linh hoạt |
|
Vận hành |
Thuật toán duyệt |
SQL |
|
Khả năng mở rộng |
Ngang bằng phân mảnh (partitioning) |
Dọc (có thể ngang nhưng tăng độ phức tạp). |
|
Hiệu năng |
Nhanh (kể cả với tập dữ liệu lớn) |
Chậm dần khi tập dữ liệu lớn lên |
|
Dễ sử dụng |
Trực quan |
Không tự nhiên (nhưng trưởng thành và phổ biến hơn trong nhiều trường hợp). |
|
Ứng dụng |
Các tác vụ thường xuyên có thay đổi và thích ứng động (ví dụ: tìm kiếm ngữ nghĩa, hệ gợi ý, v.v.). |
Các tác vụ phụ thuộc vào tính toàn vẹn dữ liệu (ví dụ: dữ liệu khách hàng, giao dịch, v.v.). |
Như đã đề cập, graph database cho phép người dùng biểu diễn dữ liệu dưới dạng đồ thị. Ba thành phần quan trọng để mô hình hóa dữ liệu theo định dạng này là nút, cạnh và thuộc tính.
Các đối tượng hoặc thể hiện được biểu diễn bằng một nút. Về mặt khái niệm, nút tương đương với một hàng trong cơ sở dữ liệu quan hệ và đóng vai trò là một đỉnh trong đồ thị. Nhóm các nút được thực hiện đơn giản bằng cách áp nhãn (label) cho từng phần tử.
Một tên gọi khác của cạnh trong đồ thị là mối quan hệ. Mối quan hệ luôn bao gồm nút bắt đầu, nút kết thúc, kiểu và hướng. Chúng tạo nên các mẫu dữ liệu bằng cách mô tả mối quan hệ cha–con, hành động, quyền sở hữu, v.v.
Nói đơn giản, thuộc tính là thông tin gắn với các nút.
Hãy điểm qua một số graph database phổ biến nhất hiện có ngày nay để hiểu các tính năng chính của chúng.
Một số graph database phổ biến
Neo4j là một trong những graph database hàng đầu thế giới, cho phép người dùng khám phá sâu, dễ và nhanh các mẫu và insight trên hàng tỷ kết nối dữ liệu. Cụ thể, Neo4j là cơ sở dữ liệu NoSQL mã nguồn mở có khả năng mở rộng cao, được phát triển bằng Java. Xem khóa học khái niệm NoSQL của chúng tôi để tìm hiểu thêm.
Các tính năng chính gồm:
Các ứng dụng làm việc với dữ liệu kết nối dày đặc có thể được phát triển và vận hành nhanh chóng, dễ dàng bằng Amazon Neptune, một dịch vụ graph database nhanh, đáng tin cậy và được quản lý hoàn toàn. Nền tảng của Neptune là một động cơ graph chuyên dụng, hiệu năng cao. Động cơ này được thiết kế để truy vấn đồ thị với độ trễ mili giây đồng thời duy trì hàng tỷ mối quan hệ.
Các tính năng chính gồm:
Hai lựa chọn phổ biến khác là ArangoDB và OrientDB.
ArangoDB là hệ thống graph database NoSQL miễn phí, mã nguồn mở. Nó hỗ trợ ba mô hình dữ liệu (đồ thị, tài liệu JSON và cặp khóa/giá trị), tức là đa mô hình, với một lõi cơ sở dữ liệu duy nhất và ngôn ngữ truy vấn thống nhất, ArangoDB Query Language (AQL). Công cụ này chủ yếu là một ngôn ngữ truy vấn và cho phép kết hợp nhiều mẫu truy cập dữ liệu trong một truy vấn duy nhất.
OrientDB là hệ quản trị cơ sở dữ liệu NoSQL mã nguồn mở viết bằng Java. Tương tự ArangoDB, OrientDB cũng là cơ sở dữ liệu đa mô hình hỗ trợ đồ thị, tài liệu JSON, cặp khóa/giá trị và mô hình đối tượng; tuy nhiên, các mối quan hệ được quản lý như trong graph database (tức là kết nối trực tiếp giữa các bản ghi). Công cụ này có hệ thống phân quyền bảo mật mạnh dựa trên người dùng và vai trò, và hỗ trợ truy vấn bằng Gremlin cùng với SQL được mở rộng cho duyệt đồ thị.
Hướng dẫn về cơ sở dữ liệu NoSQL của chúng tôi khám phá thêm các lý do vì sao chúng hữu ích cho khoa học dữ liệu.
Mạng xã hội tự nhiên được biểu diễn bằng mô hình dữ liệu đồ thị. Tận dụng graph database giúp đơn giản hóa việc ghi nhận các mối quan hệ vì dữ liệu không cần phải chuyển đổi từ đồ thị sang bảng rồi ngược lại. Mô hình dữ liệu đồ thị có thể được dùng trực tiếp để biểu diễn những thứ như người dùng và các mối quan hệ của họ.
Các mối quan hệ giữa những nhóm thông tin như bạn bè trong một mạng, sở thích của khách hàng và lịch sử mua hàng có thể được lưu trong graph database. Từ đó có thể gợi ý sản phẩm cho người dùng dựa trên các sản phẩm đã được mua bởi những người dùng khác có sở thích hoặc lịch sử mua hàng tương tự. Trong kịch bản bạn bè trên mạng, bạn có thể dùng graph database để phát hiện những người dùng có bạn chung nhưng chưa kết nối và đề xuất họ với nhau.
Graph database có thể được dùng để lưu trữ các mối quan hệ giữa giao dịch, con người và thông tin liên quan khác nhằm cho phép người dùng tìm ra các mẫu chung và xây dựng ứng dụng có khả năng phát hiện hành vi gian lận. Ví dụ, có thể dễ dàng phát hiện các mẫu quan hệ gợi ý gian lận, như nhiều cá nhân gắn với một địa chỉ email hoặc nhiều người chia sẻ cùng một địa chỉ IP nhưng cư trú tại các địa chỉ vật lý khác nhau.
Trong hướng dẫn này, bạn đã biết graph database là các nền tảng chuyên biệt, đơn mục đích dùng để tạo và thao tác dữ liệu mang tính liên kết và ngữ cảnh. Bạn cũng đã thấy rằng, dù cùng nhiệm vụ lưu trữ dữ liệu và biểu diễn mối quan hệ, cơ sở dữ liệu quan hệ và đồ thị khác nhau đáng kể trong cách đạt mục tiêu. Ví dụ, cơ sở dữ liệu quan hệ dùng SQL cho các thao tác, trong khi graph database dùng các thuật toán duyệt, giúp chúng nhanh hơn nhiều, ngay cả với tập dữ liệu lớn, và phù hợp hơn cho dữ liệu có mức độ kết nối cao.
Tìm hiểu thêm về cơ sở dữ liệu qua các tài nguyên sau:
Bắt đầu hành trình Cơ sở dữ liệu của bạn ngay hôm nay!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
