

Cursus
Introductie tot relationele databases in SQL
4 uur
201.4K
Oefen en volg je voortgang.
Ga Verder Met GoogleEen graphdatabase is een gespecialiseerde, doelgerichte platformoplossing om gegevens van associatieve en contextuele aard te creëren en te manipuleren. De graaf zelf bevat knooppunten, randen en eigenschappen die samen gebruikers in staat stellen data weer te geven en op te slaan op een manier die relationele databases niet aankunnen.
Het hoofdconcept van een graphdatabasesysteem is een relatie. Relaties zijn first-class citizens — dit betekent dat alles wat je met alle andere elementen kunt doen, ook met een relatie kan. Gegevens worden in een graaf met elkaar in verband gebracht om een verzameling knooppunten en randen op te slaan, waarbij de randen de relatie tussen knooppunten vertegenwoordigen.
Relaties zorgen ervoor dat data binnen het systeem direct aan elkaar gekoppeld kan worden. Relaties bevragen in een graphdatabase gaat snel, omdat ze op een manier worden opgeslagen die niet verandert. Je kunt ze ook visualiseren, wat ze ideaal maakt om inzichten te halen uit sterk onderling verbonden data.
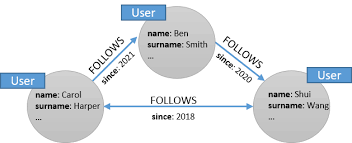
Een weergave van relaties in een socialenetwerkgraf-database
Je vraagt je misschien nog af hoe een graphdatabase verschilt van een relationele. Beide slaan informatie op en worden gebruikt om relaties tussen data weer te geven, maar de manier waarop ze dat doel bereiken verschilt.
We splitsen de verschillen tussen hen op in vijf categorieën:
Laten we dieper ingaan op de verschillen.
Relationele databases gebruiken datatabellen om informatie te structureren in rijen en kolommen. Elke kolom definieert een specifiek kenmerk van de data-entiteit, terwijl de rijen een individueel gegeven record vertegenwoordigen. Omdat datatabellen een vast schema hebben, moeten gebruikers de relaties tussen verschillende tabellen definiëren met primaire en vreemde sleutels.
Daarentegen structureert een graphdatabase data met een graafstructuur waarin knooppunten, randen en eigenschappen worden gebruikt om data weer te geven. Knooppunten definiëren de objecten, randen illustreren de relaties tussen knooppunten en eigenschappen beschrijven de kenmerken van de knooppunten en randen. Meer hierover verderop.
Relationele databases benutten de kracht van SQL om data te manipuleren. SQL stelt ontwikkelaars in staat allerlei queries uit te voeren en gaat effectief om met gestructureerde data met duidelijk gedefinieerde relaties tussen tabellen. Het blinkt met name uit in filteren, aggregeren en joinen van data over meerdere tabellen.
Graphdatabases gebruiken traversal-algoritmen om het graafdatamodel te bevragen. Traversal-algoritmen kunnen depth-first of breadth-first zijn, wat helpt om verbonden data snel te ontdekken en op te halen.
Hoewel het mogelijk is een relationele database horizontaal te schalen (bijv. met sharding), verhoogt dat de complexiteit van gegevensopslag aanzienlijk en kan het leiden tot extra problemen zoals consistentie. De aanbevolen manier om een relationele database te schalen is verticaal. Verticale schaalvergroting betekent dat de hardware wordt geüpgraded (bijv. CPU, opslag, geheugen, enz.) om de werkbelasting die een server aankan te vergroten.
Graphdatabases daarentegen doen het uitstekend in horizontaal schalen. Ze bereiken dit met partitionering, een techniek die opgeslagen databaseobjecten opdeelt in afzonderlijke delen op verschillende servers. Deze partities stellen veel servers in staat om graafqueries parallel te verwerken.
Graphdatabases gebruiken doorgaans indexvrije nabijheid. Dit betekent dat elk knooppunt zijn naburige knooppunten direct verwijst. Toegang tot relaties en gerelateerde data bestaat dus simpelweg uit geheugenpointer-lookups. Dit betekent in de praktijk dat het snel is.
Relationele databases moeten verschillende tabellen scannen om relaties tussen entiteiten te identificeren. Als je bijvoorbeeld meerdere tabellen wilt joinen, moet het databasesysteem de volledige data scannen om de relaties te vinden. Dat betekent dat de prestaties afnemen naarmate de data groeit.
Relaties staan centraal in graphdatabases. Dit maakt ze extreem gemakkelijk om mee te werken bij verbonden data, vooral bij het uitvoeren van multi-hop-queries – queries die paden met meerdere relaties doorlopen. In een relationele database moet dit met SQL. Een multi-hop-query in SQL schrijven voelt niet natuurlijk aan. Ze kunnen behoorlijk complex worden en al snel leiden tot omvangrijke queries die lastig te lezen en te onderhouden zijn.
De focus op relaties maakt graphdatabases zeer geschikt voor taken die vaak dynamische veranderingen en aanpassingen kennen. Dergelijke taken omvatten semantisch zoeken en aanbevelingssystemen. Daarentegen maakt de starheid van relationele databases ze ideaal voor gestructureerde data die goed in tabellen past. Voorbeelden zijn klantgegevens en transacties.
|
Graphdatabase |
Relationele database |
|
|
Datamodel / Schema |
Vast |
Flexibel |
|
Operaties |
Traversal-algoritmen |
SQL |
|
Schaalbaarheid |
Horizontaal met partitionering |
Verticaal (horizontaal kan, maar verhoogt de complexiteit). |
|
Prestaties |
Snel (ook bij grote datasets) |
Langzamer naarmate de dataset groter wordt |
|
Gebruiksgemak |
Intuïtief |
Onnatuurlijk (maar in veel use-cases wel veel volwassener en populairder). |
|
Toepassing |
Taken met frequente dynamische veranderingen en aanpassingen (bijv. semantisch zoeken, aanbevelingssystemen, etc.). |
Taken die afhankelijk zijn van dataintegriteit (bijv. klantgegevens, transacties, etc.). |
Zoals eerder vermeld, stellen graphdatabases gebruikers in staat data als een graaf weer te geven. De drie essentiële componenten om data in dit formaat te modelleren zijn knooppunten, randen en eigenschappen.
Objecten of instanties worden weergegeven met een knooppunt. Conceptueel zijn knooppunten het equivalent van een rij in een relationele database en fungeren ze als een vertex binnen een graaf. Groeperen van een knooppunt gebeurt eenvoudig door een label op elk lid toe te passen.
Een andere benaming voor de randen in een graaf is relaties. Relaties bestaan altijd uit een startknooppunt, eindknooppunt, type en richting. Ze vormen de dataptronen door ouder-kindrelaties, acties, eigendom en dergelijke te beschrijven.
Heel eenvoudig: eigenschappen zijn de informatie die aan knooppunten is gekoppeld.
Laten we enkele van de populairste graphdatabases bekijken die vandaag de dag beschikbaar zijn, zodat we begrijpen wat hun belangrijkste kenmerken zijn.
Enkele populaire graphdatabases
Neo4j is een van ’s werelds toonaangevende graphdatabases waarmee gebruikers diepgaand, eenvoudig en snel patronen en inzichten kunnen ontdekken over miljarden dataverbindingen. Neo4j is namelijk een zeer schaalbare NoSQL open-sourcedatabase ontwikkeld in Java. Bekijk onze cursus NoSQL-concepten om meer te leren.
Belangrijke functies zijn onder andere:
Applicaties die werken met sterk verbonden data kunnen snel en eenvoudig worden ontwikkeld en uitgevoerd met Amazon Neptune, een snelle, betrouwbare en volledig beheerde graphdatabaseservice. Een doelgebouwd, high-performance graphdatabase-engine vormt de basis van Neptune. Deze engine is ontworpen om de graaf te bevragen met millisecondenlatentie, terwijl miljarden relaties worden onderhouden.
Belangrijke functies zijn onder andere:
Twee andere populaire opties zijn ArangoDB en OrientDB.
ArangoDB is een gratis, open-source, NoSQL graphdatabasesysteem. Het ondersteunt drie datamodellen (graaf, JSON-documenten en key/value), wat betekent dat het multi-model is, met één databasekern en een uniforme querytaal: ArangoDB Query Language (AQL). De tool is in hoofdzaak een querytaal en maakt het mogelijk om verschillende data-toegangspatronen in één query te combineren.
OrientDB is een open-source NoSQL-databasemanagementsysteem geschreven in Java. Net als ArangoDB is OrientDB ook een multi-modeldatabase die graaf-, JSON-document-, key/value- en objectmodellen ondersteunt; relaties worden echter beheerd zoals in graphdatabases (d.w.z. directe verbindingen tussen records). De tool heeft een robuust beveiligingsprofilesysteem op basis van gebruikers en rollen en ondersteunt queries met Gremlin naast SQL, uitgebreid voor graaftraversal.
Onze gids over NoSQL-databases verkent meer redenen waarom ze zo nuttig zijn voor data science.
Sociale medianetwerken laten zich van nature weergeven met het graafdatamodel. Het gebruik van een graphdatabase vereenvoudigt het vastleggen van relaties, omdat de data niet heen en weer hoeft te worden omgezet van graaf naar tabel. Het graafdatamodel kan direct worden gebruikt om zaken als gebruikers en hun relaties weer te geven.
Relaties tussen informatiecategorieën zoals vrienden in een netwerk, klantinteresse en aankoopgeschiedenis kunnen worden opgeslagen in een graphdatabase. Productaanbevelingen kunnen vervolgens aan een gebruiker worden gedaan op basis van producten die zijn gekocht door andere gebruikers met vergelijkbare interesses of aankoopgeschiedenissen. In het scenario van vrienden in een netwerk kun je met de graphdatabase gebruikers met gemeenschappelijke vrienden vinden die nog niet verbonden zijn en hen aan elkaar aanbevelen.
Graphdatabases kunnen worden gebruikt om relaties tussen transacties, personen en andere relevante informatie op te slaan, zodat gebruikers gemeenschappelijke patronen kunnen vinden en applicaties kunnen bouwen die frauduleuze activiteiten detecteren. Zo kun je eenvoudig relatiepatronen ontdekken die op fraude duiden, zoals meerdere personen die aan één e-mailadres zijn gekoppeld of meerdere mensen die hetzelfde IP-adres delen maar op verschillende fysieke adressen wonen.
In deze gids heb je geleerd dat graphdatabases gespecialiseerde, doelgerichte platforms zijn om data van associatieve en contextuele aard te creëren en te manipuleren. Je hebt ook gezien dat, ondanks de duidelijke taak van het opslaan van data en het weergeven van relaties, relationele en graphdatabases sterk verschillen in hoe ze dat doel bereiken. Relationele databases gebruiken bijvoorbeeld SQL voor hun operaties, terwijl graphdatabases traversal-algoritmen gebruiken, die ze veel sneller maken, zelfs bij grote datasets, en beter geschikt voor data met veel onderlinge verbondenheid.
Leer meer over databases met deze resources:
Begin vandaag nog met je database-reis!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

