

Corso
Introduzione ai database relazionali in SQL
4 ore
201.4K
Pratica and corso your progress.
Continua Con GoogleUn database a grafo è una piattaforma specializzata e con uno scopo ben definito, usata per creare e manipolare dati di natura associativa e contestuale. Il grafo contiene nodi, archi e proprietà che, combinati, permettono di rappresentare e archiviare i dati in un modo che i database relazionali non sono pensati per gestire.
Il concetto principale in un sistema di database a grafo è la relazione. Le relazioni sono considerate entità di prima classe: significa che tutto ciò che puoi fare con gli altri elementi puoi farlo anche con una relazione. I dati sono collegati tra loro in un grafo per archiviare una collezione di nodi e archi, dove gli archi rappresentano la relazione tra i nodi.
Le relazioni consentono di collegare direttamente i dati all’interno del sistema. Interrogarle in un database a grafo è veloce, poiché sono archiviate in un modo che non cambia. Puoi anche visualizzarle, il che le rende ideali per ricavare insight da dati fortemente interconnessi.
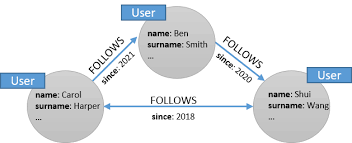
Una rappresentazione delle relazioni in un database a grafo per social network
Potresti ancora chiederti in cosa un database a grafo differisca da uno relazionale. Entrambi archiviano informazioni e rappresentano relazioni tra dati, ma lo fanno in modi diversi.
Divideremo le differenze in cinque categorie:
Vediamo più nel dettaglio come differiscono.
I database relazionali usano tabelle per strutturare le informazioni in righe e colonne. Ogni colonna definisce un attributo specifico dell’entità dati, mentre le righe rappresentano singoli record. Poiché le tabelle hanno uno schema fisso, gli utenti devono definire le relazioni tra tabelle diverse usando chiavi primarie e chiavi esterne.
Al contrario, un database a grafo struttura i dati usando una struttura a grafo in cui nodi, archi e proprietà rappresentano i dati. In particolare, i nodi definiscono gli oggetti, gli archi illustrano le relazioni tra nodi e le proprietà descrivono gli attributi di nodi e archi. Ne parleremo più avanti.
I database relazionali sfruttano la potenza di SQL per manipolare i dati. SQL consente agli sviluppatori di eseguire varie query e gestisce in modo efficace dati strutturati con relazioni ben definite tra tabelle. Eccelle in particolare nel filtrare, aggregare e unire dati tra più tabelle.
I database a grafo usano algoritmi di attraversamento per interrogare il modello a grafo. Gli algoritmi di attraversamento possono essere depth-first o breadth-first, aiutando a scoprire e recuperare rapidamente i dati connessi.
Sebbene sia possibile scalare orizzontalmente un database relazionale (ad es. tramite sharding), ciò aumenta notevolmente la complessità dell’archiviazione e può introdurre problemi come la consistenza. Il modo consigliato di scalare un database relazionale è in verticale. La scalabilità verticale consiste nell’aggiornare l’hardware (ad es. CPU, storage, memoria, ecc.) per aumentare il carico gestibile da un server.
I database a grafo, invece, si prestano molto bene alla scalabilità orizzontale. Raggiungono questo obiettivo tramite il partitioning, una tecnica che divide gli oggetti del database in parti separate su server diversi. Queste partizioni consentono a molti server di elaborare in parallelo le query sul grafo.
I database a grafo in genere utilizzano l’adjacency senza indice. Ciò significa che ogni nodo fa riferimento direttamente ai nodi vicini. L’accesso alle relazioni e ai dati correlati si riduce quindi a un lookup puntuale in memoria. In sostanza: è veloce.
I database relazionali devono eseguire scansioni di tabelle diverse per identificare le relazioni tra entità. Ad esempio, se vuoi unire più tabelle, il sistema deve scansionare l’intero dataset per trovare le relazioni. Man mano che i dati crescono, le prestazioni diminuiscono.
Le relazioni sono centrali nei database a grafo. Questo li rende estremamente semplici da usare con dati connessi, soprattutto per eseguire query multi-hop – query che attraversano percorsi con più relazioni. In un database relazionale, ciò va fatto con SQL. Scrivere una query multi-hop in SQL non è naturale: può diventare piuttosto complesso e portare facilmente a query mastodontiche difficili da leggere e mantenere.
L’attenzione alle relazioni rende i database a grafo adatti a compiti soggetti a cambiamenti dinamici e continui adattamenti. Tali compiti includono la ricerca semantica e i motori di raccomandazione. Al contrario, la rigidità dei database relazionali li rende ideali per dati strutturati che si adattano bene alle tabelle. Esempi tipici sono i dati dei clienti e le transazioni.
|
Database a grafo |
Database relazionale |
|
|
Modello dati / Schema |
Fisso |
Flessibile |
|
Operazioni |
Algoritmi di attraversamento |
SQL |
|
Scalabilità |
Orizzontale tramite partitioning |
Verticale (possibile anche orizzontale ma con maggiore complessità). |
|
Prestazioni |
Veloci (anche con dataset di grandi dimensioni) |
Più lente all’aumentare del dataset |
|
Facilità d’uso |
Intuitiva |
Poco naturale (ma molto più matura e diffusa in molti casi d’uso). |
|
Applicazione |
Attività soggette a cambiamenti dinamici e adattamenti (ad es. ricerca semantica, motori di raccomandazione, ecc.). |
Attività che dipendono dall’integrità dei dati (ad es. dati dei clienti, transazioni, ecc.). |
Come detto, i database a grafo consentono di rappresentare i dati come un grafo. I tre componenti essenziali per modellare i dati in questo formato sono nodi, archi e proprietà.
Gli oggetti o le istanze sono rappresentati da un nodo. Concettualmente, i nodi equivalgono a una riga in un database relazionale e agiscono come vertici all’interno di un grafo. Raggruppare i nodi si ottiene applicando un’etichetta a ciascun membro.
Un altro modo per chiamare gli archi in un grafo è relazioni. Le relazioni comprendono sempre un nodo iniziale, un nodo finale, un tipo e una direzione. Formano i pattern di dati descrivendo rapporti padre-figlio, azioni, proprietà e simili.
In poche parole, le proprietà sono le informazioni associate ai nodi.
Vediamo alcuni dei database a grafo più popolari oggi disponibili, per capire quali sono le loro caratteristiche chiave.
Alcuni database a grafo popolari
Neo4j è uno dei database a grafo leader al mondo, che consente agli utenti di scoprire in modo profondo, semplice e rapido pattern e insight attraverso miliardi di connessioni tra dati. In particolare, Neo4j è un database NoSQL open source altamente scalabile, sviluppato in Java. Dai un’occhiata al nostro corso sui concetti NoSQL per saperne di più.
Le caratteristiche principali includono:
Applicazioni che lavorano con dati densamente connessi possono essere sviluppate ed eseguite rapidamente e facilmente usando Amazon Neptune, un servizio di database a grafo veloce, affidabile e completamente gestito. Neptune si basa su un motore di database a grafo ad alte prestazioni, progettato per interrogare il grafo con latenze nell’ordine dei millisecondi mantenendo miliardi di relazioni.
Le caratteristiche principali includono:
Altre due opzioni popolari sono ArangoDB e OrientDB.
ArangoDB è un sistema di database a grafo NoSQL gratuito e open source. Supporta tre modelli di dati (grafi, documenti JSON e key/value), quindi è multi-modello, con un core di database unico e un linguaggio di query unificato, ArangoDB Query Language (AQL). Lo strumento è principalmente un linguaggio di query e consente di combinare vari pattern di accesso ai dati in un’unica query.
OrientDB è un sistema di gestione di database NoSQL open source scritto in Java. Come ArangoDB, è un database multi-modello che supporta grafi, documenti JSON, key/value e modelli a oggetti; tuttavia, le relazioni sono gestite come nei database a grafo (cioè, connessioni dirette tra record). Lo strumento dispone di un solido sistema di profilazione della sicurezza basato su utenti e ruoli e supporta query con Gremlin insieme a SQL esteso per l’attraversamento dei grafi.
La nostra guida sui database NoSQL approfondisce perché sono così utili per la data science.
I social network si rappresentano naturalmente con il modello dati a grafo. Sfruttare un database a grafo semplifica l’acquisizione delle relazioni, poiché i dati non devono essere continuamente convertiti da grafo a tabella e viceversa. Il modello a grafo può essere usato direttamente per rappresentare elementi come gli utenti e le loro relazioni.
Relazioni tra categorie di informazione come amici in una rete, interessi dei clienti e cronologia degli acquisti possono essere archiviate in un database a grafo. Si possono quindi fare raccomandazioni a un utente in base ai prodotti acquistati da altri utenti con interessi o storici simili. Nel caso degli amici in rete, puoi usare il database a grafo per scoprire utenti con amici in comune che non sono ancora connessi e suggerirli a vicenda.
I database a grafo possono archiviare relazioni tra transazioni, persone e altre informazioni pertinenti per individuare pattern comuni e creare applicazioni in grado di rilevare attività fraudolente. Ad esempio, possono aiutare a scoprire facilmente schemi relazionali indicativi di frode, come più individui associati allo stesso indirizzo email o più persone che condividono lo stesso indirizzo IP ma risiedono in indirizzi fisici diversi.
In questa guida hai visto che i database a grafo sono piattaforme specializzate e con uno scopo specifico, usate per creare e manipolare dati di natura associativa e contestuale. Hai anche visto che, pur condividendo l’obiettivo di archiviare dati e rappresentare relazioni, i database relazionali e quelli a grafo differiscono notevolmente nel modo in cui lo raggiungono. Ad esempio, i database relazionali usano SQL per le operazioni, mentre i database a grafo usano algoritmi di attraversamento, che li rendono molto più veloci, anche con dataset di grandi dimensioni, e più adatti a dati con un alto grado di interconnessione.
Approfondisci i database con queste risorse:
Inizia oggi il tuo percorso nei database!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



