
Kurs
Einführung in relationale Datenbanken in SQL
4 Std.
198.5K
Eine Graphdatenbank ist eine spezialisierte Plattform für einen einzigen Zweck: Daten mit starkem Beziehungs- und Kontextbezug zu erstellen und zu verarbeiten. Der Graph selbst besteht aus Knoten, Kanten und Eigenschaften, die zusammen ermöglichen, Daten so abzubilden und zu speichern, wie es relationale Datenbanken nicht leisten können.
Der Kern einer Graphdatenbank sind Beziehungen. Beziehungen sind Objekte erster Klasse — alles, was mit anderen Elementen möglich ist, geht auch mit einer Beziehung. Daten werden in einem Graphen verknüpft, der aus Knoten und Kanten besteht; die Kanten repräsentieren dabei die Beziehungen zwischen den Knoten.
Beziehungen verknüpfen Daten im System direkt miteinander. Das Abfragen von Beziehungen in einer Graphdatenbank ist schnell, weil sie in stabiler Form gespeichert sind. Zudem lassen sie sich visualisieren — ideal, um aus stark vernetzten Daten Erkenntnisse zu gewinnen.
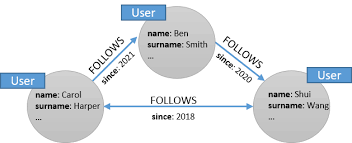
Darstellung von Beziehungen in einer sozialen Netzwerk-Graphdatenbank
Du fragst dich vielleicht, wie sich eine Graphdatenbank von einer relationalen unterscheidet. Beide speichern Informationen und bilden Beziehungen zwischen Daten ab, doch sie erreichen dieses Ziel auf unterschiedliche Weise.
Wir gliedern die Unterschiede in sechs Kategorien:
Schauen wir genauer hin.
Relationale Datenbanken strukturieren Informationen in Tabellen mit Zeilen und Spalten. Jede Spalte definiert ein bestimmtes Attribut der Datenentität, die Zeilen stehen für einzelne Datensätze. Da Tabellen ein festes Schema haben, müssen Beziehungen zwischen verschiedenen Tabellen über Primär- und Fremdschlüssel definiert werden.
Eine Graphdatenbank hingegen nutzt eine Graphstruktur, in der Knoten, Kanten und Eigenschaften Daten repräsentieren. Knoten stehen für Objekte, Kanten veranschaulichen die Beziehungen zwischen Knoten, und Eigenschaften beschreiben die Attribute von Knoten und Kanten. Mehr dazu weiter unten.
Relationale Datenbanken nutzen die Stärke von SQL zur Datenmanipulation. SQL ermöglicht vielfältige Abfragen und ist stark bei strukturierten Daten mit klar definierten Beziehungen zwischen Tabellen — insbesondere beim Filtern, Aggregieren und Joinen über mehrere Tabellen.
Graphdatenbanken verwenden Traversierungsalgorithmen, um das Graphdatenmodell abzufragen. Diese können tiefen- oder breitensuchbasiert sein und helfen, verbundene Daten schnell zu finden und abzurufen.
Eine relationale Datenbank lässt sich zwar horizontal skalieren (z. B. per Sharding), doch das erhöht die Komplexität der Datenspeicherung deutlich und kann Konsistenzprobleme nach sich ziehen. Empfehlenswert ist vertikale Skalierung — also Hardware aufrüsten (CPU, Speicher, RAM usw.), um mehr Last pro Server zu bewältigen.
Graphdatenbanken hingegen skalieren sehr gut horizontal. Sie nutzen dafür Partitionierung: Datenbankobjekte werden über mehrere Server verteilt, sodass viele Server Graphabfragen parallel verarbeiten können.
Graphdatenbanken setzen typischerweise auf indexfreie Adjazenz. Jeder Knoten verweist direkt auf seine Nachbarknoten. Das Zugreifen auf Beziehungen und verknüpfte Daten ist damit im Wesentlichen ein Speicherzeiger-Lookup — also sehr schnell.
Relationale Datenbanken müssen Tabellen scannen, um Beziehungen zwischen Entitäten zu identifizieren. Bei Joins über mehrere Tabellen muss das System große Datenmengen durchsuchen. Je größer die Daten, desto geringer die Performance.
In Graphdatenbanken stehen Beziehungen im Zentrum. Das macht sie für verbundene Daten besonders angenehm, vor allem bei Multi-Hop-Abfragen – also Pfadverfolgungen über mehrere Beziehungen. In relationalen Datenbanken muss das mit SQL umgesetzt werden. Multi-Hop-Abfragen in SQL sind nicht intuitiv, werden schnell komplex und führen leicht zu umfangreichen, schwer wartbaren Abfragen.
Der Fokus auf Beziehungen prädestiniert Graphdatenbanken für Aufgaben mit häufigen dynamischen Änderungen und Anpassungen, etwa semantische Suche und Empfehlungssysteme. Relationale Datenbanken sind durch ihre Strenge ideal für strukturierte Daten, die sich gut in Tabellen abbilden lassen, etwa Kundendaten und Transaktionen.
|
Graphdatenbank |
Relationale Datenbank |
|
|
Datenmodell / Schema |
Flexibel |
Fest |
|
Operationen |
Traversierungsalgorithmen |
SQL |
|
Skalierbarkeit |
Horizontal per Partitionierung |
Vertikal (horizontal möglich, aber komplex) |
|
Performance |
Schnell (auch bei großen Datensätzen) |
Wird langsamer mit wachsendem Datensatz |
|
Benutzerfreundlichkeit |
Intuitiv |
Weniger natürlich (dafür reif und weit verbreitet) |
|
Anwendung |
Aufgaben mit dynamischen Änderungen und Anpassungen (z. B. semantische Suche, Empfehlungssysteme) |
Aufgaben mit hohen Anforderungen an Datenintegrität (z. B. Kundendaten, Transaktionen) |
Wie beschrieben bilden Graphdatenbanken Daten als Graph ab. Die drei zentralen Bausteine sind Knoten, Kanten und Eigenschaften.
Objekte oder Instanzen werden als Knoten dargestellt. Konzeptionell entsprechen Knoten einer Zeile in einer relationalen Datenbank und fungieren im Graphen als Eckpunkte. Eine Gruppe von Knoten lässt sich über Labels kennzeichnen.
Kanten werden auch Beziehungen genannt. Sie bestehen immer aus Startknoten, Endknoten, Typ und Richtung. Sie bilden Datenmuster ab, etwa Eltern-Kind-Beziehungen, Aktionen oder Besitz.
Eigenschaften sind schlicht die den Knoten und Kanten zugeordneten Informationen.
Werfen wir einen Blick auf einige der beliebtesten Graphdatenbanken und ihre wichtigsten Funktionen.
Beliebte Graphdatenbanken
Neo4j ist eine der führenden Graphdatenbanken weltweit und hilft, Muster und Insights in Milliarden von Datenverbindungen tiefgehend, einfach und schnell zu entdecken. Neo4j ist eine hoch skalierbare NoSQL-Open-Source-Datenbank, entwickelt in Java. Sieh dir unseren NoSQL-Konzepte-Kurs an, um mehr zu erfahren.
Zu den wichtigsten Funktionen zählen:
Mit Amazon Neptune, einem schnellen, zuverlässigen und voll verwalteten Graphdatenbank-Service, lassen sich Anwendungen für dicht vernetzte Daten schnell entwickeln und betreiben. Grundlage ist eine speziell entwickelte, hochperformante Graphdatenbank-Engine, die Abfragen mit Millisekundenlatenz über Milliarden von Beziehungen hinweg ermöglicht.
Zu den wichtigsten Funktionen zählen:
Zwei weitere beliebte Optionen sind ArangoDB und OrientDB.
ArangoDB ist ein kostenlose, Open-Source-NoSQL-Graphdatenbanksystem. Es unterstützt drei Datenmodelle (Graphen, JSON-Dokumente und Key/Value) — also ein Multimodell-Ansatz mit einem gemeinsamen Datenbankkern und einer einheitlichen Abfragesprache, der ArangoDB Query Language (AQL). Das Tool fokussiert sich auf die Abfragesprache und erlaubt, verschiedene Datenzugriffsmuster in einer einzigen Abfrage zu kombinieren.
OrientDB ist ein Open-Source-NoSQL-Datenbankmanagementsystem in Java. Wie ArangoDB ist auch OrientDB eine Multimodell-Datenbank für Graphen, JSON-Dokumente, Key/Value und Objektmodelle; Beziehungen werden wie in Graphdatenbanken als direkte Verknüpfungen zwischen Datensätzen verwaltet. Das Tool bietet ein robustes Sicherheits- und Rollenmodell und unterstützt Abfragen mit Gremlin sowie SQL, erweitert um Graphtraversierung.
Unser Guide zu NoSQL-Datenbanken zeigt weitere Gründe, warum sie für Data Science so hilfreich sind.
Soziale Netzwerke lassen sich natürlich mit dem Graphdatenmodell abbilden. Mit einer Graphdatenbank ist es einfacher, Beziehungen zu erfassen, da die Daten nicht zwischen Graph und Tabelle hin- und herkonvertiert werden müssen. Nutzer und ihre Beziehungen können direkt im Graphen dargestellt werden.
Beziehungen zwischen Informationskategorien wie Freundschaften im Netzwerk, Kundeninteressen und Kaufhistorien lassen sich in einer Graphdatenbank speichern. Produktempfehlungen können dann auf Basis von Käufen anderer Nutzer mit ähnlichen Interessen oder Historien ausgesprochen werden. Im Freundesnetzwerk lassen sich Nutzer mit gemeinsamen Freunden finden, die noch nicht verbunden sind — und einander empfehlen.
Graphdatenbanken können Beziehungen zwischen Transaktionen, Personen und weiteren relevanten Informationen speichern, um gemeinsame Muster zu finden und Anwendungen zur Erkennung betrügerischer Aktivitäten zu bauen. So lassen sich etwa typische Betrugsmuster identifizieren, z. B. mehrere Personen mit derselben E-Mail-Adresse oder gemeinsame IP-Adressen bei unterschiedlichen Wohnadressen.
In diesem Guide hast du gelernt: Graphdatenbanken sind spezialisierte Plattformen für Daten mit starkem Beziehungs- und Kontextbezug. Und obwohl sowohl relationale als auch Graphdatenbanken Daten speichern und Beziehungen abbilden, unterscheiden sie sich deutlich in der Umsetzung. Relationale Datenbanken setzen für Operationen auf SQL, während Graphdatenbanken Traversierungsalgorithmen nutzen — was sie, selbst bei großen Datensätzen, oft deutlich schneller macht und sie für stark vernetzte Daten prädestiniert.
Lerne mehr über Datenbanken mit diesen Ressourcen:
Starte heute deine Datenbank-Reise!
Kurs
Kurs
Kurs