Snowflake 是一款基于云的数据平台,革新了数据存储与分析。大多数云平台会在同一组资源上同时执行分析计算和与存储相关的任务(如数据传输),而 Snowflake 独特的架构将计算负载与存储负载分离。随着数据量日益增长,Snowflake 根据组织需求进行适配的能力在当今数据经济中愈发重要。
本文将从零开始介绍 Snowflake。您无需具备数据库或云计算的任何基础知识即可阅读。我们将解释 Snowflake 是什么、它的与众不同之处、它的使用场景,以及如何马上上手。如果您想要更动手实践的方式,欢迎查看我们的Snowflake 基础技能路径。
什么是 Snowflake?
传统的本地部署数据库会将所有存储空间、计算能力和网络设备都放在公司的机房内(on-prem)。
Snowflake 是原生云的数据平台,使企业能够在大规模下存储、管理、分析和共享数据。Snowflake 完全运行在云端,并在一个平台中提供强大的数据仓库、数据湖、商业智能和机器学习工具。
此外,它让跨团队的数据共享变得简单。数据工程师和数据分析师通常使用一种名为 SQL 的编程语言来分别进行数据转换和数据分析。由于 Snowflake 基于 SQL 运行,这两类人员能更轻松地就数据需求进行沟通。
它还能与其他云服务商出色集成,并常因其有助于提升数据处理效率的独特架构而被选用。
云端集成
Snowflake 本身是一个完整的数据云环境,但这并不意味着用户会被完全锁定在其生态中。它可与三大云平台集成:
- Amazon Web Services (AWS)
- Microsoft Azure
- Google Cloud Platform (GCP)
这些集成让 Snowflake 用户能够轻松地在 Snowflake 与其现有云平台之间共享数据,反之亦然。这使组织能够以最小的开发工作量,在其已使用的云环境中灵活部署 Snowflake。
独特架构
Snowflake 主要分为三层:服务层、计算层和存储层。服务层是通用层,承载所有云端功能,如安全、访问与基础设施。Snowflake 的巧妙之处在于它将计算层与存储层分离。
大多数情况下,CPU 和内存等计算资源会同时用于计算与存储数据。Snowflake 将两者分离带来了多项出色的优势,使其更易扩展且更高效。它通过“虚拟仓库”的概念实现这一点:每位使用 Snowflake 的用户都拥有一套不与他人共享的虚拟资源。
例如,共享数据变得容易,因为您可以为数据传输和复制分配更多资源。因此,与其让公司所有人都从同一份数据副本中读取,Snowflake 会为每个人创建临时副本。
同样地,由于不再将宝贵资源花在数据存储与复制上,您可以获得更多 CPU 用于分析和数据处理。只要您的虚拟仓库规模足以应对计算需求,这意味着 SQL 查询和分析管道等任务都会运行得更快。
以下是优势总结:
- 存储:您的数据位于中央存储库。对数据的所有访问操作(如分区或索引)由专门的存储工作节点执行。随后,Snowflake 会将用户会话所需的数据组件共享给用户。
- 计算:计算任务由虚拟仓库执行,本质上是由计算资源(CPU 与内存)构成的集群,负责分析型 SQL 任务、数据装载/卸载等。
通过将存储与计算资源分离,Snowflake 的架构带来了几大关键优势:
- 可扩展性:可轻松独立扩展计算能力与存储。需要更多存储?无需额外的 CPU 成本即可增加。需要更强处理能力?扩大您的虚拟仓库而不影响数据存储。
- 并发性:多位用户与任务可同时运行且不争抢资源,确保每个人都能获得稳定性能。
- 成本效率:按需付费。可根据负载快速扩缩资源,减少不必要的成本。
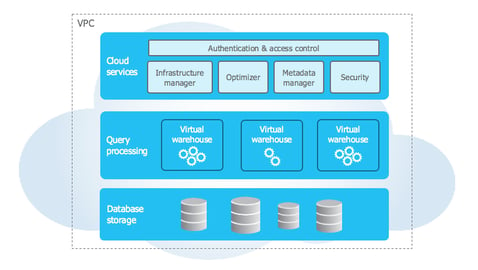
Snowflake 架构(docs.snowflake.com)
想要深入了解,请查看这篇关于Snowflake 架构的文章。
Snowflake 的关键功能
Snowflake 是一个完全托管的原生云数据平台,旨在满足现代数据团队的需求。如前所述,它在可扩展性、性能和安全性方面表现出色。凭借对 SQL 的支持和友好的用户界面,它也非常易用。
可扩展性
可扩展性是指系统在保持性能的前提下,能否良好地扩展以处理更多数据或更多用户。受益于其存储与计算分离的架构,Snowflake 在这方面尤为出色。若我需要更强的计算能力,可以把虚拟仓库做大;若需要更多存储,只需继续申请更多存储空间即可。
在传统系统中,扩容往往意味着停机或重新配置硬件。如果我想要更多计算或存储,可能需要耗时更换旧硬件、迁移数据或软件。在 Snowflake 中,这只需一次点击(或一条命令)。
示例:
- 一家小型初创公司可以先使用 X-Small 仓库来处理轻量查询和偶发报告。
- 随着数据增长,他们可以升级到 Large 或 X-Large 仓库,而无需迁移数据。传统数据服务可能要求您先将数据转移到更大的物理仓库,才能获得更强的计算能力。
- 对于高并发(同时有大量用户访问系统)的场景,Snowflake 支持多集群仓库,能自动启动额外集群来应对负载。
Snowflake 还会根据工作负载自动向上或向下扩展计算集群。这确保了:
- 高峰时段的快速查询性能。
- 空闲期的成本节省(计算资源会自动暂停)。
性能
Snowflake 针对高要求的数据工作负载进行了优化,无论是运行复杂分析、批量上传,还是实时看板,都能提供一致的速度。其高性能由以下关键技术驱动:
- 列式存储:按列而非按行存储数据,可快速获取所需数据,加速分析型查询。
- 自动查询优化:Snowflake 会自动分析并优化查询,使用越多性能越佳。
- 结果缓存:对常用查询即时返回缓存结果,降低计算时间与成本。
- 元数据管理:智能跟踪数据统计与查询模式,确保高效的查询执行。
安全性
Snowflake 将企业级安全置于首位,提供强有力的措施来保护您的数据:
- 端到端加密:AES-256 加密在静态与传输中均保护数据。
- 基于角色的访问控制(RBAC):细粒度的访问管理确保用户仅能看到其所需内容,将风险降至最低。
- 多重身份验证: 为访问 Snowflake 增加额外安全层。
- 数据脱敏与行级安全: 通过细粒度控制按角色限制敏感数据可见性。
- 合规认证:符合 HIPAA、GDPR 等行业标准。
- 时间旅行与故障安全:可恢复历史数据并在最长 90 天内找回已删除记录,防止错误或恶意行为造成损失。
易用性
Snowflake 以用户友好的设计广受好评,尤其适合熟悉 SQL 的初学者。关键易用性特性包括:
- 基于 Web 的界面:直观的 UI 简化数据库导航、查询编写与用户管理。
- 标准 SQL 兼容:无需学习新语言。Snowflake 开箱即用地支持熟悉的 SQL 语句。
- 零基础设施管理:完全托管,自动扩缩与优化,免去基础设施的搭建或维护。
- 广泛的工具集成:可与分析工具(PowerBI、Tableau)、ETL 服务(Fivetran)及语言(Python、Java)无缝连接。
- 数据市场:无需移动数据即可便捷地探索并订阅第三方数据集,增强分析能力。
Snowflake 致力于让任何从其他服务或平台的迁移尽可能简单。这里有一个很好的跟写示例,带您了解使用 Python 与 SQL 在Snowflake 中进行数据分析是多么容易。
| 功能 | 描述 | 关键收益/示例 |
|---|
| 可扩展性 | 可轻松独立扩展计算能力与存储空间。 |
- 可即时增加资源,无需停机。
- 针对高并发的自动多集群扩展。
- 在高峰与空闲时段均具成本效率的资源使用。
|
| 性能 | 为快速分析与可靠处理工作负载而优化。 |
- 列式存储加速查询。
- 自动查询优化。
- 重复查询使用缓存结果。
- 智能元数据管理。
|
| 安全性 | 强健的企业级安全保护数据完整性。 |
- AES-256 数据加密。
- 基于角色的访问控制。
- 多重身份验证。
- 数据脱敏与行级安全。
- 符合 HIPAA、GDPR 等标准。
- 通过“时间旅行”功能实现数据恢复。
|
| 易用性 | 用户友好的界面与熟悉的 SQL 兼容性。 |
- 直观的基于 Web 的 UI。
- 标准 SQL 查询,无需额外学习语言。
- 无需进行基础设施管理。
- 与工具轻松集成(PowerBI、Tableau、Fivetran、Python、Java)。
- 内置第三方数据集市场。
|
Snowflake 的用途是什么?
Snowflake 的用途广泛,从数据仓库到实时分析皆可胜任。本节将介绍 Snowflake 功能的基础。
数据仓库
数据仓库本质上是一个集中式枢纽,用于汇聚来自多种来源的结构化数据。Snowflake 之所以受欢迎,是因为它能自动处理所有技术复杂性。您无需担心服务器维护或手动优化存储,Snowflake 会替您完成。
- 自动扩缩意味着您的仓库会根据需求增长或收缩。
- 基础设施投入最小化——专注于分析数据即可。
- 无需专业技能即可获得快速查询性能。
数据湖
数据湖存放原始、未处理的数据,可以是结构化(如电子表格)、半结构化(如邮件或 JSON 文件)、或非结构化(音频或视频)。传统上,构建数据湖需要大量前期配置,而 Snowflake 通过原生支持 JSON、Parquet、ORC、Avro、XML 等多种数据格式,简化了这一过程。
- 无需外部处理或复杂的搭建。
- 将数据湖的灵活性与数据仓库的便捷性相结合,形成常说的“湖仓一体(lakehouse)”。
数据共享
跨团队甚至跨组织共享数据通常需要大量复制与导出。Snowflake 让这个过程轻而易举——您将数据保留在自己的环境中,仅需授予他人实时访问权限即可。
- 即时且安全的数据共享。
- 无需传输文件即可简化协作。
实时分析
实时分析是指在数据到达时即可处理与分析,而不是等待周期性批量装载。Snowflake 通过支持低延迟的数据摄取与流式管道来实现这一点。Snowflake 提供多种支持实时分析的工具:
- Snowpipe:无服务器的摄取服务,可在文件抵达云存储(如 S3、Azure Blob)时自动装载。
- Snowpipe Streaming:较新的功能,允许应用通过 SDK 以亚秒级延迟按行推送数据至 Snowflake。
- Streams 与 Tasks:原生功能,用于跟踪变更并自动化转换。
进一步了解让实时分析变得简单的 Snowflake 各类数据管道,请阅读这份在 Snowflake 中构建管道的新手指南。
探索 Snowflake 生态
除了提供强大的数据管道工具外,Snowflake 还拥有完整的分析生态。它提供 AI 与 ML 解决方案,并允许开发者使用熟悉的编程语言编写数据转换。
Snowflake Cortex:集成 AI 与 ML
Snowflake Cortex 是 Snowflake 内置的人工智能与机器学习(AI/ML)层。它使团队能够在数据原地构建、运行与扩展生成式 AI、预测模型与自然语言体验,无需将数据迁移至外部 AI 平台。
Snowflake 提供了可直接用简单 SQL 调用的开箱即用 AI 函数,例如使用 LLM(如 Deepseek 或 Facebook 的 Llama)对客户评价进行摘要、翻译与理解。Cortex Analyst 允许用户使用自然语言查询数据,非常适合不太熟悉 SQL 的用户。您可以直接向 Snowflake 提问,例如“上一季度的销售情况如何?”,Snowflake 会替您查询数据。
Snowflake 还提供 ML Studio,为在实时 Snowflake 数据上测试与评估机器学习模型提供了优秀的零/低代码选项。有关 Snowflake Cortex AI 的动手指南,请参考这篇介绍在 Snowflake 中进行文本处理的指南。
Snowpark:赋能开发者
Snowpark 是一个开发者框架,允许您在 Snowflake 环境中,使用诸如 Python、Java 或 Scala 等熟悉的编程语言,直接构建并运行复杂的数据逻辑。
传统上,数据工程师需要把数据从仓库中导出,再在别处处理。Snowpark 颠覆了这一模式,将逻辑带到数据所在之处,从而提升性能、安全性与成本效率。
如今,您可以在库内处理,让 Python 或 Java 原生在 Snowflake 中运行,无需单独的 Spark 会话。团队成员可以在同一平台上使用 SQL 或 Python,并在同一数据上协作。此外,相较于通过连接器把数据拉到本地编程环境,一切都在 Snowflake 中运行,降低了数据暴露风险。
如需进一步了解在 Snowflake 中运行编程语言,请阅读这篇Snowflake Snowpark 介绍。
AWS 上的 Snowflake
Snowflake 自底层即面向云端构建,其首个且最成熟的部署环境是 AWS。得益于这一早期且深入的集成,Snowflake 与关键 AWS 服务之间具有紧密的互操作性,用户可借助熟悉的 AWS 工具与基础设施构建安全、可扩展、高度自动化的数据管道。
如果您的组织已在使用 AWS,将 Snowflake 部署在 AWS 上会让数据迁移、处理与分析变得更加容易。许多服务都能与 Snowflake 无缝协作。
与 Snowflake 协同工作的关键 AWS 服务
1. Amazon S3(简单存储服务)
S3 是 AWS 的云存储系统,广泛用于存放日志、CSV、JSON、Parquet 等数据文件。这里有一篇关于Amazon S3 的文章。Snowflake 与 S3 开箱即用地集成,允许您:
- 从 S3 摄取数据:您可以使用
COPY INTO 或 Snowpipe 将 S3 存储桶中的结构化或半结构化数据装载到 Snowflake 表中。
- 将数据写入 S3:Snowflake 也允许您将数据导出或暂存到 S3,以便共享、备份或进一步处理。
- 零拷贝访问(通过外部表):Snowflake 可通过外部表直接查询 S3 中的数据,无需先复制,节省时间与存储成本。
2. AWS PrivateLink
AWS PrivateLink 是一项网络功能,可在您的 AWS 虚拟私有云(VPC)与 Snowflake 之间建立私密、安全、高带宽的连接。
若不使用 PrivateLink,您在 AWS 系统与 Snowflake 之间的流量通常会经过公共互联网。它通过以下特性确保严格的合规或时延需求:
- 您的数据保留在 AWS 网络边界内。
- 无需暴露至公共互联网。
- 有助于满足安全与监管要求,特别是在金融、医疗或政府等行业。
3. AWS Lambda、SNS 与 S3 事件通知
Snowflake 支持通过 AWS 服务触发的自动化摄取来实现事件驱动架构。其协同方式如下:
- S3 事件通知:每当文件上传至某个 S3 存储桶,AWS 都可发送通知。
- SNS(简单通知服务):这些通知可触发消息,发送到其他 AWS 服务或系统。
- AWS Lambda:这是在事件发生时运行脚本的无服务器函数。您可以用它来调用 Snowpipe(Snowflake 的持续数据装载器)。
这一工作流无需人工安排数据装载计划,即可实现近乎实时的摄取管道,非常适用于日志分析、传感器数据或应用遥测。
要进一步了解 Amazon AWS 基础设施的细节,请查看以下指南:AWS Lambda、AWS SNS,以及S3 EFS。
我也强烈推荐这门关于AWS 云与服务概念的课程,以深入理解这些组件如何协同工作。
开始使用 Snowflake
以下是开始使用 Snowflake 的一些基础步骤的简要概述。要进一步了解 Snowflake 的核心功能,请参加这门Snowflake 入门课程,涵盖在 Snowflake 中装载与探索数据的基础知识。
获取访问权限
第一步是获取访问权限。Snowflake(截至 2025 年 5 月撰写时)提供试用,可获得使用 Snowflake 功能的积分。开始非常简单:
- 在 signup.snowflake.com 注册
- 选择云服务商(AWS、Azure、GCP)
- 登录 Snowflake 界面
装载数据
您可以通过多种方式将数据装载到 Snowflake。可以在界面中拖拽并放入受支持的文件类型(Parquet、JSON、CSV 等),随后将其处理为您指定数据库与架构中的一张表;也可以使用 SQL,或使用第三方程序。
一种常见方式是将 Snowflake 连接到云存储系统(如 Amazon S3),并使用 COPY INTO 等 SQL 命令,将数据从云存储传输到您的 Snowflake 数据库。
最后,您也可以使用 Fivetran 和 Matillion 等第三方 ETL 工具在将数据存入 Snowflake 之前进行处理。这些第三方工具有助于在装载到 Snowflake 之前对数据进行清洗。有关将数据导入 Snowflake 的更多细节,请参阅这份关于Snowflake 数据摄取的指南。
运行查询
Snowflake 让您可以在其界面中轻松运行查询。首先登录您的 Snowflake 账户,然后打开一个工作表。最需要理解的一点是,Snowflake 需要您选择特定的账户角色与虚拟仓库。这是 Snowflake 架构将存储访问与计算资源分离的体现。
如果您或负责管理 Snowflake 的同事为您分配了不同的账户角色,那么每个角色可能具有不同的访问级别。也许某个角色用于在线生产数据,另一个角色用于测试。这能防止您在分析中不小心混用不同来源的数据!
每个角色会有自己的一组虚拟仓库,选择能提供您所需计算资源的仓库。简单任务也许只需要 X-Small 仓库,更大的任务则需要 Large 甚至 X-Large 仓库。
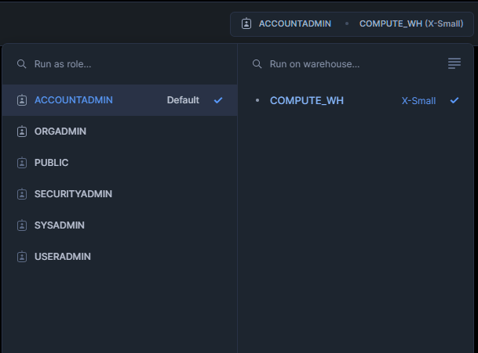
然后,选择数据库与架构,像平常一样运行 SQL。数据库是主要的存储单元,架构则是表的集合。
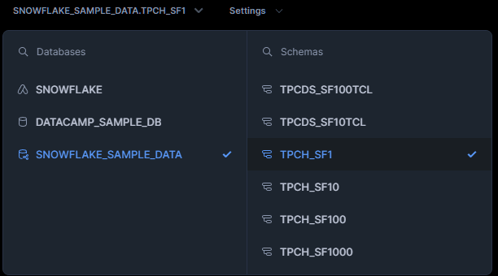
完成上述设置后,您就可以像平常一样运行 SQL 查询。例如,下面是一条示例查询:
use schema snowflake_sample_data.tpch_sf1;
SELECT
l_returnflag,
l_linestatus,
sum(l_quantity) as sum_qty,
sum(l_extendedprice) as sum_base_price,
sum(l_extendedprice * (1-l_discount))
as sum_disc_price,
sum(l_extendedprice * (1-l_discount) *
(1+l_tax)) as sum_charge,
avg(l_quantity) as avg_qty,
avg(l_extendedprice) as avg_price,
avg(l_discount) as avg_disc,
count(*) as count_order
FROM
lineitem
WHERE
l_shipdate <= dateadd(day, -90, to_date('1998-12-01'))
GROUP BY
l_returnflag,
l_linestatus
ORDER BY
l_returnflag,
l_linestatus;技术支持
如需更深入地了解 Snowflake 并学会驾驭其界面,请阅读这篇如何学习 Snowflake的文章。如果您想进一步学习 SQL,欢迎查看 Datacamp 上的众多SQL 课程。
结语
Snowflake 远不止是一个云数据仓库。它是一个强大的平台,将数据仓库、数据湖、数据共享、AI 和开发者工具融于一体。对初学者而言,这是进入数据世界最容易、最可扩展的途径之一。借助其友好的 SQL 界面、Snowpark 等开发者选项,以及通过 Cortex 提供的 AI 能力,Snowflake 使个人与组织能够充分释放数据价值。欲了解更多 Snowflake 相关信息,请参阅以下资源:

Snowflake 是一款基于云的数据平台,革新了数据存储与分析。大多数云平台会在同一组资源上同时执行分析计算和与存储相关的任务(如数据传输),而 Snowflake 独特的架构将计算负载与存储负载分离。随着数据量日益增长,Snowflake 根据组织需求进行适配的能力在当今数据经济中愈发重要。
本文将从零开始介绍 Snowflake。您无需具备数据库或云计算的任何基础知识即可阅读。我们将解释 Snowflake 是什么、它的与众不同之处、它的使用场景,以及如何马上上手。如果您想要更动手实践的方式,欢迎查看我们的Snowflake 基础技能路径。
什么是 Snowflake?
传统的本地部署数据库会将所有存储空间、计算能力和网络设备都放在公司的机房内(on-prem)。
Snowflake 是原生云的数据平台,使企业能够在大规模下存储、管理、分析和共享数据。Snowflake 完全运行在云端,并在一个平台中提供强大的数据仓库、数据湖、商业智能和机器学习工具。
此外,它让跨团队的数据共享变得简单。数据工程师和数据分析师通常使用一种名为 SQL 的编程语言来分别进行数据转换和数据分析。由于 Snowflake 基于 SQL 运行,这两类人员能更轻松地就数据需求进行沟通。
它还能与其他云服务商出色集成,并常因其有助于提升数据处理效率的独特架构而被选用。
云端集成
Snowflake 本身是一个完整的数据云环境,但这并不意味着用户会被完全锁定在其生态中。它可与三大云平台集成:
这些集成让 Snowflake 用户能够轻松地在 Snowflake 与其现有云平台之间共享数据,反之亦然。这使组织能够以最小的开发工作量,在其已使用的云环境中灵活部署 Snowflake。
独特架构
Snowflake 主要分为三层:服务层、计算层和存储层。服务层是通用层,承载所有云端功能,如安全、访问与基础设施。Snowflake 的巧妙之处在于它将计算层与存储层分离。
大多数情况下,CPU 和内存等计算资源会同时用于计算与存储数据。Snowflake 将两者分离带来了多项出色的优势,使其更易扩展且更高效。它通过“虚拟仓库”的概念实现这一点:每位使用 Snowflake 的用户都拥有一套不与他人共享的虚拟资源。
例如,共享数据变得容易,因为您可以为数据传输和复制分配更多资源。因此,与其让公司所有人都从同一份数据副本中读取,Snowflake 会为每个人创建临时副本。
同样地,由于不再将宝贵资源花在数据存储与复制上,您可以获得更多 CPU 用于分析和数据处理。只要您的虚拟仓库规模足以应对计算需求,这意味着 SQL 查询和分析管道等任务都会运行得更快。
以下是优势总结:
通过将存储与计算资源分离,Snowflake 的架构带来了几大关键优势:
Snowflake 架构(docs.snowflake.com)
想要深入了解,请查看这篇关于Snowflake 架构的文章。
Snowflake 的关键功能
Snowflake 是一个完全托管的原生云数据平台,旨在满足现代数据团队的需求。如前所述,它在可扩展性、性能和安全性方面表现出色。凭借对 SQL 的支持和友好的用户界面,它也非常易用。
可扩展性
可扩展性是指系统在保持性能的前提下,能否良好地扩展以处理更多数据或更多用户。受益于其存储与计算分离的架构,Snowflake 在这方面尤为出色。若我需要更强的计算能力,可以把虚拟仓库做大;若需要更多存储,只需继续申请更多存储空间即可。
在传统系统中,扩容往往意味着停机或重新配置硬件。如果我想要更多计算或存储,可能需要耗时更换旧硬件、迁移数据或软件。在 Snowflake 中,这只需一次点击(或一条命令)。
示例:
Snowflake 还会根据工作负载自动向上或向下扩展计算集群。这确保了:
性能
Snowflake 针对高要求的数据工作负载进行了优化,无论是运行复杂分析、批量上传,还是实时看板,都能提供一致的速度。其高性能由以下关键技术驱动:
安全性
Snowflake 将企业级安全置于首位,提供强有力的措施来保护您的数据:
易用性
Snowflake 以用户友好的设计广受好评,尤其适合熟悉 SQL 的初学者。关键易用性特性包括:
Snowflake 致力于让任何从其他服务或平台的迁移尽可能简单。这里有一个很好的跟写示例,带您了解使用 Python 与 SQL 在Snowflake 中进行数据分析是多么容易。
Snowflake 的用途是什么?
Snowflake 的用途广泛,从数据仓库到实时分析皆可胜任。本节将介绍 Snowflake 功能的基础。
数据仓库
数据仓库本质上是一个集中式枢纽,用于汇聚来自多种来源的结构化数据。Snowflake 之所以受欢迎,是因为它能自动处理所有技术复杂性。您无需担心服务器维护或手动优化存储,Snowflake 会替您完成。
数据湖
数据湖存放原始、未处理的数据,可以是结构化(如电子表格)、半结构化(如邮件或 JSON 文件)、或非结构化(音频或视频)。传统上,构建数据湖需要大量前期配置,而 Snowflake 通过原生支持 JSON、Parquet、ORC、Avro、XML 等多种数据格式,简化了这一过程。
数据共享
跨团队甚至跨组织共享数据通常需要大量复制与导出。Snowflake 让这个过程轻而易举——您将数据保留在自己的环境中,仅需授予他人实时访问权限即可。
实时分析
实时分析是指在数据到达时即可处理与分析,而不是等待周期性批量装载。Snowflake 通过支持低延迟的数据摄取与流式管道来实现这一点。Snowflake 提供多种支持实时分析的工具:
进一步了解让实时分析变得简单的 Snowflake 各类数据管道,请阅读这份在 Snowflake 中构建管道的新手指南。
探索 Snowflake 生态
除了提供强大的数据管道工具外,Snowflake 还拥有完整的分析生态。它提供 AI 与 ML 解决方案,并允许开发者使用熟悉的编程语言编写数据转换。
Snowflake Cortex:集成 AI 与 ML
Snowflake Cortex 是 Snowflake 内置的人工智能与机器学习(AI/ML)层。它使团队能够在数据原地构建、运行与扩展生成式 AI、预测模型与自然语言体验,无需将数据迁移至外部 AI 平台。
Snowflake 提供了可直接用简单 SQL 调用的开箱即用 AI 函数,例如使用 LLM(如 Deepseek 或 Facebook 的 Llama)对客户评价进行摘要、翻译与理解。Cortex Analyst 允许用户使用自然语言查询数据,非常适合不太熟悉 SQL 的用户。您可以直接向 Snowflake 提问,例如“上一季度的销售情况如何?”,Snowflake 会替您查询数据。
Snowflake 还提供 ML Studio,为在实时 Snowflake 数据上测试与评估机器学习模型提供了优秀的零/低代码选项。有关 Snowflake Cortex AI 的动手指南,请参考这篇介绍在 Snowflake 中进行文本处理的指南。
Snowpark:赋能开发者
Snowpark 是一个开发者框架,允许您在 Snowflake 环境中,使用诸如 Python、Java 或 Scala 等熟悉的编程语言,直接构建并运行复杂的数据逻辑。
传统上,数据工程师需要把数据从仓库中导出,再在别处处理。Snowpark 颠覆了这一模式,将逻辑带到数据所在之处,从而提升性能、安全性与成本效率。
如今,您可以在库内处理,让 Python 或 Java 原生在 Snowflake 中运行,无需单独的 Spark 会话。团队成员可以在同一平台上使用 SQL 或 Python,并在同一数据上协作。此外,相较于通过连接器把数据拉到本地编程环境,一切都在 Snowflake 中运行,降低了数据暴露风险。
如需进一步了解在 Snowflake 中运行编程语言,请阅读这篇Snowflake Snowpark 介绍。
AWS 上的 Snowflake
Snowflake 自底层即面向云端构建,其首个且最成熟的部署环境是 AWS。得益于这一早期且深入的集成,Snowflake 与关键 AWS 服务之间具有紧密的互操作性,用户可借助熟悉的 AWS 工具与基础设施构建安全、可扩展、高度自动化的数据管道。
如果您的组织已在使用 AWS,将 Snowflake 部署在 AWS 上会让数据迁移、处理与分析变得更加容易。许多服务都能与 Snowflake 无缝协作。
与 Snowflake 协同工作的关键 AWS 服务
1. Amazon S3(简单存储服务)
S3 是 AWS 的云存储系统,广泛用于存放日志、CSV、JSON、Parquet 等数据文件。这里有一篇关于Amazon S3 的文章。Snowflake 与 S3 开箱即用地集成,允许您:
COPY INTO或 Snowpipe 将 S3 存储桶中的结构化或半结构化数据装载到 Snowflake 表中。2. AWS PrivateLink
AWS PrivateLink 是一项网络功能,可在您的 AWS 虚拟私有云(VPC)与 Snowflake 之间建立私密、安全、高带宽的连接。
若不使用 PrivateLink,您在 AWS 系统与 Snowflake 之间的流量通常会经过公共互联网。它通过以下特性确保严格的合规或时延需求:
3. AWS Lambda、SNS 与 S3 事件通知
Snowflake 支持通过 AWS 服务触发的自动化摄取来实现事件驱动架构。其协同方式如下:
这一工作流无需人工安排数据装载计划,即可实现近乎实时的摄取管道,非常适用于日志分析、传感器数据或应用遥测。
要进一步了解 Amazon AWS 基础设施的细节,请查看以下指南:AWS Lambda、AWS SNS,以及S3 EFS。
我也强烈推荐这门关于AWS 云与服务概念的课程,以深入理解这些组件如何协同工作。
开始使用 Snowflake
以下是开始使用 Snowflake 的一些基础步骤的简要概述。要进一步了解 Snowflake 的核心功能,请参加这门Snowflake 入门课程,涵盖在 Snowflake 中装载与探索数据的基础知识。
获取访问权限
第一步是获取访问权限。Snowflake(截至 2025 年 5 月撰写时)提供试用,可获得使用 Snowflake 功能的积分。开始非常简单:
装载数据
您可以通过多种方式将数据装载到 Snowflake。可以在界面中拖拽并放入受支持的文件类型(Parquet、JSON、CSV 等),随后将其处理为您指定数据库与架构中的一张表;也可以使用 SQL,或使用第三方程序。
一种常见方式是将 Snowflake 连接到云存储系统(如 Amazon S3),并使用
COPY INTO等 SQL 命令,将数据从云存储传输到您的 Snowflake 数据库。最后,您也可以使用 Fivetran 和 Matillion 等第三方 ETL 工具在将数据存入 Snowflake 之前进行处理。这些第三方工具有助于在装载到 Snowflake 之前对数据进行清洗。有关将数据导入 Snowflake 的更多细节,请参阅这份关于Snowflake 数据摄取的指南。
运行查询
Snowflake 让您可以在其界面中轻松运行查询。首先登录您的 Snowflake 账户,然后打开一个工作表。最需要理解的一点是,Snowflake 需要您选择特定的账户角色与虚拟仓库。这是 Snowflake 架构将存储访问与计算资源分离的体现。
如果您或负责管理 Snowflake 的同事为您分配了不同的账户角色,那么每个角色可能具有不同的访问级别。也许某个角色用于在线生产数据,另一个角色用于测试。这能防止您在分析中不小心混用不同来源的数据!
每个角色会有自己的一组虚拟仓库,选择能提供您所需计算资源的仓库。简单任务也许只需要 X-Small 仓库,更大的任务则需要 Large 甚至 X-Large 仓库。
然后,选择数据库与架构,像平常一样运行 SQL。数据库是主要的存储单元,架构则是表的集合。
完成上述设置后,您就可以像平常一样运行 SQL 查询。例如,下面是一条示例查询:
如需更深入地了解 Snowflake 并学会驾驭其界面,请阅读这篇如何学习 Snowflake的文章。如果您想进一步学习 SQL,欢迎查看 Datacamp 上的众多SQL 课程。
结语
Snowflake 远不止是一个云数据仓库。它是一个强大的平台,将数据仓库、数据湖、数据共享、AI 和开发者工具融于一体。对初学者而言,这是进入数据世界最容易、最可扩展的途径之一。借助其友好的 SQL 界面、Snowpark 等开发者选项,以及通过 Cortex 提供的 AI 能力,Snowflake 使个人与组织能够充分释放数据价值。欲了解更多 Snowflake 相关信息,请参阅以下资源: