Snowflake 是一款基于云的数据平台,旨在解决现代数据管理的核心挑战。自 2014 年推出以来,它为组织提供了一个集中式的解决方案,用于存储和处理大规模数据任务。
传统数据管理系统往往存在诸多限制。企业通常需要在查询性能、并发访问能力与成本效益之间做出取舍。Snowflake 的架构通过其对数据存储与计算的处理方式,旨在消除这些约束。
本指南将剖析 Snowflake 的架构框架与运行机制。尽管该平台融合了复杂技术,本文将以通俗易懂的方式阐述这些概念,适合具备基础数据系统知识的读者阅读。
本指南将涵盖:
- Snowflake 数据存储系统的基本原理
- 构成其基础设施的架构组件
- 平台对并发数据访问的处理方式
- 推动其被广泛采用的技术优势
本分析将帮助您建立对 Snowflake 在现代数据基础设施中如何运作的基础认知。
如果您刚接触 Snowflake, Snowflake 新手入门将为您提供必要的背景知识。
Snowflake 架构的核心概念
Snowflake 的架构不同于传统的数据仓库设计,它运用现代云计算理念来解决可扩展性与性能难题。该架构采用多层式方法,将存储、计算与服务划分为彼此独立又互相连接的组件。
Snowflake 的架构分层
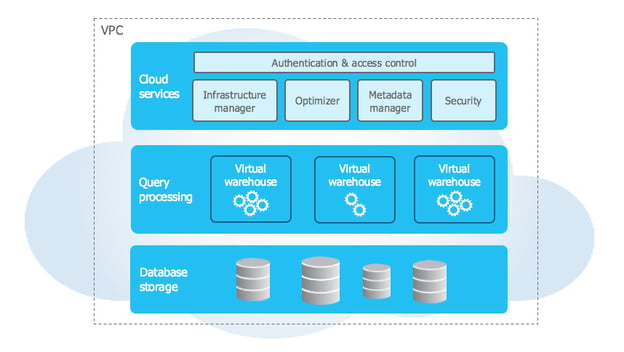
来源:Snowflake 文档
Snowflake 的架构采用独特的三层设计,在分离核心功能的同时保持无缝集成。下面分别介绍各层:
1. 存储层
Snowflake 的存储层依赖云对象存储(Amazon S3、Azure Blob Storage 或 Google Cloud Storage),并以压缩的列式格式将数据组织为不可变的微分区(50–500MB)。这些微分区会存储诸如列最小值/最大值等元数据,从而支持高效的查询裁剪。
该层具备自优化能力,无需人工维护。它会基于数据类型与模式为每一列智能选择最佳压缩算法,既确保高压缩比,也通过仅读取必要列来加速分析型查询。
2. 计算层
计算层由虚拟仓库组成——相互独立的 MPP 集群,用于执行 SQL 查询与 DML 操作。每个仓库以并行方式运行多个节点,并完全隔离,防止性能相互干扰。
这些无状态资源可随时启动、停止、调整大小或克隆,而不会影响数据。调整大小会自动重分配工作负载;自动挂起功能可在仓库空闲时暂停,并在需要时于数秒内恢复。
3. 服务层
服务层负责编排 Snowflake 的各项操作,管理分布式元数据存储,以追踪表、视图、安全策略与查询。查询优化器利用这些元数据,基于数据分布、计算资源与访问模式生成高效的执行计划。
该层通过高级并发控制确保 ACID 特性,同时通过 SSO、MFA 与基于角色的访问控制在各层面处理身份验证。它还负责会话管理与安全策略执行。
各层如何协同工作
Snowflake 各层之间的交互带来了诸如安全数据共享、多集群计算与动态可扩展性等强大能力。数据共享以元数据为驱动——仅交换指针,访问由细粒度安全策略控制。数据消费者可使用自己的计算资源查询共享数据,而无需复制。
多集群计算允许相互独立的计算集群在保持各自缓存与一致性的同时访问同一存储层。可通过为 ETL、BI 或数据科学专用仓库来隔离不同工作负载。Snowflake 的架构还支持动态扩展,使存储与计算能够彼此独立扩容,而服务层负责优化资源分配与查询性能。
若想更深入学习这些概念,您可以查阅 Snowflake 入门课程。
Snowflake 的数据仓库架构
Snowflake 的数据仓库架构基于其三层设计,提供灵活的数据建模与高效的查询处理。它既支持结构化数据,也支持半结构化数据,同时优化性能并简化管理。
数据模型
Snowflake 通过关系型数据库理念处理结构化数据,支持 SQL 数据类型、约束,以及通过主键与外键建立关系。敏感信息可受益于列级加密。对于半结构化数据,Snowflake 原生支持 JSON、XML、Parquet 与 Avro,并通过 VARIANT 数据类型进行处理,能够自动推断模式,并配合如 FLATTEN 与 PARSE_JSON 等专用函数实现高效查询。
在存储层面,数据会自动被划分为 50–500MB 的微分区,每个分区都会存储列最小/最大值、空值频率等元数据。Snowflake 会跟踪自然聚类并定期重组数据,以提升查询效率,从而无需手动管理分区。
查询处理架构
Snowflake 通过多个协同层来优化查询执行。查询优化器会将 SQL 查询转换为逻辑执行计划,并基于表规模、索引与缓存评估多种物理计划。借助成本模型,它会选择最优方案,确定连接算法、排序方法与数据移动策略。
执行引擎会将查询分发到并行处理节点。通过利用元数据,它能裁剪无关分区,并在 Snowflake 的列式存储格式中仅读取相关列,从而提升效率。24 小时结果缓存还能在底层数据未变化时复用先前的查询结果,进一步增强性能。
Snowflake 的架构支持高效的数据访问模式。零拷贝克隆可在不复制数据的情况下即时复制表;时间旅行保留历史版本,支持时间点查询。多版本并发控制(MVCC)保障事务一致性,使高并发工作负载在无锁冲突的情况下运行。这些优化结合智能缓存与分区裁剪,使 Snowflake 以最少的人工干预提供可扩展的高性能分析能力。
Snowflake 的高级功能
Snowflake 在资源管理、安全、集成与监控方面提供了高级功能,以增强企业级能力。
资源管理
其动态资源管理包括仓库调度与自动伸缩,可自动暂停空闲仓库,并根据工作负载需求调整计算资源。管理员可设置自动启停计划,并利用详尽的资源指标来优化成本与性能。
查询治理
查询治理功能对资源消耗进行精细控制,包括动态限制、智能排队与自定义查询路由,以确保高效的工作负载管理。
企业集成
在企业集成方面,Snowflake 支持使用 JavaScript 与 Java 编写存储过程,使开发者能够实现超越 SQL 的复杂业务逻辑。
版本控制便于回滚,错误处理配合详尽日志以保障平稳执行。平台的安全数据交换框架允许组织通过私有数据市场共享并变现数据集。
企业可以控制访问、跟踪使用情况并实施自动计费,在确保合规与安全的同时创造新的营收机会。
这些功能共同强化了 Snowflake 作为综合性数据平台的地位,提供可扩展性、自动化与安全性。借助智能的工作负载管理、无缝集成与完善的治理工具,组织能够优化性能、降低成本,并围绕数据资产安全协作。
架构对比
下面将 Snowflake 的架构与传统数据仓库及现代竞品进行对比,以理解其独特价值主张。
传统数据仓库
关键架构差异:
- 传统系统将存储与计算紧密耦合
- 物理数据分区需要人工维护
- 为峰值工作负载进行硬件容量规划
- 处理半结构化数据的能力有限
成本模型对比:
- 传统模式需要前期硬件投入
- 容量需预留未来增长空间
- 维护成本涵盖硬件与机房设施
- 许可费用通常按处理器核心计费
性能特征:
- 受物理硬件限制
- 并发用户扩展需要升级硬件
- 用户增多会导致查询性能下降
- 不同工作负载之间存在资源争用
现代竞品
1. Amazon Redshift
- 架构: 基于集群;需要手动 vacuum 操作;使用区域映射(zone maps)
- 成本: 基于节点的按小时计费;局限于 AWS 生态
2. Google BigQuery
- 架构: 无服务器,基于 slot 的计费;自动查询缓存(保留 24 小时)
- 成本: 按扫描字节数计费;对计算资源的控制有限
3. Azure Synapse
- 架构: 混合(无服务器与专用池);资源管理复杂;同时支持行存与列存
- 成本: 基于 DTU 或 vCore 的定价;与 Azure 服务集成
其他性能考量:
1. 查询优化
- BigQuery:自动优化,用户控制有限
- Redshift:需要手动执行 vacuum 与 analyze
- Synapse:需要更新统计信息与建立索引
2. 并发处理
- BigQuery:基于 slot 的分配机制
- Redshift:基于队列的工作负载管理
- Synapse:资源类分配
3. 存储架构
- BigQuery:列式存储并自动分片
- Redshift:基于节点的分布与切片管理
- Synapse:行存与列存可选
4. 成本结构差异
- BigQuery:按扫描字节数计费
- Redshift:基于节点的按小时计费
- Synapse:基于 DTU 或 vCore 的定价
5. 集成能力
- BigQuery:原生集成 GCP 服务
- Redshift:集成 AWS 生态
- Synapse:Azure 平台服务
这些架构差异会影响:
- 运维复杂度
- 资源管理
- 成本可预测性
- 性能优化
- 生态集成
如需系统化掌握这些概念,请参阅 全面的 Snowflake 学习指南。
以下表格对上述差异进行了汇总:
| 方面 | BigQuery | Redshift | Synapse | Snowflake |
|---|
| 架构 | 无服务器 | 基于集群 | 混合(无服务器与专用) | 多集群,共享数据 |
| 存储 | 列式且自动分片 | 基于节点的分布 | 行存与列存 | 微分区列式 |
| 查询优化 | 自动,控制有限 | 手动 vacuum/analyze | 手动建索引与统计 | 自动优化 |
| 并发性 | 基于 slot 的分配 | 基于队列的 WLM | 资源类 | 虚拟仓库伸缩 |
| 定价模型 | 按扫描字节数 | 基于节点按小时 | 基于 DTU/vCore | 按秒计费的仓库用量 |
| 集成 | GCP 原生服务 | AWS 生态 | Azure 平台 | 多云支持 |
| 资源管理 | 自动化 | 手动管理节点 | 池化管理复杂 | 自动化且可手动控制 |
| 数据类型支持 | 强大的半结构化 | 半结构化支持有限 | 半结构化支持有限 | 原生半结构化 |
| 维护 | 最低限度 | 需要定期 vacuum | 需要索引维护 | 零维护 |
| 缓存 | 24 小时自动 | 用户自管 | 内置能力有限 | 自动结果缓存 |
结论
Snowflake 通过让云中数据处理更简单、更高效,改变了企业管理数据的方式。其架构允许将数据存储与处理解耦,从而在保持高性能的同时节省成本。凭借强大的安全功能,企业能够对数据安全充满信心。该系统可在不同云服务商之间顺畅运行,为企业选择数据托管位置提供了更高的灵活性。
若您希望进一步了解 Snowflake,DataCamp 上有大量有用的资源与培训材料可供学习。
该平台正不断发展,新增的人工智能等功能使其对企业更具吸引力。采用 Snowflake 的公司能够随着数据需求的变化迅速调整。随着更多组织将其作为管理数据的主要平台,Snowflake 的前景十分可期。


Snowflake 是一款基于云的数据平台,旨在解决现代数据管理的核心挑战。自 2014 年推出以来,它为组织提供了一个集中式的解决方案,用于存储和处理大规模数据任务。
传统数据管理系统往往存在诸多限制。企业通常需要在查询性能、并发访问能力与成本效益之间做出取舍。Snowflake 的架构通过其对数据存储与计算的处理方式,旨在消除这些约束。
本指南将剖析 Snowflake 的架构框架与运行机制。尽管该平台融合了复杂技术,本文将以通俗易懂的方式阐述这些概念,适合具备基础数据系统知识的读者阅读。
本指南将涵盖:
本分析将帮助您建立对 Snowflake 在现代数据基础设施中如何运作的基础认知。
如果您刚接触 Snowflake, Snowflake 新手入门将为您提供必要的背景知识。
Snowflake 架构的核心概念
Snowflake 的架构不同于传统的数据仓库设计,它运用现代云计算理念来解决可扩展性与性能难题。该架构采用多层式方法,将存储、计算与服务划分为彼此独立又互相连接的组件。
Snowflake 的架构分层
来源:Snowflake 文档
Snowflake 的架构采用独特的三层设计,在分离核心功能的同时保持无缝集成。下面分别介绍各层:
1. 存储层
Snowflake 的存储层依赖云对象存储(Amazon S3、Azure Blob Storage 或 Google Cloud Storage),并以压缩的列式格式将数据组织为不可变的微分区(50–500MB)。这些微分区会存储诸如列最小值/最大值等元数据,从而支持高效的查询裁剪。
该层具备自优化能力,无需人工维护。它会基于数据类型与模式为每一列智能选择最佳压缩算法,既确保高压缩比,也通过仅读取必要列来加速分析型查询。
2. 计算层
计算层由虚拟仓库组成——相互独立的 MPP 集群,用于执行 SQL 查询与 DML 操作。每个仓库以并行方式运行多个节点,并完全隔离,防止性能相互干扰。
这些无状态资源可随时启动、停止、调整大小或克隆,而不会影响数据。调整大小会自动重分配工作负载;自动挂起功能可在仓库空闲时暂停,并在需要时于数秒内恢复。
3. 服务层
服务层负责编排 Snowflake 的各项操作,管理分布式元数据存储,以追踪表、视图、安全策略与查询。查询优化器利用这些元数据,基于数据分布、计算资源与访问模式生成高效的执行计划。
该层通过高级并发控制确保 ACID 特性,同时通过 SSO、MFA 与基于角色的访问控制在各层面处理身份验证。它还负责会话管理与安全策略执行。
各层如何协同工作
Snowflake 各层之间的交互带来了诸如安全数据共享、多集群计算与动态可扩展性等强大能力。数据共享以元数据为驱动——仅交换指针,访问由细粒度安全策略控制。数据消费者可使用自己的计算资源查询共享数据,而无需复制。
多集群计算允许相互独立的计算集群在保持各自缓存与一致性的同时访问同一存储层。可通过为 ETL、BI 或数据科学专用仓库来隔离不同工作负载。Snowflake 的架构还支持动态扩展,使存储与计算能够彼此独立扩容,而服务层负责优化资源分配与查询性能。
若想更深入学习这些概念,您可以查阅 Snowflake 入门课程。
Snowflake 的数据仓库架构
Snowflake 的数据仓库架构基于其三层设计,提供灵活的数据建模与高效的查询处理。它既支持结构化数据,也支持半结构化数据,同时优化性能并简化管理。
数据模型
Snowflake 通过关系型数据库理念处理结构化数据,支持 SQL 数据类型、约束,以及通过主键与外键建立关系。敏感信息可受益于列级加密。对于半结构化数据,Snowflake 原生支持 JSON、XML、Parquet 与 Avro,并通过 VARIANT 数据类型进行处理,能够自动推断模式,并配合如 FLATTEN 与 PARSE_JSON 等专用函数实现高效查询。
在存储层面,数据会自动被划分为 50–500MB 的微分区,每个分区都会存储列最小/最大值、空值频率等元数据。Snowflake 会跟踪自然聚类并定期重组数据,以提升查询效率,从而无需手动管理分区。
查询处理架构
Snowflake 通过多个协同层来优化查询执行。查询优化器会将 SQL 查询转换为逻辑执行计划,并基于表规模、索引与缓存评估多种物理计划。借助成本模型,它会选择最优方案,确定连接算法、排序方法与数据移动策略。
执行引擎会将查询分发到并行处理节点。通过利用元数据,它能裁剪无关分区,并在 Snowflake 的列式存储格式中仅读取相关列,从而提升效率。24 小时结果缓存还能在底层数据未变化时复用先前的查询结果,进一步增强性能。
Snowflake 的架构支持高效的数据访问模式。零拷贝克隆可在不复制数据的情况下即时复制表;时间旅行保留历史版本,支持时间点查询。多版本并发控制(MVCC)保障事务一致性,使高并发工作负载在无锁冲突的情况下运行。这些优化结合智能缓存与分区裁剪,使 Snowflake 以最少的人工干预提供可扩展的高性能分析能力。
Snowflake 的高级功能
Snowflake 在资源管理、安全、集成与监控方面提供了高级功能,以增强企业级能力。
资源管理
其动态资源管理包括仓库调度与自动伸缩,可自动暂停空闲仓库,并根据工作负载需求调整计算资源。管理员可设置自动启停计划,并利用详尽的资源指标来优化成本与性能。
查询治理
查询治理功能对资源消耗进行精细控制,包括动态限制、智能排队与自定义查询路由,以确保高效的工作负载管理。
企业集成
在企业集成方面,Snowflake 支持使用 JavaScript 与 Java 编写存储过程,使开发者能够实现超越 SQL 的复杂业务逻辑。
版本控制便于回滚,错误处理配合详尽日志以保障平稳执行。平台的安全数据交换框架允许组织通过私有数据市场共享并变现数据集。
企业可以控制访问、跟踪使用情况并实施自动计费,在确保合规与安全的同时创造新的营收机会。
这些功能共同强化了 Snowflake 作为综合性数据平台的地位,提供可扩展性、自动化与安全性。借助智能的工作负载管理、无缝集成与完善的治理工具,组织能够优化性能、降低成本,并围绕数据资产安全协作。
架构对比
下面将 Snowflake 的架构与传统数据仓库及现代竞品进行对比,以理解其独特价值主张。
传统数据仓库
关键架构差异:
成本模型对比:
性能特征:
现代竞品
1. Amazon Redshift
2. Google BigQuery
3. Azure Synapse
其他性能考量:
1. 查询优化
2. 并发处理
3. 存储架构
4. 成本结构差异
5. 集成能力
这些架构差异会影响:
如需系统化掌握这些概念,请参阅 全面的 Snowflake 学习指南。
以下表格对上述差异进行了汇总:
结论
Snowflake 通过让云中数据处理更简单、更高效,改变了企业管理数据的方式。其架构允许将数据存储与处理解耦,从而在保持高性能的同时节省成本。凭借强大的安全功能,企业能够对数据安全充满信心。该系统可在不同云服务商之间顺畅运行,为企业选择数据托管位置提供了更高的灵活性。
若您希望进一步了解 Snowflake,DataCamp 上有大量有用的资源与培训材料可供学习。
该平台正不断发展,新增的人工智能等功能使其对企业更具吸引力。采用 Snowflake 的公司能够随着数据需求的变化迅速调整。随着更多组织将其作为管理数据的主要平台,Snowflake 的前景十分可期。