
课程
Data Engineering 入门
4 小时
130.1K
如果您从事大数据处理,您会知道管理和分析无组织的数据文件既具有挑战性又容易出错。由于一个简单的失误(例如误执行删除命令)而丢失宝贵数据的风险始终令人担忧。
Apache Iceberg 通过提供一种健壮可靠的表格式来应对这些挑战,它支持回滚并可恢复数据的先前状态。这确保了数据的完整性与一致性,使数据管理更加高效且更不易出错。
在本教程中,我们将解释什么是 Apache Iceberg、为什么要使用它以及它如何工作。您还将通过动手实践、循序渐进的指导学习如何开始使用它,从而更高效地管理和分析您的数据。
Apache Iceberg 是一种面向开放生态的表格式,旨在高效处理海量分析型数据集。它提供高性能的表结构,将传统数据库的优势(如 SQL 查询、ACID 合规与分区)带到您的数据文件之上。
本质上,Apache Iceberg 就像一副“镜头”,让您可以将一组数据文件视作一个统一的整体表来查看和管理。
Apache Iceberg 的主要优势在于它能够以高度优化的方式处理大规模数据。它支持模式演进、隐式分区和时光回溯等特性,是管理复杂数据工作流的强大解决方案。
通过抽象底层存储格式的复杂性,Iceberg 实现了高效的数据管理与查询,是大数据处理的理想之选。
Netflix 于 2017 年开发 Apache Iceberg,以解决 Hive 的局限性,尤其是在增量处理与流式数据方面。2018 年,Netflix 将 Iceberg 捐赠给 Apache 软件基金会,使其成为开源项目。
自那以后,Apache Iceberg 成为现代数据湖架构的基石,被各行各业广泛采用。
该项目持续演进,加入了隐式分区与模式演进等特性,以满足大规模数据环境的需求。
2024 年,Databricks 宣布其收购 Tabular 的协议。Tabular 由 Apache Iceberg 的最初创建者创立,此次收购旨在统一 Apache Iceberg 与 Delta Lake,增强数据兼容性并推动向单一开放互操作标准演进。
|
年份 |
事件 |
|
2017 |
Netflix 开发 Apache Iceberg,以解决 Hive 的限制,特别是增量处理与流式数据。 |
|
2018 |
Netflix 将 Apache Iceberg 捐赠给 Apache 软件基金会,使其成为开源项目。 |
|
2019 |
Apache Iceberg 因其可扩展且高效的数据管理能力被多个行业采用。引入了模式演进与隐式分区等特性。 |
|
2020 |
社区贡献与采用持续增长,性能得到提升,并新增了时光回溯与元数据管理等功能。 |
|
2021 |
Apache Iceberg 作为数据湖首选表格式获得显著进展,并与主要大数据工具和平台集成。 |
|
2022 |
新增特性与优化,增强了 Iceberg 对复杂数据工作流与大规模数据环境的支持。 |
|
2023 |
Apache Iceberg 继续演进,重点提升与其他数据格式和系统的数据兼容性与互操作性。 |
|
2024 |
Databricks 宣布达成收购 Tabular 的协议。此次收购旨在统一 Iceberg 与 Delta Lake。 |
如前所述,Apache Iceberg 是在大规模环境中进行数据管理与分析的强大工具。
以下是 Iceberg 的更具体使用场景概览。
使用 ORC 或 Parquet 等文件格式容易实现,但直接在其上运行分析效率不高。而 Iceberg 为这些文件提供带有元数据信息的表格式,以优化查询。
例如,原始数据文件并不存储其所属表的信息,但 Iceberg 的元数据文件会存储这些信息。这使查询引擎能够决定读取哪些表、跳过哪些表,显著提升查询效率。
元数据文件会存储此类有助于高效查询的信息。查询语言会先在元数据中查找相关文件名,只获取所需文件进行快速查询,减少不必要的数据读取。
分区裁剪是一种跳过无关数据、只对必要数据执行操作的技术。
例如,如果您的分区列是“date”,并指定一个特定的日期范围,查询就只会读取该范围内的数据。这减少了从磁盘读取的数据量,使对 Iceberg 表的查询更快、更高效。
时光回溯允许您通过获取某一时刻的快照来访问旧版本的数据。
快照是在某一特定时刻的一组完整数据文件。
元数据文件会跟踪快照 ID、时间戳和历史详情,您可以通过快照的 ID 或时间戳访问每个快照。
许多流行的存储系统(如 Google Cloud、AWS 和 Microsoft Azure)都支持 Iceberg 表格式。您可以将数据文件存储在这些云平台上,并使用外部或内置目录服务指向其元数据。
目录服务配置完成后,您可以使用Apache Spark 或 Apache Flink等大数据处理框架。
Iceberg 还支持多种查询引擎,如 SQL、Trino 和 Presto,可与现有数据工作流无缝集成。
Apache Iceberg 拥有活跃的社区,并在 Twitter、Github 等多个协作平台上保持在线活跃。它还设有专门的 Slack 工作区,便于参与最新开发话题的讨论。
开源贡献者与 Iceberg 开发者通过社交平台与学习社区保持互通。这使您在实现 Iceberg 特性时遇到问题能够更容易获得解决方案。
Apache Iceberg 引入了一组支持高效数据管理与查询的核心概念。本节将对其进行回顾。
Iceberg 通过其元数据层管理表的模式、分区、文件位置等信息,并以JSON 格式维护元数据、清单列表与清单文件。
Iceberg 通过快照元数据支持版本控制。它会存储快照的时间戳、分区和相关数据文件等详情。快照是在特定时间点对整个数据的一个视图。
模式演进是为适应新数据元素或需求变化而修改表模式的过程。Apache Iceberg 原生支持模式演进,无需代价高昂的数据重写或迁移即可更新模式。
例如,如果您在维护员工数据并希望新增一个用于绩效指标的列,您可以添加“employee_performance”列。Iceberg 会更新其元数据以包含该列,而不影响现有数据。新列初始有默认值,并会在新记录插入时得到更新。
分区将数据划分为更小的子集,使您在查询时无需读取整个数据集,只访问所需数据。
Iceberg 支持多种分区策略,例如:
快照是一组在特定时间点有效的清单文件。您对数据的每次更改都会创建一个带有更新清单文件与元数据的新快照。
Iceberg 采用基于快照的查询,这意味着您可以通过访问特定时间戳来获取该时刻的整套数据文件。这使您能够访问历史数据,并在数据丢失时回滚到先前版本。
Apache Iceberg 并不将数据存储在表中,而是组织数据文件,以将其呈现为一张表。
我们来回顾一下实现这一点的架构。
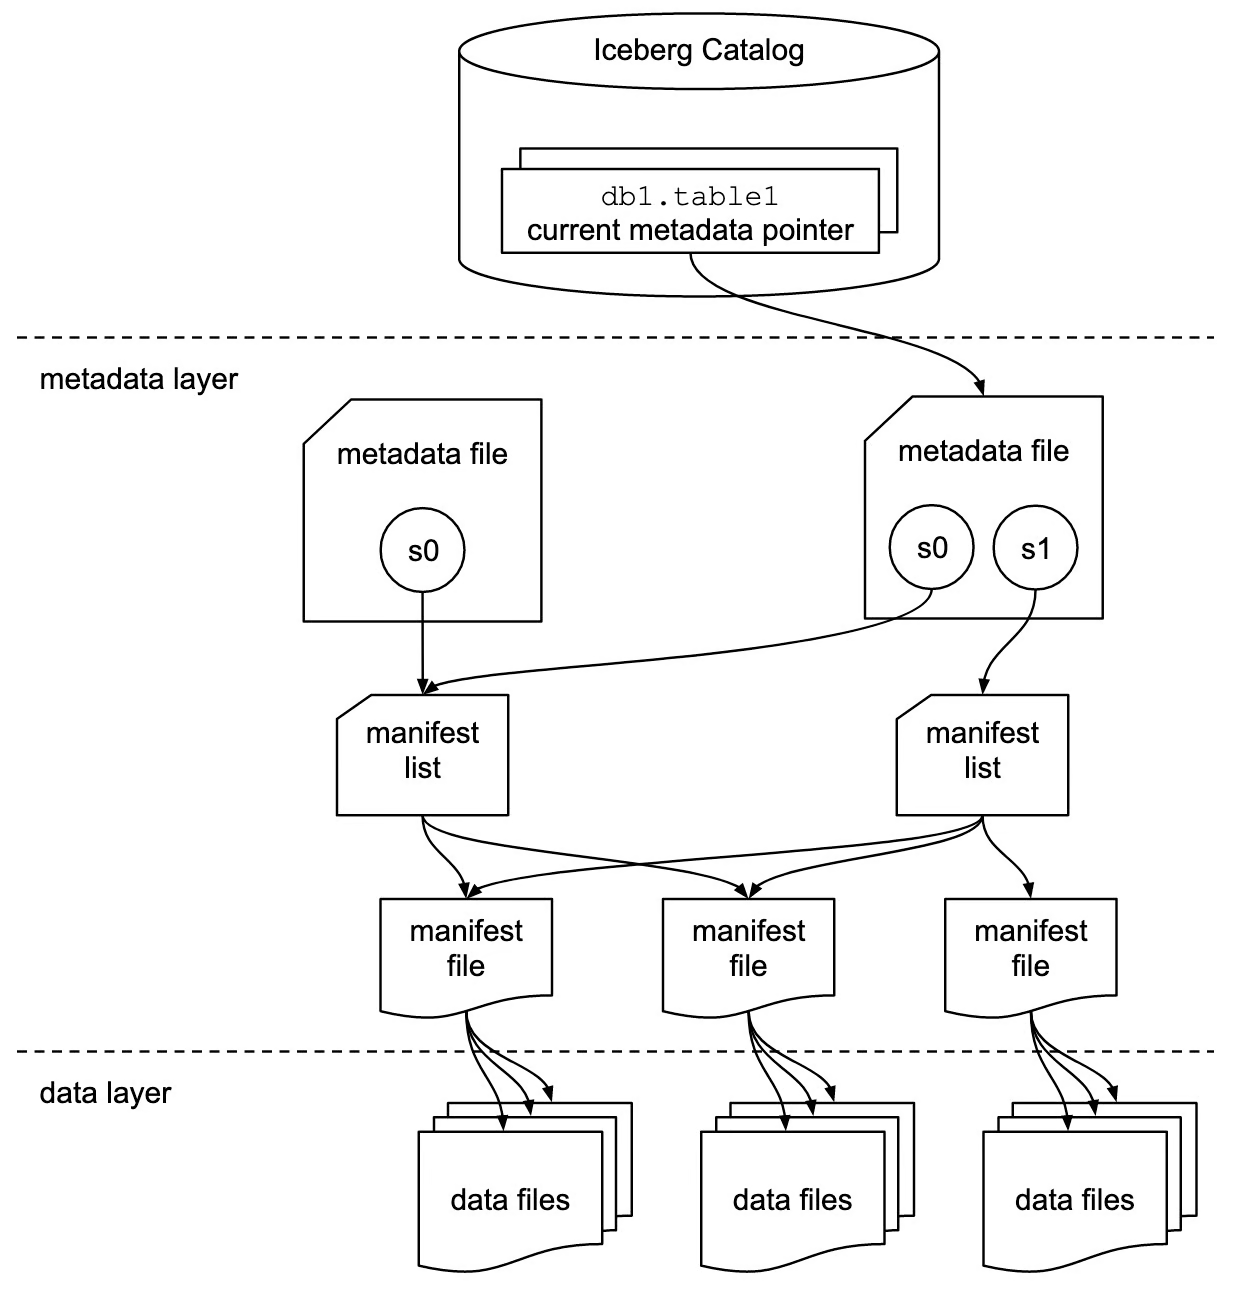
图片来源
目录层包含指向表当前元数据文件的引用或指针。每当数据发生变化,就会写入新的元数据文件,指针会指向日志中最新的元数据文件。
该层促成了 Iceberg 表的 ACID 合规性。例如,进行中的更改在完成并提交到表之前,对其他事务不可见。在此之前,指针始终指向当前的元数据文件。
总体而言,目录通过指向特定版本的元数据文件,简化了 Iceberg 表中 ACID 合规性的管理。
该层包含三类文件:
该层维护表的结构与完整性,从而实现高效的数据查询与管理。
数据层是 Iceberg 架构中实际数据所在的存储组件。
Iceberg 支持多种数据格式,包括 Parquet、ORC 和 Avro。这种灵活性允许针对不同数据类型与用例实现优化存储与高效处理。
Apache Iceberg 可与众多流行的大数据处理框架与计算引擎集成。
Iceberg 表的功能类似大型数据存储系统,您可以使用Spark API读写数据。除 dataframe API 外,您还可以使用 Spark SQL 模块查询 Iceberg 表。
Apache Spark 提供两个目录:org.apache.iceberg.spark.SparkCatalog 与 org.apache.iceberg.spark.SparkSessionCatalog。这些目录帮助 Spark 发现并访问可用的 Iceberg 表元数据。
metadataorg.apache.iceberg.spark.SparkCatalog:用于使用 Hive 或 Hadoop 等外部目录服务。org.apache.iceberg.spark.SparkSessionCatalog:Spark 内置目录,可在同一会话中处理 Iceberg 与非 Iceberg 表。Apache Flink 与 Iceberg 的集成以流式数据处理著称。该集成使您可以将来自各种来源的数据直接流式写入 Iceberg 表,并便捷地对实时流数据进行分析。
Preso 与 Trino 以相较 Hive 或其他 SQL 引擎更快的数据处理能力闻名。因此,如果您有需要查询与分析的海量数据,Iceberg 与 Presto/Trino 的集成是极佳选择。
Trino 没有内置目录,它依赖 Hive Metastore 或 AWS Glue 等外部目录服务来指向 Iceberg 表。
传统数据湖不支持 ACID 属性,可能导致读取不完整数据或并发写入冲突。然而,将数据湖与 Iceberg 集成可确保数据一致性与准确性。
Apache Iceberg 与 Delta Lake 都是旨在为数据湖引入 ACID 属性的先进表格式,但它们在特性、集成与使用场景方面存在差异。
以下是两者的详细对比:
Delta Lake 是一种为一组 Parquet 文件提供 ACID 属性的表格式,确保读取方不会看到不一致的数据。
由 Databricks(Apache Spark 背后的公司)开发,Delta Lake 与 Spark 在大数据处理与分析方面高度兼容。
Delta Lake 使用事务日志来管理时光回溯功能。事务日志是一组 JSON 文件,用于跟踪对表所做的更改。每次插入、删除或更新都会生成一个新的日志文件以跟踪具体变更。
Delta Lake 会定期创建检查点文件,这些文件以 Parquet 格式存储,代表在特定时间点对整张表的快照。
|
特性 |
Apache Iceberg |
Delta Lake |
|
定义 |
Iceberg 表格式提供可扩展的基础设施,并支持多种处理引擎。 |
Delta Lake 是可靠的存储层,尤其适合Databricks 生态。 |
|
文件格式 |
Iceberg 支持多种文件格式,包括 Parquet、Avro 和 ORC。 |
Delta Lake 原生仅支持 Parquet 文件格式。 |
|
ACID 属性支持 |
Iceberg 支持 ACID 事务。 |
Delta Lake 提供健壮的 ACID 属性。 |
|
分区处理 |
Iceberg 支持动态分区,可在不重写模式的情况下更新分区。 |
分区为常量,需在建表时定义。修改已定义分区可能涉及数据重写。 |
|
时光回溯 |
对表的每次更改都会创建新的快照。 |
通过事务日志提供时光回溯功能,变更记录在 JSON 文件中。 |
|
集成 |
Iceberg 支持多种数据处理引擎,如 SQL、Spark、Trino、Hive、Flink、Presto 等。 |
Delta Lake 与 Apache Spark 深度耦合。 |
|
使用场景 |
Apache Iceberg |
Delta Lake |
|
引擎灵活性 |
适合同时使用多种引擎(包括 Apache Spark、Flink、Presto、Hive 等)。非常适合需要针对不同处理任务选择不同引擎的环境。 |
最适合本就原生使用 Apache Spark 的用户,在 Spark 生态内提供紧密集成与最佳性能。 |
|
数据流处理 |
支持从多种来源的持续数据摄取,并进行实时处理。 |
统一批处理与流处理,适合需要在同一管道中同时满足两者的场景。 |
总体而言,Delta Lake 适用于需要实时处理并与 Spark 和 Databricks 生态深度集成的场景。而 Apache Iceberg 则为大规模数据处理提供更高的灵活性,并能为特定用例选择最佳引擎。
设置并使用 Apache Iceberg 需要配置您的环境,并了解基础与进阶操作。本指南将帮助您入门。
要设置并运行 Iceberg 表,您需要在本机配置以下环境:
具备上述工具与技术的基础知识也将有所助益。您可以通过以下课程学习:
准备就绪后,您可以按照以下步骤设置 Iceberg 表:
iceberg-warehouse 的新文件夹,用于存储 Iceberg 表。mkdir iceberg-warehousefrom pyspark.sql import SparkSession
spark = SparkSession.builder \
.appName("Iceberg-sample") \
.config("spark.jars", "jars/iceberg-spark-runtime-<version>.jar") \
.getOrCreate()
将 “jars/iceberg-spark-runtime-<version>.jar” 替换为您所使用的 jar 文件实际目录与版本。
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("Iceberg-Sample") \
    .config("spark.jars", "jars/iceberg-spark-runtime-<version>.jar") \
    .config("spark.sql.catalog.catalog_name", "org.apache.iceberg.spark.SparkCatalog") \
    .config("spark.sql.catalog.catalog_name.type", "hadoop") \
    .config("spark.sql.catalog.catalog_name.warehouse", "file:///C:/HP/iceberg-warehouse") \
    .getOrCreate()
将 "jars/iceberg-spark-runtime-<version>.jar" 替换为 Iceberg JAR 文件的实际路径与版本,并确保仓库路径正确。
现在,您可以使用 PySpark 创建并使用 Iceberg 表。
spark.sql(""" CREATE TABLE my_catalog.emp_table ( id INT, data STRING ) USING iceberg """)
spark.sql(""" INSERT INTO catalog_name.emp_table VALUES (14, 'james'),('15','john')""")spark.sql("DELETE FROM catalog_name.emp_table WHERE id = 14")在不影响现有数据的情况下添加、更新或删除列是模式演进的一部分。
spark.sql("ALTER TABLE ADD catalog_name.emp_table COLUMN salary INT")分区演进是指在不重写现有数据文件的情况下更改分区列。
spark.sql("ALTER TABLE catalog_name.emp_table ADD PARTITION FIELD emp_join_date")这些步骤与命令为您开始使用 Apache Iceberg 提供了基本框架,并让您了解使用该格式的实际感受。
本文涵盖内容较多,下面用几个要点来总结。
Apache Iceberg 为一组数据文件提供了健壮的表结构,支持 ACID 事务,确保数据一致性与可靠性。
Iceberg 格式引入了动态模式演进、无缝分区与良好可扩展性。与 Apache Spark、Flink 等数据处理引擎的集成,使其能高效处理批处理与实时流式数据。
如果您希望进一步深入了解现代数据架构与管理,建议探索以下资源:
通过以下课程,进一步学习数据工程与数据管理!
课程
课程
课程