
कोर्स
Introduction to Data Engineering
4 घंटा
130.1K
यदि आप बिग डेटा प्रोसेसिंग के साथ काम करते हैं, तो आप जानते हैं कि असंगठित डेटा फ़ाइलों का प्रबंधन और विश्लेषण करना चुनौतीपूर्ण और त्रुटि-प्रवण हो सकता है। एक साधारण गलती, जैसे कि गलत से डिलीट कमांड चल जाना, के कारण मूल्यवान डेटा खोने का जोखिम हमेशा बना रहता है।
Apache Iceberg इन चुनौतियों का समाधान देता है एक मज़बूत और विश्वसनीय टेबल फ़ॉर्मेट उपलब्ध कराकर, जो रोलबैक को सपोर्ट करता है और आपके डेटा की पिछली अवस्थाओं को पुनर्स्थापित कर सकता है। यह डेटा इंटेग्रिटी और कंसिस्टेंसी सुनिश्चित करता है, जिससे डेटा प्रबंधन अधिक कुशल और कम त्रुटि-प्रवण हो जाता है।
इस ट्यूटोरियल में, हम बताएँगे कि Apache Iceberg क्या है, इसका उपयोग क्यों किया जाता है, और यह कैसे काम करता है। आप इसे शुरू करने के लिए चरण-दर-चरण, हैंड्स-ऑन निर्देश भी सीखेंगे, जिससे आप अपने डेटा का अधिक प्रभावी ढंग से प्रबंधन और विश्लेषण कर सकेंगे।
Apache Iceberg एक ओपन टेबल फ़ॉर्मेट है, जिसे विशाल विश्लेषणात्मक डेटा सेट्स को कुशलता से संभालने के लिए डिज़ाइन किया गया है। यह एक उच्च-प्रदर्शन टेबल संरचना देता है जो पारंपरिक डेटाबेस के फ़ायदों—जैसे SQL क्वेरीइंग, ACID अनुपालन, और पार्टिशनिंग—को आपकी डेटा फ़ाइलों तक लाता है।
मूल रूप से, Apache Iceberg एक लेंस की तरह काम करता है, जो आपको डेटा फ़ाइलों के संग्रह को एक एकीकृत, समेकित टेबल के रूप में देखने और प्रबंधित करने देता है।
Apache Iceberg का मुख्य लाभ इसकी बड़े पैमाने के डेटा को उच्च स्तर पर अनुकूलित तरीके से हैंडल करने की क्षमता है। यह स्कीमा एवोल्यूशन, हिडन पार्टिशनिंग और टाइम ट्रैवल जैसी विशेषताओं को सपोर्ट करता है, जो जटिल डेटा वर्कफ़्लोज़ को प्रबंधित करने के लिए इसे एक मज़बूत समाधान बनाता है।
आधारभूत स्टोरेज फ़ॉर्मैट्स की जटिलताओं को एब्स्ट्रैक्ट करके, Iceberg कुशल डेटा प्रबंधन और क्वेरीइंग सक्षम करता है, जिससे यह बिग डेटा प्रोसेसिंग के लिए आदर्श विकल्प बनता है।
Netflix ने 2017 में Apache Iceberg विकसित किया था ताकि Hive की सीमाओं, विशेष रूप से इन्क्रीमेंटल प्रोसेसिंग और स्ट्रीमिंग डेटा को संभालने में, सुधार हो सके। 2018 में, Netflix ने Iceberg को Apache Software Foundation को दान कर दिया, जिससे यह ओपन-सोर्स प्रोजेक्ट बन गया।
तब से, Apache Iceberg आधुनिक डेटा लेक आर्किटेक्चर का आधार बन गया है, और विभिन्न उद्योगों में व्यापक रूप से अपनाया गया है।
प्रोजेक्ट लगातार विकसित हुआ है, जिसमें हिडन पार्टिशनिंग और स्कीमा एवोल्यूशन जैसी विशेषताएँ शामिल की गई हैं, ताकि बड़े पैमाने के डेटा वातावरण की माँगों को पूरा किया जा सके।
2024 में, Databricks ने Tabular का अधिग्रहण करने के लिए समझौते की घोषणा की, जो Apache Iceberg के मूल निर्माताओं द्वारा स्थापित डेटा प्रबंधन कंपनी है। यह अधिग्रहण Apache Iceberg और Delta Lake को एकीकृत करने, डेटा संगतता बढ़ाने और एकल, खुले इंटरऑपरेबिलिटी मानक की दिशा में विकास को बढ़ावा देने का लक्ष्य रखता है।
|
वर्ष |
घटना |
|
2017 |
Netflix Apache Iceberg विकसित करता है ताकि Hive की सीमाएँ, खासकर इन्क्रीमेंटल प्रोसेसिंग और स्ट्रीमिंग डेटा के लिए, दूर की जा सकें। |
|
2018 |
Netflix Apache Iceberg को Apache Software Foundation को दान करता है, जिससे यह ओपन-सोर्स प्रोजेक्ट बन जाता है। |
|
2019 |
Apache Iceberg को विभिन्न उद्योगों द्वारा इसके स्केलेबल और कुशल डेटा प्रबंधन क्षमताओं के लिए अपनाया जाता है। स्कीमा एवोल्यूशन और हिडन पार्टिशनिंग जैसी विशेषताएँ पेश की जाती हैं। |
|
2020 |
समुदाय का योगदान और अपनाना बढ़ता रहता है, प्रदर्शन में सुधार और टाइम ट्रैवल तथा मेटाडेटा प्रबंधन जैसी नई विशेषताओं के साथ। |
|
2021 |
Apache Iceberg डेटा लेक्स के लिए पसंदीदा टेबल फ़ॉर्मेट के रूप में महत्वपूर्ण गति प्राप्त करता है, और प्रमुख बिग डेटा टूल्स व प्लेटफ़ॉर्म्स के साथ एकीकृत होता है। |
|
2022 |
नई विशेषताएँ और अनुकूलन जोड़े जाते हैं, जो जटिल डेटा वर्कफ़्लोज़ और बड़े पैमाने के डेटा वातावरण के लिए Iceberg के समर्थन को बढ़ाते हैं। |
|
2023 |
Apache Iceberg डेटा संगतता और अन्य डेटा फ़ॉर्मैट्स व सिस्टम्स के साथ इंटरऑपरेबिलिटी में सुधार पर ध्यान केंद्रित करते हुए विकसित होता रहता है। |
|
2024 |
Databricks Tabular के अधिग्रहण के लिए अपने समझौते की घोषणा करता है। यह अधिग्रहण Iceberg और Delta Lake को एकीकृत करने का लक्ष्य रखता है। |
जैसा कि हमने देखा, Apache Iceberg बड़े पैमाने के वातावरण में डेटा प्रबंधन और एनालिटिक्स के लिए एक शक्तिशाली टूल है।
यहाँ विस्तार से देखते हैं कि Apache Iceberg का उपयोग किन कार्यों के लिए होता है।
ORC या Parquet जैसे फ़ाइल फ़ॉर्मैट्स का उपयोग करना आसान है, लेकिन उन पर एनालिटिक्स चलाना अप्रभावी होता है। जबकि Iceberg इन्हें मेटाडेटा जानकारी के साथ एक टेबल फ़ॉर्मेट प्रदान करता है ताकि क्वेरीज़ को अनुकूलित किया जा सके।
उदाहरण के लिए, कच्ची डेटा फ़ाइलें यह जानकारी संग्रहीत नहीं करतीं कि वे किस टेबल की हैं, लेकिन Iceberg की मेटाडेटा फ़ाइलें करती हैं। इससे क्वेरी इंजन तय कर सकते हैं कि किन टेबल्स को पढ़ना है और किन्हें स्किप करना है, जिससे क्वेरी दक्षता में उल्लेखनीय सुधार होता है।
मेटाडेटा फ़ाइलें कुशल क्वेरीइंग के लिए इस प्रकार की जानकारी संग्रहीत करती हैं। क्वेरी भाषाएँ पहले मेटाडेटा में प्रासंगिक फ़ाइल नाम ढूँढती हैं और तेज़ क्वेरी के लिए केवल उसी फ़ाइल को फ़ेच करती हैं, जिससे अनावश्यक डेटा रीड्स कम होते हैं।
पार्टिशन प्रूनिंग एक तकनीक है जो अप्रासंगिक डेटा को छोड़ देती है और केवल आवश्यक डेटा पर ही ऑपरेशन करती है।
उदाहरण के लिए, यदि आपका पार्टिशन कॉलम "date" है और आप एक विशिष्ट तारीख़ सीमा निर्दिष्ट करते हैं, तो क्वेरी केवल उसी सीमा के भीतर का डेटा पढ़ती है। इससे डिस्क से पढ़े जाने वाले डेटा की मात्रा कम होती है और Iceberg टेबल्स पर क्वेरीइंग तेज़ और अधिक कुशल हो जाती है।
टाइम ट्रैवल एक सुविधा है जो आपको किसी विशेष समय बिंदु के स्नैपशॉट्स को फ़ेच करके अपने डेटा के पुराने संस्करणों तक पहुँचने देती है।
स्नैपशॉट किसी विशेष क्षण में डेटा फ़ाइलों का पूर्ण सेट होता है।
मेटाडेटा फ़ाइलें स्नैपशॉट IDs, टाइमस्टैम्प्स और हिस्ट्री विवरण को ट्रैक करती हैं, जिससे प्रत्येक स्नैपशॉट तक उसके ID या टाइमस्टैम्प द्वारा पहुँचना संभव होता है।
कई लोकप्रिय स्टोरेज सिस्टम, जैसे Google Cloud, AWS, और Microsoft Azure, Iceberg टेबल फ़ॉर्मेट को सपोर्ट करते हैं। आप उन क्लाउड प्लेटफ़ॉर्म्स पर डेटा फ़ाइलें स्टोर कर सकते हैं और उनकी मेटाडेटा की ओर इशारा करने के लिए बाहरी या बिल्ट-इन कैटलॉग सेवा का उपयोग कर सकते हैं।
एक बार कैटलॉग सेवा कॉन्फ़िगर हो जाने के बाद, आप Apache Spark या Apache Flink जैसे बिग डेटा प्रोसेसिंग फ़्रेमवर्क का उपयोग कर सकते हैं।
Iceberg विभिन्न क्वेरीइंग इंजनों को भी सपोर्ट करता है, जैसे SQL, Trino और Presto, जिससे मौजूदा डेटा वर्कफ़्लोज़ के साथ सहज एकीकरण संभव होता है।
Apache Iceberg का एक सक्रिय समुदाय है और इसकी उपस्थिति Twitter और Github जैसे विभिन्न सहयोग प्लेटफ़ॉर्म्स पर है। जो लोग नवीनतम विकास संबंधी चर्चाओं में भाग लेना चाहते हैं, उनके लिए इसका एक समर्पित Slack वर्कस्पेस भी है।
ओपन-सोर्स योगदानकर्ता और Iceberg डेवलपर्स सीखने वाले समुदाय के लिए सामाजिक प्लेटफ़ॉर्म्स पर सुलभ हैं। इससे Iceberg फीचर्स लागू करते समय समस्या आने पर समाधान पाना आसान हो जाता है।
Apache Iceberg कुशल डेटा प्रबंधन और क्वेरीइंग को संभव बनाने वाले कुछ मुख्य सिद्धांत प्रस्तुत करता है। इस अनुभाग में, हम इन्हें समीक्षा करेंगे।
Iceberg अपने मेटाडेटा लेयर के माध्यम से टेबल स्कीमा, पार्टिशन्स, फ़ाइल लोकेशन्स और बहुत कुछ प्रबंधित करता है, जो JSON फ़ॉर्मेट में मेटाडेटा, मैनिफेस्ट लिस्ट्स और मैनिफेस्ट फ़ाइलें बनाए रखता है।
Iceberg स्नैपशॉट मेटाडेटा के माध्यम से वर्ज़निंग सपोर्ट करता है। यह स्नैपशॉट के टाइमस्टैम्प, पार्टिशन और प्रासंगिक डेटा फ़ाइलों का विवरण संग्रहीत करता है। स्नैपशॉट किसी विशेष समय पर आपके संपूर्ण डेटा का दृश्य होता है।
स्कीमा एवोल्यूशन वह प्रक्रिया है जिसमें टेबल स्कीमा को बदलती आवश्यकताओं या नए डेटा तत्वों के अनुरूप संशोधित किया जाता है। Apache Iceberg नैटिव स्कीमा एवोल्यूशन सपोर्ट करता है, जिससे महँगे डेटा री-राइट्स या माइग्रेशन्स के बिना स्कीमा अपडेट संभव हो पाते हैं।
उदाहरण के लिए, यदि आप कर्मचारी डेटा बनाए रख रहे हैं और परफ़ॉर्मेंस मेट्रिक्स के लिए नया कॉलम जोड़ना चाहते हैं, तो आप “employee_performance” कॉलम जोड़ सकते हैं। Iceberg अपने मेटाडेटा को अपडेट करके इस कॉलम को शामिल कर लेता है, बिना मौजूदा डेटा को प्रभावित किए। नए कॉलम में शुरू में डिफ़ॉल्ट मान होंगे और जैसे-जैसे नए रिकॉर्ड डाले जाएँगे, वह अपडेट होता जाएगा।
पार्टिशनिंग डेटा को छोटे उपसमूहों में विभाजित करती है, जिससे आप पूरे डेटा सेट को पढ़ने के बजाय केवल क्वेरी के लिए आवश्यक डेटा तक पहुँच सकते हैं।
Iceberg कई पार्टिशनिंग रणनीतियों को सपोर्ट करता है, जैसे:
स्नैपशॉट किसी विशेष समय पर मान्य मैनिफेस्ट फ़ाइलों का एक सेट होता है। डेटा में आप जो भी परिवर्तन करते हैं, वे अपडेटेड मैनिफेस्ट फ़ाइलों और मेटाडेटा के साथ एक नया स्नैपशॉट बनाते हैं।
Iceberg स्नैपशॉट-आधारित क्वेरीइंग का पालन करता है, यानी आप किसी विशेष टाइमस्टैम्प तक पहुँचकर उस समय के संपूर्ण डेटा फ़ाइलों के सेट तक पहुँच सकते हैं। इससे ऐतिहासिक डेटा तक पहुँचना और डेटा लॉस होने पर पिछली वर्ज़न पर रोलबैक करना संभव हो जाता है।
Apache Iceberg डेटा को टेबल्स में स्टोर नहीं करता। इसके बजाय, यह डेटा फ़ाइलों को इस तरह व्यवस्थित करता है कि उन्हें एक एकल टेबल के रूप में प्रदर्शित किया जा सके।
आइए उस आर्किटेक्चर की समीक्षा करें जो इसे संभव बनाती है।
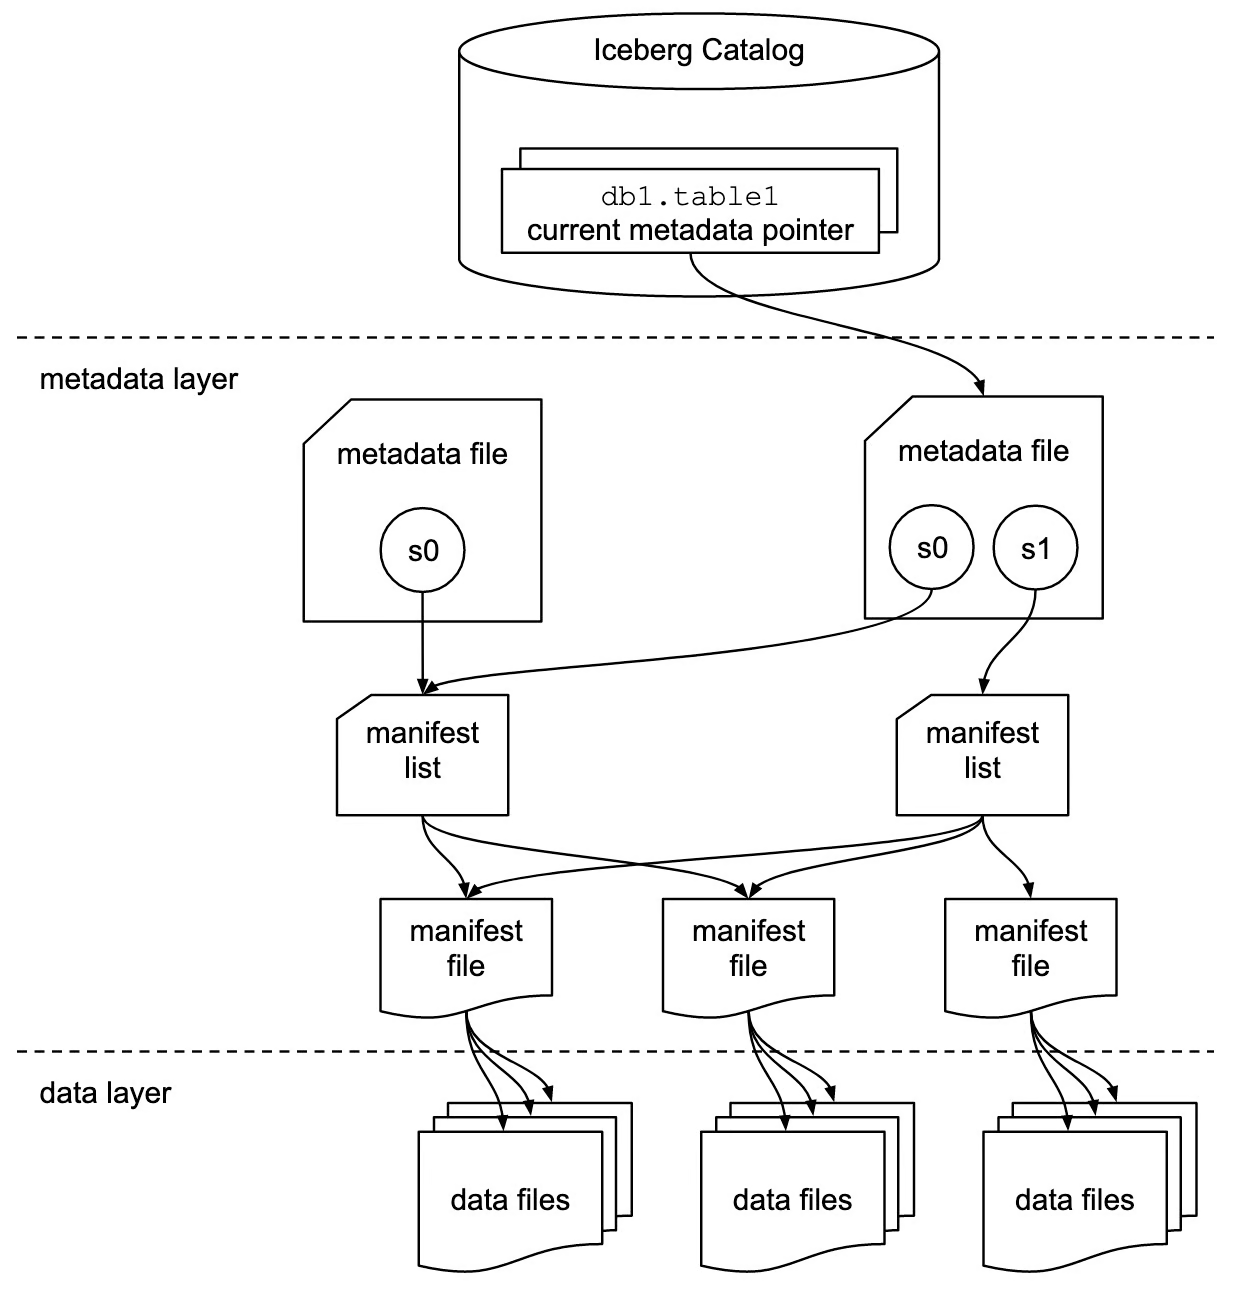
इमेज स्रोत
कैटलॉग लेयर में टेबल की वर्तमान मेटाडेटा फ़ाइल के लिए एक संदर्भ या पॉइंटर होता है। जब भी आप डेटा बदलते हैं, एक नई मेटाडेटा फ़ाइल लिखी जाती है, और पॉइंटर अब लॉग में नवीनतम मेटाडेटा फ़ाइल की ओर इशारा करता है।
यह लेयर Iceberg टेबल्स के भीतर ACID अनुपालन को सुगम बनाती है। उदाहरण के लिए, जारी परिवर्तन तब तक अन्य ट्रांज़ैक्शन्स को दिखाई नहीं देते जब तक वे पूरे होकर टेबल में कमिट न हो जाएँ। तब तक, पॉइंटर वर्तमान मेटाडेटा फ़ाइल को ही संदर्भित करता है।
कुल मिलाकर, कैटलॉग्स Iceberg टेबल्स में ACID अनुपालन प्रबंधन को सरल बनाते हैं, मेटाडेटा फ़ाइलों के विशिष्ट वर्ज़न्स की ओर इशारा करके।
इस लेयर में तीन प्रकार की फ़ाइलें होती हैं:
यह लेयर टेबल की संरचना और अखंडता बनाए रखती है, जिससे कुशल डेटा क्वेरीइंग और प्रबंधन संभव होता है।
डेटा लेयर Iceberg आर्किटेक्चर का स्टोरेज घटक है, जहाँ वास्तविक डेटा रहता है।
Iceberg विभिन्न डेटा फ़ॉर्मैट्स को सपोर्ट करता है, जिनमें Parquet, ORC और Avro शामिल हैं। यह लचीलापन अनुकूलित स्टोरेज और कुशल डेटा प्रोसेसिंग की सुविधा देता है, और अलग-अलग डेटा प्रकारों व उपयोग मामलों के अनुरूप होता है।
Apache Iceberg कई लोकप्रिय बिग डेटा प्रोसेसिंग फ़्रेमवर्क्स और कम्प्यूटिंग इंजनों के साथ इंटीग्रेट होता है।
Iceberg टेबल्स बड़े डेटा स्टोरेज सिस्टम्स की तरह काम करती हैं, जिन पर आप डेटा पढ़ने-लिखने के लिए Spark APIs का उपयोग कर सकते हैं। डेटाफ्रेम API के अलावा, आप Spark SQL मॉड्यूल का उपयोग करके Iceberg टेबल्स पर क्वेरी चला सकते हैं।
Apache Spark में दो कैटलॉग्स हैं: org.apache.iceberg.spark.SparkCatalog और org.apache.iceberg.spark.SparkSessionCatalog। ये कैटलॉग्स Spark को उपलब्ध Iceberg टेबल्स के मेटाडेटा खोजने और एक्सेस करने में मदद करते हैं।
metadataorg.apache.iceberg.spark.SparkCatalog: Hive या Hadoop जैसी बाहरी कैटलॉग सेवाओं का उपयोग करने के लिए।org.apache.iceberg.spark.SparkSessionCatalog: Spark का बिल्ट-इन कैटलॉग, जो एक ही सत्र में Iceberg और non-Iceberg दोनों टेबल्स को हैंडल कर सकता है। Apache Flink और Iceberg का इंटीग्रेशन स्ट्रीमिंग डेटा प्रोसेसिंग के लिए जाना जाता है। यह इंटीग्रेशन आपको विभिन्न स्रोतों से सीधे Iceberg टेबल्स में डेटा स्ट्रीम करने देता है और रियल-टाइम स्ट्रीमिंग डेटा पर एनालिटिक्स करना आसान बनाता है।
Preso और Trino Hive या अन्य SQL इंजनों की तुलना में तेज़ डेटा प्रोसेसिंग क्षमताओं के लिए जाने जाते हैं। इसलिए, यदि आपके पास विशाल डेटा है जिसे क्वेरी और विश्लेषित करने की आवश्यकता है, तो Iceberg और Presto/Trino का इंटीग्रेशन एक बेहतरीन विकल्प है।
Trino का अपना बिल्ट-इन कैटलॉग नहीं है। यह Iceberg टेबल्स की ओर इशारा करने के लिए Hive Metastore या AWS Glue जैसी बाहरी कैटलॉग सेवाओं पर निर्भर करता है।
पारंपरिक डेटा लेक्स ACID गुणों को सपोर्ट नहीं करते, जिससे अधूरा डेटा पढ़ना या समवर्ती डेटा लिखना जैसी समस्याएँ होती हैं। जबकि, किसी डेटा लेक को Iceberg के साथ इंटीग्रेट करने से डेटा कंसिस्टेंसी और शुद्धता सुनिश्चित होती है।
Apache Iceberg और Delta Lake दोनों ही उन्नत टेबल फ़ॉर्मैट्स हैं जो डेटा लेक्स में ACID गुण लाते हैं, लेकिन उनकी विशेषताएँ, इंटीग्रेशन्स और उपयोग मामलों में अंतर है।
यहाँ दोनों की विस्तृत तुलना दी गई है:
Delta Lake एक टेबल फ़ॉर्मेट है जो Parquet फ़ाइलों के संग्रह को ACID गुण प्रदान करता है, यह सुनिश्चित करते हुए कि रीडर्स को कभी भी असंगत डेटा न दिखे।
Databricks द्वारा विकसित, जो Apache Spark के पीछे की कंपनी है, Delta Lake बिग डेटा प्रोसेसिंग और एनालिटिक्स के लिए Spark के साथ अत्यधिक संगत है।
Delta Lake टाइम ट्रैवल विशेषताओं को प्रबंधित करने के लिए ट्रांज़ैक्शनल लॉग्स का उपयोग करता है। एक ट्रांज़ैक्शन लॉग JSON फ़ाइलों की सूची होती है, जो टेबल में किए गए परिवर्तनों को ट्रैक करती है। प्रत्येक इंसर्शन, डिलीशन या अपडेट एक नई लॉग फ़ाइल बनाता है जो विशिष्ट परिवर्तनों को ट्रैक करती है।
Delta Lake समय-समय पर चेकपॉइंट फ़ाइलें बनाता है, जो विशेष समय बिंदुओं पर संपूर्ण टेबल के स्नैपशॉट्स का प्रतिनिधित्व करती हैं और Parquet फ़ॉर्मेट में संग्रहीत होती हैं।
|
फ़ीचर |
Apache Iceberg |
Delta Lake |
|
परिभाषा |
Iceberg टेबल फ़ॉर्मेट बहु-प्रोसेसिंग इंजनों के समर्थन के साथ एक स्केलेबल इन्फ्रास्ट्रक्चर प्रदान करता है। |
Delta Lake एक विश्वसनीय स्टोरेज लेयर है, विशेष रूप से Databricks इकोसिस्टम के लिए उपयुक्त। |
|
फ़ाइल फ़ॉर्मेट |
Iceberg विभिन्न फ़ाइल फ़ॉर्मैट्स को सपोर्ट करता है, जिनमें Parquet, Avro और ORC शामिल हैं। |
Delta Lake नैटिव रूप से केवल Parquet फ़ाइल फ़ॉर्मेट को सपोर्ट करता है। |
|
ACID गुणों का समर्थन |
Iceberg ACID ट्रांज़ैक्शन्स को सपोर्ट करता है। |
Delta Lake मज़बूत ACID गुण प्रदान करता है। |
|
पार्टिशन हैंडलिंग |
Iceberg डायनेमिक पार्टिशनिंग सपोर्ट करता है, यानी पार्टिशन्स को स्कीमा को फिर से लिखे बिना अपडेट किया जा सकता है। |
पार्टिशन्स स्थिर होते हैं, और आपको उन्हें टेबल बनाते समय परिभाषित करना चाहिए। परिभाषित पार्टिशन्स को संशोधित करने में डेटा री-राइट्स शामिल हो सकते हैं। |
|
टाइम ट्रैवल |
टेबल में किए गए हर परिवर्तन से नया स्नैपशॉट बनता है। |
यह ट्रांज़ैक्शन लॉग्स के माध्यम से टाइम ट्रैवल सुविधाएँ प्रदान करता है, जिसमें परिवर्तन JSON फ़ाइलों में ट्रैक होते हैं। |
|
इंटीग्रेशन्स |
Iceberg कई डेटा प्रोसेसिंग इंजनों को सपोर्ट करता है, जैसे SQL, Spark, Trino, Hive, Flink, Presto आदि। |
Delta Lake Apache Spark के साथ काफ़ी कसा हुआ है। |
|
उपयोग मामला |
Apache Iceberg |
Delta Lake |
|
इंजन लचीलापन |
यह तब सर्वोत्तम है जब आप कई इंजनों का उपयोग करते हैं, जिनमें Apache Spark, Flink, Presto, Hive आदि शामिल हैं। अलग-अलग प्रोसेसिंग कार्यों के लिए अलग-अलग इंजनों की ज़रूरत वाले वातावरण के लिए आदर्श। |
उन उपयोगकर्ताओं के लिए सर्वोत्तम जो नैटिव रूप से Apache Spark का उपयोग करते हैं, Spark इकोसिस्टम के भीतर कसा हुआ इंटीग्रेशन और इष्टतम प्रदर्शन प्रदान करता है। |
|
डेटा स्ट्रीमिंग |
विभिन्न स्रोतों से निरंतर डेटा इनजेशन को सपोर्ट करता है, और उसे रियल-टाइम में प्रोसेस करता है। |
बैच और स्ट्रीम प्रोसेसिंग को एकीकृत करता है, जो एक ही पाइपलाइन में दोनों की आवश्यकता वाले उपयोग मामलों के लिए आदर्श है। |
समग्र रूप से, Delta Lake वे उपयोग मामले के लिए उपयुक्त है जिनमें रियल-टाइम प्रोसेसिंग और Spark व Databricks इकोसिस्टम के साथ कड़ा इंटीग्रेशन आवश्यक है। दूसरी ओर, Apache Iceberg बड़े पैमाने के डेटा प्रोसेसिंग और विशिष्ट उपयोग मामलों के लिए सर्वश्रेष्ठ इंजन चुनने की क्षमता के लिए अधिक लचीलापन प्रदान करता है।
Apache Iceberg को सेटअप और उपयोग करने में आपके वातावरण को कॉन्फ़िगर करना और बुनियादी व उन्नत ऑपरेशन्स को समझना शामिल है। यह गाइड आपको इसकी शुरुआत करने में मदद करेगा।
Iceberg टेबल्स सेटअप और रन करने के लिए, आपकी मशीन पर निम्नलिखित वातावरण कॉन्फ़िगर होने चाहिए:
इन टूल्स और तकनीकों की बुनियादी समझ होना भी लाभदायक है। आप निम्नलिखित कोर्सेस के माध्यम से इन्हें सीख सकते हैं:
तैयार होने के बाद, आप Iceberg टेबल्स सेटअप करने के लिए नीचे दिए गए चरणों का पालन कर सकते हैं:
iceberg-warehouse नाम का नया फ़ोल्डर बनाएँ।mkdir iceberg-warehousefrom pyspark.sql import SparkSession
spark = SparkSession.builder \
.appName("Iceberg-sample") \
.config("spark.jars", "jars/iceberg-spark-runtime-<version>.jar") \
.getOrCreate()
“jars/iceberg-spark-runtime-<version>.jar” को जार फ़ाइलों की वास्तविक डायरेक्टरी और आपके उपयोग में हो रही वर्ज़न से बदलें।
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("Iceberg-Sample") \
    .config("spark.jars", "jars/iceberg-spark-runtime-<version>.jar") \
    .config("spark.sql.catalog.catalog_name", "org.apache.iceberg.spark.SparkCatalog") \
    .config("spark.sql.catalog.catalog_name.type", "hadoop") \
    .config("spark.sql.catalog.catalog_name.warehouse", "file:///C:/HP/iceberg-warehouse") \
    .getOrCreate()
"jars/iceberg-spark-runtime-<version>.jar" को Iceberg JAR फ़ाइलों के वास्तविक पथ और वर्ज़न से बदलें, और सुनिश्चित करें कि वेयरहाउस पथ सही है।
अब आप PySpark का उपयोग करके Iceberg टेबल्स बना और उपयोग कर सकते हैं।
spark.sql(""" CREATE TABLE my_catalog.emp_table ( id INT, data STRING ) USING iceberg """)
spark.sql(""" INSERT INTO catalog_name.emp_table VALUES (14, 'james'),('15','john')""")spark.sql("DELETE FROM catalog_name.emp_table WHERE id = 14")मौजूदा डेटा को प्रभावित किए बिना कॉलम जोड़ना, अपडेट करना या हटाना स्कीमा एवोल्यूशन का हिस्सा है।
spark.sql("ALTER TABLE ADD catalog_name.emp_table COLUMN salary INT")पार्टिशन एवोल्यूशन का अर्थ है मौजूदा डेटा फ़ाइलों को ओवरराइट किए बिना पार्टिशन कॉलम्स को बदलना।
spark.sql("ALTER TABLE catalog_name.emp_table ADD PARTITION FIELD emp_join_date")ये चरण और कमांड्स Apache Iceberg के साथ शुरुआत करने के लिए एक बुनियादी ढाँचा प्रदान करते हैं और आपको यह समझ देते हैं कि इस फ़ॉर्मेट के साथ काम करना कैसा दिखता है।
आज हमने बहुत कुछ कवर किया; आइए कुछ मुख्य बातों से सारांश करें।
Apache Iceberg डेटा फ़ाइलों के एक सेट को एक मज़बूत टेबल संरचना प्रदान करता है, ACID ट्रांज़ैक्शन्स का समर्थन करता है और डेटा कंसिस्टेंसी व विश्वसनीयता सुनिश्चित करता है।
Iceberg फ़ॉर्मेट स्टोरेज सिस्टम्स में डायनेमिक स्कीमा एवोल्यूशन, सहज पार्टिशनिंग और स्केलेबिलिटी पेश करता है। Apache Spark और Flink जैसे डेटा प्रोसेसिंग इंजनों के साथ इसका इंटीग्रेशन बैच और रियल-टाइम स्ट्रीमिंग डेटा—दोनों—का कुशल हैंडलिंग संभव बनाता है।
यदि आप आधुनिक डेटा आर्किटेक्चर और प्रबंधन में और गहराई से जाना चाहते हैं, तो इन अतिरिक्त संसाधनों का अन्वेषण करने पर विचार करें:
इन कोर्सेस के साथ डेटा इंजीनियरिंग और प्रबंधन के बारे में और जानें!
कोर्स
कोर्स
कोर्स