Databricks 一直是构建大规模交付 AI 解决方案的技术与平台先驱之一,其中包括推动 Apache Spark 和 MLflow 等开源项目。
在 Databrick Data + AI Summit 2023 期间,Lakehouse AI 作为全球首个内置于数据层的 AI 平台发布,同时还宣布了更多新功能。随着 ChatGPT 的发布以及全球生成式 AI 技术的飞跃式发展,Lakehouse AI 是 Databrick 以数据为中心的方法来构建生成式 AI 应用的答案。
在本教程中,我们将介绍 Databricks Lakehouse AI 平台,思考其重要性,了解新发布的功能,以及如何在我们的机器学习开发生命周期中加以利用。
什么是 Databricks Lakehouse AI?
等等,Lakehouse?我们理解这对您来说可能都是新术语。
让我们一步步拆解 Databricks Lakehouse AI 的演进。要理解 Lakehouse AI,我们首先需要充分理解 Lakehouse 架构。
什么是 Lakehouse?
“Lakehouse” 是一种现代数据管理架构,它将数据湖的灵活性与成本效益,与数据仓库的数据管理特性相结合。
我们有一篇关于数据湖与数据仓库差异的完整教程,简而言之,含义如下:
- 数据湖:一种存储库,可以以原生格式保存海量原始数据,直到需要时再使用。它就像一个大型容器,我们把所有数据都放进去——无论是结构化的(如数据库中的表)还是非结构化的(如文本或图像)——而无需事先组织。
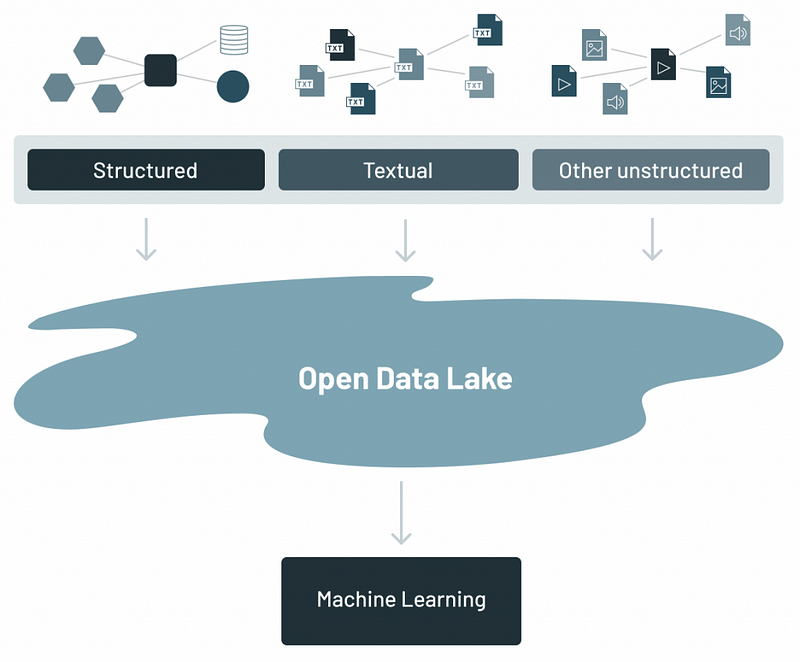
数据湖架构(来源)
- 数据仓库:用于报告与数据分析的系统,其中数据是结构化、经过处理并以便于检索与分析的方式存储。它就像一个图书馆,书籍被整齐组织和编目,便于取用。
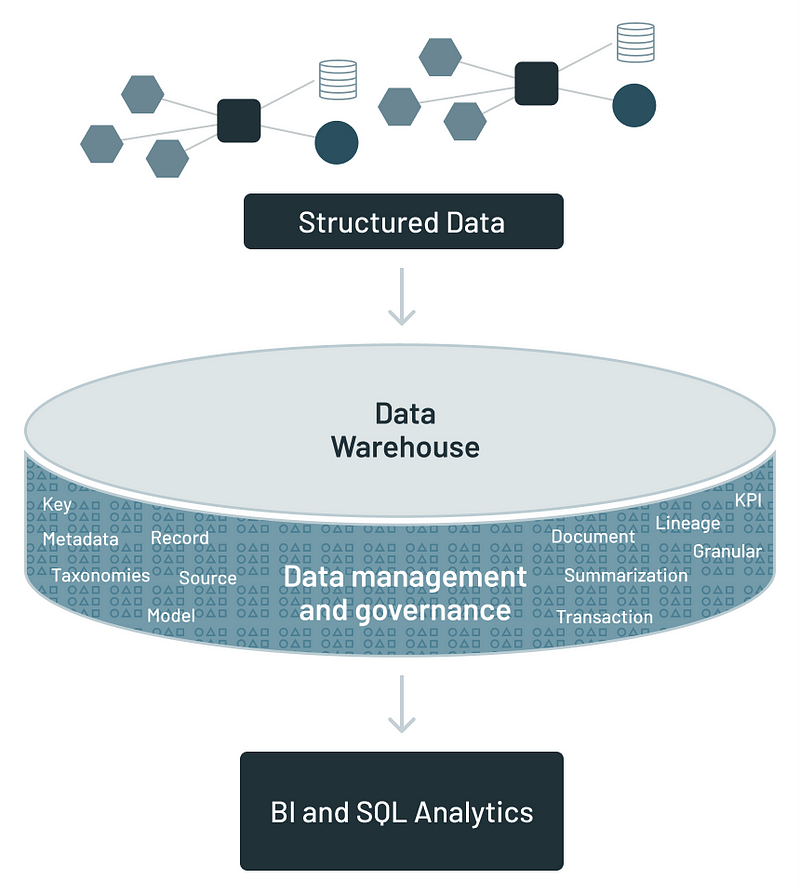
数据仓库架构(来源)
数据湖由于存储大量原始、非结构化数据,常在数据管理与治理方面面临挑战,容易演变为“数据沼泽”,使数据难以查找、访问或信任。缺乏结构也会阻碍复杂分析查询的性能,且传统数据湖通常不支持良好的事务型数据操作,缺少 ACID 事务能力,而这对确保数据完整性至关重要。
另一方面,数据仓库针对结构化数据与分析进行了优化,但随着数据量增长,其扩展成本可能高得难以承受。要求数据被处理成预定义模式会带来刚性,限制了对新数据类型的快速摄取与分析。
这些局限推动了 Lakehouse 架构的演进,其目标是兼具两者之长:
- 像数据湖一样,低成本地存储海量原始数据。
- 像数据仓库一样,高效地执行复杂分析,并以强治理与高可靠性管理数据。
以下是 Lakehouse 架构的样子:
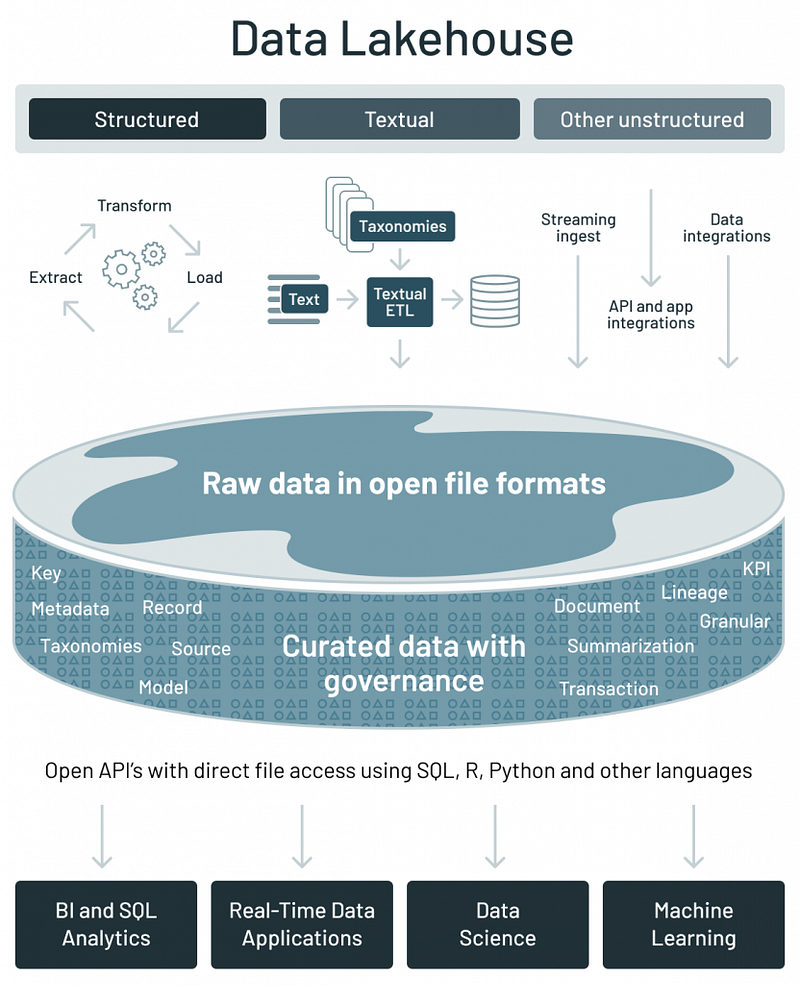
数据 Lakehouse 架构(来源)
现在我们理解了 Databricks Lakehouse 的演进,就来到最后一个问题。
什么是 Lakehouse AI?
Lakehouse AI 是将人工智能与机器学习能力直接集成进 Lakehouse 架构。这意味着我们可以使用存储在数据湖中的海量数据来开发、训练与部署 AI 模型,而无需将数据移动或复制到单独的处理环境。
该平台的重要性在于:
- 直接访问数据:AI 模型可在更全面的数据集上训练,从而可能获得更准确且更有洞见的结果。
- 简化架构:减少数据存储与 AI 处理的分离系统,降低管理数据基础设施的复杂性与成本。
- 实时洞察:支持 AI 应用对数据进行实时处理,使企业能够更快速地做出数据驱动的决策。
这些功能解释了为何 Databricks 将此平台称为全球首个内置于数据层的 AI 平台。
Lakehouse AI 的核心组件
向 Lakehouse AI 的转型,推动企业更加数据驱动并与 AI 深度融合的运营方式。
这场变革的核心是若干组件,它们促进 AI 与机器学习模型的开发、部署与管理。理解这些组件为何以及何时需要,有助于组织更有效地将数据用于 AI 应用。
向量检索(Vector Search)
Databricks Lakehouse AI 中的向量检索(同样在 2023 年 Data+AI Summit 发布)是在处理与检索海量数据集方面的一次重大进步,它用于查找语义相似的信息,而不是依赖传统的关键词匹配。
向量检索通过将数据与查询转换为多维空间中的向量(即嵌入),这些嵌入来自生成式 AI 模型。该方法使语义相近的词或概念在 n 维空间中距离更近,从而提供更相关、具备上下文意识的搜索结果。
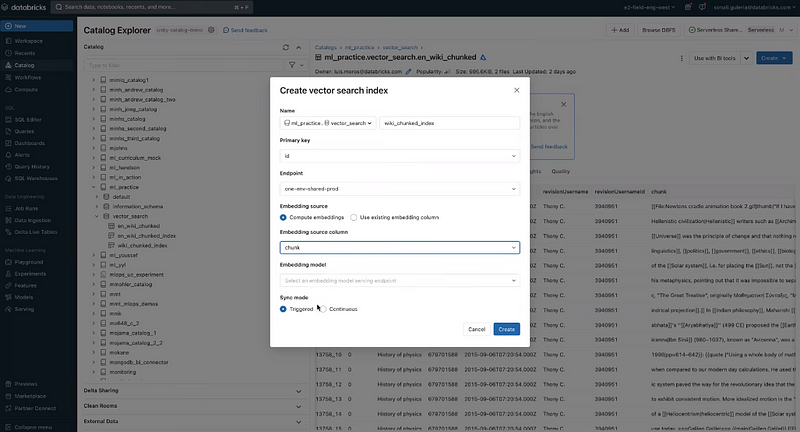
向量检索(作者截图)
使用向量检索的流程(Databricks 演示视频)如下:
- 创建向量检索端点与索引。
- 将数据分块作为输入,映射到由嵌入向量表示的 N 维空间。
- 将这些向量存储在向量数据库中,以便快速、可扩展的最近邻检索算法查找相似向量。
例如,Lippert 等公司已通过将来自各渠道的内容导入向量检索,帮助坐席快速找到客户咨询的答案。
精选模型(Curated Models)
这些模型可在 Databricks Marketplace 获取,经过性能优化,易于集成到 Lakehouse 环境中,适用于从文本分析与生成到图像处理等多种应用。
部分精选的生成式 AI 模型包括:
- MPT-7B 与 Falcon-7B:分别为遵循指令与摘要模型,适用于基于给定指令理解并生成类人文本,或将长文档总结为简洁且信息丰富的摘要。
- Stable Diffusion:一款图像生成模型,因其能基于文本描述生成高质量图像而广受欢迎,使其在 Lakehouse AI 框架内支持广泛的创意与分析应用。查看我们的Stable Diffusion 教程了解更多。
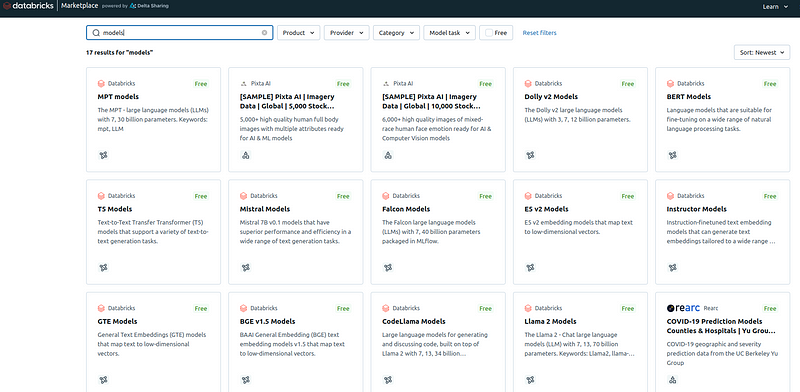
Databricks Marketplace 中可用的模型(作者截图)
这些模型与 Databricks Lakehouse AI 更广泛的功能集无缝协作,包括数据管理、分析与 MLOps 工具。稍后我们将看到如何在机器学习开发中使用这些模型。
AutoML
Databricks Lakehouse AI 中的 AutoML(自动化机器学习)旨在简化并自动化机器学习模型的开发流程,使更广泛的用户(包括缺乏机器学习专业知识的人)也能开展高级数据科学工作。
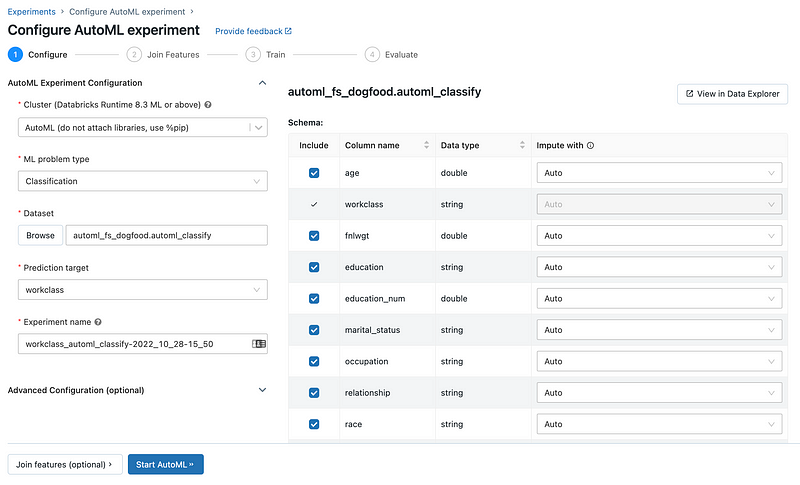
Databrick AutoML(来源)
当我们提供数据集并指定预测目标后,AutoML 会负责为模型训练准备数据集。随后,它会通过一系列试验创建、调优并评估多个模型。
评估完成后,AutoML 会呈现结果,并提供包含每次试验源代码的 Python 笔记本。这样我们就可以按需审阅、复现实验并进行修改。AutoML 还会计算数据集的汇总统计信息,并将其保存到笔记本中以备后用。
在最新版本中,AutoML 现已支持使用客户自有数据对生成式 AI 的文本分类模型与嵌入模型进行微调。这意味着非技术的业务用户也可通过几次点击,用 AutoML 构建生成式 AI 应用。
Lakehouse 监控
Databricks Lakehouse Monitoring 使我们能够监控数据表的统计特性与质量,并跟踪机器学习模型及其预测的性能。通过审视 Databricks 流水线中的数据流动,该监控功能有助于确保持续监控数据质量与模型效果。
以下展示了数据如何在 Lakehouse 监控中流动,从而实现持续监控:
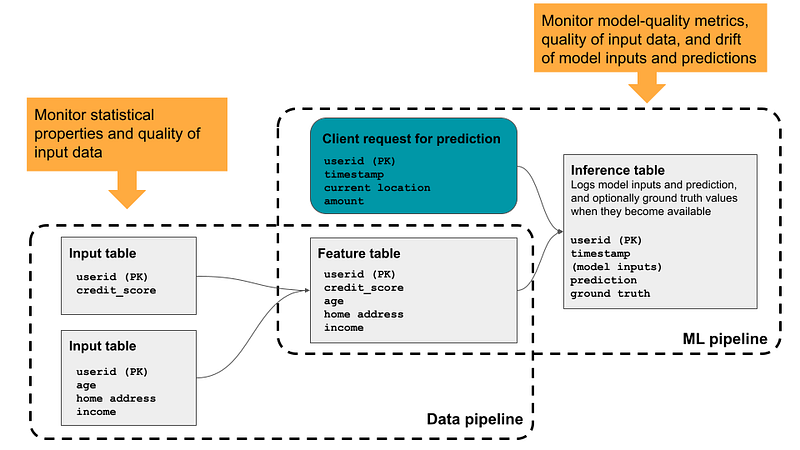
Lakehouse 监控流程(来源)
该功能不止于监控,还会在数据完整性、分布、漂移以及模型随时间的性能等多方面提供可操作的洞见。
现在让我们看看这些功能如何在 Lakehouse AI 中以统一治理的方式汇聚在一起。
统一治理在 Lakehouse AI 中的作用
统一治理的理念是在同一处访问、控制、协作、监控并对数据、机器学习模型及其他 AI 资产采取行动。随着组织在 AI 转型之旅中的成长与成熟,能够在一个地方管理一切至关重要。
Databricks Unity Catalog 正是为此而生,以统一的方式治理 AI 资产,在确保合规性的同时加速 AI 采用。
除了数据浏览器和添加外部系统的能力等实用功能外,最突出的功能是可以通过简单的 Unity Catalog 治理门户从全局视角审视这些资产的整体治理状况,如下图所示:
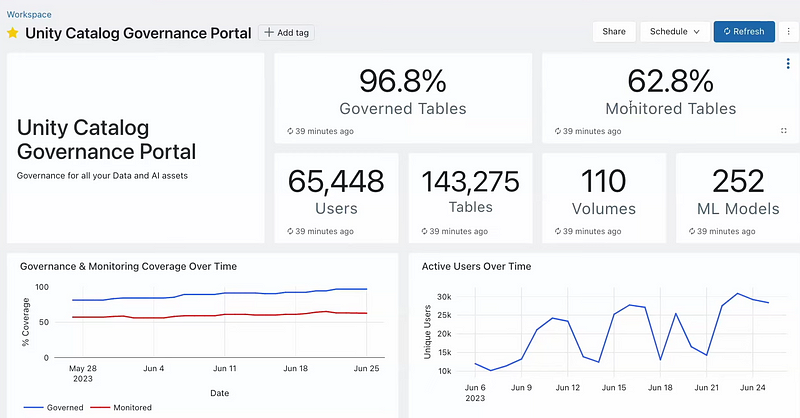
Unity Catalog 治理门户(作者截图)
该门户显示关键指标,例如受治理与受监控表的百分比、活跃用户数量,以及表、卷与 ML 模型的数量。此高层视图有助于快速评估治理状态与对数据资产的活跃使用程度。
该仪表板还展示用户随时间的活跃度,有助于了解组织内部对数据资产的使用情况,并识别潜在瓶颈或培训需求。
此外,该门户通过识别未监控的表或源自 PII(个人可识别信息)的列等问题,列出潜在治理风险,从而以主动方式安全管理数据,如下图所示。
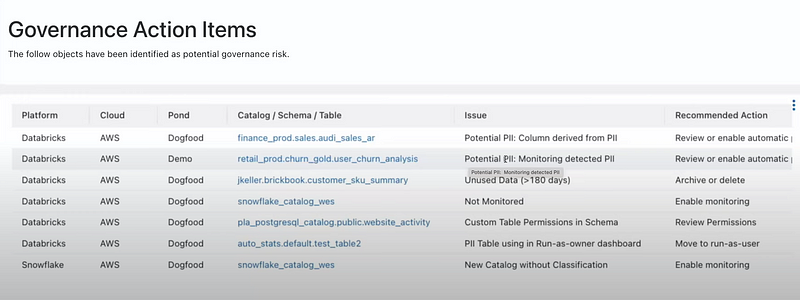
Unity Catalog 仪表板的治理待办视图(作者截图)
每个识别出的问题都会附带推荐操作,引导用户解决潜在的治理隐患。此功能简化并统一了平台上 AI 与数据资产往往复杂的治理流程。
现在我们了解了平台功能及其协同方式,接下来深入其在端到端机器学习开发中的应用。
在 Databricks Lakehouse AI 上的端到端机器学习开发
若需回顾端到端的机器学习开发生命周期,建议参考我们的深度教程。在本节中,我们将理解 Databricks Lakehouse AI 的功能如何融入该生命周期。
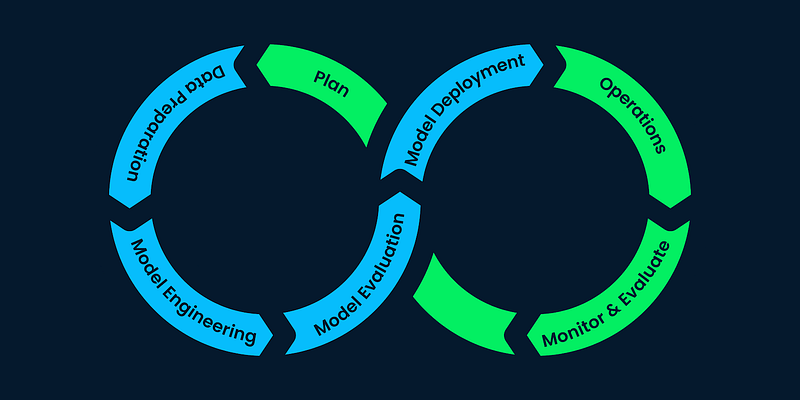
端到端机器学习开发(来源)
1. 数据准备与特征工程
在 Databricks Lakehouse AI 中进行机器学习的基石,是高效训练与构建模型的能力。
我们可以使用包含 pandas 与 PySpark 等常用包的 Databricks ML runtime 进行数据准备与清洗。Databricks Feature Store 是 Databricks Lakehouse AI 平台中的集中式存储库,用于存储、共享与管理机器学习特征。
该特征库确保训练机器学习模型所用的特征与生产环境推理时所用一致。我们也无需为不同用例反复重新计算特征,避免浪费计算资源。
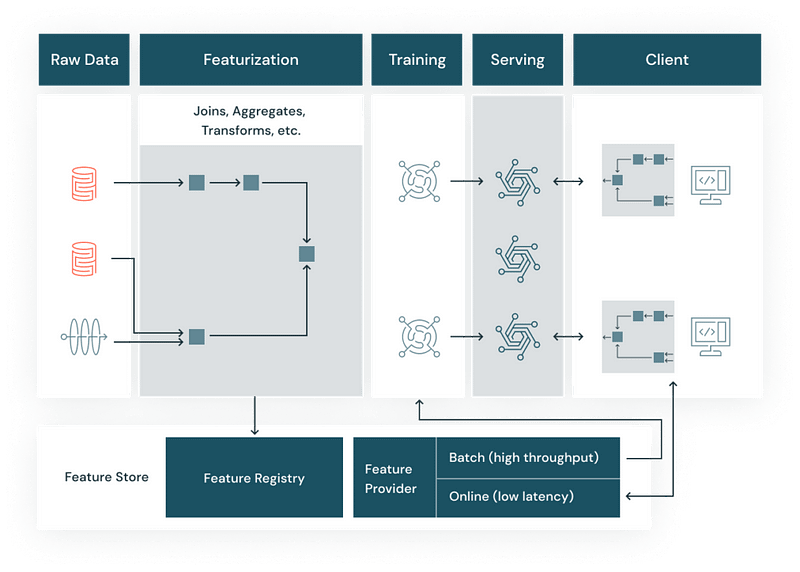
特征库的作用(来源)
通过集中化的特征定义与存储,它消除了常见的“训练-服务偏移”问题,即模型训练时使用的数据与模型在生产中遇到的数据不一致。
2. 模型工程
在模型开发方面,我们既可以选择 Databricks 环境内的预构建精选模型,也可以根据特定数据与业务需求训练自定义模型。
- 利用现有模型:如前所述,我们可以从 Databricks Marketplace 中挑选任何在大规模数据集上预训练的模型。模型附带示例笔记本,无需担心如何具体使用。
- 训练新模型:若需构建定制化方案,我们可以使用 ML runtime,其中包含 TensorFlow、PyTorch、Scikit-learn 等机器学习框架与语言。Databricks 的协作式笔记本提供交互环境,数据科学家可在其中编写代码、分析数据与分享洞见,从而提升训练流程。
Databricks 还提供针对 GPU 优化的集群,这意味着训练(以及推理)可以更快且可扩展地进行,这在需要大规模实时洞察、预测与推荐时往往至关重要。
3. 模型评估与实验
Databricks 开发了一个开源工具 MLflow,并在 Databricks 平台中原生可用,它简化了跟踪实验、将代码打包为可复现运行以及共享结果的复杂过程。
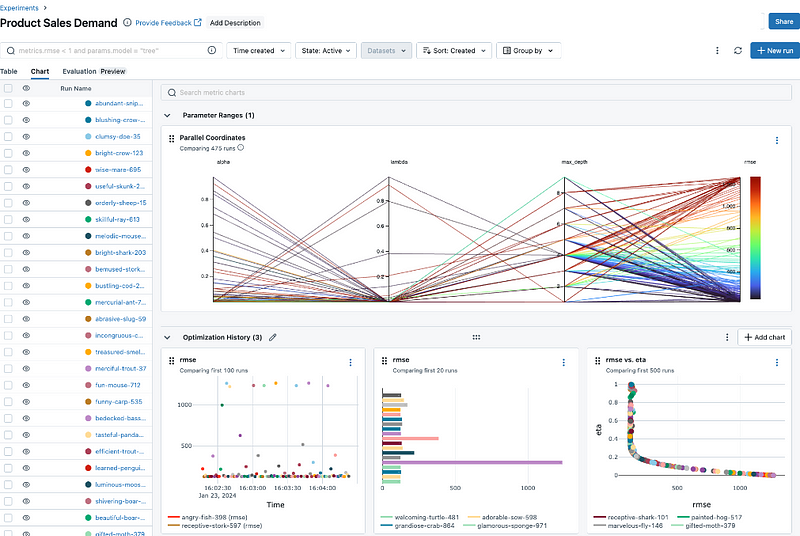
一个 MLflow 实验示例(作者截图)
创建实验框架的步骤如下:
- 安装 MLflow 并设置 tracking URI
- 创建实验
- 启动 MLflow 运行,记录参数、指标与制品
- 在同一实验下创建多次运行以进行超参数调优及其他改进
- 查看实验下各次运行的结果
- 选择最佳模型并将其转入生产
一旦建立该框架,我们就能快速迭代,尽早找到最佳模型。
4. 模型部署与 MLOps
“Model Serving” 是 Databricks Lakehouse AI 中的另一功能,它简化了将机器学习模型从开发阶段过渡到可投入生产的过程。
该功能允许将模型部署为 RESTful 端点,便于集成到各类应用与服务中,用于实时预测或批量推理。
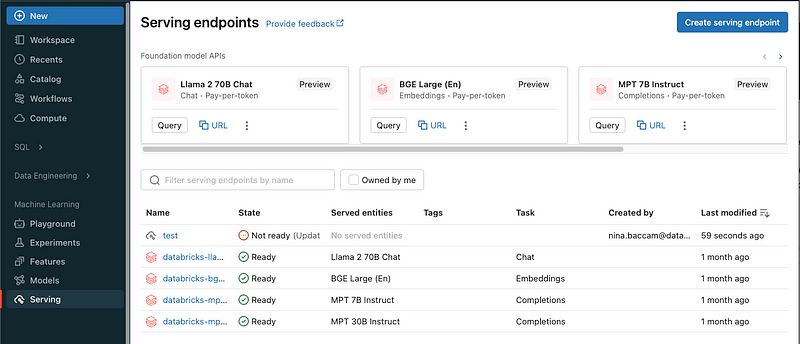
Model Serving 端点(来源)
模型训练完成后,数据科学家只需点击几下即可部署,无需繁琐设置或 DevOps 专业知识。具体步骤如下:
- 将已开发的模型记录到模型注册表(MLflow 的一项功能)
- 使用 Serving UI 为所选模型创建端点
- 查询已创建的端点
我们鼓励您参阅 Databricks 提供的详细教程示例,以轻松完成这些步骤。在现代数据工作流中,这种部署便捷性至关重要,能够快速迭代与上线模型,显著提升业务价值。
5. 监控与评估
当我们的机器学习模型上线到生产环境后,AI 生命周期中最后一个关键阶段是监控与评估。该阶段需要持续跟踪模型性能,以确保其在一段时间内仍然有效且准确。
Databricks Lakehouse AI 通过 Lakehouse Monitoring 与 Inference Tables 来实现这一点,它们是维护 AI 系统健康与成效的关键工具。鉴于我们之前已了解 Lakehouse Monitoring 的功能,本节将重点介绍推理表(Inference Tables)。
简单来说,Inference Table 是一项需要您勾选启用的附加功能,它可捕获来自 Model Serving 端点的输入数据及相应预测,并将其记录到 delta 表中,该表将成为 Unity Catalog 的一部分。
这一记录机制具有多重益处:
- 检测模型漂移:随着时间推移,模型在生产中遇到的数据可能逐渐偏离其最初训练数据。推理表可通过持续监控输入数据特征并与训练数据集进行比较,帮助团队检测这种漂移。它与 Lakehouse Monitoring 仪表板协同工作。
- 调试与根因分析:当模型预测不符合预期时,推理表提供所需的细粒度数据来理解问题所在。通过检查导致较差或意外结果的具体输入,数据科学家可以更有效地调试并优化模型。
- 合规与审计:对于金融或医疗等需要严格合规与审计流程的行业,推理表为模型的决策过程提供透明记录。这对于向利益相关者或监管机构解释决策至关重要。
机器学习开发是一个循环过程,这意味着我们会基于首次部署的反馈进行改进、再训练,构建更准确高效的模型,从而再次回到第一步。
结语
本教程介绍了 Databricks Lakehouse AI 的演进及其核心功能。我们还探讨了这些功能如何通过统一治理融合到一起。进一步地,我们分析并理解了如何使用 Databricks Lakehouse AI 平台贯穿端到端的机器学习生命周期。
若要以实践方式进一步了解 Databricks Lakehouse 及其在数据工程、机器学习开发与大规模应用构建中的应用,我们建议您将Introduction to Databricks 课程作为下一步。


Databricks 一直是构建大规模交付 AI 解决方案的技术与平台先驱之一,其中包括推动 Apache Spark 和 MLflow 等开源项目。
在 Databrick Data + AI Summit 2023 期间,Lakehouse AI 作为全球首个内置于数据层的 AI 平台发布,同时还宣布了更多新功能。随着 ChatGPT 的发布以及全球生成式 AI 技术的飞跃式发展,Lakehouse AI 是 Databrick 以数据为中心的方法来构建生成式 AI 应用的答案。
在本教程中,我们将介绍 Databricks Lakehouse AI 平台,思考其重要性,了解新发布的功能,以及如何在我们的机器学习开发生命周期中加以利用。
什么是 Databricks Lakehouse AI?
等等,Lakehouse?我们理解这对您来说可能都是新术语。
让我们一步步拆解 Databricks Lakehouse AI 的演进。要理解 Lakehouse AI,我们首先需要充分理解 Lakehouse 架构。
什么是 Lakehouse?
“Lakehouse” 是一种现代数据管理架构,它将数据湖的灵活性与成本效益,与数据仓库的数据管理特性相结合。
我们有一篇关于数据湖与数据仓库差异的完整教程,简而言之,含义如下:
数据湖架构(来源)
数据仓库架构(来源)
数据湖由于存储大量原始、非结构化数据,常在数据管理与治理方面面临挑战,容易演变为“数据沼泽”,使数据难以查找、访问或信任。缺乏结构也会阻碍复杂分析查询的性能,且传统数据湖通常不支持良好的事务型数据操作,缺少 ACID 事务能力,而这对确保数据完整性至关重要。
另一方面,数据仓库针对结构化数据与分析进行了优化,但随着数据量增长,其扩展成本可能高得难以承受。要求数据被处理成预定义模式会带来刚性,限制了对新数据类型的快速摄取与分析。
这些局限推动了 Lakehouse 架构的演进,其目标是兼具两者之长:
以下是 Lakehouse 架构的样子:
数据 Lakehouse 架构(来源)
现在我们理解了 Databricks Lakehouse 的演进,就来到最后一个问题。
什么是 Lakehouse AI?
Lakehouse AI 是将人工智能与机器学习能力直接集成进 Lakehouse 架构。这意味着我们可以使用存储在数据湖中的海量数据来开发、训练与部署 AI 模型,而无需将数据移动或复制到单独的处理环境。
该平台的重要性在于:
这些功能解释了为何 Databricks 将此平台称为全球首个内置于数据层的 AI 平台。
Lakehouse AI 的核心组件
向 Lakehouse AI 的转型,推动企业更加数据驱动并与 AI 深度融合的运营方式。
这场变革的核心是若干组件,它们促进 AI 与机器学习模型的开发、部署与管理。理解这些组件为何以及何时需要,有助于组织更有效地将数据用于 AI 应用。
向量检索(Vector Search)
Databricks Lakehouse AI 中的向量检索(同样在 2023 年 Data+AI Summit 发布)是在处理与检索海量数据集方面的一次重大进步,它用于查找语义相似的信息,而不是依赖传统的关键词匹配。
向量检索通过将数据与查询转换为多维空间中的向量(即嵌入),这些嵌入来自生成式 AI 模型。该方法使语义相近的词或概念在 n 维空间中距离更近,从而提供更相关、具备上下文意识的搜索结果。
向量检索(作者截图)
使用向量检索的流程(Databricks 演示视频)如下:
例如,Lippert 等公司已通过将来自各渠道的内容导入向量检索,帮助坐席快速找到客户咨询的答案。
精选模型(Curated Models)
这些模型可在 Databricks Marketplace 获取,经过性能优化,易于集成到 Lakehouse 环境中,适用于从文本分析与生成到图像处理等多种应用。
部分精选的生成式 AI 模型包括:
Databricks Marketplace 中可用的模型(作者截图)
这些模型与 Databricks Lakehouse AI 更广泛的功能集无缝协作,包括数据管理、分析与 MLOps 工具。稍后我们将看到如何在机器学习开发中使用这些模型。
AutoML
Databricks Lakehouse AI 中的 AutoML(自动化机器学习)旨在简化并自动化机器学习模型的开发流程,使更广泛的用户(包括缺乏机器学习专业知识的人)也能开展高级数据科学工作。
Databrick AutoML(来源)
当我们提供数据集并指定预测目标后,AutoML 会负责为模型训练准备数据集。随后,它会通过一系列试验创建、调优并评估多个模型。
评估完成后,AutoML 会呈现结果,并提供包含每次试验源代码的 Python 笔记本。这样我们就可以按需审阅、复现实验并进行修改。AutoML 还会计算数据集的汇总统计信息,并将其保存到笔记本中以备后用。
在最新版本中,AutoML 现已支持使用客户自有数据对生成式 AI 的文本分类模型与嵌入模型进行微调。这意味着非技术的业务用户也可通过几次点击,用 AutoML 构建生成式 AI 应用。
Lakehouse 监控
Databricks Lakehouse Monitoring 使我们能够监控数据表的统计特性与质量,并跟踪机器学习模型及其预测的性能。通过审视 Databricks 流水线中的数据流动,该监控功能有助于确保持续监控数据质量与模型效果。
以下展示了数据如何在 Lakehouse 监控中流动,从而实现持续监控:
Lakehouse 监控流程(来源)
该功能不止于监控,还会在数据完整性、分布、漂移以及模型随时间的性能等多方面提供可操作的洞见。
现在让我们看看这些功能如何在 Lakehouse AI 中以统一治理的方式汇聚在一起。
统一治理在 Lakehouse AI 中的作用
统一治理的理念是在同一处访问、控制、协作、监控并对数据、机器学习模型及其他 AI 资产采取行动。随着组织在 AI 转型之旅中的成长与成熟,能够在一个地方管理一切至关重要。
Databricks Unity Catalog 正是为此而生,以统一的方式治理 AI 资产,在确保合规性的同时加速 AI 采用。
除了数据浏览器和添加外部系统的能力等实用功能外,最突出的功能是可以通过简单的 Unity Catalog 治理门户从全局视角审视这些资产的整体治理状况,如下图所示:
Unity Catalog 治理门户(作者截图)
该门户显示关键指标,例如受治理与受监控表的百分比、活跃用户数量,以及表、卷与 ML 模型的数量。此高层视图有助于快速评估治理状态与对数据资产的活跃使用程度。
该仪表板还展示用户随时间的活跃度,有助于了解组织内部对数据资产的使用情况,并识别潜在瓶颈或培训需求。
此外,该门户通过识别未监控的表或源自 PII(个人可识别信息)的列等问题,列出潜在治理风险,从而以主动方式安全管理数据,如下图所示。
Unity Catalog 仪表板的治理待办视图(作者截图)
每个识别出的问题都会附带推荐操作,引导用户解决潜在的治理隐患。此功能简化并统一了平台上 AI 与数据资产往往复杂的治理流程。
现在我们了解了平台功能及其协同方式,接下来深入其在端到端机器学习开发中的应用。
在 Databricks Lakehouse AI 上的端到端机器学习开发
若需回顾端到端的机器学习开发生命周期,建议参考我们的深度教程。在本节中,我们将理解 Databricks Lakehouse AI 的功能如何融入该生命周期。
端到端机器学习开发(来源)
1. 数据准备与特征工程
在 Databricks Lakehouse AI 中进行机器学习的基石,是高效训练与构建模型的能力。
我们可以使用包含 pandas 与 PySpark 等常用包的 Databricks ML runtime 进行数据准备与清洗。Databricks Feature Store 是 Databricks Lakehouse AI 平台中的集中式存储库,用于存储、共享与管理机器学习特征。
该特征库确保训练机器学习模型所用的特征与生产环境推理时所用一致。我们也无需为不同用例反复重新计算特征,避免浪费计算资源。
特征库的作用(来源)
通过集中化的特征定义与存储,它消除了常见的“训练-服务偏移”问题,即模型训练时使用的数据与模型在生产中遇到的数据不一致。
2. 模型工程
在模型开发方面,我们既可以选择 Databricks 环境内的预构建精选模型,也可以根据特定数据与业务需求训练自定义模型。
Databricks 还提供针对 GPU 优化的集群,这意味着训练(以及推理)可以更快且可扩展地进行,这在需要大规模实时洞察、预测与推荐时往往至关重要。
3. 模型评估与实验
Databricks 开发了一个开源工具 MLflow,并在 Databricks 平台中原生可用,它简化了跟踪实验、将代码打包为可复现运行以及共享结果的复杂过程。
一个 MLflow 实验示例(作者截图)
创建实验框架的步骤如下:
一旦建立该框架,我们就能快速迭代,尽早找到最佳模型。
4. 模型部署与 MLOps
“Model Serving” 是 Databricks Lakehouse AI 中的另一功能,它简化了将机器学习模型从开发阶段过渡到可投入生产的过程。
该功能允许将模型部署为 RESTful 端点,便于集成到各类应用与服务中,用于实时预测或批量推理。
Model Serving 端点(来源)
模型训练完成后,数据科学家只需点击几下即可部署,无需繁琐设置或 DevOps 专业知识。具体步骤如下:
我们鼓励您参阅 Databricks 提供的详细教程示例,以轻松完成这些步骤。在现代数据工作流中,这种部署便捷性至关重要,能够快速迭代与上线模型,显著提升业务价值。
5. 监控与评估
当我们的机器学习模型上线到生产环境后,AI 生命周期中最后一个关键阶段是监控与评估。该阶段需要持续跟踪模型性能,以确保其在一段时间内仍然有效且准确。
Databricks Lakehouse AI 通过 Lakehouse Monitoring 与 Inference Tables 来实现这一点,它们是维护 AI 系统健康与成效的关键工具。鉴于我们之前已了解 Lakehouse Monitoring 的功能,本节将重点介绍推理表(Inference Tables)。
简单来说,Inference Table 是一项需要您勾选启用的附加功能,它可捕获来自 Model Serving 端点的输入数据及相应预测,并将其记录到 delta 表中,该表将成为 Unity Catalog 的一部分。
这一记录机制具有多重益处:
机器学习开发是一个循环过程,这意味着我们会基于首次部署的反馈进行改进、再训练,构建更准确高效的模型,从而再次回到第一步。
结语
本教程介绍了 Databricks Lakehouse AI 的演进及其核心功能。我们还探讨了这些功能如何通过统一治理融合到一起。进一步地,我们分析并理解了如何使用 Databricks Lakehouse AI 平台贯穿端到端的机器学习生命周期。
若要以实践方式进一步了解 Databricks Lakehouse 及其在数据工程、机器学习开发与大规模应用构建中的应用,我们建议您将Introduction to Databricks 课程作为下一步。