

分类数据集
信息通常用两种不同形式来表示:分类数据和数值数据。可以被分类或分组在一起的数据称为分类数据。男性和女性属于性别类别,红、绿、蓝属于颜色类别,国家类别可能包括美国、加拿大、墨西哥等。
数值数据是指可用数字表示的数据。数值数据的示例包括身高、体重和温度。
简单来说,分类数据是可以被放入类别中的信息,而数值数据是可以用数字表示的信息。由于大多数机器学习算法都是为数值数据而设计的,因此在该领域中分类数据的处理方式与数值数据不同。在将分类数据用作机器学习模型的输入之前,必须先将其转换为数值数据。将分类数据转换为数值表示的过程称为编码。
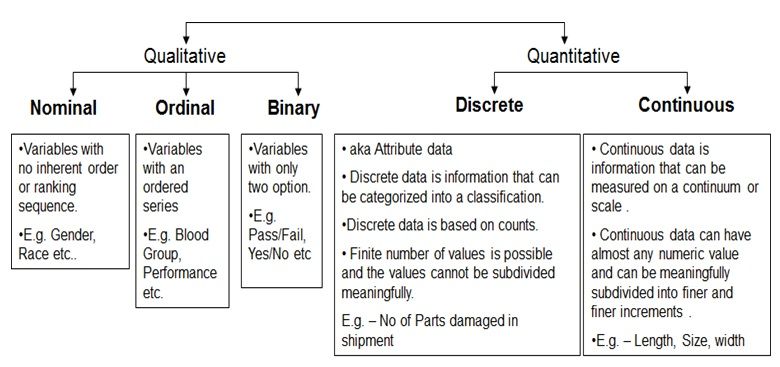
定性与定量数据 - 图片来源
分类数据分为两类:名义型和有序型。
名义数据
名义数据是可以划分为若干组但这些组没有内在层级或顺序的分类数据。示例包括品牌名称(Coca-Cola、Pepsi、Sprite)、披萨配料种类(意大利腊肠、蘑菇、洋葱)和发色(金色、棕色、黑色等)。查看我们的名义变量指南了解更多信息。
有序数据
另一方面,有序数据描述的是既可分类又具有明确顺序或等级的信息。教育程度(高中、本科、硕士)、工作满意度水平(非常满意、满意、中立、不满意、非常不满意)以及星级评分(1 星、2 星、3 星、4 星、5 星)都是有序数据的示例。
通过为每个类别赋予反映其顺序或等级的数值,有序数据可以转换为数值数据并用于机器学习。对于对输入数据大小敏感的算法,这可能很有帮助。
在实践中,名义数据与有序数据的区分并不总是显而易见,且可能因具体用例而异。例如,有些人可能认为“星级评分”是有序数据,而另一些人则将其视为名义数据。最重要的是了解您数据的性质,并选择最能体现数据中关系的编码策略。
了解 pandas 中的数据类型
广受欢迎的 Python 开源库 pandas 用于数据分析与处理。它在处理结构化数据方面功能强大,例如可处理带有行列标签的表格数据的数据框和序列。
pandas 还提供了多种读取和写入不同文件类型(csv、parquet、数据库等)的函数。当您使用 pandas 读取文件时,每一列都会基于推断被分配一个数据类型。以下是 pandas 可能分配的所有数据类型:
- 数值型:包括整数和浮点数。数值数据通常用于定量分析和数学运算。
- 字符串:用于表示文本数据,如姓名、地址和描述。
- 布尔型:该数据类型只有两个可能的值:True 或 False。布尔数据常用于逻辑运算和过滤。
- 日期时间:用于表示日期和时间。pandas 拥有强大的日期时间数据处理工具。
- 分类型:表示取有限个值的数据。分类数据常用于分组与聚合。
- 对象型:用于表示不属于其他类别的数据的兜底类型。它可以包含多种不同数据类型,如列表、字典和其他对象。

在 pandas 中,category 和 object 数据类型用于表示不适合归入其他数据类型的数据,包括字符串、混合类型或其他对象。但它们之间有一些重要差异,会影响功能与性能。
分类数据类型
分类数据类型是为只有少数可能取值的信息(如类别或标签)而设计的。在内部,分类数据表示为一组数字,与相应的对象类型相比,这可以加快某些操作并节省内存。此外,分类数据可以进行逻辑排序,并有助于高效的分组与聚合操作。
对象数据类型
另一方面,对象数据类型是那些不适用于其他数据类型的信息的兜底类型。它可以包含许多不同的数据类型,例如列表、字典和其他对象。尽管对象数据具有很强的灵活性,但与相同规模的分类数据相比,它可能更慢、占用更多内存,并且无法使用某些可用于分类数据的专门操作。
一般来说,如果您的数据只有少数可能取值,并计划进行大量分组或聚合操作,可以考虑使用分类数据类型。其他情况下,使用对象数据类型通常是稳妥的选择。不过,理想的数据类型最终还是取决于您的具体用例和数据特性。
让我们通过读取一份来自 GitHub 的csv 文件来看看示例。
# read csv using pandas
data = pd.read_csv(‘https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv’)
# check the head of dataframe
data.head()输出:
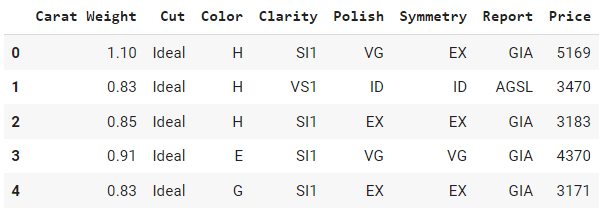
您能分辨这些列中哪些是分类型,哪些是数值型吗?在此示例中,除“Carat Weight”和“Price”外,其他列都是分类变量。我们通过检查默认数据类型来验证一下。
# check the data types
data.dtypes输出:

注意到“Price”被分配为“int64”类型,“Carat Weight”为“float64”,其余列为对象类型,正如我们所预期的那样。
在 Python 中分析分类特征
pandas 是 Python 中流行的数据分析库,其中有一些函数可让您快速分析数据集中分类数据类型。我们逐一来看:
Value Counts
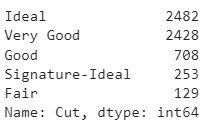
pandas 库中的 value_counts() 函数返回分类数据列中每个唯一值的出现频数。当您想快速了解某个分类变量的分布(如最常见的类别及其频数)时,该函数非常有用。
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# check value counts of Cut column
data['Cut'].value_counts()输出:
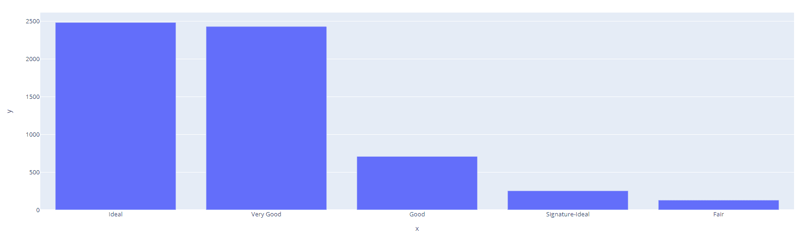
如果您想可视化分布,可以使用 plotly 库绘制交互式柱状图。
import plotly.express as px
cut_counts = data['Cut'].value_counts()
fig = px.bar(x=cut_counts.index, y=cut_counts.values)
fig.show()输出:
分组(Group by)
Pandas 中的 groupby() 函数可按一个或多个列对数据进行分组,并应用聚合函数,如求和、均值和计数。当您想对分类数据进行更复杂的分析(例如计算每个类别对应的某个数值变量的平均值)时,该函数很有用。来看一个示例:
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# average carat weight and price by Cut
data.groupby(by = 'Cut').mean()输出:
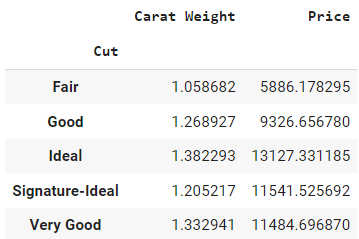
它只会返回仅包含数值列的数据框。groupby 方法中的 by 参数用于指定要执行分组操作的列,括号外的 mean() 则是聚合方法。
可以这样解读输出:切工为 Fair 的钻石平均价格为 5,886,平均重量为 1.05;相比之下,切工为 Very Good 的钻石平均价格为 11,485。
交叉列联表(Cross tab)
pandas 中的 crosstab() 函数用于创建交叉列联表,它展示两个或多个分类变量的频数分布。当您想查看两个或多个分类变量之间的关系(例如一个变量的频数如何与另一个变量相关)时,该函数很有用。
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# cross tab of Cut and Color
pd.crosstab(index=data['Cut'], columns=data['Color'])
输出:
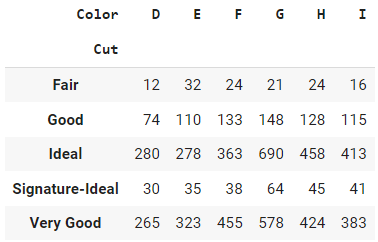
pandas 的 crosstab 函数输出的是一个表格,展示两个或更多分类变量的频数分布。表格的每一行代表某个变量的一个唯一类别,每一列代表另一个变量的一个唯一类别,表格中的条目则是这两个变量类别组合的频数。
数据透视表(Pivot Table)
Pandas 中的 pivot_table() 函数用于创建数据透视表,它类似于交叉列联表,但更灵活。当您想要分析多个分类变量与一个或多个数值变量之间的关系时,数据透视表非常有用。它允许以多种方式聚合数据,并以紧凑的形式展示结果。
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# create pivot table
pd.pivot_table(data, values='Price', index='Cut', columns='Color', aggfunc=np.mean)
输出:
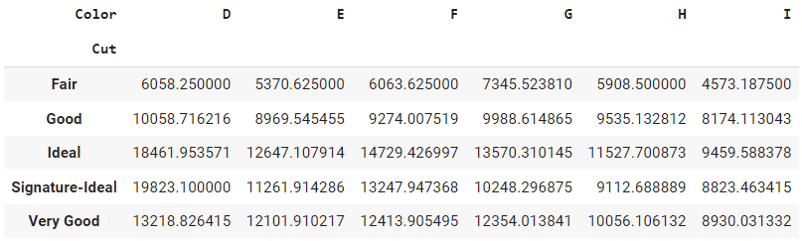
该表按颜色展示了每种钻石切工的平均价格。行代表不同的钻石切工,列代表不同的钻石颜色,表格中的条目是钻石的平均价格。
pivot_table 函数在您希望以表格形式汇总并比较多个变量上的数值数据时非常有用。它允许使用多种函数(如均值、求和、计数等)对数据进行聚合,并将其组织成便于阅读与分析的格式。
在 Python 中对分类特征进行编码
大多数机器学习算法主要是为数值数据设计的,因此通常无法直接处理分类数据。因此,在将分类特征用作机器学习算法输入之前,必须先将其编码为数值。
常见的分类特征编码技术包括独热编码(one-hot encoding)、有序编码(ordinal encoding)和目标编码(target encoding)。选择哪种编码技术取决于数据的具体特性以及所用机器学习算法的要求。
独热编码
独热编码是一种将分类数据表示为一组二进制值的过程,其中每个类别映射到一个唯一的二进制向量。在这种表示中,只有一个比特被设为 1,其余为 0,因此称为“one hot”。这通常用于机器学习中,将分类数据转换为算法可处理的格式。
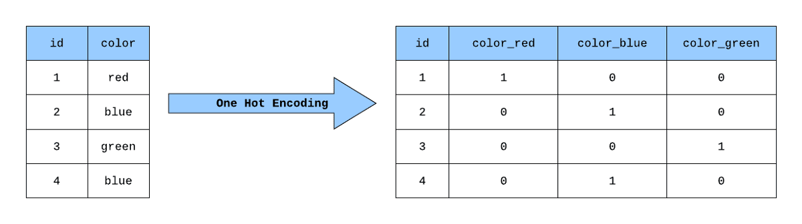
pandas 将分类转换为数值
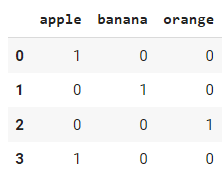
在 pandas 中实现这一点的一种方式是使用 pd.get_dummies() 方法。它是 Pandas 库中的一个函数,可对数据框中的分类变量执行独热编码。它接收一个数据框并返回一个新的数据框,其中为每个类别创建二进制列。以下是使用示例:
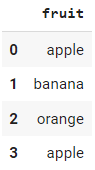
假设我们有一个包含“fruit”列(为分类数据)的数据框:
import pandas as pd
# generate df with 1 col and 4 rows
data = {
"fruit": ["apple", "banana", "orange", "apple"]
}
# show head
df = pd.DataFrame(data)
df.head()
输出:
# apply get_dummies function
df_encoded = pd.get_dummies(df["fruit"])
df_encoded .head()
输出:
尽管 pandas.get_dummies 使用起来很直接,但在进行机器学习任务时,更常见的做法是使用 sklearn 库中的 OneHotEncoder。主要区别在于 pandas.get_dummies 不能“学习”编码;它只能对您传入的数据集执行独热编码。相反,sklearn.OneHotEncoder 是一个类,可以保存并在未来用于转换其他传入的数据集。
import pandas as pd
# generate df with 1 col and 4 rows
data = {
"fruit": ["apple", "banana", "orange", "apple"]
}
# one-hot-encode using sklearn
from sklearn.preprocessing import OneHotEncoder
encoder = OneHotEncoder()
encoded_results = encoder.fit_transform(df).toarray()
输出:
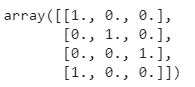
标签编码
标签编码是一种将分类变量编码为数值的技术,每个类别被分配一个唯一的整数。例如,假设我们有一个包含三个类别的分类变量“color”:“red”、“green” 和 “blue”。我们可以按如下方式进行标签编码(red: 0,green: 1,blue: 2)。
标签编码对于某些需要数值输入的机器学习算法很有用,因为它可以让分类数据以算法能够理解的方式表示。但需要注意的是,标签编码会引入类别的任意排序,这种排序未必反映它们之间任何有意义的关系。在某些情况下,如果这种排序被解读为具有某种序关系,可能会导致分析问题。
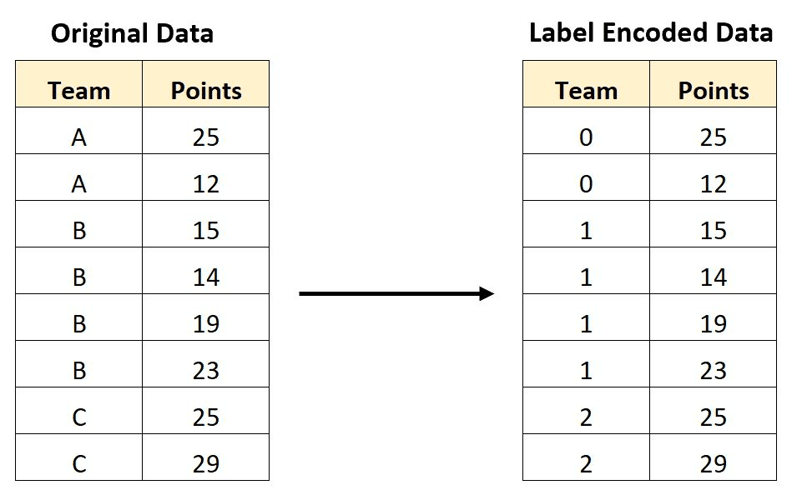
标签编码后的数据。图片来源
独热编码与标签编码的比较
独热编码和标签编码都是将分类变量编码为数值的技术,但它们具有不同的特性,适用于不同的用例。
独热编码将每个类别表示为一个二进制列,其中 1 表示该类别出现,0 表示未出现。例如,假设我们有一个包含三个类别的分类变量“color”:“red”、“green”和“blue”。独热编码会将该变量表示为三个二进制列:

当各类别之间没有内在顺序或关系时,独热编码是合适的选择。这是因为独热编码将每个类别视为相互独立的实体,与其他类别无关。当类别数量相对较少时,独热编码也很实用,因为在类别非常多的情况下,列数可能会变得难以管理。
另一方面,标签编码将每个类别表示为一个唯一的整数。例如,具有三个类别的“color”变量可以被标签编码为:

当类别之间具有自然的顺序或关系(例如“small”、“medium”、“large”等有序变量)时,标签编码是合适的。在这些情况下,分配给类别的整数应反映类别的顺序。当类别数量非常多时,标签编码也很有用,因为它降低了数据的维度。
总体而言,独热编码在机器学习应用中更为常见,因为它更灵活,并且避免了标签编码可能带来的歧义和任意排序问题。不过,在类别具有自然顺序或需要处理非常多类别的场景中,标签编码也有其用武之地。
处理高基数分类数据
高基数指的是某个分类特征中存在大量唯一类别。在为机器学习模型对分类数据进行编码时,处理高基数是一个常见挑战。高基数会导致稀疏的数据表示,并可能对某些机器学习模型的性能产生负面影响。以下是一些可用于处理分类特征高基数的技术:
合并稀有类别
将出现频率较低的类别合并为一个类别。这可以减少唯一类别数量,同时降低数据表示的稀疏性。
目标编码
目标编码用该类别对应的目标均值替换分类取值。它为分类数据提供了更连续的表示,并有助于捕捉分类特征与目标变量之间的关系。
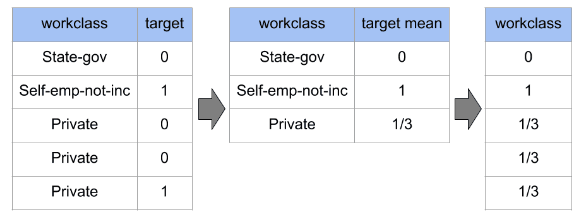
证据权重(WOE)编码
证据权重编码与目标编码类似,但它会考虑每个类别中目标变量的分布。某个类别的 WOE 计算为该类别目标均值与总体均值之比的对数。
分类数据的特征工程
特征工程是为机器学习模型准备数据的重要步骤。它涉及从现有特征创建新特征,以提升模型性能。以下是对分类数据进行特征工程的几种方法:
创建交互变量
交互变量是通过组合两个或更多现有特征创建的新特征。例如,如果我们有两个分类特征“Gender”和“Marital Status”,可以创建一个新特征“Gender-Marital Status”来捕捉二者之间的交互。这有助于捕捉特征与目标变量之间的非线性关系。
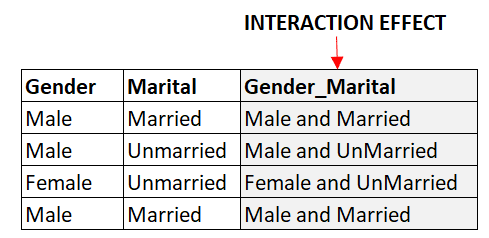
对数值变量进行分箱
分箱是将连续型数值变量划分为离散箱(区间)的过程。这有助于减少特征中的唯一取值数量,有利于对分类数据进行编码。分箱还可以帮助捕捉特征与目标变量之间的非线性关系。
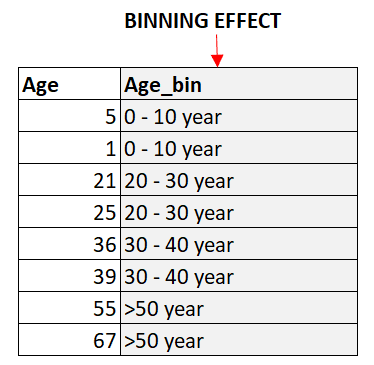
对周期性变量进行编码
周期性变量是在特定周期内重复的变量。例如,一天中的小时数是周期性变量,因为它每 24 小时重复一次。对周期性变量进行编码可以帮助捕捉数据中的周期性模式。一种常见做法是创建两个新特征:一个为该变量的正弦值,另一个为余弦值。
结论
在许多机器学习项目中,处理分类数据是一个重要环节。在本教程中,我们探讨了在 Python 中分析与编码分类变量的多种技术,包括两种常用方法:独热编码与标签编码。
我们首先介绍了分类数据的概念,以及为何在机器学习模型中妥善处理它很重要。随后,我们提供了使用 pandas 和 scikit-learn 执行独热编码的分步指南,并配以代码示例来说明过程。
本教程还讨论了一些高级概念,例如应对高基数分类数据、特征工程、WOE 编码等。如果您想更深入学习该主题,请查看我们的课程 Working with Categorical Data in Python。
如果您更偏好 R 语言,您可能会对我们的课程 Categorical Data in the Tidyverse 或 Inference for Categorical Data in R 感兴趣。这两门课程对 R 用户都非常出色。
图片来源
简介
可以被归类但本身不具备内在层级或顺序的数据称为分类数据。换句话说,各类别之间没有数学上的关联。一个人的性别(男/女)、眼睛颜色(蓝、绿、棕等)、驾驶的车辆类型(轿车、SUV、卡车等)或食用的水果种类(苹果、香蕉、橙子等)都是分类数据的示例。
在本教程中,我们将概述分类数据的处理与预处理方法。在讨论为机器学习模型准备分类数据的重要性之前,我们将先定义分类数据及其类型。此外,我们还将介绍多种编码方法、在 Python 中进行分类数据分析与可视化的方法,以及高基数分类数据与不同编码方法等更高级的概念。