

श्रेणीबद्ध डेटासेट
जानकारी दो प्रकार के डेटा रूपों में प्रस्तुत की जाती है: श्रेणीबद्ध डेटा और संख्यात्मक डेटा। वह डेटा जिसे वर्गीकृत या समूहित किया जा सकता है, श्रेणीबद्ध डेटा कहलाता है। पुरुष और महिलाएं लिंग श्रेणी में आते हैं, लाल, हरा और नीला रंगों की श्रेणी में आते हैं, और देशों की श्रेणी में US, Canada, Mexico आदि आ सकते हैं।
संख्यात्मक डेटा वह है जिसे किसी संख्या के रूप में व्यक्त किया जा सकता है। ऊंचाई, वजन और तापमान संख्यात्मक डेटा के उदाहरण हैं।
सरल शब्दों में, श्रेणीबद्ध डेटा वह जानकारी है जिसे श्रेणियों में रखा जा सकता है, जबकि संख्यात्मक डेटा वह जानकारी है जिसे संख्या के रूप में व्यक्त किया जा सकता है। चूंकि अधिकांश मशीन लर्निंग एल्गोरिदम संख्यात्मक डेटा के साथ काम करने के लिए बनाए जाते हैं, इसलिए इस क्षेत्र में श्रेणीबद्ध डेटा का व्यवहार संख्यात्मक डेटा से अलग होता है। मशीन लर्निंग मॉडल के इनपुट के रूप में श्रेणीबद्ध डेटा का उपयोग करने से पहले, उसे संख्यात्मक डेटा में बदला जाना चाहिए। श्रेणीबद्ध डेटा को संख्यात्मक अभ्यRepresentation में बदलने की इस प्रक्रिया को एन्कोडिंग कहते हैं।
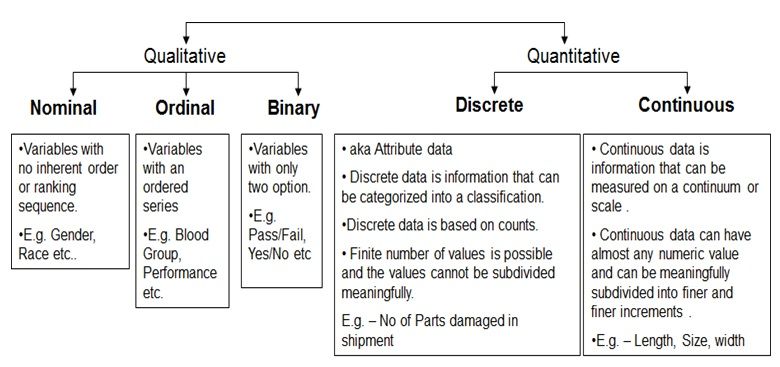
गुणात्मक और मात्रात्मक डेटा - छवि स्रोत
श्रेणीबद्ध डेटा दो प्रकार का होता है: नोमिनल और ऑर्डिनल।
Nominal डेटा
Nominal डेटा वह श्रेणीबद्ध डेटा है जिसे समूहों में बांटा जा सकता है, परंतु इन समूहों में कोई अंतर्निहित पदानुक्रम या क्रम नहीं होता। उदाहरण हैं ब्रांड नाम (Coca-Cola, Pepsi, Sprite), पिज़्ज़ा टॉपिंग्स के प्रकार (पेपरॉनी, मशरूम, प्याज़), और बालों का रंग (गोरा, भूरा, काला, आदि)। अधिक जानने के लिए हमारे nominal variables पर गाइड को देखें।
Ordinal डेटा
दूसरी ओर, Ordinal डेटा वह जानकारी दर्शाता है जिसे श्रेणियों में बांटा जा सकता है और जिसका एक स्पष्ट क्रम या रैंकिंग होती है। शिक्षा के स्तर (हाई स्कूल, बैचलर, मास्टर), नौकरी संतुष्टि के स्तर (बेहद संतुष्ट, संतुष्ट, तटस्थ, असंतुष्ट, बहुत असंतुष्ट), और स्टार रेटिंग (1-स्टार, 2-स्टार, 3-स्टार, 4-स्टार, 5-स्टार) Ordinal डेटा के कुछ उदाहरण हैं।
प्रत्येक श्रेणी को एक संख्यात्मक मान देकर जो उसके क्रम या रैंकिंग को दर्शाता है, Ordinal डेटा को संख्यात्मक डेटा में बदला जा सकता है और मशीन लर्निंग में उपयोग किया जा सकता है। यह उन एल्गोरिदम के लिए उपयोगी हो सकता है जो इनपुट डेटा के परिमाण के प्रति संवेदनशील होते हैं।
व्यवहार में Nominal और Ordinal डेटा के बीच का अंतर हमेशा स्पष्ट नहीं होता और यह विशेष उपयोग-केस पर निर्भर कर सकता है। उदाहरण के लिए, कुछ लोग "स्टार रेटिंग" को Ordinal डेटा मान सकते हैं, जबकि अन्य इसे Nominal डेटा समझ सकते हैं। सबसे महत्वपूर्ण बात यह है कि आप अपने डेटा की प्रकृति से अवगत हों और वह एन्कोडिंग रणनीति चुनें जो आपके डेटा में संबंधों को सबसे अच्छी तरह पकड़ती हो।
pandas में डेटा प्रकारों को समझना
pandas एक व्यापक रूप से प्रयुक्त ओपन-सोर्स Python लाइब्रेरी है, जिसका उपयोग डेटा विश्लेषण और हेरफेर के लिए किया जाता है। इसमें संरचित डेटा से निपटने के लिए शक्तिशाली क्षमताएं हैं, जैसे डेटा फ्रेम और सीरीज़, जो लेबल युक्त पंक्तियों और स्तंभों वाले सारणीबद्ध डेटा को संभाल सकते हैं।
pandas विभिन्न फाइल प्रकारों (csv, parquet, database, आदि) को पढ़ने और लिखने के लिए कई फ़ंक्शन भी प्रदान करता है। जब आप pandas का उपयोग करके कोई फाइल पढ़ते हैं, तो प्रत्येक कॉलम को अनुमान के आधार पर एक डेटा प्रकार सौंपा जाता है। यहां वे सभी डेटा प्रकार हैं जिन्हें pandas संभावित रूप से सौंप सकता है:
- Numeric: इसमें पूर्णांक और फ्लोटिंग-पॉइंट संख्याएं शामिल हैं। संख्यात्मक डेटा आम तौर पर परिमाणात्मक विश्लेषण और गणितीय परिचालनों के लिए उपयोग होता है।
- String: यह डेटा प्रकार नाम, पते और विवरण जैसी पाठ्य सामग्री को दर्शाने के लिए उपयोग होता है।
- Boolean: इस डेटा प्रकार में केवल दो संभावित मान हो सकते हैं: True या False। Boolean डेटा अक्सर तर्कसंगत परिचालनों और फ़िल्टरिंग के लिए उपयोग होता है।
- Datetime: यह डेटा प्रकार दिनांक और समय को दर्शाने के लिए उपयोग होता है। pandas में datetime डेटा को संसाधित करने के लिए शक्तिशाली उपकरण हैं।
- Categorical: यह डेटा प्रकार उन डेटा का प्रतिनिधित्व करता है जो सीमित संख्या के मान लेते हैं। श्रेणीबद्ध डेटा अक्सर समूहकरण और समेकन (aggregation) के लिए उपयोग होता है।
- Object: यह डेटा प्रकार उन डेटा के लिए कैच-ऑल है जो अन्य श्रेणियों में फिट नहीं होते। इसमें सूचियां (lists), डिक्शनरीज़ और अन्य ऑब्जेक्ट्स जैसे विविध प्रकार शामिल हो सकते हैं।

pandas में category और object डेटा प्रकार उन डेटा का प्रतिनिधित्व करते हैं जो अन्य प्रकारों में फिट नहीं होते, जिनमें स्ट्रिंग्स, मिश्रित प्रकार या अन्य ऑब्जेक्ट्स शामिल हैं। हालांकि, उनमें कुछ महत्वपूर्ण अंतर हैं जो उनके काम करने और प्रदर्शन पर असर डालते हैं।
Categorical डेटा प्रकार
श्रेणीबद्ध डेटा प्रकार उन जानकारियों के लिए बनाया गया है जिनके केवल कुछ ही संभावित मान होते हैं, जैसे श्रेणियां या लेबल। आंतरिक रूप से, श्रेणीबद्ध डेटा को संख्याओं के संग्रह के रूप में दर्शाया जाता है, जो कुछ परिचालनों को तेज कर सकता है और समान object डेटा प्रकार की तुलना में मेमोरी की बचत कर सकता है। इसके अतिरिक्त, श्रेणीबद्ध डेटा को तार्किक रूप से क्रमबद्ध किया जा सकता है और यह कुशल समूहकरण और समेकन प्रक्रियाओं में सहायक होता है।
Object डेटा प्रकार
दूसरी ओर, object डेटा प्रकार उन जानकारियों के लिए कैच-ऑल के रूप में कार्य करता है जो अन्य डेटा प्रकारों में फिट नहीं होतीं। यह कई भिन्न प्रकार के डेटा जैसे सूचियां, डिक्शनरीज़ और अन्य ऑब्जेक्ट्स शामिल कर सकता है। यद्यपि object डेटा में बहुत लचीलापन होता है, यह समान आकार के श्रेणीबद्ध डेटा की तुलना में धीमा हो सकता है और अधिक मेमोरी ले सकता है, और श्रेणी डेटा के साथ संभव कुछ विशेष परिचालनों के अधीन नहीं हो सकता।
सामान्यतः, यदि आपके डेटा में संभावित मानों की संख्या कम है और आप बहुत सारा समूहकरण या समेकन करने की योजना बना रहे हैं, तो आप श्रेणीबद्ध डेटा प्रकार का उपयोग करने पर विचार कर सकते हैं। अन्य सभी मामलों में object डेटा प्रकार आमतौर पर सुरक्षित विकल्प होता है। हालांकि, आदर्श डेटा प्रकार अंततः आपके विशिष्ट उपयोग-केस और आपके डेटा की विशेषताओं पर निर्भर करता है।
आइए GitHub से एक csv फाइल पढ़कर उदाहरण देखते हैं।
# read csv using pandas
data = pd.read_csv(‘https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv’)
# check the head of dataframe
data.head()आउटपुट:
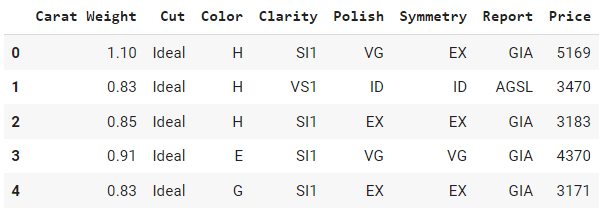
क्या आप पहचान सकते हैं कि इनमें से कौन-से कॉलम श्रेणीबद्ध हैं और कौन-से संख्यात्मक? खैर, इस उदाहरण में `Carat Weight` और `Price` को छोड़कर सभी कॉलम श्रेणीबद्ध हैं। आइए डिफ़ॉल्ट डेटा प्रकारों की जांच करके देखें कि क्या हम सही हैं।
# check the data types
data.dtypesआउटपुट:

ध्यान दें कि `Price` को `int64` प्रकार सौंपा गया है, `Carat Weight` को `float64`, और शेष कॉलम object हैं—बिल्कुल जैसा हमने अपेक्षित किया था।
Python में श्रेणीबद्ध फीचर्स का विश्लेषण
Python की लोकप्रिय डेटा विश्लेषण लाइब्रेरी pandas में कुछ फ़ंक्शन हैं जो आपको अपने डेटासेट में श्रेणीबद्ध डेटा प्रकारों का तेज़ी से विश्लेषण करने देते हैं। आइए उन्हें एक-एक करके देखें:
Value Counts
`value_counts()` pandas का एक फ़ंक्शन है जो किसी श्रेणीबद्ध कॉलम में प्रत्येक यूनिक मान की आवृत्ति लौटाता है। यह फ़ंक्शन तब उपयोगी है जब आप किसी श्रेणीबद्ध चर के वितरण, जैसे सबसे सामान्य श्रेणियां और उनकी आवृत्ति, को जल्दी समझना चाहते हैं।
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# check value counts of Cut column
data['Cut'].value_counts()आउटपुट:
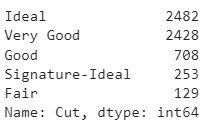
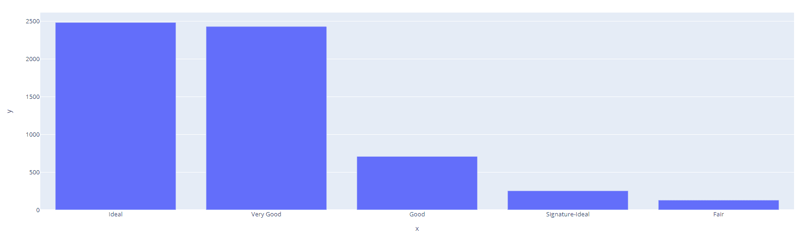
यदि आप वितरण का विज़ुअलाइज़ेशन करना चाहते हैं तो आप `plotly` लाइब्रेरी का उपयोग करके एक इंटरैक्टिव बार प्लॉट बना सकते हैं।
import plotly.express as px
cut_counts = data['Cut'].value_counts()
fig = px.bar(x=cut_counts.index, y=cut_counts.values)
fig.show()आउटपुट:
Group by
`groupby()` Pandas का एक फ़ंक्शन है जो आपको एक या अधिक कॉलम के आधार पर डेटा को समूहित करने और sum, mean, count जैसी समेकन फ़ंक्शनों को लागू करने देता है। यह फ़ंक्शन तब उपयोगी होता है जब आप श्रेणीबद्ध डेटा पर अधिक जटिल विश्लेषण करना चाहते हैं, जैसे प्रत्येक श्रेणी के लिए किसी संख्यात्मक चर का औसत निकालना। आइए एक उदाहरण देखें:
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# average carat weight and price by Cut
data.groupby(by = 'Cut').mean()आउटपुट:
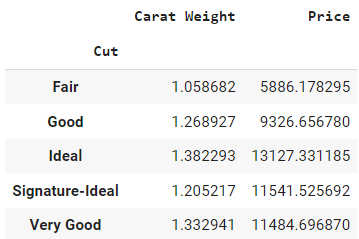
यह केवल संख्यात्मक कॉलम वाले डेटा फ्रेम को लौटाएगा। `groupby` मेथड के अंदर `by` पैरामीटर उस कॉलम को परिभाषित करता है जिस पर आप group by ऑपरेशन करना चाहते हैं, और उसके बाद कोष्ठकों के बाहर `mean()` समेकन विधि है।
आउटपुट की व्याख्या इस प्रकार की जा सकती है: fair कट वाले हीरे की औसत कीमत 5,886 है और औसत वजन 1.05 है, जबकि Very Good कट वाले हीरे की औसत कीमत 11,485 है।
Cross tab
`crosstab()` pandas का एक फ़ंक्शन है जो क्रॉस-टैबुलेशन तालिका बनाता है, जो दो या अधिक श्रेणीबद्ध चर के आवृत्ति वितरण को दिखाती है। यह फ़ंक्शन तब उपयोगी होता है जब आप दो या अधिक श्रेणीबद्ध चर के बीच संबंध देखना चाहते हैं, जैसे किसी एक चर की आवृत्ति का दूसरे चर से संबंध।
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# cross tab of Cut and Color
pd.crosstab(index=data['Cut'], columns=data['Color'])
आउटपुट:
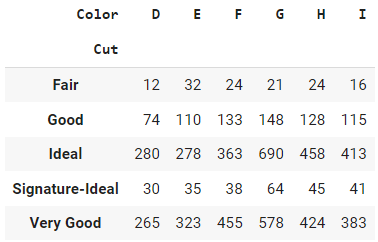
pandas के crosstab फ़ंक्शन का आउटपुट एक तालिका है जो दो या अधिक श्रेणीबद्ध चर के आवृत्ति वितरण को दिखाती है। तालिका की प्रत्येक पंक्ति किसी एक चर की एक यूनिक श्रेणी का प्रतिनिधित्व करती है, और प्रत्येक स्तंभ दूसरे चर की एक यूनिक श्रेणी का। तालिका में प्रविष्टियां दोनों चरों की श्रेणियों के संयोजनों की आवृत्ति गणनाएं हैं।
Pivot Table
`pivot_table()` Pandas का एक फ़ंक्शन है जो पिवट टेबल बनाता है, जो क्रॉस-टैबुलेशन तालिकाओं के समान होते हैं लेकिन अधिक लचीलापन प्रदान करते हैं। यह फ़ंक्शन तब उपयोगी होता है जब आप कई श्रेणीबद्ध चरों और उनके एक या अधिक संख्यात्मक चरों के साथ संबंध का विश्लेषण करना चाहते हैं। पिवट टेबल आपको कई तरीकों से डेटा को समेकित करने और परिणामों को संक्षिप्त रूप में प्रदर्शित करने देती हैं।
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# create pivot table
pd.pivot_table(data, values='Price', index='Cut', columns='Color', aggfunc=np.mean)
आउटपुट:
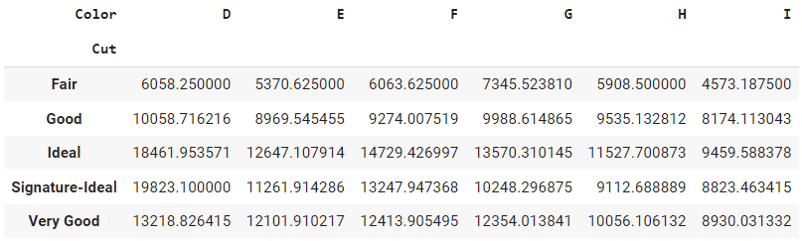
यह तालिका प्रत्येक रंग के लिए प्रत्येक हीरे के कट की औसत कीमत दिखाती है। पंक्तियां विभिन्न हीरे के कट का प्रतिनिधित्व करती हैं, स्तंभ विभिन्न रंगों का, और तालिका में प्रविष्टियां हीरों की औसत कीमत हैं।
pivot_table फ़ंक्शन तब उपयोगी होता है जब आप तालिका प्रारूप में कई चरों के पार संख्यात्मक डेटा का सारांश और तुलना करना चाहते हैं। यह फ़ंक्शन आपको विभिन्न फ़ंक्शनों (जैसे mean, sum, count, आदि) का उपयोग कर डेटा को समेकित करने और उसे एक ऐसे प्रारूप में व्यवस्थित करने देता है जो पढ़ने और विश्लेषण करने में आसान हो।
Python में श्रेणीबद्ध फीचर्स की एन्कोडिंग
अधिकांश मशीन लर्निंग एल्गोरिदम मुख्यतः केवल संख्यात्मक डेटा के साथ काम करने के लिए बनाए गए हैं, इसलिए वे आमतौर पर श्रेणीबद्ध डेटा को सीधे संभाल नहीं सकते। अतः, श्रेणीबद्ध फीचर्स को मशीन लर्निंग एल्गोरिदम के इनपुट के रूप में उपयोग करने से पहले उन्हें संख्यात्मक मानों के रूप में एन्कोड करना आवश्यक है।
श्रेणीबद्ध फीचर्स को एन्कोड करने की कई तकनीकें हैं, जिनमें one-hot एन्कोडिंग, ordinal एन्कोडिंग, और target एन्कोडिंग शामिल हैं। एन्कोडिंग तकनीक का चुनाव डेटा की विशिष्ट विशेषताओं और प्रयुक्त मशीन लर्निंग एल्गोरिदम की आवश्यकताओं पर निर्भर करता है।
One-hot एन्कोडिंग
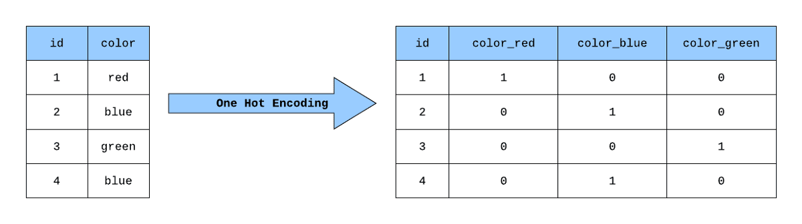
One-hot एन्कोडिंग श्रेणीबद्ध डेटा को द्विआधारी मानों के सेट के रूप में दर्शाने की प्रक्रिया है, जहां प्रत्येक श्रेणी को एक अद्वितीय बाइनरी वेक्टर से मैप किया जाता है। इस अभ्यRepresentation में केवल एक बिट 1 पर सेट होता है और बाकी 0 पर, इसलिए नाम "one hot" पड़ा। यह मशीन लर्निंग में आमतौर पर उपयोग किया जाता है ताकि श्रेणीबद्ध डेटा को ऐसे प्रारूप में बदला जा सके जिसे एल्गोरिदम प्रोसेस कर सकें।
pandas में श्रेणीबद्ध से संख्यात्मक
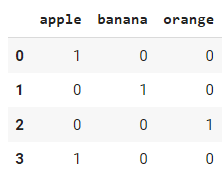
pandas में इसे हासिल करने का एक तरीका `pd.get_dummies()` मेथड का उपयोग करना है। यह Pandas लाइब्रेरी का एक फ़ंक्शन है जिसका उपयोग DataFrame में श्रेणीबद्ध चरों पर one-hot एन्कोडिंग करने के लिए किया जा सकता है। यह एक DataFrame लेता है और प्रत्येक श्रेणी के लिए बाइनरी कॉलम के साथ एक नया DataFrame लौटाता है। यहां इसका उपयोग कैसे करें, इसका उदाहरण है:
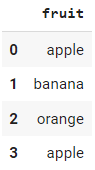
मान लीजिए हमारे पास "fruit" नाम का कॉलम वाला एक डेटा फ्रेम है जिसमें श्रेणीबद्ध डेटा है:
import pandas as pd
# generate df with 1 col and 4 rows
data = {
"fruit": ["apple", "banana", "orange", "apple"]
}
# show head
df = pd.DataFrame(data)
df.head()
आउटपुट:
# apply get_dummies function
df_encoded = pd.get_dummies(df["fruit"])
df_encoded .head()
आउटपुट:
हालांकि `pandas.get_dummies` का उपयोग करना सीधा है, मशीन लर्निंग कार्य करते समय अधिक सामान्य दृष्टिकोण sklearn लाइब्रेरी के `OneHotEncoder` का उपयोग करना है। मुख्य अंतर यह है कि `pandas.get_dummies` एन्कोडिंग सीख नहीं सकता; यह केवल उस डेटासेट पर one-hot एन्कोडिंग कर सकता है जिसे आप इनपुट के रूप में पास करते हैं। दूसरी ओर, `sklearn.OneHotEncoder` एक क्लास है जिसे सहेजा जा सकता है और भविष्य में आने वाले अन्य डेटासेट्स को ट्रांसफॉर्म करने के लिए उपयोग किया जा सकता है।
import pandas as pd
# generate df with 1 col and 4 rows
data = {
"fruit": ["apple", "banana", "orange", "apple"]
}
# one-hot-encode using sklearn
from sklearn.preprocessing import OneHotEncoder
encoder = OneHotEncoder()
encoded_results = encoder.fit_transform(df).toarray()
आउटपुट:
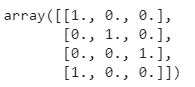
लेबल एन्कोडिंग
लेबल एन्कोडिंग एक तकनीक है जिसमें श्रेणीबद्ध चरों को संख्यात्मक मानों के रूप में एन्कोड किया जाता है, जहां प्रत्येक श्रेणी को एक अद्वितीय पूर्णांक सौंपा जाता है। उदाहरण के लिए, यदि हमारे पास "color" नामक श्रेणीबद्ध चर में तीन श्रेणियां हैं: "red", "green" और "blue"। हम इन्हें इस प्रकार लेबल एन्कोड कर सकते हैं (red: 0, green: 1, blue: 2)।
लेबल एन्कोडिंग कुछ मशीन लर्निंग एल्गोरिदम के लिए उपयोगी हो सकती है जिन्हें संख्यात्मक इनपुट की आवश्यकता होती है, क्योंकि यह श्रेणीबद्ध डेटा को ऐसे तरीके से दर्शाने देती है जिसे एल्गोरिदम समझ सकें। हालांकि, ध्यान रखना महत्वपूर्ण है कि लेबल एन्कोडिंग श्रेणियों का एक मनमाना क्रम पेश करती है, जो उनके बीच किसी सार्थक संबंध को आवश्यक रूप से प्रतिबिंबित नहीं कर सकता। कुछ मामलों में, यदि इस क्रम की व्याख्या किसी प्रकार के ऑर्डिनल संबंध के रूप में की जाती है, तो यह विश्लेषण में समस्याएं पैदा कर सकता है।
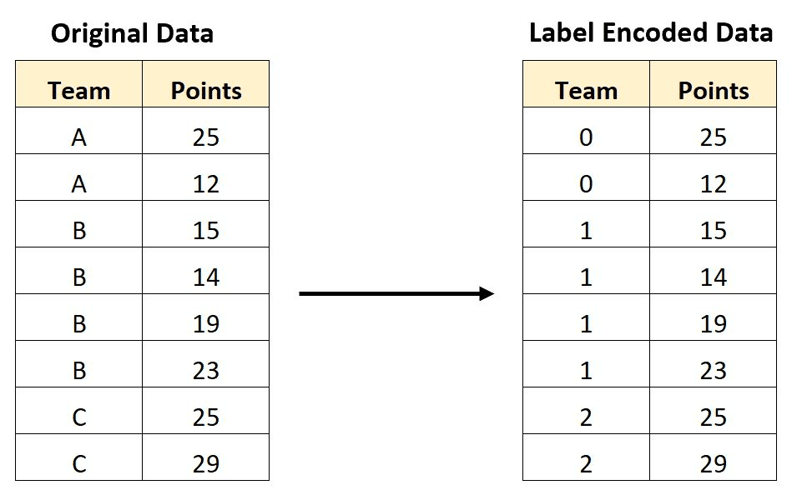
लेबल-एन्कोडेड डेटा। छवि स्रोत
One-hot बनाम लेबल एन्कोडिंग की तुलना
One-hot एन्कोडिंग और लेबल एन्कोडिंग दोनों श्रेणीबद्ध चरों को संख्यात्मक मानों के रूप में एन्कोड करने की तकनीकें हैं, परंतु उनकी विशेषताएं अलग हैं और वे अलग-अलग उपयोग-केस के लिए उपयुक्त हैं।
One-hot एन्कोडिंग प्रत्येक श्रेणी को एक बाइनरी कॉलम के रूप में दर्शाता है, जहां 1 उस श्रेणी की उपस्थिति और 0 उसकी अनुपस्थिति को दर्शाता है। उदाहरण के लिए, यदि हमारे पास "color" नामक श्रेणीबद्ध चर में तीन श्रेणियां हैं: "red", "green" और "blue"। One-hot एन्कोडिंग इस चर को तीन बाइनरी कॉलम के रूप में दर्शाएगा:

जब श्रेणियों में कोई अंतर्निहित क्रम या आपसी संबंध न हो, तो One-hot एन्कोडिंग उपयुक्त है। ऐसा इसलिए क्योंकि One-hot एन्कोडिंग हर श्रेणी को अन्य से असंबद्ध एक अलग इकाई की तरह मानता है। यह तब भी उपयोगी है जब श्रेणियों की संख्या अपेक्षाकृत कम हो, क्योंकि बहुत बड़ी संख्या में श्रेणियों के लिए कॉलमों की संख्या बोझिल हो सकती है।
दूसरी ओर, लेबल एन्कोडिंग प्रत्येक श्रेणी को एक अद्वितीय पूर्णांक के रूप में दर्शाती है। उदाहरण के लिए, तीन श्रेणियों वाले "color" चर को इस प्रकार लेबल-एन्कोड किया जा सकता है:

लेबल एन्कोडिंग तब उपयुक्त है जब श्रेणियों के बीच स्वाभाविक क्रम या आपसी संबंध हो, जैसे "small", "medium", और "large" जैसे ऑर्डिनल चरों के मामले में। इन मामलों में, श्रेणियों को सौंपे गए पूर्णांक मानों को श्रेणियों के क्रम को प्रतिबिंबित करना चाहिए। जब श्रेणियों की संख्या बहुत बड़ी हो, तब यह डेटा की आयामिकता घटाने में भी सहायक हो सकती है।
सामान्यतः, मशीन लर्निंग अनुप्रयोगों में One-hot एन्कोडिंग अधिक प्रचलित है, क्योंकि यह अधिक लचीली है और लेबल एन्कोडिंग के साथ उत्पन्न होने वाली अस्पष्टता और मनमाने क्रम की समस्याओं से बचाती है। हालांकि, कुछ संदर्भों में, जहां श्रेणियों का स्वाभाविक क्रम होता है या बहुत बड़ी संख्या में श्रेणियों से निपटना होता है, लेबल एन्कोडिंग उपयोगी हो सकती है।
उच्च कार्डिनैलिटी वाले श्रेणीबद्ध डेटा से निपटना
उच्च कार्डिनैलिटी का अर्थ है किसी श्रेणीबद्ध फीचर में बहुत बड़ी संख्या में यूनिक श्रेणियां। मशीन लर्निंग मॉडलों के लिए श्रेणीबद्ध डेटा को एन्कोड करते समय उच्च कार्डिनैलिटी से निपटना एक सामान्य चुनौती है। उच्च कार्डिनैलिटी विरल (sparse) डेटा अभ्यRepresentation की ओर ले जा सकती है और कुछ मशीन लर्निंग मॉडलों के प्रदर्शन पर नकारात्मक प्रभाव डाल सकती है। यहां कुछ तकनीकें हैं जिनका उपयोग श्रेणीबद्ध फीचर्स में उच्च कार्डिनैलिटी से निपटने के लिए किया जा सकता है:
दुर्लभ श्रेणियों को संयोजित करना
इसमें कम आवृत्ति वाली श्रेणियों को एकल श्रेणी में जोड़ना शामिल है। यह यूनिक श्रेणियों की संख्या को घटाता है और साथ ही डेटा अभ्यRepresentation में विरलता को भी कम करता है।
Target एन्कोडिंग
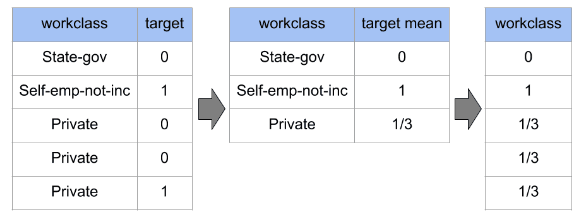
Target एन्कोडिंग श्रेणीबद्ध मानों को उस श्रेणी के औसत टार्गेट मान से बदल देती है। यह श्रेणीबद्ध डेटा का अधिक सतत अभ्यRepresentation प्रदान करती है और श्रेणीबद्ध फीचर और लक्ष्य चर के बीच संबंध को पकड़ने में मदद कर सकती है।
Weight of Evidence (WOE) एन्कोडिंग
Weight of Evidence एन्कोडिंग target एन्कोडिंग के समान है, लेकिन यह प्रत्येक श्रेणी के लिए लक्ष्य चर के वितरण को ध्यान में रखती है। किसी श्रेणी का WOE उस श्रेणी के लिए लक्ष्य के औसत और पूरी आबादी के औसत के अनुपात के लघुगणक के रूप में गणना किया जाता है।
श्रेणीबद्ध डेटा के लिए फीचर इंजीनियरिंग
फीचर इंजीनियरिंग मशीन लर्निंग मॉडलों के लिए डेटा तैयार करने का एक महत्वपूर्ण चरण है। इसमें मॉडलों के प्रदर्शन में सुधार के लिए मौजूदा फीचर्स से नए फीचर्स बनाना शामिल होता है। यहां कुछ तरीके दिए गए हैं जिनसे आप श्रेणीबद्ध डेटा पर फीचर इंजीनियरिंग कर सकते हैं:
इंटरैक्शन वेरिएबल्स बनाना
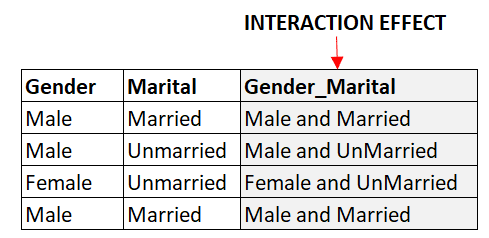
इंटरैक्शन वेरिएबल्स वे नए फीचर्स होते हैं जो दो या अधिक मौजूदा फीचर्स को मिलाकर बनाए जाते हैं। उदाहरण के लिए, यदि हमारे पास दो श्रेणीबद्ध फीचर्स हैं, 'Gender' और 'Marital Status', तो हम दोनों के बीच इंटरैक्शन को कैप्चर करने के लिए 'Gender-Marital Status' नाम का नया फीचर बना सकते हैं। यह फीचर्स और लक्ष्य चर के बीच नॉन-लिनियर संबंधों को पकड़ने में मदद कर सकता है।
संख्यात्मक चरों का बिनिंग
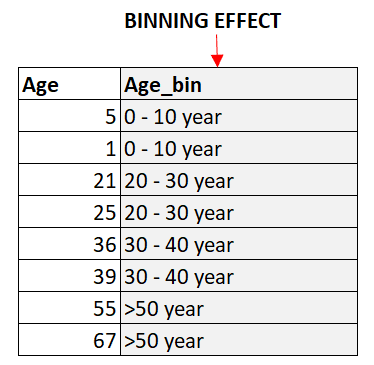
बिनिंग वह प्रक्रिया है जिसमें सतत संख्यात्मक चरों को असतत बिन्स में बांटा जाता है। यह फीचर में यूनिक मानों की संख्या को कम करने में मदद कर सकता है, जो श्रेणीबद्ध डेटा को एन्कोड करने के लिए लाभदायक हो सकता है। बिनिंग फीचर्स और लक्ष्य चर के बीच नॉन-लिनियर संबंधों को पकड़ने में भी मदद कर सकता है।
चक्रिय (cyclical) चरों की एन्कोडिंग
चक्रिय चर वे होते हैं जो किसी निश्चित अवधि के बाद दोहराते हैं। उदाहरण के लिए, दिन का घंटा एक चक्रिय चर है क्योंकि यह हर 24 घंटे में दोहरता है। चक्रिय चरों की एन्कोडिंग डेटा में आवर्तक पैटर्न को पकड़ने में मदद कर सकती है। ऐसा करने का एक सामान्य तरीका है दो नए फीचर्स बनाना—एक चर के sine का प्रतिनिधित्व करता है और दूसरा उसके cosine का।
निष्कर्ष
श्रेणीबद्ध डेटा को संभालना कई मशीन लर्निंग प्रोजेक्ट्स का एक महत्वपूर्ण पहलू है। इस ट्यूटोरियल में, हमने Python में श्रेणीबद्ध चरों का विश्लेषण और एन्कोडिंग करने की विभिन्न तकनीकों का अन्वेषण किया, जिनमें one-hot एन्कोडिंग और लेबल एन्कोडिंग शामिल हैं—जो दो सामान्यतः उपयोग की जाने वाली तकनीकें हैं।
हमने श्रेणीबद्ध डेटा की अवधारणा और मशीन लर्निंग मॉडलों में इसे सही ढंग से संभालना क्यों महत्वपूर्ण है, से शुरुआत की। फिर हमने pandas और scikit-learn दोनों का उपयोग करके one-hot एन्कोडिंग करने की चरण-दर-चरण गाइड दी, और प्रक्रिया को स्पष्ट करने के लिए कोड उदाहरण जोड़े।
इस ट्यूटोरियल में उच्च कार्डिनैलिटी वाले श्रेणीबद्ध डेटा, फीचर इंजीनियरिंग, WOE एन्कोडिंग आदि जैसे कुछ उन्नत विचारों पर भी चर्चा की गई है। यदि आप इस विषय में और गहराई से जाना चाहते हैं, तो हमारा कोर्स Working with Categorical Data in Python देखें।
यदि आप R भाषा पसंद करते हैं, तो हमारे कोर्स Categorical Data in the Tidyverse या Inference for Categorical Data in R में रुचि ले सकते हैं। ये दोनों R उपयोगकर्ताओं के लिए बेहतरीन कोर्स हैं।
छवि स्रोत
परिचय
वह डेटा जिसे वर्गीकृत किया जा सकता है, परंतु जिसमें कोई अंतर्निहित पदानुक्रम या क्रम नहीं होता, उसे श्रेणीबद्ध (categorical) डेटा कहते हैं। दूसरे शब्दों में, श्रेणियों के बीच कोई गणितीय संबंध नहीं होता। किसी व्यक्ति का लिंग (पुरुष/महिला), आंखों का रंग (नीला, हरा, भूरा, आदि), वे किस प्रकार का वाहन चलाते हैं (सेडान, SUV, ट्रक, आदि), या वे किस प्रकार का फल खाते हैं (सेब, केला, संतरा, आदि)—ये श्रेणीबद्ध डेटा के उदाहरण हैं।
इस ट्यूटोरियल में, हम श्रेणीबद्ध डेटा को संभालने और उसका प्री-प्रोसेसिंग करने की विधियों का खाका प्रस्तुत करेंगे। मशीन लर्निंग मॉडलों के लिए श्रेणीबद्ध डेटा तैयार करने के महत्व पर चर्चा करने से पहले, हम श्रेणीबद्ध डेटा और उसके प्रकारों को परिभाषित करेंगे। साथ ही, हम विभिन्न एन्कोडिंग विधियों, Python में श्रेणीबद्ध डेटा के विश्लेषण और विज़ुअलाइज़ेशन के तरीकों, तथा उच्च कार्डिनैलिटी वाले श्रेणीबद्ध डेटा और विभिन्न एन्कोडिंग तरीकों जैसे उन्नत विचारों पर भी नज़र डालेंगे।