

Dataset categorici
L'informazione è rappresentata utilizzando due forme di dati: dati categorici e dati numerici. I dati che possono essere classificati o raggruppati sono detti dati categorici. Uomini e donne rientrano nella categoria genere, rosso, verde e blu rientrano nella categoria colori, e la categoria paesi può includere USA, Canada, Messico, ecc.
Dati numerici si riferisce ai dati che possono essere espressi come numero. Esempi di dati numerici includono altezza, peso e temperatura.
In parole semplici, i dati categorici sono informazioni che possono essere suddivise in categorie, mentre i dati numerici sono informazioni che possono essere espresse come numero. Poiché la maggior parte degli algoritmi di machine learning sono progettati per operare con dati numerici, in questo ambito i dati categorici vengono trattati diversamente dai dati numerici. Prima che i dati categorici possano essere utilizzati come input per un modello di machine learning, devono essere trasformati in dati numerici. Questo processo di conversione dei dati categorici in una rappresentazione numerica è noto come encoding.
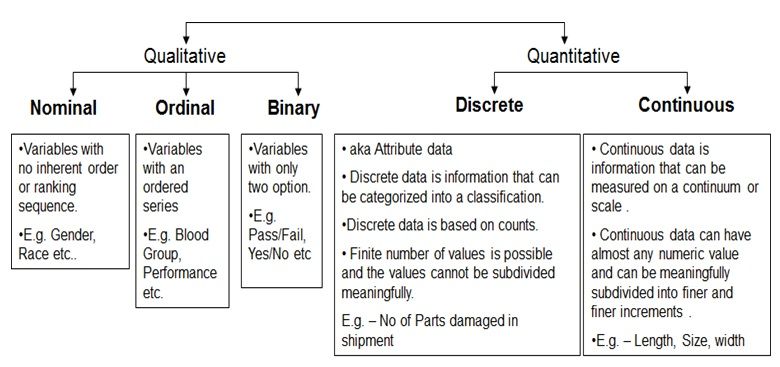
Dati qualitativi e quantitativi - Fonte immagine
Esistono due tipi di dati categorici: nominali e ordinali.
Dati nominali
I dati nominali sono dati categorici che possono essere suddivisi in gruppi, ma questi gruppi non hanno alcuna gerarchia o ordine intrinseco. Esempi di dati nominali includono nomi di marca (Coca-Cola, Pepsi, Sprite), varietà di condimenti per pizza (pepperoni, funghi, cipolle) e colore dei capelli (biondi, castani, neri, ecc.). Dai un'occhiata alla nostra guida sulle variabili nominali per saperne di più.
Dati ordinali
I dati ordinali, invece, descrivono informazioni che possono essere classificate e hanno un ordine o una graduatoria ben definita. Livelli di istruzione (scuola superiore, laurea triennale, laurea magistrale), livelli di soddisfazione lavorativa (estremamente soddisfatto, soddisfatto, neutro, insoddisfatto, molto insoddisfatto) e valutazioni a stelle (1 stella, 2 stelle, 3 stelle, 4 stelle, 5 stelle) sono alcuni esempi di dati ordinali.
Attribuendo a ciascuna categoria un valore numerico che rifletta il suo ordine o rango, i dati ordinali possono essere trasformati in dati numerici e utilizzati nel machine learning. Per gli algoritmi sensibili all'ampiezza dei dati in input, ciò può essere utile.
La distinzione tra dati nominali e ordinali non è sempre netta nella pratica e può variare a seconda del caso d'uso specifico. Ad esempio, mentre alcune persone possono considerare la "valutazione a stelle" come dato ordinale, altre possono vederla come dato nominale. La cosa più importante è conoscere la natura dei tuoi dati e scegliere la strategia di encoding che meglio cattura le relazioni presenti nei tuoi dati.
Comprendere i tipi di dati in pandas
pandas è una libreria open-source Python molto utilizzata per l'analisi e la manipolazione dei dati. Ha solide funzionalità per lavorare con dati strutturati, come data frame e series che gestiscono dati tabellari con righe e colonne etichettate.
pandas fornisce anche diverse funzioni per leggere e scrivere vari tipi di file (csv, parquet, database, ecc.). Quando leggi un file con pandas, a ogni colonna viene assegnato un tipo di dato in base all'inferenza. Ecco tutti i tipi di dati che pandas può assegnare:
- Numerico: include interi e numeri in virgola mobile. I dati numerici sono tipicamente usati per analisi quantitative e operazioni matematiche.
- Stringa: questo tipo di dato è usato per rappresentare dati testuali come nomi, indirizzi e descrizioni.
- Booleano: può avere solo due valori possibili: True o False. I dati booleani sono spesso usati per operazioni logiche e filtraggio.
- Datetime: rappresenta date e orari. pandas ha strumenti potenti per manipolare dati datetime.
- Categorico: rappresenta dati che assumono un numero limitato di valori. I dati categorici sono spesso usati per raggruppare e aggregare dati.
- Object: è un contenitore generico per dati che non rientrano nelle altre categorie. Può includere vari tipi di dati, come liste, dizionari e altri oggetti.

I dati che non rientrano negli altri tipi, inclusi stringhe, tipi misti o altri oggetti, sono rappresentati dai tipi di dato category e object in pandas. Tuttavia, presentano alcune differenze significative che influiscono su funzionalità e prestazioni.
Tipo di dato categorico
Il tipo di dato categorico è stato creato per informazioni con un numero limitato di valori possibili, come categorie o etichette. Internamente, i dati categorici sono rappresentati come una collezione di numeri, il che può velocizzare alcune operazioni e risparmiare memoria rispetto al corrispondente tipo object. Inoltre, i dati categorici possono essere ordinati logicamente e facilitano procedure di raggruppamento e aggregazione efficienti.
Tipo di dato object
Il tipo di dato object, invece, funge da contenitore generico per informazioni che non rientrano negli altri tipi. Può includere molti tipi di dati diversi, come liste, dizionari e altri oggetti. Sebbene i dati object offrano grande flessibilità, possono anche essere più lenti e consumare più memoria rispetto ai dati categorici di pari dimensione e non possono essere sottoposti ad alcune operazioni specializzate possibili con i dati di tipo category.
In generale, potresti considerare di utilizzare il tipo di dato categorico se i tuoi dati hanno un numero ridotto di valori possibili e intendi effettuare molte operazioni di raggruppamento o aggregazione. Il tipo object è in genere un'opzione sicura in tutti gli altri casi. Tuttavia, il tipo ideale dipende in ultima analisi dal tuo caso d'uso e dalle proprietà dei tuoi dati.
Vediamo un esempio leggendo un file csv da GitHub.
# read csv using pandas
data = pd.read_csv(‘https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv’)
# check the head of dataframe
data.head()Output:
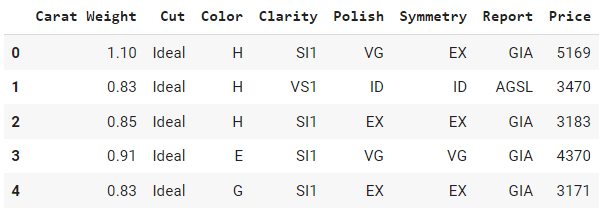
Riesci a identificare quali di queste colonne sono categoriche e quali numeriche? Ebbene, in questo esempio tutte le colonne sono categoriche tranne `Carat Weight` e `Price`. Verifichiamo se abbiamo ragione controllando i tipi di dato predefiniti.
# check the data types
data.dtypesOutput:

Nota come a `Price` venga assegnato il tipo `int64`, a `Carat Weight` `float64` e il resto delle colonne siano object, esattamente come ci aspettavamo.
Analizzare le feature categoriche in Python
In pandas, una popolare libreria per l'analisi dei dati in Python, ci sono alcune funzioni che ti permettono di analizzare rapidamente i tipi di dato categorici nel tuo dataset. Vediamole una per una:
Value Counts
`value_counts()` è una funzione della libreria pandas che restituisce la frequenza di ciascun valore unico in una colonna di dati categorici. Questa funzione è utile quando vuoi avere una comprensione rapida della distribuzione di una variabile categorica, come le categorie più comuni e la loro frequenza.
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# check value counts of Cut column
data['Cut'].value_counts()Output:
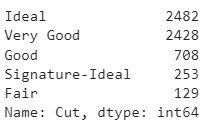
Se vuoi visualizzare la distribuzione puoi usare la libreria `plotly` per tracciare un grafico a barre interattivo.
import plotly.express as px
cut_counts = data['Cut'].value_counts()
fig = px.bar(x=cut_counts.index, y=cut_counts.values)
fig.show()Output:
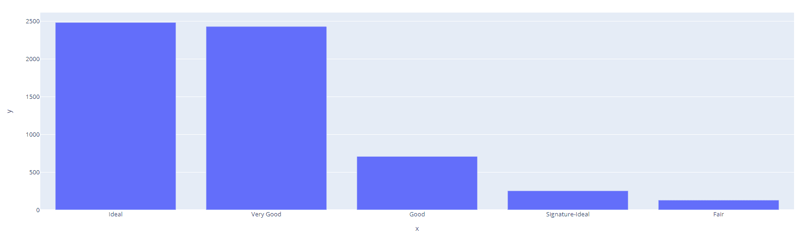
Group by
`groupby()` è una funzione in Pandas che ti consente di raggruppare i dati per una o più colonne e applicare funzioni di aggregazione come somma, media e conteggio. Questa funzione è utile quando vuoi eseguire analisi più complesse su dati categorici, ad esempio calcolare la media di una variabile numerica per ciascuna categoria. Vediamo un esempio:
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# average carat weight and price by Cut
data.groupby(by = 'Cut').mean()Output:
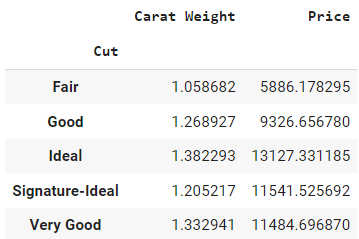
Restituirà solo un data frame con colonne numeriche. Il parametro `by` all'interno del metodo `groupby` definisce la colonna su cui vuoi eseguire l'operazione di raggruppamento e poi `mean()` fuori dalle parentesi è il metodo di aggregazione.
L'output può essere interpretato così: il prezzo medio di un diamante con taglio Fair è 5.886 e il peso medio è 1,05, rispetto al prezzo medio di 11.485 per un diamante con taglio Very Good.
Cross tab
`crosstab()` è una funzione in pandas che crea una tabella di contingenza, che mostra la distribuzione di frequenza di due o più variabili categoriche. Questa funzione è utile quando vuoi vedere la relazione tra due o più variabili categoriche, ad esempio come la frequenza di una variabile è correlata a un'altra.
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# cross tab of Cut and Color
pd.crosstab(index=data['Cut'], columns=data['Color'])
Output:
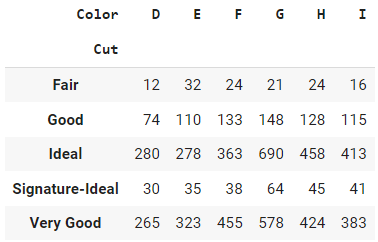
L'output della funzione crosstab in pandas è una tabella che mostra la distribuzione di frequenza di due o più variabili categoriche. Ogni riga della tabella rappresenta una categoria unica di una delle variabili e ogni colonna rappresenta una categoria unica dell'altra variabile. Le celle della tabella sono i conteggi di frequenza delle combinazioni di categorie nelle due variabili.
Tabella pivot
`pivot_table()` è una funzione in Pandas che crea tabelle pivot, simili alle tabelle di contingenza ma con maggiore flessibilità. Questa funzione è utile quando vuoi analizzare più variabili categoriche e la loro relazione con una o più variabili numeriche. Le tabelle pivot ti consentono di aggregare i dati in vari modi e visualizzare i risultati in forma compatta.
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')
# create pivot table
pd.pivot_table(data, values='Price', index='Cut', columns='Color', aggfunc=np.mean)
Output:
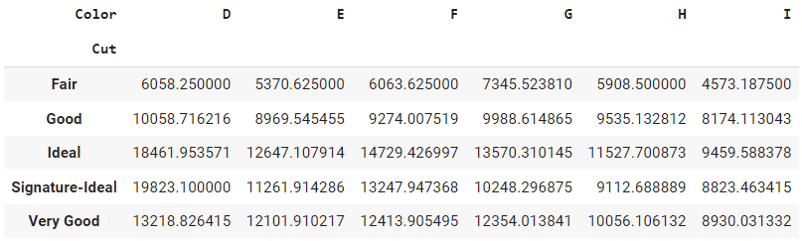
Questa tabella mostra il prezzo medio di ciascun taglio di diamante per ogni colore. Le righe rappresentano i diversi tagli di diamante, le colonne rappresentano i diversi colori dei diamanti e le celle della tabella sono il prezzo medio del diamante.
La funzione pivot_table è utile quando vuoi riassumere e confrontare i dati numerici su più variabili in formato tabellare. La funzione ti consente di aggregare i dati con varie funzioni (come media, somma, conteggio, ecc.) e organizzarli in un formato facile da leggere e analizzare.
Codifica delle feature categoriche in Python
I dati categorici in genere non possono essere gestiti direttamente dagli algoritmi di machine learning, poiché la maggior parte degli algoritmi è progettata principalmente per operare solo con dati numerici. Pertanto, prima che le feature categoriche possano essere utilizzate come input per gli algoritmi di machine learning, devono essere codificate come valori numerici.
Esistono diverse tecniche per codificare le feature categoriche, tra cui one-hot encoding, ordinal encoding e target encoding. La scelta della tecnica di encoding dipende dalle caratteristiche specifiche dei dati e dai requisiti dell'algoritmo di machine learning utilizzato.
One-hot encoding
Il one-hot encoding è un processo che rappresenta i dati categorici come un insieme di valori binari, in cui ogni categoria è mappata a un valore binario univoco. In questa rappresentazione, solo un bit è impostato a 1 e gli altri sono impostati a 0, da cui il nome "one hot". È comunemente usato nel machine learning per convertire dati categorici in un formato che gli algoritmi possano elaborare.
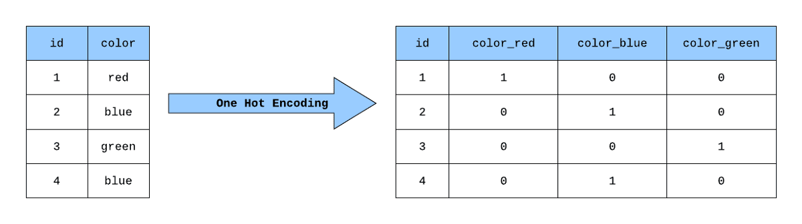
Da categorico a numerico con pandas
Un modo per ottenere questo in pandas è usare il metodo `pd.get_dummies()`. È una funzione della libreria Pandas che può essere utilizzata per eseguire il one-hot encoding su variabili categoriche in un DataFrame. Prende un DataFrame e restituisce un nuovo DataFrame con colonne binarie per ciascuna categoria. Ecco un esempio di utilizzo:
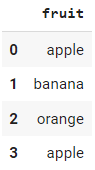
Supponiamo di avere un data frame con una colonna "fruit" contenente dati categorici:
import pandas as pd
# generate df with 1 col and 4 rows
data = {
"fruit": ["apple", "banana", "orange", "apple"]
}
# show head
df = pd.DataFrame(data)
df.head()
Output:
# apply get_dummies function
df_encoded = pd.get_dummies(df["fruit"])
df_encoded .head()
Output:
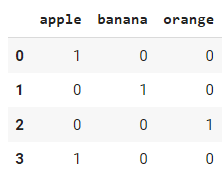
Anche se `pandas.get_dummies` è semplice da usare, un approccio più comune è usare `OneHotEncoder` della libreria sklearn, soprattutto quando svolgi attività di machine learning. La differenza principale è che `pandas.get_dummies` non può apprendere codifiche; può solo eseguire il one-hot encoding sul dataset passato in input. D'altra parte, `sklearn.OneHotEncoder` è una classe che può essere salvata e utilizzata per trasformare altri dataset in arrivo in futuro.
import pandas as pd
# generate df with 1 col and 4 rows
data = {
"fruit": ["apple", "banana", "orange", "apple"]
}
# one-hot-encode using sklearn
from sklearn.preprocessing import OneHotEncoder
encoder = OneHotEncoder()
encoded_results = encoder.fit_transform(df).toarray()
Output:
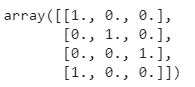
Label encoding
Il label encoding è una tecnica per codificare variabili categoriche come valori numerici, assegnando a ciascuna categoria un intero univoco. Ad esempio, supponiamo di avere una variabile categorica "color" con tre categorie: "red", "green" e "blue". Possiamo codificare queste categorie usando il label encoding come segue (red: 0, green: 1, blue: 2).
Il label encoding può essere utile per alcuni algoritmi di machine learning che richiedono input numerici, poiché consente di rappresentare i dati categorici in un modo comprensibile per gli algoritmi. Tuttavia, è importante ricordare che il label encoding introduce un ordinamento arbitrario delle categorie, che potrebbe non riflettere alcuna relazione significativa tra di esse. In alcuni casi, ciò può portare a problemi nell'analisi, soprattutto se l'ordinamento viene interpretato come una qualche forma di relazione ordinale.
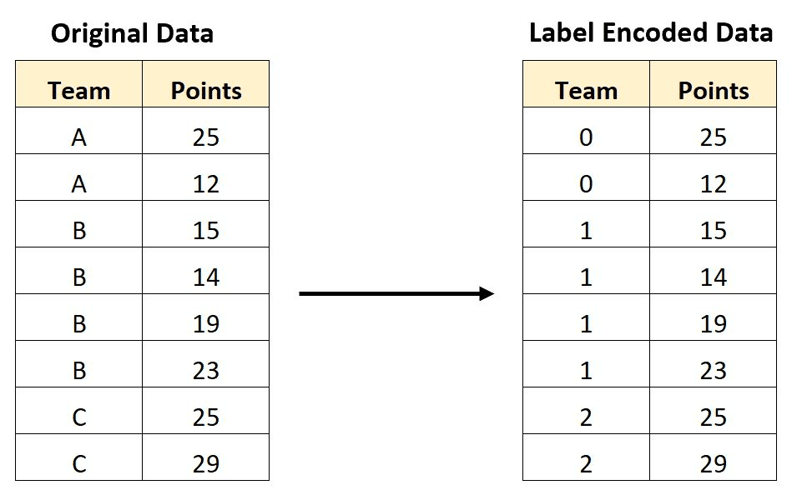
Dati con label encoding. Fonte immagine
Confronto tra One-hot e Label Encoding
Il one-hot encoding e il label encoding sono entrambe tecniche per codificare variabili categoriche come valori numerici, ma hanno proprietà diverse e sono adatte a casi d'uso differenti.
Il one-hot encoding rappresenta ogni categoria come una colonna binaria, con 1 a indicare la presenza della categoria e 0 la sua assenza. Ad esempio, supponiamo di avere una variabile categorica "color" con tre categorie: "red", "green" e "blue". Il one-hot encoding rappresenterebbe questa variabile come tre colonne binarie:

Il one-hot encoding è indicato quando le categorie non hanno un ordinamento o una relazione intrinseca tra loro. Questo perché tratta ogni categoria come un'entità separata, senza relazione con le altre. È anche utile quando il numero di categorie è relativamente piccolo, poiché con numeri molto grandi di categorie il numero di colonne può diventare ingestibile.
Il label encoding, invece, rappresenta ogni categoria come un intero univoco. Ad esempio, la variabile "color" con tre categorie potrebbe essere codificata così:

Il label encoding è indicato quando le categorie hanno un ordinamento o una relazione naturale tra loro, come nel caso di variabili ordinali come "small", "medium" e "large". In questi casi, i valori interi assegnati alle categorie dovrebbero riflettere l'ordinamento delle categorie. Il label encoding può anche essere utile quando il numero di categorie è molto grande, poiché riduce la dimensionalità dei dati.
In generale, il one-hot encoding è più comunemente usato nelle applicazioni di machine learning, poiché è più flessibile ed evita i problemi di ambiguità e ordinamento arbitrario che possono sorgere con il label encoding. Tuttavia, il label encoding può essere utile in determinati contesti in cui le categorie hanno un ordinamento naturale o quando si gestiscono numeri molto elevati di categorie.
Gestire dati categorici ad alta cardinalità
Alta cardinalità indica un gran numero di categorie uniche in una feature categorica. Gestire l'alta cardinalità è una sfida comune nella codifica dei dati categorici per i modelli di machine learning. Un'alta cardinalità può portare a una rappresentazione sparsa dei dati e avere un impatto negativo sulle prestazioni di alcuni modelli di machine learning. Ecco alcune tecniche che possono essere utilizzate per gestire l'alta cardinalità nelle feature categoriche:
Combinare categorie rare
Ciò implica combinare categorie poco frequenti in un'unica categoria. Questo riduce il numero di categorie uniche e diminuisce anche la sparseness nella rappresentazione dei dati.
Target Encoding
Il target encoding sostituisce i valori categorici con il valore medio del target per quella categoria. Fornisce una rappresentazione più continua dei dati categorici e può aiutare a catturare la relazione tra la feature categorica e la variabile target.
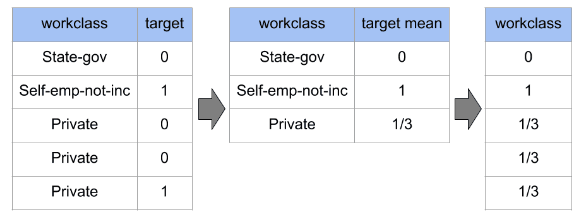
Weight of Evidence (WOE) Encoding
Il Weight of Evidence encoding è simile al target encoding, ma tiene conto della distribuzione della variabile target per ciascuna categoria. Il WOE di una categoria è calcolato come il logaritmo del rapporto tra la media del target per la categoria e la media per l'intera popolazione.
Feature engineering per dati categorici
La feature engineering è un passaggio importante nella preparazione dei dati per i modelli di machine learning. Consiste nel creare nuove feature a partire da quelle esistenti per migliorare le prestazioni dei modelli. Ecco alcuni modi in cui puoi eseguire feature engineering sui dati categorici:
Creare variabili di interazione
Le variabili di interazione sono nuove feature create combinando due o più feature esistenti. Ad esempio, se abbiamo due feature categoriche, 'Gender' e 'Marital Status', possiamo creare una nuova feature, 'Gender-Marital Status', per catturare l'interazione tra le due feature. Questo può aiutare a cogliere relazioni non lineari tra le feature e la variabile target.
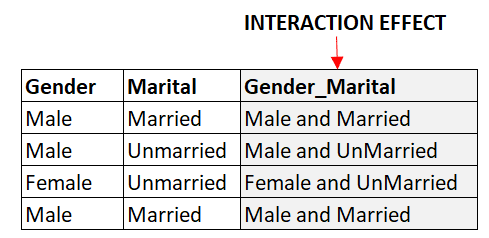
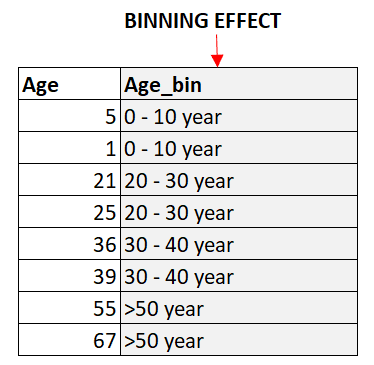
Binning di variabili numeriche
Il binning è il processo di suddivisione di variabili numeriche continue in intervalli discreti. Questo può aiutare a ridurre il numero di valori unici nella feature, cosa che può essere vantaggiosa per la codifica dei dati categorici. Il binning può anche aiutare a catturare relazioni non lineari tra le feature e la variabile target.
Codifica di variabili cicliche
Le variabili cicliche sono variabili che si ripetono su un periodo specifico. Ad esempio, l'ora del giorno è una variabile ciclica poiché si ripete ogni 24 ore. Codificare le variabili cicliche può aiutare a catturare i pattern periodici nei dati. Un approccio comune consiste nel creare due nuove feature, una che rappresenta il seno della variabile e l'altra il coseno della variabile.
Conclusione
La gestione dei dati categorici è un aspetto importante di molti progetti di machine learning. In questo tutorial, abbiamo esplorato varie tecniche per analizzare e codificare variabili categoriche in Python, incluso il one-hot encoding e il label encoding, due tecniche comunemente utilizzate.
Abbiamo iniziato introducendo il concetto di dati categorici e perché è importante gestirli correttamente nei modelli di machine learning. Abbiamo poi fornito una guida passo-passo su come eseguire il one-hot encoding sia con pandas che con scikit-learn, insieme a esempi di codice per illustrare il processo.
Questo tutorial discute anche alcuni concetti avanzati come la gestione dei dati categorici ad alta cardinalità, la feature engineering, il WOE encoding e altro ancora. Se vuoi approfondire ulteriormente questo argomento, dai un'occhiata al nostro corso Working with Categorical Data in Python.
Se preferisci il linguaggio R, potrebbero interessarti i nostri corsi Categorical Data in the Tidyverse o Inference for Categorical Data in R. Entrambi sono corsi eccellenti per gli utenti R.





Fonte immagine
Introduzione
I dati che possono essere classificati ma non hanno una gerarchia o un ordine intrinseco sono noti come dati categorici. In altre parole, non esiste alcuna connessione matematica tra le categorie. Il genere di una persona (maschio/femmina), il colore degli occhi (blu, verde, marrone, ecc.), il tipo di veicolo guidato (berlina, SUV, camion, ecc.) o il tipo di frutta consumata (mela, banana, arancia, ecc.) sono esempi di dati categorici.
In questo tutorial illustreremo i metodi di gestione e preprocessing dei dati categorici. Prima di discutere l'importanza di preparare i dati categorici per i modelli di machine learning, definiremo i dati categorici e le loro tipologie. Inoltre, vedremo diversi metodi di codifica, tecniche di analisi e visualizzazione dei dati categorici in Python e concetti più avanzati come i dati categorici ad alta cardinalità e vari metodi di codifica.