
Cursus
Data opschonen in Python
4 uur
162.2K
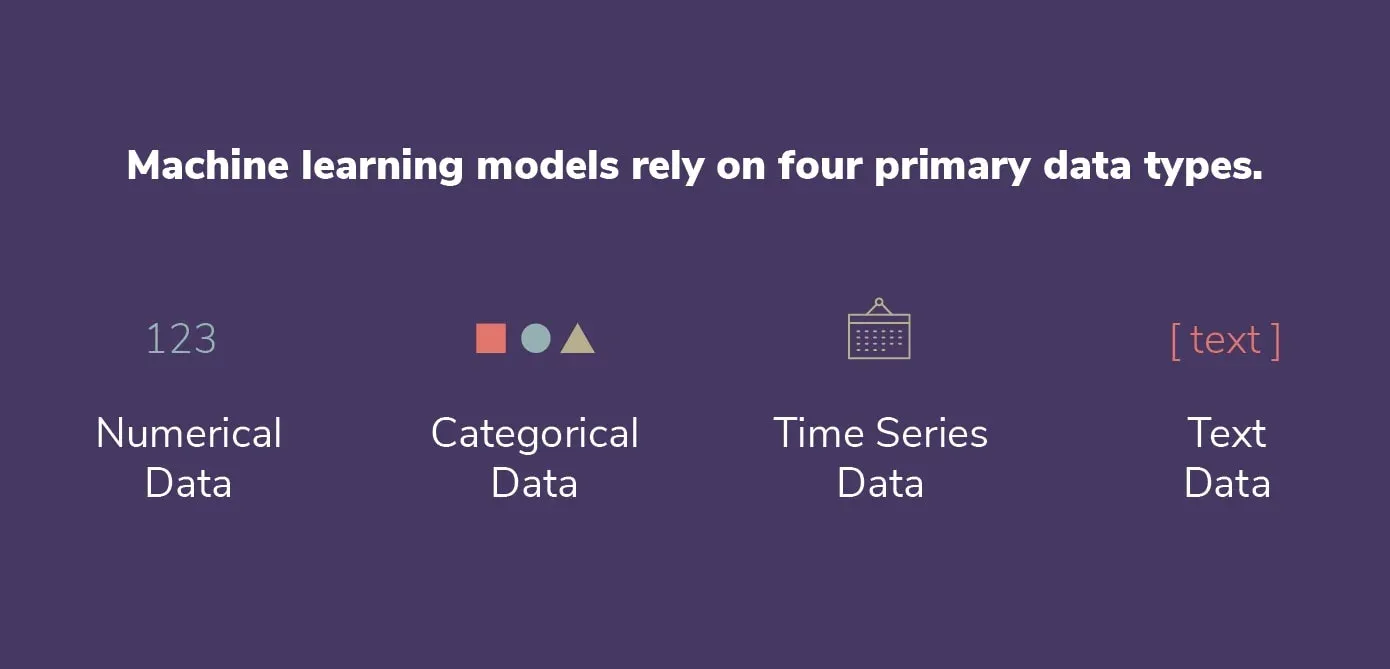
Data die je kunt indelen in categorieën maar die geen inherente hiërarchie of volgorde heeft, noemen we categorische data. Met andere woorden: er is geen wiskundig verband tussen de categorieën. Het geslacht van een persoon (man/vrouw), oogkleur (blauw, groen, bruin, enz.), het type voertuig dat iemand rijdt (sedan, SUV, truck, enz.) of het soort fruit dat iemand eet (appel, banaan, sinaasappel, enz.) zijn voorbeelden van categorische data.
In deze tutorial behandelen we methoden voor het verwerken en voorbewerken van categorische data. Voordat we ingaan op het belang van het voorbereiden van categorische data voor machine-learningmodellen, definiëren we eerst categorische data en de typen ervan. Daarnaast bekijken we verschillende encodeermethoden, methoden voor analyse en visualisatie van categorische data in Python, en meer geavanceerde ideeën zoals categorische data met hoge cardinaliteit en diverse encodeertechnieken.
Informatie wordt weergegeven met twee verschillende vormen van data: categorische data en numerieke data. Data die kan worden gecategoriseerd of gegroepeerd, noemen we categorische data. Mannen en vrouwen vallen onder de categorie geslacht, de kleuren rood, groen en blauw vallen onder de categorie kleuren, en de categorie landen kan de VS, Canada, Mexico, enz. omvatten.
Numerieke data is data die als getal kan worden uitgedrukt. Voorbeelden van numerieke data zijn lengte, gewicht en temperatuur.
Eenvoudig gezegd: categorische data is informatie die je in categorieën kunt onderbrengen, terwijl numerieke data informatie is die je als getal kunt uitdrukken. Omdat de meeste machine-learningalgoritmen zijn ontworpen om met numerieke data te werken, wordt categorische data in dit veld anders behandeld dan numerieke data. Voordat categorische data als invoer voor een machine-learningmodel kan worden gebruikt, moet deze eerst worden omgezet in numerieke data. Dit proces van het omzetten van categorische data naar een numerieke representatie heet encoderen.

Kwalitatieve en kwantitatieve data - Bron afbeelding
Er zijn twee soorten categorische data: nominaal en ordinaal.
Nominale data is categorische data die je kunt verdelen in groepen, maar deze groepen hebben geen intrinsieke hiërarchie of volgorde. Voorbeelden van nominale data zijn merknamen (Coca-Cola, Pepsi, Sprite), soorten pizzabeleg (pepperoni, champignons, uien) en haarkleur (blond, bruin, zwart, enz.). Bekijk onze gids over nominale variabelen om meer te leren.
Ordinale data daarentegen beschrijft informatie die je kunt categoriseren én die een duidelijke volgorde of rangorde heeft. Opleidingsniveaus (middelbare school, bachelor, master), mate van werktevredenheid (zeer tevreden, tevreden, neutraal, ontevreden, zeer ontevreden) en sterrenbeoordelingen (1 ster, 2 sterren, 3 sterren, 4 sterren, 5 sterren) zijn enkele voorbeelden van ordinale data.
Door elke categorie een numerieke waarde te geven die de volgorde of rangorde weerspiegelt, kan ordinale data worden omgezet in numerieke data en gebruikt in machine learning. Dit kan nuttig zijn voor algoritmen die gevoelig zijn voor de schaal van de invoerdata.
Het onderscheid tussen nominale en ordinale data is in de praktijk niet altijd eenduidig en kan variëren per toepassing. Zo kunnen sommigen een "sterrenbeoordeling" als ordinale data zien, terwijl anderen die als nominaal beschouwen. Het belangrijkste is dat je de aard van je data begrijpt en de encodeerstrategie kiest die de relaties in je data het best weergeeft.
De veelgebruikte open-sourcelibrary pandas voor Python wordt gebruikt voor data-analyse en -manipulatie. Het heeft krachtige mogelijkheden voor het werken met gestructureerde data, waaronder dataframes en series die overweg kunnen met tabeldata met gelabelde rijen en kolommen.
pandas biedt ook verschillende functies om verschillende bestandstypen te lezen en te schrijven (csv, parquet, database, enz.). Wanneer je een bestand met pandas leest, krijgt elke kolom een datatype toegewezen op basis van inferentie. Dit zijn alle datatypes die pandas kan toewijzen:
Data die niet in de andere datatypes past, waaronder strings, gemengde typen of andere objecten, wordt in pandas weergegeven door de datatypes category en object. Ze hebben echter een paar belangrijke verschillen die invloed hebben op hun werking en prestaties.
Het categorische datatype is gemaakt voor informatie met slechts een paar mogelijke waarden, zoals categorieën of labels. Intern wordt categorische data weergegeven als een verzameling getallen, wat sommige bewerkingen kan versnellen en geheugen kan besparen in vergelijking met het overeenkomstige object-datatype. Bovendien kan categorische data logisch worden geordend en faciliteert het efficiënte groeperings- en aggregatieprocedures.
Het object-datatype is daarentegen een vergaarbak voor informatie die niet in de andere datatypes past. Het kan veel verschillende soorten data bevatten, zoals lijsten, dictionaries en andere objecten. Hoewel objectdata veel flexibiliteit biedt, kan het ook trager zijn en meer geheugen verbruiken dan categorische data van dezelfde grootte, en het kan niet worden onderworpen aan sommige gespecialiseerde bewerkingen die mogelijk zijn met category-data.
In het algemeen kun je overwegen het categorische datatype te gebruiken als je data een klein aantal mogelijke waarden heeft en je veel gaat groeperen of aggregeren. In alle andere gevallen is het object-datatype doorgaans een veilige keuze. Het ideale datatype hangt echter uiteindelijk af van je specifieke usecase en de eigenschappen van je data.
Laten we een voorbeeld bekijken door een csv-bestand van GitHub te lezen.
# read csv using pandas
data = pd.read_csv(‘https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv’)

# check the head of dataframe
data.head()
Output:

Kun je bepalen welke van deze kolommen categorisch zijn en welke numeriek? In dit voorbeeld zijn alle kolommen categorisch, behalve `Carat Weight` en `Price`. Laten we controleren of dat klopt door de standaarddatatypes te bekijken.
# check the data types
data.dtypes
Output:

Let op: `Price` heeft het type `int64`, `Carat Weight` heeft `float64`, en de rest van de kolommen zijn objects, precies zoals verwacht.
In pandas, een populaire Python-bibliotheek voor data-analyse, zijn er een paar functies waarmee je snel categorische datatypen in je dataset kunt analyseren. Laten we ze één voor één bekijken:
`value_counts()` is een functie in de pandas-bibliotheek die de frequentie van elke unieke waarde in een categorische datakolom teruggeeft. Deze functie is handig wanneer je snel inzicht wilt krijgen in de verdeling van een categorische variabele, zoals de meest voorkomende categorieën en hun frequentie.
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')

# check value counts of Cut column
data['Cut'].value_counts()
Output:

Als je de verdeling wilt visualiseren, kun je de `plotly`-bibliotheek gebruiken om een interactieve staafgrafiek te maken.
import plotly.express as px
cut_counts = data['Cut'].value_counts()
fig = px.bar(x=cut_counts.index, y=cut_counts.values)
fig.show()
Output:

`groupby()` is een functie in Pandas waarmee je data kunt groeperen op één of meer kolommen en aggregatiefuncties zoals som, gemiddelde en aantal kunt toepassen. Deze functie is handig wanneer je complexere analyses op categorische data wilt uitvoeren, zoals het gemiddelde van een numerieke variabele per categorie berekenen. Laten we een voorbeeld bekijken:
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')

# average carat weight and price by Cut
data.groupby(by = 'Cut').mean()
Output:

Dit retourneert alleen een dataframe met numerieke kolommen. De parameter `by` in de `groupby`-methode definieert de kolom waarop je de groupby-operatie wilt uitvoeren, en `mean()` buiten de haakjes is de aggregatiemethode.
De output kun je interpreteren als: de gemiddelde prijs van een diamant met fair cut is 5.886 en het gemiddelde gewicht is 1,05, vergeleken met een gemiddelde prijs van 11.485 voor een diamant met een Very Good cut.
`crosstab()` is een functie in pandas die een kruistabel maakt, waarin de frequentieverdeling van twee of meer categorische variabelen wordt weergegeven. Deze functie is handig wanneer je de relatie tussen twee of meer categorische variabelen wilt zien, bijvoorbeeld hoe de frequentie van de ene variabele samenhangt met een andere variabele.
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')

# cross tab of Cut and Color
pd.crosstab(index=data['Cut'], columns=data['Color'])
Output:

De output van de crosstab-functie in pandas is een tabel die de frequentieverdeling van twee of meer categorische variabelen toont. Elke rij van de tabel vertegenwoordigt een unieke categorie in de ene variabele, en elke kolom vertegenwoordigt een unieke categorie in de andere variabele. De waarden in de tabel zijn de frequentietellingen van de combinaties van categorieën in de twee variabelen.
`pivot_table()` is een functie in Pandas die draaitabellen maakt, die lijken op kruistabellen maar met meer flexibiliteit. Deze functie is handig wanneer je meerdere categorische variabelen en hun relatie tot één of meer numerieke variabelen wilt analyseren. Draaitabellen stellen je in staat data op meerdere manieren te aggregeren en de resultaten compact weer te geven.
# read csv using pandas
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/diamond.csv')

# create pivot table
pd.pivot_table(data, values='Price', index='Cut', columns='Color', aggfunc=np.mean)
Output:

Deze tabel toont de gemiddelde prijs van elke diamantenslijpvorm per kleur. De rijen vertegenwoordigen de verschillende slijpvormen, de kolommen de verschillende diamantkleuren, en de waarden in de tabel zijn de gemiddelde prijzen.
De functie pivot_table is nuttig wanneer je numerieke data wilt samenvatten en vergelijken over meerdere variabelen in tabelvorm. De functie laat je de data aggregeren met verschillende functies (zoals mean, sum, count, enz.) en organiseren in een formaat dat makkelijk te lezen en te analyseren is.
Categorische data kan doorgaans niet direct door machine-learningalgoritmen worden verwerkt, omdat de meeste algoritmen primair zijn ontworpen om alleen met numerieke data te werken. Daarom moeten categorische features, voordat ze als invoer voor machine-learningalgoritmen kunnen worden gebruikt, worden gecodeerd als numerieke waarden.
Er zijn verschillende technieken voor het encoderen van categorische features, waaronder one-hot-encoding, ordinale encoding en target encoding. De keuze voor een encodeertechniek hangt af van de specifieke kenmerken van de data en de vereisten van het gebruikte machine-learningalgoritme.
One-hot-encoding is een manier om categorische data weer te geven als een set binaire waarden, waarbij elke categorie wordt toegewezen aan een unieke binaire waarde. In deze representatie staat slechts één bit op 1 en de rest op 0, vandaar de naam "one hot". Dit wordt veel gebruikt in machine learning om categorische data om te zetten naar een formaat dat algoritmen kunnen verwerken.

Een manier om dit in pandas te doen is met de methode `pd.get_dummies()`. Dit is een functie in de Pandas-bibliotheek die one-hot-encoding kan uitvoeren op categorische variabelen in een DataFrame. Het neemt een DataFrame en retourneert een nieuw DataFrame met binaire kolommen voor elke categorie. Hier is een voorbeeld van het gebruik:
Stel dat we een dataframe hebben met een kolom "fruit" met categorische data:
import pandas as pd

# generate df with 1 col and 4 rows
data = {
    "fruit": ["apple", "banana", "orange", "apple"]
}

# show head
df = pd.DataFrame(data)
df.head()
Output:

# apply get_dummies function
df_encoded = pd.get_dummies(df["fruit"])
df_encoded .head()
Output:

Hoewel `pandas.get_dummies` eenvoudig te gebruiken is, is een meer gangbare aanpak het gebruik van `OneHotEncoder` uit de sklearn-bibliotheek, zeker wanneer je met machine learning bezig bent. Het belangrijkste verschil is dat `pandas.get_dummies` geen encodings kan leren; het kan alleen one-hot-encoding uitvoeren op de dataset die je als invoer meegeeft. `sklearn.OneHotEncoder` daarentegen is een klasse die je kunt opslaan en later kunt gebruiken om andere binnenkomende datasets te transformeren.
import pandas as pd

# generate df with 1 col and 4 rows
data = {
    "fruit": ["apple", "banana", "orange", "apple"]
}

# one-hot-encode using sklearn
from sklearn.preprocessing import OneHotEncoder
encoder = OneHotEncoder()
encoded_results = encoder.fit_transform(df).toarray()
Output:

Label-encoding is een techniek om categorische variabelen als numerieke waarden te coderen, waarbij elke categorie een uniek geheel getal krijgt. Stel bijvoorbeeld dat we een categorische variabele "color" hebben met drie categorieën: "red", "green" en "blue". We kunnen deze categorieën als volgt label-encoden (red: 0, green: 1, blue: 2).
Label-encoding kan nuttig zijn voor sommige machine-learningalgoritmen die numerieke input vereisen, omdat het categorische data weergeeft op een manier die de algoritmen begrijpen. Houd er echter rekening mee dat label-encoding een arbitraire ordening van de categorieën introduceert, die niet per se een betekenisvolle relatie tussen die categorieën weerspiegelt. In sommige gevallen kan dit problemen opleveren in de analyse, vooral als de ordening wordt geïnterpreteerd als een soort ordinale relatie.

Label-gecodeerde data. Bron afbeelding
One-hot-encoding en label-encoding zijn beide technieken om categorische variabelen als numerieke waarden te coderen, maar ze hebben verschillende eigenschappen en zijn geschikt voor verschillende usecases.
One-hot-encoding vertegenwoordigt elke categorie als een binaire kolom, met een 1 die de aanwezigheid van de categorie aangeeft en een 0 die de afwezigheid aangeeft. Stel bijvoorbeeld dat we een categorische variabele "color" hebben met drie categorieën: "red", "green" en "blue". One-hot-encoding zou deze variabele als drie binaire kolommen weergeven:

One-hot-encoding is geschikt wanneer de categorieën geen intrinsieke ordening of relatie met elkaar hebben. Dit komt omdat one-hot-encoding elke categorie behandelt als een afzonderlijke entiteit zonder relatie tot de andere categorieën. One-hot-encoding is ook nuttig wanneer het aantal categorieën relatief klein is, omdat het aantal kolommen onhandelbaar kan worden bij zeer veel categorieën.
Label-encoding daarentegen vertegenwoordigt elke categorie als een uniek geheel getal. De variabele "color" met drie categorieën zou bijvoorbeeld als volgt label-encodet kunnen worden:

Label-encoding is geschikt wanneer de categorieën een natuurlijke ordening of relatie met elkaar hebben, zoals bij ordinale variabelen als "small", "medium" en "large". In die gevallen moeten de gehele waarden die aan de categorieën zijn toegewezen de ordening van de categorieën weerspiegelen. Label-encoding kan ook nuttig zijn wanneer het aantal categorieën zeer groot is, omdat het de dimensionaliteit van de data vermindert.
Over het algemeen wordt one-hot-encoding vaker gebruikt in machine-learningtoepassingen, omdat het flexibeler is en de problemen van ambiguïteit en arbitraire ordening vermijdt die bij label-encoding kunnen optreden. Toch kan label-encoding nuttig zijn in bepaalde contexten waarin de categorieën een natuurlijke ordening hebben of wanneer je met zeer veel categorieën te maken hebt.
Hoge cardinaliteit verwijst naar een groot aantal unieke categorieën in een categorische feature. Hiermee omgaan is een veelvoorkomende uitdaging bij het encoderen van categorische data voor machine-learningmodellen. Hoge cardinaliteit kan leiden tot een sparse datarepresentatie en kan de prestaties van sommige machine-learningmodellen negatief beïnvloeden. Hier zijn enkele technieken om met hoge cardinaliteit in categorische features om te gaan:
Dit houdt in dat weinig voorkomende categorieën worden samengevoegd tot één categorie. Dit vermindert het aantal unieke categorieën en verkleint ook de spaarzaamheid in de datarepresentatie.
Target encoding vervangt de categorische waarden door de gemiddelde targetwaarde van die categorie. Het biedt een meer continue representatie van de categorische data en kan helpen de relatie tussen de categorische feature en de targetvariabele vast te leggen.

Weight of Evidence-encoding lijkt op target encoding, maar houdt rekening met de verdeling van de targetvariabele voor elke categorie. De WOE van een categorie wordt berekend als de logaritme van de verhouding van het gemiddelde van de target voor de categorie tot het gemiddelde voor de gehele populatie.
Feature engineering is een belangrijke stap bij het voorbereiden van data voor machine-learningmodellen. Het omvat het creëren van nieuwe features op basis van bestaande features om de prestaties van de modellen te verbeteren. Hier zijn een paar manieren waarop je feature engineering op categorische data kunt toepassen:
Interactieve variabelen zijn nieuwe features die worden gemaakt door twee of meer bestaande features te combineren. Als we bijvoorbeeld twee categorische features hebben, 'Gender' en 'Marital Status', dan kunnen we een nieuwe feature 'Gender-Marital Status' maken om de interactie tussen de twee features vast te leggen. Dit kan helpen om niet-lineaire relaties tussen de features en de targetvariabele te vangen.

Binning is het proces waarbij continue numerieke variabelen worden verdeeld in discrete bakken (bins). Dit kan helpen het aantal unieke waarden in de feature te verminderen, wat gunstig kan zijn voor het encoderen van categorische data. Binning kan ook helpen om niet-lineaire relaties tussen de features en de targetvariabele vast te leggen.

Cyclische variabelen zijn variabelen die zich over een specifieke periode herhalen. Het uur van de dag is bijvoorbeeld een cyclische variabele, omdat dit elke 24 uur terugkomt. Het encoderen van cyclische variabelen kan helpen de periodieke patronen in de data vast te leggen. Een veelgebruikte aanpak om cyclische variabelen te encoderen is om twee nieuwe features te maken: één die de sinus van de variabele weergeeft en één die de cosinus van de variabele weergeeft.
Leer meer over Python
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

