想象您在动物园里,需要判断某只动物是猎豹还是豹。作为人类,大脑可以毫不费力地通过身体和面部特征分析作出判断。同样地,无论模式多么复杂,卷积神经网络(CNN)都可以被训练来执行相同的识别任务。这使得它们在计算机视觉领域非常强大。
本概念性 CNN 教程将首先概述 CNN 是什么,以及它们在机器学习中的重要性。随后将带您使用 TensorFlow Framework 2 按步骤实现一个 CNN。
什么是 CNN?
卷积神经网络(CNN 或 ConvNet)是一种专为需要进行目标识别的任务(如图像分类、检测与分割)设计的深度学习算法。许多现实应用(如自动驾驶汽车、监控摄像头等)都采用 CNN。
CNN 的重要性
下列几点突出了 CNN 的重要性:
- 与需要手动特征提取的传统机器学习模型(如 SVM 和决策树)不同,CNN 能够大规模自动进行特征提取,从而更高效。
- 卷积层使 CNN 具有平移不变性,意味着它们可以识别数据中的模式并提取特征,而不受其位置影响,无论图像是否旋转、缩放或平移。
- 大量预训练的 CNN 模型(如 VGG-16、ResNet50、Inceptionv3 和 EfficientNet)已被证明达到了最先进的效果,并可在较少数据的情况下针对新任务进行微调。
- CNN 也可用于非图像的分类问题,应用并不限于自然语言处理、时间序列分析与语音识别。
CNN 的架构
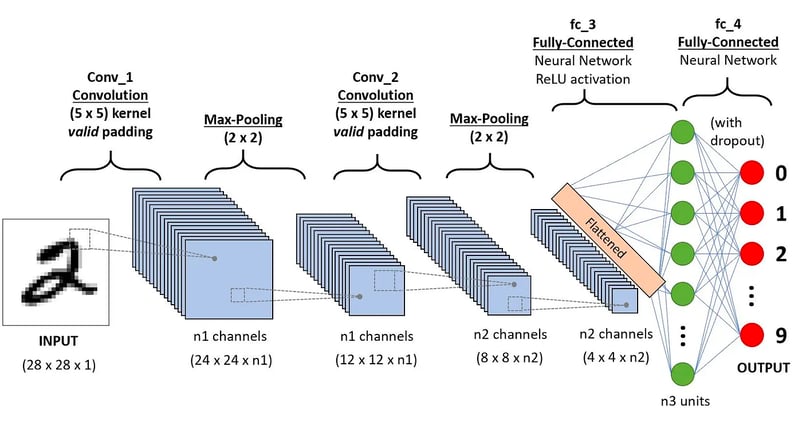
CNN 的架构尝试模拟人类视觉系统中神经元的结构,由多个层组成,每一层都负责在数据中检测特定特征。如下图所示,典型的 CNN 由四类主要层组合而成:
- 卷积层
- 修正线性单元(简称 ReLU)
- 池化层
- 全连接层
下面我们通过手写数字分类的例子来理解这些层的工作原理。
卷积层
这是 CNN 的第一个构建模块。顾名思义,其执行的主要数学运算称为卷积,即将滑动窗口函数应用于代表图像的像素矩阵。应用于矩阵的滑动函数称为核或滤波器,两者可互换使用。
在卷积层中,会应用多个大小相同的滤波器,每个滤波器用于从图像中识别某种特定模式,如数字的弯曲、边缘、整体形状等。
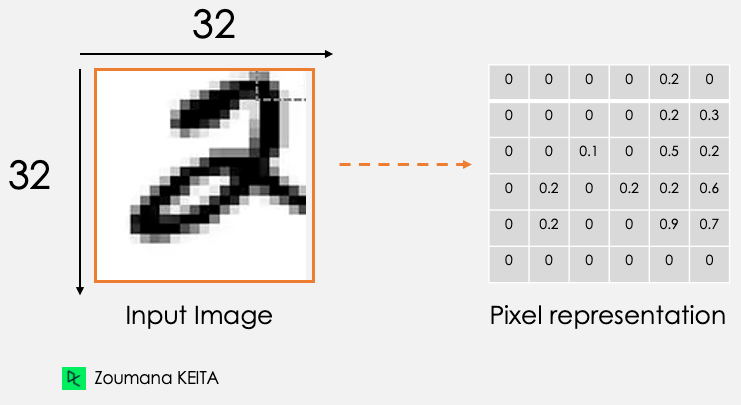
我们以一个 32x32 的灰度手写数字图像为例。矩阵中的数值仅用于说明。
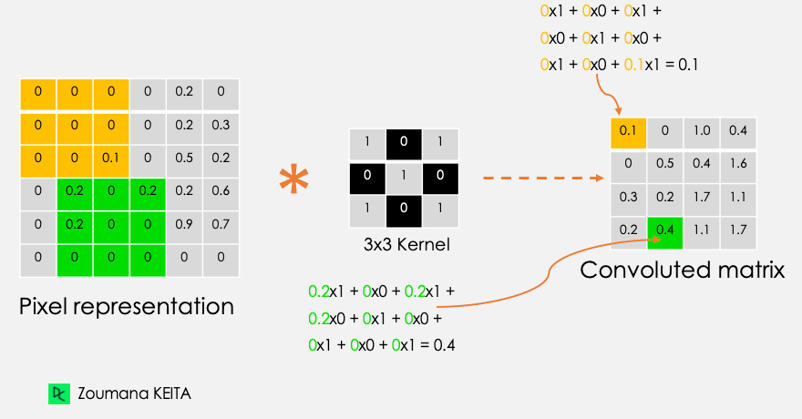
再来看用于卷积的核。它是一个 3x3 的矩阵。核中每个元素的权重在网格中表示。权重为 0 的用黑格表示,权重为 1 的用白格表示。
这些权重需要我们手动确定吗?
在实际中,核的权重是在神经网络的训练过程中确定的。
使用这两个矩阵,我们可以通过点积来执行卷积操作,步骤如下:
- 将核矩阵从左上角开始向右滑动应用。
- 执行元素级乘法。
- 对乘积求和。
- 所得值对应卷积后矩阵的第一个值(左上角)。
- 按滑动步长向下移动核。
- 重复第 1 至第 5 步,直到覆盖整个图像矩阵。
卷积后矩阵的维度取决于滑动窗口的大小。步长越大,维度越小。
文献中与核相关的另一个名称是特征检测器,因为其权重可以微调以检测输入图像中的特定特征。
例如:
- 对相邻像素求平均的核可用于模糊输入图像。
- 相邻像素相减的核用于执行边缘检测。
卷积层越多,网络越能检测到更抽象的特征。
激活函数
每次卷积操作后都会应用 ReLU 激活函数。该函数帮助网络学习图像特征之间的非线性关系,使网络更稳健地识别不同模式。同时也有助于缓解梯度消失问题。
池化层
池化层的目标是从卷积后的矩阵中提取最显著的特征。这通过应用某些聚合操作来完成,从而降低特征图(卷积后矩阵)的维度,进而减少训练网络时的内存占用。池化对于缓解过拟合同样重要。
常见的聚合函数包括:
- 最大池化:取特征图中的最大值
- 求和池化:对应特征图所有值的总和
- 平均池化:对应特征图所有值的平均值
下面是每种方法的示意:
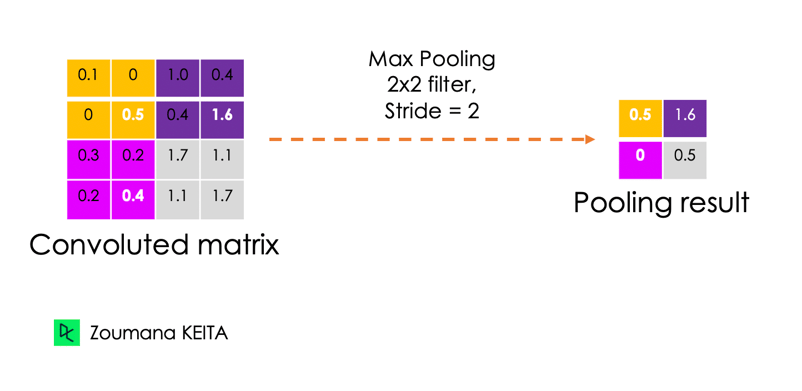
随着池化函数的应用,特征图的维度也会变小。
最后一个池化层会将其特征图展平,以便由全连接层处理。
全连接层
这些层位于卷积神经网络的末端,其输入对应最后一个池化层生成的展平成一维的矩阵。为引入非线性,对其应用 ReLU 激活函数。
最后,使用 softmax 预测层为每个可能的输出标签生成概率值,最终预测的标签即具有最高概率分数的那一类。
Dropout
Dropout 是一种正则化技术,用于提升参数数量巨大的神经网络的泛化能力。其做法是在训练过程中随机丢弃部分神经元,迫使其余神经元从输入数据中学习新的特征。
由于技术实现将使用 TensorFlow 2,下一节旨在全面概述该框架的不同组件,以高效构建深度学习模型。
什么是 TensorFlow 框架?
Google 于 2015 年 11 月开发了 TensorFlow。他们将其定义为“人人可用的开源机器学习框架”,理由包括以下几点。
- 开源:在 Apache 2.0 开源许可下发布。这使研究人员、组织与开发者可以在不受限制的情况下基于该库进行贡献与构建。
- 机器学习框架:这意味着它包含一组支持机器学习模型构建过程的库与工具。
- 面向所有人:通过 Python 等常用编程语言,TensorFlow 让机器学习模型的实现更为容易。此外,Keras 等内置库更是让创建健壮的深度学习模型变得更简单。
这些功能使 TensorFlow 成为构建神经网络的理想选择。
此外,使用 Python 包管理器 pip 安装 TensorFlow 2 十分简单,安装方法见官方文档。
安装完成后,我们可以看到当前使用的版本是 2.9.1
import tensorflow as tf
print("TensorFlow version:", tf.__version__)技术支持
现在,让我们进一步探索用于创建这些网络的主要组件。
什么是张量?
在构建机器学习与深度学习模型时,我们主要处理高维数据。张量是具有统一类型的多维数组,用于表示数据的不同特征。
下面是不同维度张量的图示。
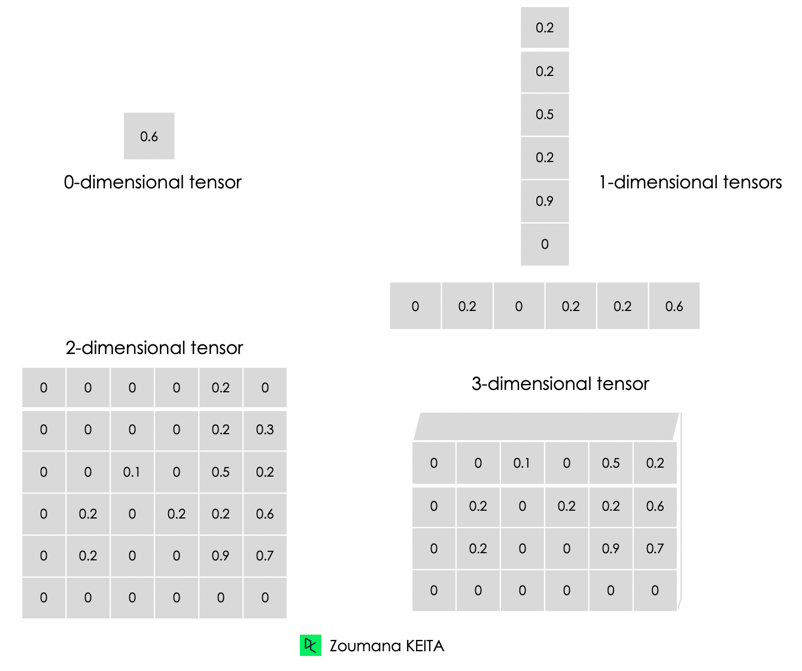
- 零维张量只包含一个值。
- 一维张量(也称为“秩 1”张量)是一组值的列表。
- 二维张量是“秩 2”张量。
- 最后,我们还可以有 N 维张量,其中 N 表示张量的维度数量。在前述示例中,N 分别为 0、1 和 2。
下面是从零维到三维张量的示意。每个张量都使用 TensorFlow 的 constant() 函数创建。
zero_dim_tensor = tf.constant(20)
print(zero_dim_tensor)
one_dim_tensor = tf.constant([12, 20, 53, 26, 11, 56])
print(one_dim_tensor)
two_dim_array = [[3, 6, 7, 5],
[9, 2, 3, 4],
[7, 1, 10,6],
[0, 8, 11,2]]
two_dim_tensor = tf.constant(two_dim_array)
print(two_dim_tensor)技术支持
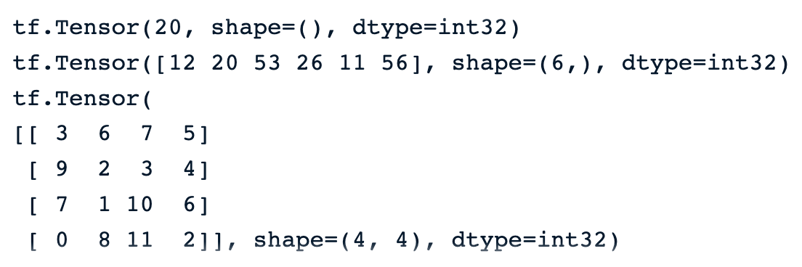
成功执行上述代码应生成如下输出,我们可以注意到关键字“tf.Tensor”,意味着结果是一个张量。它包含三个参数:
- 张量的实际数值。
- shape():张量的形状,分别为第一个张量 0、第二个张量 6×1、第三个张量 4×4。
- dtype:数据类型,此处所有张量均为 int32。
我们的 TensorFlow 新手教程提供了对 TensorFlow 的完整概述,并讲解如何构建和训练模型。
张量 vs 矩阵:有何不同
许多人容易将张量与矩阵混淆。尽管二者看起来相似,但性质完全不同。本节将更好地阐明矩阵与张量之间的区别。
- 可以将矩阵看作只有两个维度的张量。
- 而张量是一种更通用的格式,可以具有任意数量的维度。
与矩阵相比,张量更适合深度学习问题,原因如下:
- 它们可以处理任意维度,因此更适合多维数据。
- 张量在数据类型、形状与维度上的广泛兼容性,使其比矩阵更通用。
- TensorFlow 提供 GPU 与 TPU 支持以加速计算。使用张量,机器学习工程师可以自动受益于这些加速。
- 张量原生支持广播机制,即在不同形状的张量之间执行算术运算;而处理矩阵时并非总能做到这一点。
TensorFlow:常量、变量与占位符
张量不只有常量类型。还有变量与占位符,它们都是计算图的构建模块。
计算图本质上是对一系列操作以及其间数据流的表示。
现在,让我们理解这些张量类型之间的差异。
常量
常量是在计算图执行期间其值不发生变化的张量。它们通过 tf.constant() 函数创建,主要用于存储在模型训练期间无需改变的固定参数。
变量
变量是在计算图执行期间其值可以改变的张量,通过 tf.Variable() 函数创建。例如,在神经网络中,权重和偏置可定义为变量,因为它们需要在训练过程中被更新。
占位符
在 TensorFlow 第一版中,占位符被用作不包含特定值的空容器。它们仅用于为未来要使用的数据预留位置。这使用户可在模型训练与验证期间灵活使用不同的数据集与批大小。
在 TensorFlow 2 中,占位符已被 tf.function() 函数取代,这是一种更 Python 化、更动态的数据馈入计算图的方法。
CNN 分步实现
让我们将之前学到的一切付诸实践。本节将演示在 TensorFlow 上对 CIFAR-10 数据集实现卷积神经网络的端到端过程。该内置数据集具有以下属性:
- 包含 60,000 张 32×32 的彩色图像
- 数据集包含 10 个不同类别
- 每个类别有 6000 张图像
- 共有 50,000 张训练图像
- 共有 10,000 张测试图像
本文源代码可在 DataCamp 的 Workspace 中获取
网络架构
在进入技术实现之前,先来了解将要实现的网络的整体架构。
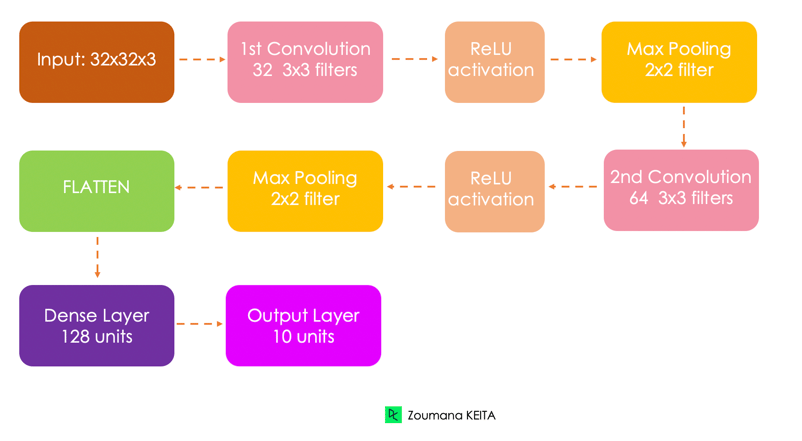
- 模型的输入是一个 32x32x3 的张量,分别对应宽度、高度与通道。
- 我们将使用两个卷积层。第一层应用 32 个 3x3 的滤波器并使用 ReLU 激活函数;第二层应用 64 个 3x3 的滤波器。
- 第一个池化层将应用 2x2 的最大池化。
- 第二个池化层同样应用 2x2 的最大池化。
- 全连接层包含 128 个单元并使用 ReLU 激活函数。
- 最后,输出为 10 个单元,对应 10 个类别,激活函数为 softmax 以生成概率分布。
加载数据集
该内置数据集从 keras.datasets() 加载如下:
(train_images, train_labels), (test_images, test_labels) = cf10.load_data()技术支持
探索性数据分析
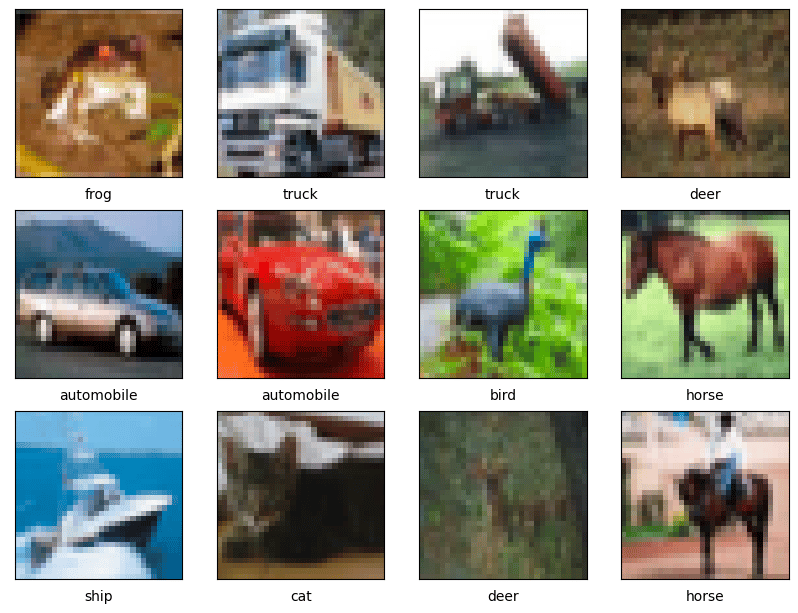
在本节中,我们将仅展示一些样例图像,因为我们已知训练与测试数据中各类别的占比。
辅助函数 show_images() 默认显示共 12 张图像,并接收三个主要参数:
import matplotlib.pyplot as plt

def show_images(train_images,
            	class_names,
            	train_labels,
            	nb_samples = 12, nb_row = 4):

	plt.figure(figsize=(12, 12))
	for i in range(nb_samples):
    	plt.subplot(nb_row, nb_row, i + 1)
    	plt.xticks([])
    	plt.yticks([])
    	plt.grid(False)
    	plt.imshow(train_images[i], cmap=plt.cm.binary)
    	plt.xlabel(class_names[train_labels[i][0]])
	plt.show()技术支持
现在,我们可以用所需参数来调用该函数。
class_names = ['airplane', 'automobile', 'bird', 'cat', 'deer',
           	'dog', 'frog', 'horse', 'ship', 'truck']

show_images(train_images, class_names, train_labels)技术支持
成功执行上述代码将生成如下图像。
数据预处理
在训练模型之前,我们需要将数据的像素值归一化到相同范围(例如 0 到 1)。这是处理图像时的常见预处理步骤,以确保尺度不变性并在训练过程中更快收敛。
max_pixel_value = 255

train_images = train_images / max_pixel_value
test_images = test_images / max_pixel_value技术支持
此外,我们注意到标签以类别形式表示,如 cat、horse、bird 等。需要将它们转换为数值格式,以便神经网络能够轻松处理。
from tensorflow.keras.utils import to_categorical
train_labels = to_categorical(train_labels, len(class_names))
test_labels = to_categorical(test_labels, len(class_names))技术支持
模型架构实现
下一步是根据前述描述来实现网络架构。
首先,我们使用 Sequential() 类定义模型,并通过 add() 函数逐层添加到模型中。
from tensorflow.keras import Sequential
from tensorflow.keras.layers import Conv2D, MaxPooling2D, Flatten, Dense
INPUT_SHAPE = (32, 32, 3)
FILTER1_SIZE = 32
FILTER2_SIZE = 64
FILTER_SHAPE = (3, 3)
POOL_SHAPE = (2, 2)
FULLY_CONNECT_NUM = 128
NUM_CLASSES = len(class_names)
model = Sequential()
model.add(Conv2D(FILTER1_SIZE, FILTER_SHAPE, activation='relu', input_shape=INPUT_SHAPE))
model.add(MaxPooling2D(POOL_SHAPE))
model.add(Conv2D(FILTER2_SIZE, FILTER_SHAPE, activation='relu'))
model.add(MaxPooling2D(POOL_SHAPE))
model.add(Flatten())
model.add(Dense(FULLY_CONNECT_NUM, activation='relu'))
model.add(Dense(NUM_CLASSES, activation='softmax'))技术支持
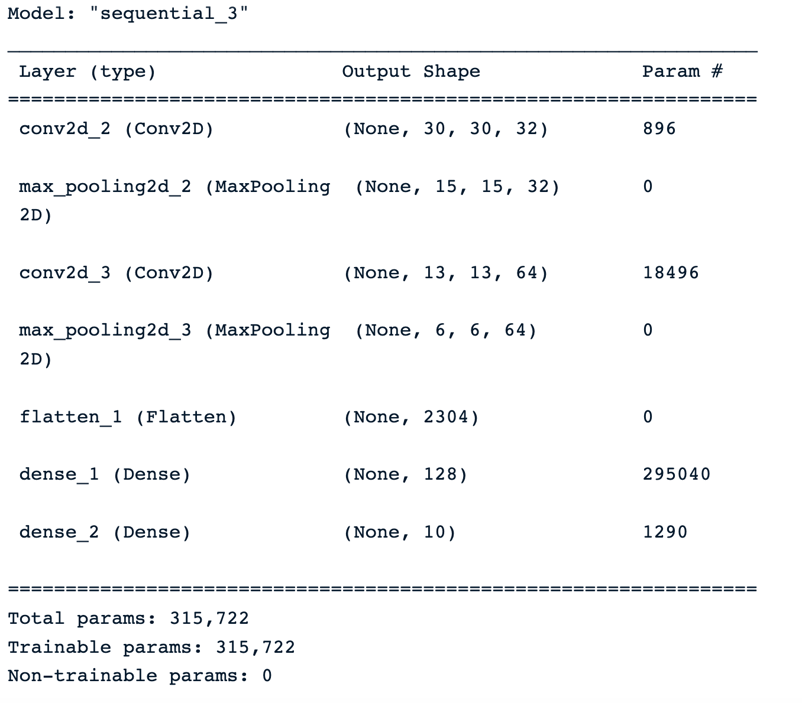
对模型应用 summary() 函数后,我们会得到模型架构的全面摘要,其中包含每一层的信息、层类型、输出形状以及可训练参数总数。
模型训练
至此,已具备配置并启动模型训练的所有资源。训练分别通过 compile() 和 fit() 函数完成,它们接收以下参数:
- 优化器负责更新模型的权重与偏置。在本例中,我们使用 Adam 优化器。
- 损失函数用于度量分类错误,我们使用交叉熵(Crosentropy())。
- 最后,度量指标用于衡量模型性能;在本例中将显示准确率、精确率和召回率。
from tensorflow.keras.metrics import Precision, Recall
BATCH_SIZE = 32
EPOCHS = 30
METRICS = metrics=['accuracy',
Precision(name='precision'),
Recall(name='recall')]
model.compile(optimizer='adam',
loss='categorical_crossentropy',
metrics = METRICS)
training_history = model.fit(train_images, train_labels,
epochs=EPOCHS, batch_size=BATCH_SIZE,
validation_data=(test_images, test_labels))技术支持
模型评估
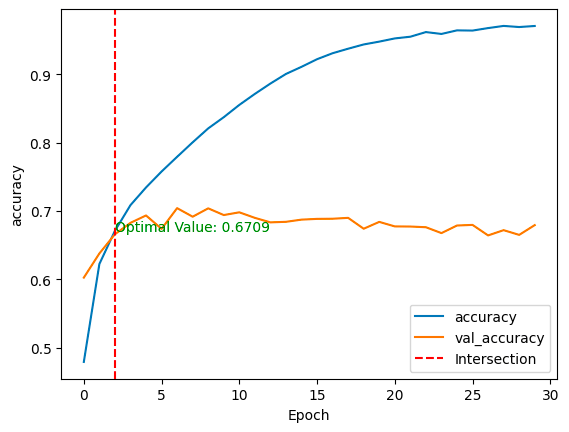
在模型训练完成后,我们可以通过绘制上述指标来比较其在训练与测试数据集上的性能,使用 show_performance_curve() 辅助函数以二维方式展示。
- 横轴(x)为轮数(epoch)
- 纵轴(y)为模型的对应性能。
- 曲线表示特定轮次下该指标的取值。
为便于可视化,图中通过训练与验证性能值的交点绘制一条红色竖线,并标注最优值。
def show_performance_curve(training_result, metric, metric_label):

	train_perf = training_result.history[str(metric)]
	validation_perf = training_result.history['val_'+str(metric)]
	intersection_idx = np.argwhere(np.isclose(train_perf,
                                            	validation_perf, atol=1e-2)).flatten()[0]
	intersection_value = train_perf[intersection_idx]

	plt.plot(train_perf, label=metric_label)
	plt.plot(validation_perf, label = 'val_'+str(metric))
	plt.axvline(x=intersection_idx, color='r', linestyle='--', label='Intersection')

	plt.annotate(f'Optimal Value: {intersection_value:.4f}',
         	xy=(intersection_idx, intersection_value),
         	xycoords='data',
         	fontsize=10,
         	color='green')

	plt.xlabel('Epoch')
	plt.ylabel(metric_label)
	plt.legend(loc='lower right')技术支持
随后,将该函数分别用于模型的准确率与精确率。
show_performance_curve(training_history, 'accuracy', 'accuracy')技术支持
show_performance_curve(training_history, 'precision', 'precision')技术支持
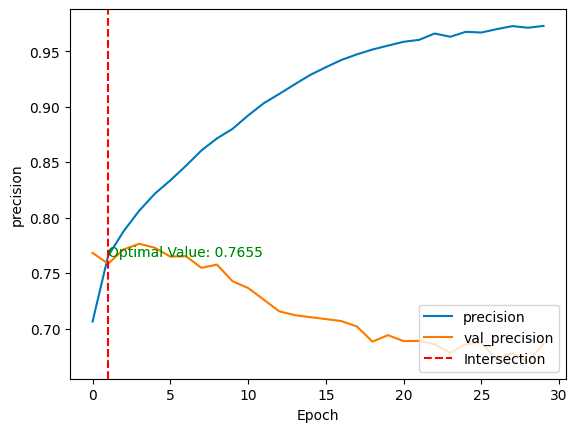
在未进行任何微调与预处理的情况下训练模型后,我们最终得到:
- 67.09% 的准确率,意味着每 100 个样本中有 67 个被模型正确分类。
- 76.55% 的精确率,意味着每 100 个正类预测中,约有 77 个为真正例,剩余 23 个为假正例。
- 上述分数分别在第 3 个与第 2 个 epoch 达到(对应准确率与精确率)。
这两个指标为我们提供了对模型行为的整体理解。
如果我们想知道对于每个类别,模型擅长预测哪些、又在哪些上表现欠佳,该怎么办?
这可以通过混淆矩阵实现,它显示了每个类别的正确与错误预测数量。实现如下所示。我们先对测试数据进行预测,然后计算混淆矩阵并展示最终结果。
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay

test_predictions = model.predict(test_images)

test_predicted_labels = np.argmax(test_predictions, axis=1)

test_true_labels = np.argmax(test_labels, axis=1)

cm = confusion_matrix(test_true_labels, test_predicted_labels)

cmd = ConfusionMatrixDisplay(confusion_matrix=cm)

cmd.plot(include_values=True, cmap='viridis', ax=None, xticks_rotation='horizontal')
plt.show()技术支持
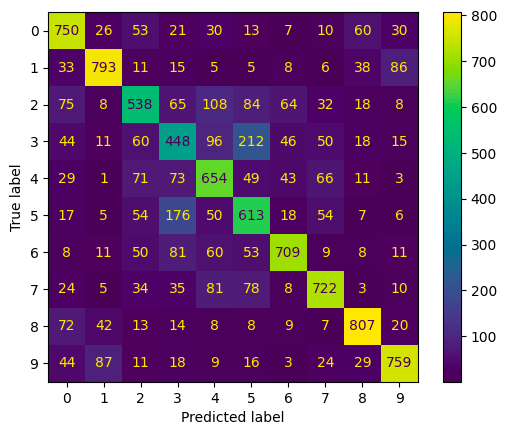
- 类别 0、1、6、7、8、9(分别对应 airplane、automobile、frog、horse、ship 和 truck)在对角线上数值最高。这意味着模型更擅长预测这些类别。
- 相反,模型似乎在其余类别上表现欠佳:
- 对角线以外数值最高的类别,是模型最易与正确类别混淆的。例如,它会将 birds(类别 2) 混淆为 airplane,并将 automobile 混淆为 trucks(类别 9)。
想进一步了解混淆矩阵,请参阅我们的教程 R 中的混淆矩阵详解,该教程取材自 DataCamp 的“机器学习工具箱”课程。
通过以下任务可进一步改进该模型:
- 图像增强
- 使用预训练模型(如 ResNet、MobileNet 或 VGG)进行迁移学习。我们的 迁移学习教程 解释了什么是迁移学习及其在现实中的一些应用。
- 应用不同的正则化技术,如 L1、L2 或 dropout。
- 微调不同的超参数,如学习率、批大小、网络层数。
结论
本文全面介绍了 TensorFlow 中的 CNN,详细说明了 CNN 架构中的各个层。同时简要介绍了 TensorFlow 以及它如何帮助机器学习工程师与研究人员构建复杂的神经网络。
我们将上述技能应用于一个与多分类任务相关的现实场景。
我们的 目标检测新手指南 将是继续学习计算机视觉的很好下一步。该指南探讨了目标检测的关键组成部分,并讲解了如何在 TensorFlow 中实现 SSD 与 Faster R-CNN。


想象您在动物园里,需要判断某只动物是猎豹还是豹。作为人类,大脑可以毫不费力地通过身体和面部特征分析作出判断。同样地,无论模式多么复杂,卷积神经网络(CNN)都可以被训练来执行相同的识别任务。这使得它们在计算机视觉领域非常强大。
本概念性 CNN 教程将首先概述 CNN 是什么,以及它们在机器学习中的重要性。随后将带您使用 TensorFlow Framework 2 按步骤实现一个 CNN。
什么是 CNN?
卷积神经网络(CNN 或 ConvNet)是一种专为需要进行目标识别的任务(如图像分类、检测与分割)设计的深度学习算法。许多现实应用(如自动驾驶汽车、监控摄像头等)都采用 CNN。
CNN 的重要性
下列几点突出了 CNN 的重要性:
CNN 的架构
CNN 的架构尝试模拟人类视觉系统中神经元的结构,由多个层组成,每一层都负责在数据中检测特定特征。如下图所示,典型的 CNN 由四类主要层组合而成:
下面我们通过手写数字分类的例子来理解这些层的工作原理。
卷积层
这是 CNN 的第一个构建模块。顾名思义,其执行的主要数学运算称为卷积,即将滑动窗口函数应用于代表图像的像素矩阵。应用于矩阵的滑动函数称为核或滤波器,两者可互换使用。
在卷积层中,会应用多个大小相同的滤波器,每个滤波器用于从图像中识别某种特定模式,如数字的弯曲、边缘、整体形状等。
我们以一个 32x32 的灰度手写数字图像为例。矩阵中的数值仅用于说明。
再来看用于卷积的核。它是一个 3x3 的矩阵。核中每个元素的权重在网格中表示。权重为 0 的用黑格表示,权重为 1 的用白格表示。
这些权重需要我们手动确定吗?
在实际中,核的权重是在神经网络的训练过程中确定的。
使用这两个矩阵,我们可以通过点积来执行卷积操作,步骤如下:
卷积后矩阵的维度取决于滑动窗口的大小。步长越大,维度越小。
文献中与核相关的另一个名称是特征检测器,因为其权重可以微调以检测输入图像中的特定特征。
例如:
卷积层越多,网络越能检测到更抽象的特征。
激活函数
每次卷积操作后都会应用 ReLU 激活函数。该函数帮助网络学习图像特征之间的非线性关系,使网络更稳健地识别不同模式。同时也有助于缓解梯度消失问题。
池化层
池化层的目标是从卷积后的矩阵中提取最显著的特征。这通过应用某些聚合操作来完成,从而降低特征图(卷积后矩阵)的维度,进而减少训练网络时的内存占用。池化对于缓解过拟合同样重要。
常见的聚合函数包括:
下面是每种方法的示意:
随着池化函数的应用,特征图的维度也会变小。
最后一个池化层会将其特征图展平,以便由全连接层处理。
全连接层
这些层位于卷积神经网络的末端,其输入对应最后一个池化层生成的展平成一维的矩阵。为引入非线性,对其应用 ReLU 激活函数。
最后,使用 softmax 预测层为每个可能的输出标签生成概率值,最终预测的标签即具有最高概率分数的那一类。
Dropout
Dropout 是一种正则化技术,用于提升参数数量巨大的神经网络的泛化能力。其做法是在训练过程中随机丢弃部分神经元,迫使其余神经元从输入数据中学习新的特征。
由于技术实现将使用 TensorFlow 2,下一节旨在全面概述该框架的不同组件,以高效构建深度学习模型。
什么是 TensorFlow 框架?
Google 于 2015 年 11 月开发了 TensorFlow。他们将其定义为“人人可用的开源机器学习框架”,理由包括以下几点。
这些功能使 TensorFlow 成为构建神经网络的理想选择。
此外,使用 Python 包管理器 pip 安装 TensorFlow 2 十分简单,安装方法见官方文档。
安装完成后,我们可以看到当前使用的版本是 2.9.1
现在,让我们进一步探索用于创建这些网络的主要组件。
什么是张量?
在构建机器学习与深度学习模型时,我们主要处理高维数据。张量是具有统一类型的多维数组,用于表示数据的不同特征。
下面是不同维度张量的图示。
下面是从零维到三维张量的示意。每个张量都使用 TensorFlow 的 constant() 函数创建。
成功执行上述代码应生成如下输出,我们可以注意到关键字“tf.Tensor”,意味着结果是一个张量。它包含三个参数:
我们的 TensorFlow 新手教程提供了对 TensorFlow 的完整概述,并讲解如何构建和训练模型。
张量 vs 矩阵:有何不同
许多人容易将张量与矩阵混淆。尽管二者看起来相似,但性质完全不同。本节将更好地阐明矩阵与张量之间的区别。
与矩阵相比,张量更适合深度学习问题,原因如下:
TensorFlow:常量、变量与占位符
张量不只有常量类型。还有变量与占位符,它们都是计算图的构建模块。
计算图本质上是对一系列操作以及其间数据流的表示。
现在,让我们理解这些张量类型之间的差异。
常量
常量是在计算图执行期间其值不发生变化的张量。它们通过 tf.constant() 函数创建,主要用于存储在模型训练期间无需改变的固定参数。
变量
变量是在计算图执行期间其值可以改变的张量,通过 tf.Variable() 函数创建。例如,在神经网络中,权重和偏置可定义为变量,因为它们需要在训练过程中被更新。
占位符
在 TensorFlow 第一版中,占位符被用作不包含特定值的空容器。它们仅用于为未来要使用的数据预留位置。这使用户可在模型训练与验证期间灵活使用不同的数据集与批大小。
在 TensorFlow 2 中,占位符已被 tf.function() 函数取代,这是一种更 Python 化、更动态的数据馈入计算图的方法。
CNN 分步实现
让我们将之前学到的一切付诸实践。本节将演示在 TensorFlow 上对 CIFAR-10 数据集实现卷积神经网络的端到端过程。该内置数据集具有以下属性:
本文源代码可在 DataCamp 的 Workspace 中获取
网络架构
在进入技术实现之前,先来了解将要实现的网络的整体架构。
加载数据集
该内置数据集从 keras.datasets() 加载如下:
探索性数据分析
在本节中,我们将仅展示一些样例图像,因为我们已知训练与测试数据中各类别的占比。
辅助函数 show_images() 默认显示共 12 张图像,并接收三个主要参数:
现在,我们可以用所需参数来调用该函数。
成功执行上述代码将生成如下图像。
数据预处理
在训练模型之前,我们需要将数据的像素值归一化到相同范围(例如 0 到 1)。这是处理图像时的常见预处理步骤,以确保尺度不变性并在训练过程中更快收敛。
此外,我们注意到标签以类别形式表示,如 cat、horse、bird 等。需要将它们转换为数值格式,以便神经网络能够轻松处理。
模型架构实现
下一步是根据前述描述来实现网络架构。
首先,我们使用 Sequential() 类定义模型,并通过 add() 函数逐层添加到模型中。
对模型应用 summary() 函数后,我们会得到模型架构的全面摘要,其中包含每一层的信息、层类型、输出形状以及可训练参数总数。
模型训练
至此,已具备配置并启动模型训练的所有资源。训练分别通过 compile() 和 fit() 函数完成,它们接收以下参数:
模型评估
在模型训练完成后,我们可以通过绘制上述指标来比较其在训练与测试数据集上的性能,使用 show_performance_curve() 辅助函数以二维方式展示。
为便于可视化,图中通过训练与验证性能值的交点绘制一条红色竖线,并标注最优值。
随后,将该函数分别用于模型的准确率与精确率。
在未进行任何微调与预处理的情况下训练模型后,我们最终得到:
这两个指标为我们提供了对模型行为的整体理解。
如果我们想知道对于每个类别,模型擅长预测哪些、又在哪些上表现欠佳,该怎么办?
这可以通过混淆矩阵实现,它显示了每个类别的正确与错误预测数量。实现如下所示。我们先对测试数据进行预测,然后计算混淆矩阵并展示最终结果。
想进一步了解混淆矩阵,请参阅我们的教程 R 中的混淆矩阵详解,该教程取材自 DataCamp 的“机器学习工具箱”课程。
通过以下任务可进一步改进该模型:
结论
本文全面介绍了 TensorFlow 中的 CNN,详细说明了 CNN 架构中的各个层。同时简要介绍了 TensorFlow 以及它如何帮助机器学习工程师与研究人员构建复杂的神经网络。
我们将上述技能应用于一个与多分类任务相关的现实场景。
我们的 目标检测新手指南 将是继续学习计算机视觉的很好下一步。该指南探讨了目标检测的关键组成部分,并讲解了如何在 TensorFlow 中实现 SSD 与 Faster R-CNN。