课程
理解机器学习
2 小时
313.7K
随着基于深度学习的计算机视觉模型的快速发展,目标检测应用的开发比以往任何时候都更容易。除了显著的性能提升,这些技术还利用了海量图像数据集,从而降低了对大型专用数据集的需求。此外,当前方法侧重于完整的端到端流水线,性能也显著提升,使实时场景成为可能。
类似于我之前撰写的关于不同图像分类架构的博文,本文将介绍两种目标检测架构。我将讨论 SSD 和 Faster RCNN,这两者目前都可在 Tensorflow Detection API 中使用。
首先,我会介绍目标检测中的一些关键概念,然后说明这些概念如何在 SSD 和 Faster RCNN 中实现。
人们常常会混淆图像分类和目标检测的场景。一般而言,如果您想将一张图像归入某个类别,使用图像分类即可。另一方面,如果您希望识别图像中目标的位置,并例如统计某个目标的实例数量,那么可以使用目标检测。
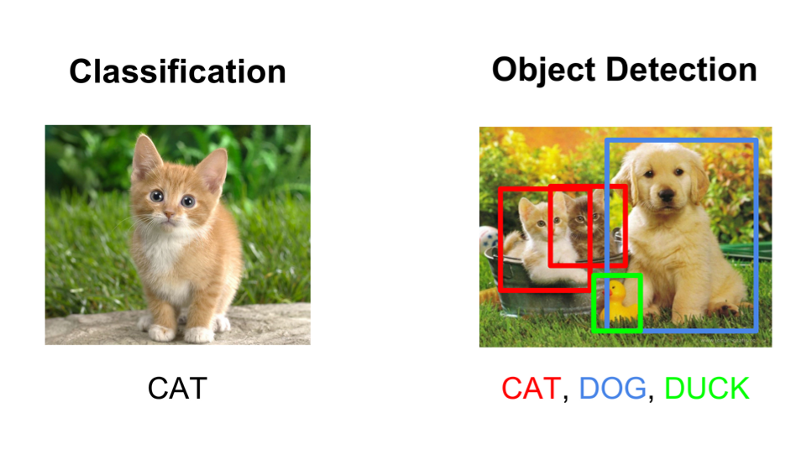
不过,这两种场景之间也有一定重叠。如果您要将图像分类为某个类别,但用于分类的目标或特征相对于整张图像来说过小,那么即使您并不关心目标的确切位置或数量,使用目标检测往往也会比图像分类取得更好的效果。
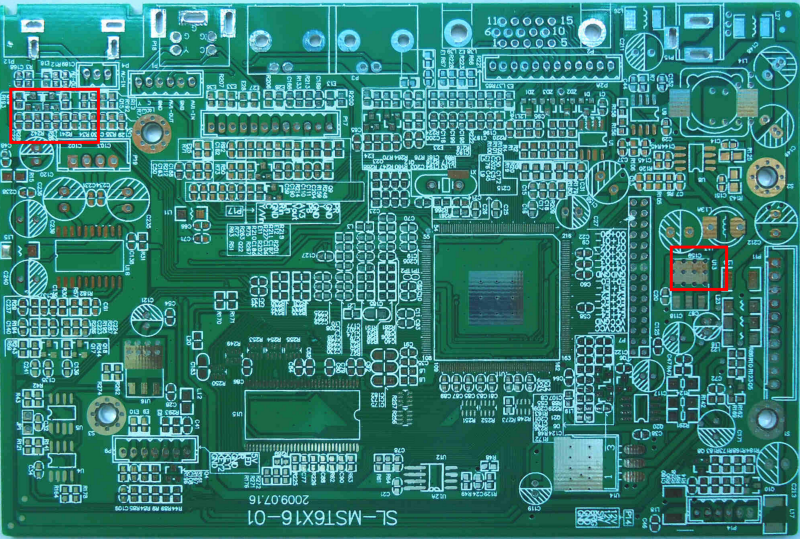
设想您需要检查电路板并将其分类为“有缺陷”或“无缺陷”。本质上这是一个分类问题,但缺陷可能太小,以至于图像分类模型难以察觉。构建目标检测数据集会更耗时,但很可能会得到更好的模型。
在图像分类模型中,您会对整张图像生成图像特征(可通过传统方法或深度学习方法获取)。这些特征是对图像的整体聚合。而在目标检测中,您会在图像更细粒度的区域级别上提取特征。前者可能会丢失分类信号,而后者则可能以更适用于特定用例的方式保留这一信号。
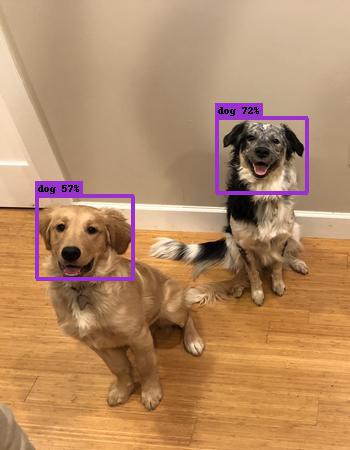
要训练自定义模型,您需要带标注的数据。在目标检测的语境下,带标注的数据指的是带有相应边界框坐标和标签的图像。也就是说,需要提供左下角和右上角的 (x,y) 坐标,以及类别。
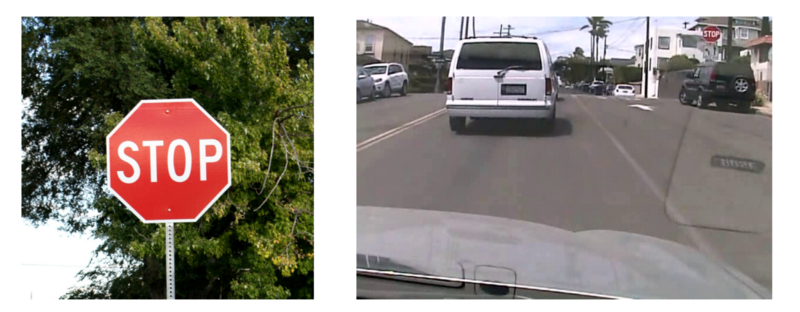
人们总爱问的一个问题是:要在问题 X 上做目标检测,我需要多少张图片?更重要的是,您需要清楚了解模型将部署在哪些场景。关键在于每个类别都要有大量(例如,> 100,最好 >1000)具有代表性的图像。此处的“具有代表性”意味着这些图像应与模型实际使用时所处的各种场景相对应。如果您在构建一个将在车载系统中运行的交通标志检测模型,就必须使用在不同天气、光照和摄像条件下拍摄的、并处于合适语境的图像。目标检测模型并非魔法,实际上也相当“笨”。如果模型没有足够的数据来学习通用模式,它在生产环境中的表现就不会好。
通常,目标检测框架包含三个步骤。
用于生成候选区域的方法有多种。最初,人们使用“选择性搜索”算法来生成目标候选。Lillie Weng 在她的博文中对该算法做了详尽讲解。简言之,选择性搜索是一种基于聚类的方法,它尝试对像素进行分组,并基于生成的聚类来提出候选区域。
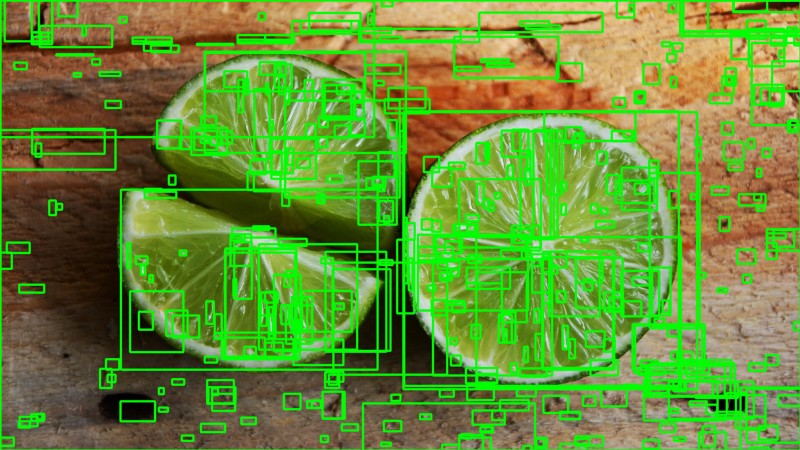
其他方法会使用从图像中提取的更复杂的视觉特征来生成区域(例如,基于深度学习模型的特征),或者采用蛮力式的区域生成方法。这些蛮力方法类似于在多个比例和尺度上对图像应用滑动窗口。此类区域是自动生成的,不考虑图像特征。
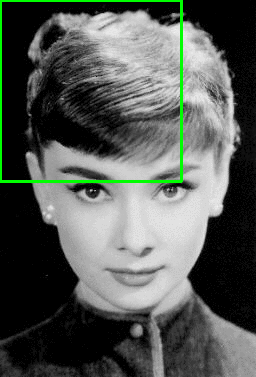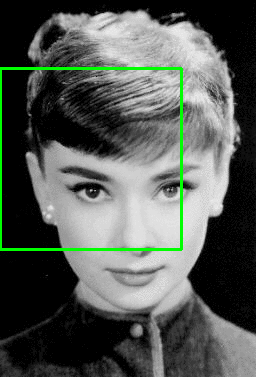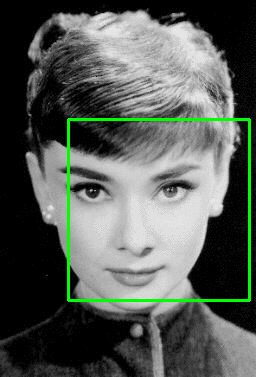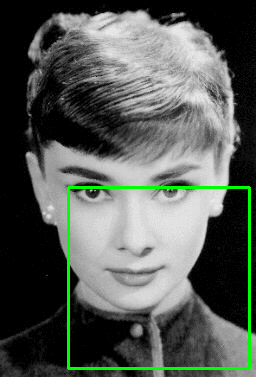
在生成候选区域时,一个重要的权衡是区域数量与计算复杂度之间的取舍。生成的区域越多,越有可能找到目标。反过来说,如果穷尽性地生成所有可能的候选,那么例如就不可能实时运行目标检测器。在某些情况下,可以利用问题特定的信息来减少 ROI 的数量。例如,行人的长宽比通常约为 1.5,因此生成长宽比为 0.25 的 ROI 就没有意义。
特征提取的目标是将可变尺寸的图像压缩为一组固定的视觉特征。图像分类模型通常采用强大的视觉特征提取方法。无论是基于传统计算机视觉方法(例如滤波方法、直方图方法等),还是基于深度学习的方法,它们的目标都是一样的:从输入图像中提取能代表当前任务的特征,并利用这些特征来确定图像的类别。在目标检测框架中,人们通常使用预训练的图像分类模型来提取视觉特征,因为这些模型具有良好的泛化能力。例如,在 MS CoCo 数据集上训练的模型能够提取相当通用的特征。不过,为了提升模型效果,建议尝试不同的方法。我关于迁移学习的博文清晰区分了不同类型的迁移学习,以及它们的优缺点。
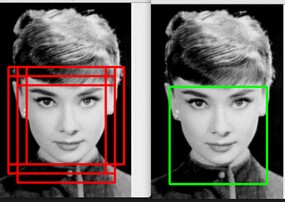
非极大值抑制的总体思路是将一帧中的检测数量减少到实际存在的目标数量。如果帧中的目标很大,且生成了超过 2000 个候选区域,那么其中一些候选很可能彼此之间、以及与目标之间有显著重叠。观看 Coursera 上的这个视频以进一步了解 NMS。不同检测框架中的 NMS 技术通常较为标准,但这是一个重要步骤,可能需要根据场景进行超参数调优。
目标识别任务中最常用的评估指标是“mAP”,即“平均精度均值”。它的取值范围为 0 到 100,数值越高通常越好,但与分类中的准确率指标不同。
每个边界框都会有一个分数(该框包含目标的可能性)。基于预测结果,通过改变分数阈值,为每个类别计算精确率-召回率曲线(PR 曲线)。平均精度(AP)是 PR 曲线下的面积。首先为每个类别计算 AP,然后在不同类别上求平均,最终得到 mAP。
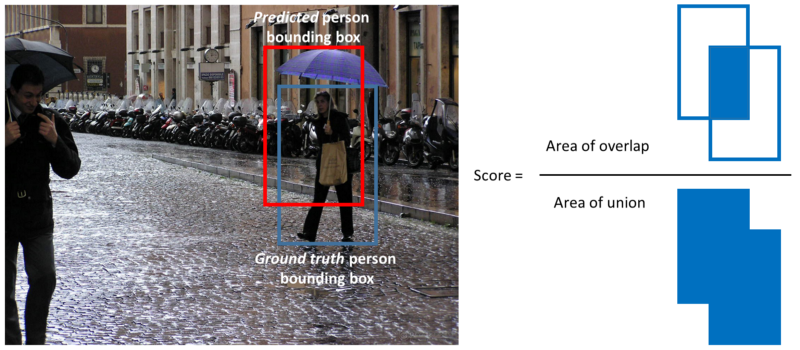
请注意,当检测结果与真实标注框的“交并比”(IoU 或重叠度)大于某个阈值(通常为 0.5)时,才被视为真正例。通常我们会使用 mAP@0.5 或 mAP@0.25 来指代所采用的 IoU 阈值。
Tensorflow Detection API 将上述众多思想整合在一个包中,允许您借助 Tensorflow 后端快速迭代不同配置。通过该 API,您可以使用配置文件来定义目标检测模型,而 Tensorflow Detection API 负责将所有必要组件组织起来。
为更好地了解支持的不同组件,请查看包含函数定义的“protos 文件夹”。在微调模型时,train、eval、ssd、faster_rcnn 和 preprocessing 这几个 proto 尤为重要。
SSD 架构由 Google 的研究人员于 2016 年提出。它提出了一种使用单个深度神经网络的目标检测模型,将候选区域与特征提取相结合。
SSD 使用一组覆盖不同长宽比和尺度的默认框,并将其应用于特征图。由于这些特征图是通过将图像输入图像分类网络计算得到的,因此可以在单步中提取边界框的特征。对于每个默认边界框,会为每个目标类别生成分数。为更好地拟合真实标注框,还会为每个框计算调整偏移量。
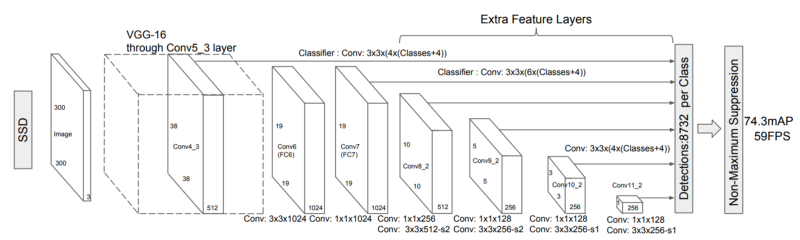
卷积网络中的不同特征图对应不同的感受野,自然可用于处理不同尺度的目标。由于所有计算都封装在单个网络中,因而能实现相当高的计算速度(例如,300 × 300 输入可达 59 FPS)。
在用法方面,我们将查看 SSD 的不同示例配置文件。使用 SSD 架构时,有若干重要参数,我们逐一说明。
首先,不同分类网络各有优劣(参见这篇博文获取概览)。例如,Inceptionv3 网络在不同尺度下都能很好地检测目标,而 ResNet 架构整体准确率非常高。另一方面,Mobilenet 的训练目标是尽可能降低计算资源占用。特征提取网络在 ImageNet 上的表现、参数数量以及其原始训练数据集,是评估性能/速度权衡的良好参照。特征提取器在“feature_extractor”部分中定义。
第二组显而易见的参数是默认框与长宽比的设置。根据问题类型,值得分析标注数据中边界框的各种长宽比与尺度。合理设置长宽比和尺度可确保网络避免不必要的计算。您可以在“ssd_anchor_generator”部分进行调节。请注意,增加更多的尺度和长宽比通常能带来更好性能,但往往存在边际收益递减。
第三,在训练模型时,需在“data_augmentation_options”和“image_resizer”部分设置图像尺寸和数据增强选项。更大的图像尺寸通常表现更好,因为小目标往往难以检测,但计算开销也会显著增加。数据增强在 SSD 的语境中尤为重要,以便能够检测不同尺度下的目标(甚至包括训练数据中可能不存在的尺度)。
最后,在“train_config”中进行调参,设置学习率和批量大小,对降低过拟合很重要,并且高度依赖于您数据集的规模。
Faster R-CNN 由微软的研究人员提出。它基于采用多阶段方法进行目标检测的 R-CNN。R-CNN 使用选择性搜索来确定候选区域,将这些区域输入分类网络,然后使用 SVM 对不同区域进行分类。
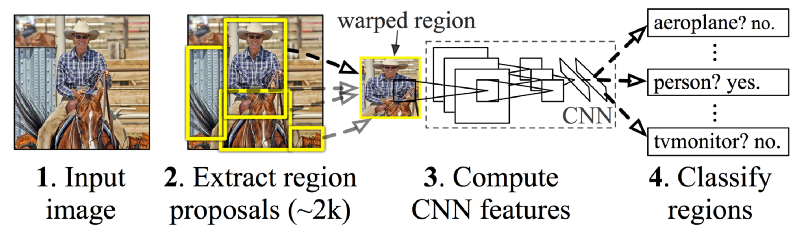
与 SSD 类似,Faster R-CNN 是一种端到端的方法。不同于使用默认边界框,Faster R-CNN 通过区域候选网络(RPN)来生成一组固定的候选区域。RPN 使用来自图像分类网络的卷积特征,从而几乎“零成本”地生成候选区域。RPN 实现为一个全卷积网络,在每个位置预测目标边界和目标性分数。
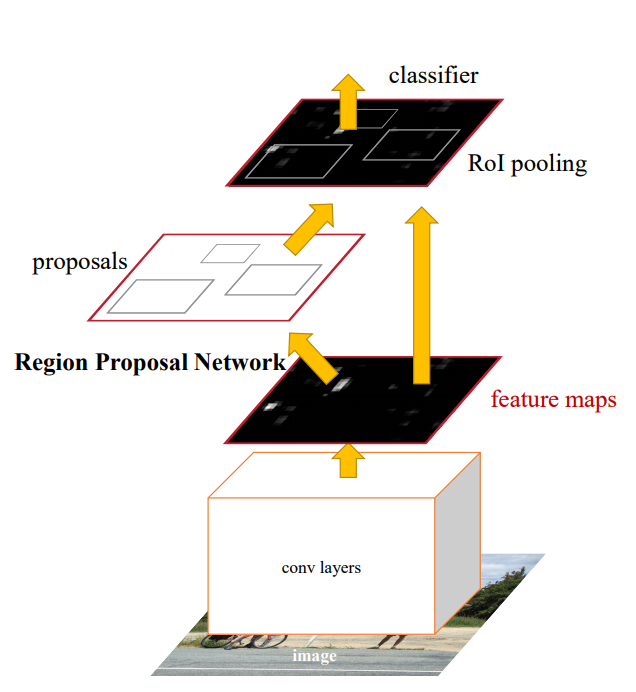
请注意,RPN 的设置与 SSD 网络类似(即并非“凭空”预测边界框)。RPN 在特征图上使用滑动窗口。在每个滑动窗口位置(或称锚点)上,会按不同尺度和长宽比计算一组候选。与 SSD 相似,RPN 的输出是基于锚点“调整后”的边界框。
不同组件在同一架构中组合在一起,可采用端到端或多阶段训练(以提升稳定性)。对 RPN 的另一种解读是,它引导网络将“注意力”聚焦于更有意义的区域。
Faster R-CNN 的大部分使用细节与 SSD 相似。在原始 mAP 指标上,Faster R-CNN 通常优于 SSD,但它需要显著更多的计算资源。
对于 Fast-RCNN 检测器,一个重要的部分是“first_stage_anchor_generator”,它定义了 RPN 生成的锚点。该部分中的步幅定义了滑动窗口的步长。需要注意的是,尤其在尝试检测小目标时(如果步幅过大,可能会漏检)。
尽管 Faster-RCNN 论文的作者并未使用大量数据增强,但在小数据集场景下,仍建议采用数据增强。
还有其他多种目标检测架构,本文未涉及。尤其在实时应用方面,Yolov2 常被视为重要架构(与 SSD 相当相似)。当它被加入 Tensorflow Detection API 后,我会更新本文。
进一步学习机器学习
课程
课程
课程